
レポート
AIの研究開発の自動化についてAI研究者に聞く
原題:Interviewing AI researchers on automation of AI R&D
はじめに
AIがいつ、どのようにAIの研究開発(R&D)を自動化しうるかという問いは、AIの予測にとって極めて重要である。AIがAI研究に関わるタスクを自動化できれば、AIの進歩を劇的に加速させる可能性があるからだ。研究者たちは以前から長く、この問いを抽象的に考え、AIが未来をどう形づくるかを考えるうえでのその重要性を論じてきた。1しかし、AIの研究開発が自動化されるまでの時期について、AI研究者の意見は大きく分かれている。たとえば、AI研究者のすべてのタスクが自動化される時期についての研究者の予測は、数年から数世紀まで幅がある。2
本研究では、次の三つの目的でAI研究者にインタビューを行った。
- 自動化がどのように起こりうるかをよりよく理解するために、AIの研究開発の作業タスクを詳しく特徴づける。
- 研究者の意見がどこで、なぜ分かれるのかを見るために、自動化についての研究者の予測を支える理由づけを明らかにする。
- この極めて重要な分野でのAIの進歩を社会がどう追跡できるかをよりよく理解するために、AIシステムがAIの研究開発をどれほどこなせるかを測る評価について、研究者の見解を集める。
そのために、質的インタビューを用いた。産業界・非営利・学術の研究所に所属し、主要な学会で論文を発表したか、それに類する経験を持つ8人のAI研究者に、自由回答式の質問をした。回答の中で繰り返し現れるテーマを特定してまとめ、必要に応じて参加者の発言を例として引用した。
自動化についての参加者の予測は、既存の調査結果と同様に大きく異なっていた。しかし、今後5年間の研究開発の自動化を主に牽引するのはエンジニアリングのタスクだという点では、全参加者の意見が一致した。参加者が正しければ、問題はどのタスクが重要かではなく、エンジニアリングのタスクがいつ自動化されるかである。エンジニアリングのタスクを中心とする既存のAI研究開発の評価をAIが解けるようになれば、自分たちの仕事は大きく加速すると、ほとんどの参加者が考えていた。
結果の要約
-
仮説を立てることと研究を計画することはAIの研究開発に不可欠だが、研究者の説明によれば、プロジェクトの中でそれらが占める時間は比較的少ない。一方、コーディングやデバッグのようなエンジニアリングのタスクは同様に重要で、より時間がかかる。エンジニアリングのタスクは、参加者が上級になり、計画や管理の責任をより多く担うようになっても、その仕事の中心にある。
-
自動化のペースについての予測は大きく異なるが、近い将来の研究開発の自動化を牽引するのはエンジニアリングのタスクだと見ている点は共通している。自動化についての予測の違いは、どのタスクが重要かについての考えの違いよりも、エンジニアリングのタスクがいつ自動化されるかという時期の見込みの違いから主に生じている。
-
エンジニアリングを中心とする既存のAI研究開発の評価は、有望な出発点である。参加者は、機械学習(ML)の実験の実装とデバッグを扱う研究開発の評価の例についてフィードバックをくれた。8人中6人は、AIがこれらを自律的に解けるようになれば、研究者の作業時間のかなりの部分が自動化されると予測した。研究者は、評価を現実的なものにするための提案をいくつか示した。その中には、より難しい自由度の高いタスクや、AIエージェントの信頼性のきめ細かな評価が含まれる。
主な結果
仮説はすぐに立ち、実装には時間がかかる。どちらも極めて重要
参加者による自分の仕事の説明は、評価に関する文献で想定されているAIの研究開発のワークフロー、すなわち仮説・実験・結果のフィードバックループと似ている。これを図1に示す。全参加者が、それぞれの高次のタスクについて具体例を挙げた。その例は、アーキテクチャの設計、データセットの整備、CUDA の最適化など、AI研究の幅広い分野にわたっていた。
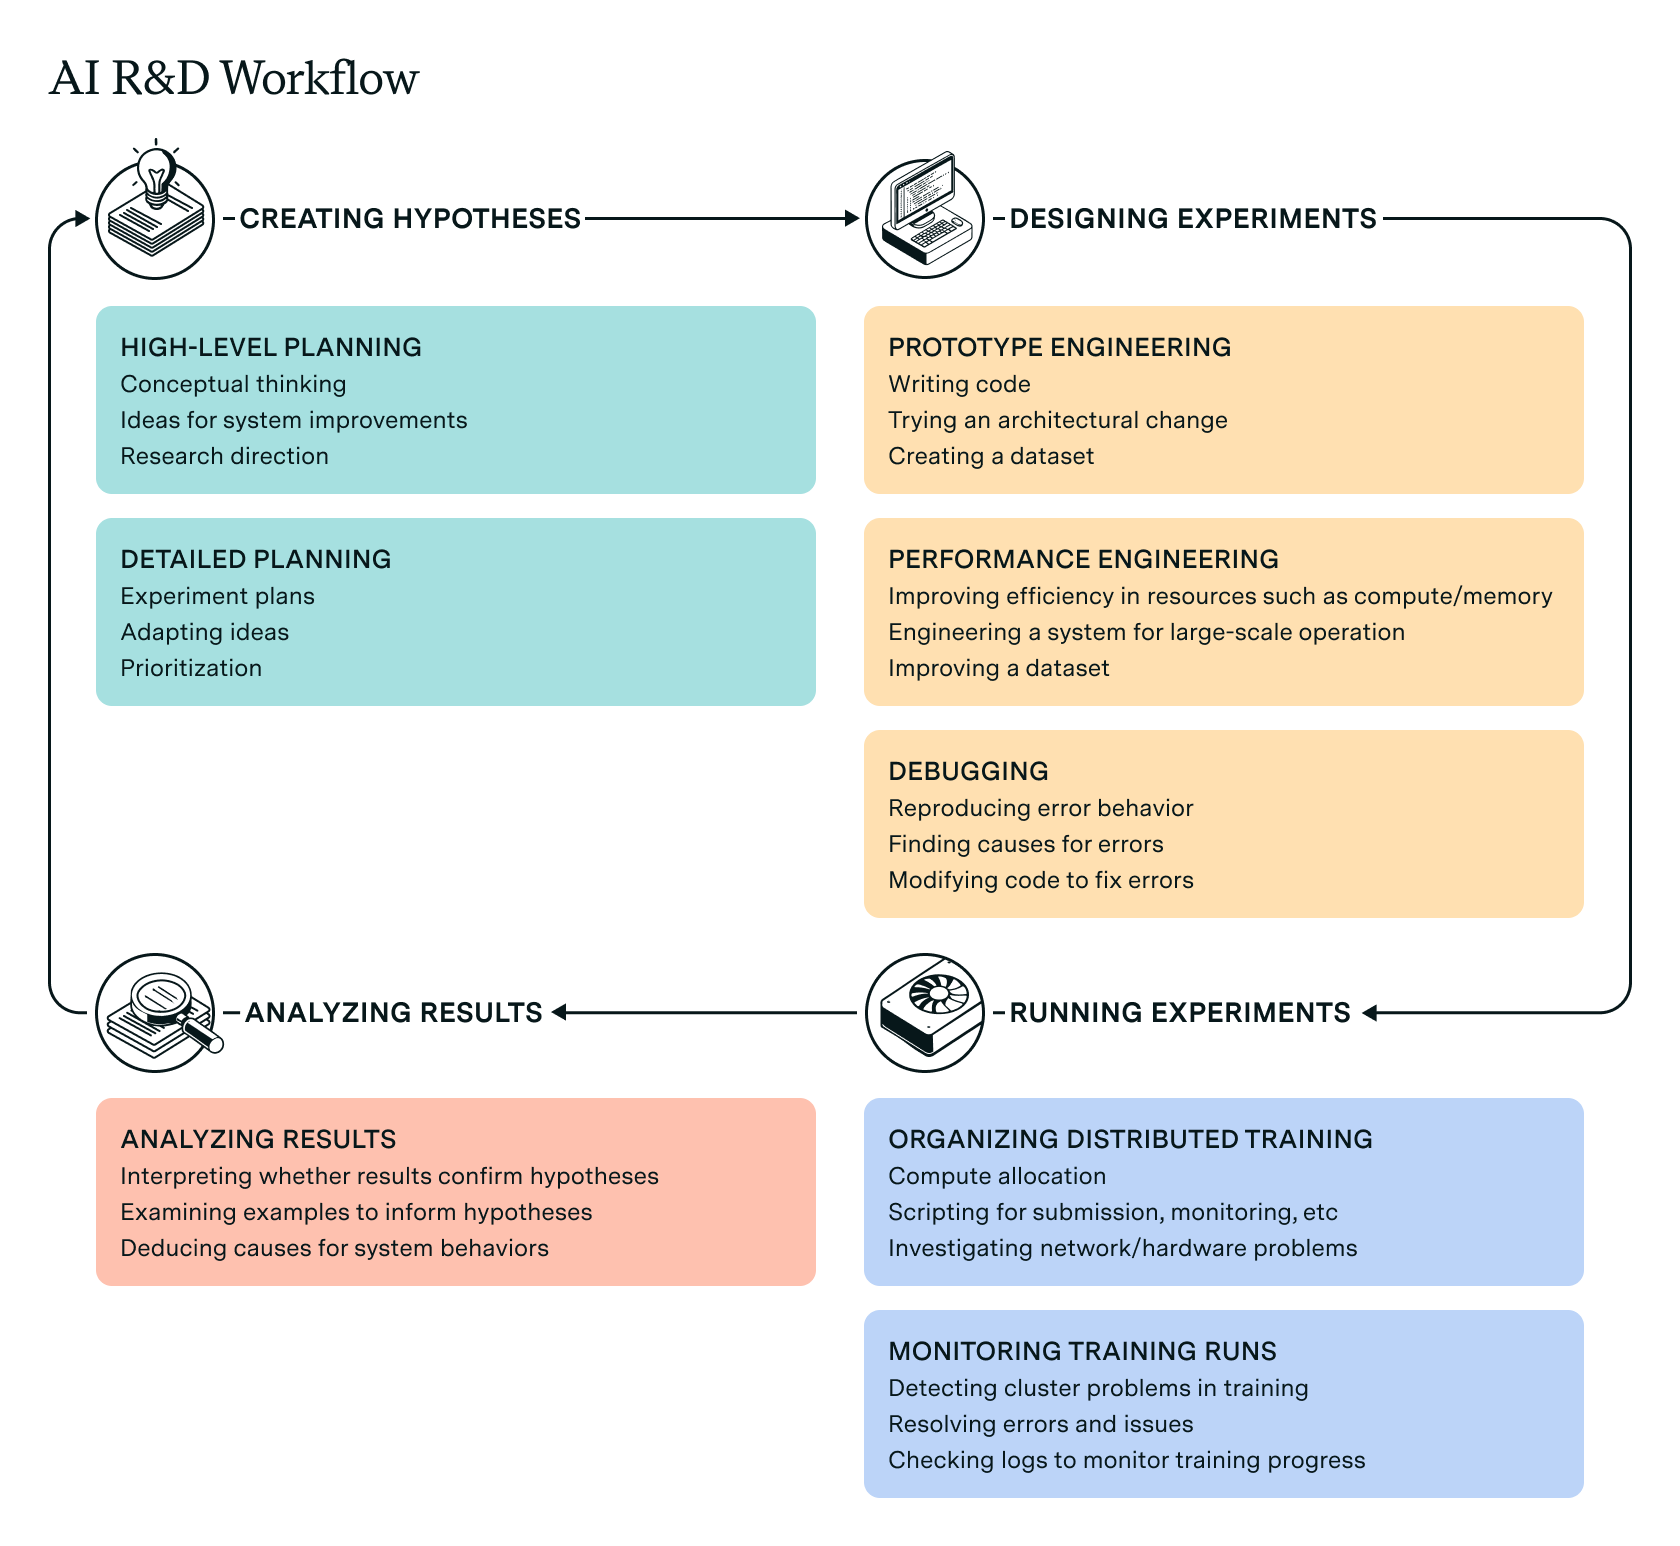
図1:参加者の説明に基づくAIの研究開発のワークフロー。評価に関する文献にある既存の説明を拡張したもの。参加者は各サブタスクについて例を挙げた。
6人の参加者は、プロジェクトの中での計画と仮説づくりの重要性を強調した。これらにかかる時間を特定する方法は明らかではない。実験の設計や他の研究の調査などと重なっているからだ。それでも参加者の説明からは、アイデアを実装する作業と比べれば、これらはすぐに済むことがうかがえる。全参加者が、エンジニアリングとデバッグの重要性と、それらにどれほど時間がかかりうるかに言及した。どの場合でも、これは参加者の仕事の中核をなしており、上級になって研究の計画や管理の責任をより多く担うようになってもそうだった。
ある参加者によるAIの研究開発のワークフローの説明:「研究はサイクルで進みます。まず、重要な問題は何だと思うか、何に取り組みたいか、どこなら進歩を生む余地がありそうかを見極めるのに、かなりの時間を費やします。次に、その分野で進歩するために実際に何をしたいのかを考えはじめますが、それ自体はまた少し違う作業です。そしてその後に、いわば純粋な実行の作業があるのです……」
自動化のペースについての予測は分かれるが、研究開発の自動化の主な牽引役がエンジニアリングになる点では一致
AIの研究開発の自動化についての予測は、ペースも範囲も大きく異なっていたが、全参加者が実装やデバッグのようなソフトウェアエンジニアリングのタスクを中心に回答した。要するに、全参加者が、エンジニアリングのタスクの自動化はAIの研究開発を大幅に加速させるのに十分だと予測したが、どの水準のエンジニアリング能力があれば十分かについての予測は異なっていた。データの生成や整備といった他のタスクも、2人の参加者が有望な自動化の対象として挙げたが、予測の中でそれだけを取り上げて論じられることは少なかった。
表1は、今後5年間の自分の仕事の自動化についての参加者の予測を示す。2人の参加者は自動化について極めて楽観的な時期を見込み、今後5年間に研究開発のエンジニアリングが大幅に自動化されると予測した。この2人は、5年後にはAIエージェントが、研究者による自然言語の説明からコードと実験を自律的に実装するようになると予測した。後で時間の使い方を説明してもらったところ、これによって現在の仕事の半分以上が自動化されうることがうかがえた。これらの予測では、今日と同様のMLの実験が自動化されることで、意味のあるAIの自己改良が起きることになる。より悲観的な側では、2人の参加者が、AIのコーディングアシスタントや類似のツールは今後も改善していくが、AIの研究開発への効果は控えめだと予測した。1人の参加者は、自分の仕事の生産性が20〜50%向上するというのを、極めて楽観的な上限だと述べた。残りの4人はおおむねこれら両極の間に位置し、AIアシスタントは改善して役に立つようになるが、自分のタスクを完全に自動化する可能性は小さいと予測した。
| 見通し | 発言の引用 |
|---|---|
| 悲観的 AIによる支援は、より簡単なソフトウェアエンジニアリングには役立つかもしれないが、研究開発にはあまり役立たない。 | P1:「データが与えるあらゆる汚い混沌の中から、どうやってAIに最も単純な真実を引き出させるか、という点にはそれほど労力が注がれていないように見えます[…]次トークン予測はそうした振る舞いとはかけ離れているように思えます。そして、まさにその振る舞いこそが、自己改良のためのAIの研究能力に加えて、数学的能力や一流のソフトウェアエンジニアリング、その他あらゆるものを本当に解き放つのだと思います。」 |
| やや楽観的 AIによる支援は改善を続け、AIの研究開発に役立つが、完全に自動化されるタスクは少ない。 | P4:「コーディングは間違いなく、今まさに人々が取り組んでいるもので、大きな進歩が見られます。これは人々の生活のとても大きな部分を占めていて、人々の時間をすっかり奪っています。だから、コーディングが加速されれば……主にコードの加速の話だと思います。」 |
| 極めて楽観的 AIによる支援が進歩し、かなり多くのタスクが完全に自動化される。 | P7:「人間はこの巨大なモデルに自然言語で話しかけるだけになり、モデルはコードベースを管理し、実験も実行するでしょう。基本的には、次の学習実行の管理もするかもしれません。」 |
参加者は、AIシステムがAIの研究開発の仕事を自動化できるようになるまでに改善しなければならない課題をいくつか挙げた。信頼性、自由度の高い計画立案、長いコンテキストにわたる推論、深い推論、新規性である。ほかにも、研究者が実装の細部に精通している必要があることや、特にエージェントが自らMLの実験を行う場合に、エージェントの稼働に多くの計算資源が必要になることなど、実際には自動化を妨げうる要因がいくつかある。こうしたAIの限界の要約を、研究者による説明の例とともに表2に示す。これらの限界は、経済全体の作業タスクをMLシステムへの適合性に応じて評価した自動化可能性についての既存の研究といくらか似ている。ただし、本研究で特定した限界は、とくにAIの研究開発の作業タスクを対象としたものであり、あらかじめ定義したものではなく、研究者の説明から導き出したものである。
| 課題 | 説明 |
|---|---|
| 信頼性 | P5:「この論文のこの手法を実装して試し、結果を報告するよう頼んだとします。でも、もしエージェントがコンパイルできないコードを出して失敗し、このタスクに失敗したと返してきたら、そのアーキテクチャは機能しないと見なしてよいでしょうか。それとも、単にエージェントがミスをしただけだと考えますか。」 |
| 自由度の高い計画立案 | P6、自由度の高いタスクの例を挙げて:「私たちのモデルはこのスコアで75%にとどまっている。それでは受け入れられない、80%まで上げる必要がある。どうやってそうするかは君[エージェント]に任せる。[このようなタスクは]世の中でずっとよくあるもので、自動化するのもずっと難しいでしょう。」 |
| 長いコンテキストにわたる推論 | P2:「『うちのコンテキストウィンドウは300万トークン、1,000万トークンです。コードリポジトリ全体を放り込めば、関数を実装できますし、実質的にリポジトリ全体を更新できます』といった宣伝をたくさん目にします。でも私の反論は、より長いコンテキストを処理できる能力と、そのコンテキストを実際に使える能力は別物だ、というものです。」 |
| 深い推論 | P1、CUDA のコードの設計について:「深層学習でやりたいことの大半を捉えつつ、ハードウェアが求めるものも尊重する抽象化とは何か[…]それは、コンテキストの取り込みの面でも、単純に推論の面でも、まだかなり遠いところにあると思います。それを実現するには多くの推論が必要ですが、GPT-4 の推論は少し浅すぎるように見えます。」 |
| 新規性 | P6、AIの研究開発には小さな規模ではうまくいかない新しい手法が関わることについて:「AIがやってきたことのほとんどは、誰か人間がすでにやってきたことです[…]最先端のタスク、つまり極めて大きな規模で物事を動かす方法を見つけたり、AIの新しい学習手法を考え出したりすることについては、それらは小さなモデルではうまくいったことがなかったのに、今はうまくいくのです。」 |
既存の研究開発の評価は有望な出発点になりうる
現在開発中のAI研究開発の評価から、実験の実装とデバッグを扱うタスクの例をいくつか参加者に示し、AIシステムがこれらのタスクを解けるようになった場合に何が起こるかを尋ねた。6人の参加者は、これらの評価に合格できるAIシステムは、AIの研究開発を大幅に自動化できるようになると予測した。評価、参加者の予測、その理由づけの詳細を表3に示す。説明の例からは、これらのタスクをこなせるエージェントは、研究者の現在の作業時間の半分を自動化するかもしれないことがうかがえた。
| 明確に定義された実験 | エラーのデバッグ | |
|---|---|---|
| 評価 | 与えられたモデルのコードベースと事前学習済みの重みで、アテンションをスパースアテンションに置き換える。ファインチューニングして性能を評価する。 | CUDA ストリームの並行処理のエラーがある、与えられたMLのコードベースをデバッグする。 |
| AIの研究開発がどれだけ自動化されるか(楽観的) | P4:「それをやってくれるモデルがあれば、私の時間の60%が自動化されるでしょう」 | P3:「うまく動かなくなった時点より後のすべてをデバッグに数えるなら、[コーディングに費やす時間の]70%くらいでしょう。」 |
| 大きな影響を持ちうる理由 | P4:「私のプロジェクトの一部はまさにそれで、基本的にさまざまな種類のアテンションを実装するものでした[…]スパースアテンションのさまざまな変種をやるのに、少なくとも1か月は費やしました。」 | P5:「[エラーは]再現がとても難しかったり、いつも現れるわけではなかったりすることがあり、そういうものは間違いなく見つけるのがとても厄介です[…]でも、役に立つためにそれらを自動で解決できる必要はないと思います。」 |
| AIの研究開発がどれだけ自動化されるか(悲観的) | P8:「数か月がかりのプロジェクトのうち、数時間か数日」 | P8:「コードのどこからもエラーが出ていない場合[…]そのほうがデバッグはずっと難しいのですが、その場合こそ、比べものにならないほど有用だと思います。」 |
| 大きな影響を持たないかもしれない理由 | P8:「実装のその部分は、それほど込み入っていないし、それほど複雑でもありません。」 | P8:「明示的な CUDA のバグはないのに、間違った結果が出て、それが数学的に間違っているとわかる。そういうのはデバッグがとても難しいのです。」 |
この結果について、ある参加者が強調した注意点として、自動化の全体的な効果は、これらの研究タスクの個々の事例によって大きく異なりうることがある。したがって、全体的な影響は、研究者の作業時間から見積もったものとは違うかもしれない。2人の参加者は、そもそもこれらの評価に懐疑的で、自分たちの仕事はより自由度が高く難しいタスクに依存していると反論した。この2人は、これらの評価には合格できても、より難しいタスクはこなせないAIは、AIの研究開発の自動化にはほとんど価値がないと予測した。
評価を改善するための提案は二つの形をとった。より難しく自由度の高いタスクを含む、別のタスクについての提案と、評価の仕組みを変えることについての提案である。たとえば5人の参加者は、タスクを最初から最後まで自律的に完了させることより、部分的な自動化に基づく評価のほうが好ましいと述べた。同様に2人の参加者は、タスクの完全な自動化にはおそらく高い信頼性が必要であり、評価ではそれを詳しく評価する必要があると強調した。これらの提案については、報告書の全文でさらに論じている。
考察
参加者による仕事の説明と自動化についての予測を扱った今回のインタビューから、研究者がAIの研究開発の自動化可能性をどう考えているかが見えてくる。本研究は、短期的な自動化について異なる予測を持つ研究者の間でさえ、意見が一致する点を掘り起こした。ほとんどの研究者は、明確に定義された実験を実装し、エラーをデバッグできるAIエージェントがあれば、自分たちの仕事は大幅に加速すると予測している。意見が分かれるのは主に、そのようなエージェントがいつ実現しうるか、そしてそれまでの間に部分的な自動化が大きな影響を持つかどうか、という点である。
評価の設計は、これと密接に関わる問題である。評価は、補助的なAIツールではなく完全な自動化にどの程度焦点を当てるべきだろうか。結果はまちまちである。ほとんどの参加者は、スパースアテンションの実装や CUDA のエラーのデバッグといった例のタスクをAIが自動化できれば、大きな影響があると予測した。しかし、8人中6人は、AIが近い将来にこの水準の能力に達することに懐疑的だった。このことから、完全な自動化に焦点を当てた評価は、極端な結果、すなわちAIの研究開発の急速かつ大幅な自動化を検出するのに最も役立つのかもしれない。本研究は、AI研究者から直接得た提案に基づいて、評価の設計についていくつかの提案を示している。これらの提案が、さまざまなタスクと難易度にわたる評価の設計に役立つことを願う。主要な研究所や政府機関によってすでに開発が進められているこうした評価は、この極めて重要な分野でのAIの進歩を追跡できる可能性がある。
詳しくは、報告書の全文をご覧いただきたい。
謝辞:本研究は、AIの研究開発へのAIの貢献についての証拠基盤を築くために、英国 AI Safety Institute の資金提供を受けて行われた。