
レポート
ハードウェア障害はAIのスケーリングを制約しない
原題:Hardware failures won’t limit AI scaling
はじめに
計算能力は、モデルの能力向上を競ううえでの主要な原動力となっている。大手テック企業(Google、Microsoft、Meta、Amazon)はすでに、NVIDIA H100 GPU 200万基超に相当するAI計算インフラを保有している。フロンティアAIモデルの学習費用は2027年までにモデル1つあたり10億ドルを超えると予測されている。計算がこの規模になると、分散コンピューティングでますます重要になる課題が生じる。ハードウェア障害である。
その理由を理解するために、H100 GPU 1基が平均して5万時間(約6年)に1回故障するとしよう。すると、10万基のGPUからなるクラスターでは30分ごとに、100万基のクラスターでは3分ごとに障害が発生することになる。
こうした障害に対処するため、技術者は一つの重要な手法に頼る。チェックポイントである。チェックポイントでは学習の進捗を耐障害性のあるストレージに保存し、障害が起きた場合は、保存した進捗を正常に動くGPU群に読み込んで学習を再開できる。ここに最適化の余地が生まれる。チェックポイントが頻繁すぎれば貴重な計算時間を浪費し、少なすぎれば障害が起きたときに多くの進捗を失うおそれがあるからだ。
この研究では、学習クラスターが数百万基のGPUにまで拡大していく中で、ハードウェア障害とチェックポイントの戦略がAIモデルの学習時間に与える影響を分析する。最適なチェックポイント間隔を求める数理モデルを構築し、ストレージを適切に拡張しなければ、従来のストレージを使ったチェックポイント手法が学習の規模を制約しうることを示す。
しかし、別の手法を使えばこうした制約を克服できる。ストレージを使ったチェックポイントに頼らず、学習に参加する他のノードに分散したメモリを障害からの復旧に活用すれば、ハードウェア障害は実用上、学習の規模を制約しないことを示す。この結論は、Chinchilla 最適のスケーリング則にもとづいて将来のモデルの規模を考慮しても成り立つ。さらに、壊滅的な障害、メンテナンス、より効率的な通信パターンへの移行の可能性はチェックポイントの戦略に影響しうるものの、AIのスケーリングを制約することはないことも示す。
背景と現在の手法
システムの規模と障害の頻度の関係から、チェックポイントのオーバーヘッドが実際に学習を進める時間を上回る臨界点が生じる。スケーリングのパターンを考えてみよう。H100 SXM GPU 1基はおよそ5万時間に1回故障するが1、この頻度はハードウェアの数に比例して増える。その結果、16,384基のGPUからなるシステムでは平均3時間ごとに障害が起き、さらに大きな100万基のシステムでは3分ごとに障害が起きる2。
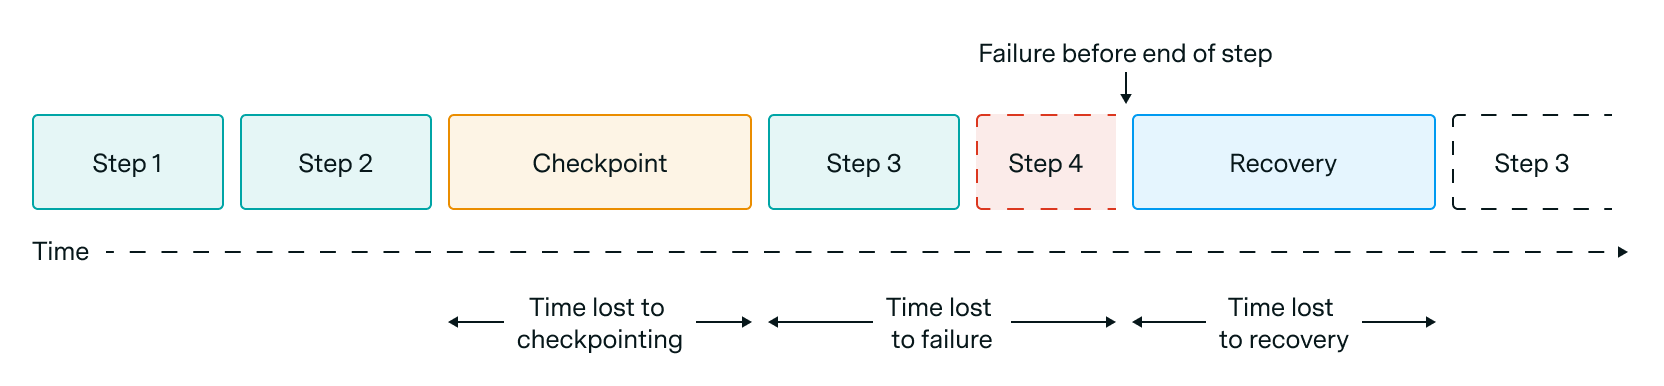
図1:チェックポイント、障害、復旧時間によって時間が失われるしくみを図示したもの。
GPUの障害による学習の中断には、3種類の時間コストがある(図1)。耐障害性のあるストレージにチェックポイントを保存するオーバーヘッド、最後のチェックポイント以降に失われる進捗、そしてシステムの復旧処理(ハードウェアの交換、ジョブへの再組み込み、チェックポイントの読み込みを含む)である。
チェックポイントの頻度には根本的なトレードオフがある。チェックポイントを頻繁に取れば障害による進捗の損失は最小限に抑えられるが、計算のオーバーヘッドが増える。障害の発生をポアソン過程でモデル化すれば、計算期間中に障害によって失われる時間の期待値を推定できる。
障害によって失われる時間の合計を とし、これをチェックポイントの間隔 の関数としてモデル化する。これは二つの項からなる。一つ目は、チェックポイントに費やす時間の割合 で、チェックポイントで失われる時間 との比である(たとえば、10分ごとにチェックポイントを保存し、その保存に5秒かかる)。二つ目は、障害が起きたときの再計算で失われる時間で、GPUの数()、GPU 1基あたりの故障率()(たとえば )、そして失われる時間の平均 の関数である。平均がこの値になるのは、障害が二つのチェックポイントの間の期間 のどの時点でも等しい確率で起こるからである。
これにより、失われる時間の割合の合計は次のようになる。
の関数として失われる時間の最小値を求めるには、微分して次の方程式を解けばよい。
この式から最適なチェックポイントの頻度 が得られ、その結果を に代入すれば、失われる時間の割合を計算できる3,4。
このモデルを Meta の Llama 3.1 405B の学習5に当てはめると、学習時間全体の約2.1%がチェックポイントと障害からの復旧に費やされたと推定される。最適なチェックポイントは4分ごとに行われ、1回に2.5秒かかる6。これは、学習期間全体でおよそ1%のMFU(モデルFLOP利用率)の損失に相当する7。
この速度でのチェックポイントがどの時点でさらなる規模拡大を制約するかを理解するには、システムの規模が大きくなってチェックポイントにかかる時間が障害の間隔に近づくシナリオを調べればよい。その時点で、厄介な悪循環が生じる。システムは実際の学習ではなく、チェックポイントと復旧にますます多くの時間を割くようになる。最終的には、学習を進めることよりも障害の対処に多くの資源を費やすようになり、大規模な学習が実行不可能になるおそれがある。Llama 405B を固定サイズのモデルの例とし、そのチェックポイント速度2.5秒を前提に、モデルのアーキテクチャも学習の他の設定もまったく同じまま単純にGPUの数を増やしていくと、この問題は約7,000万基のGPUで生じる。そこではシステムが、学習を進めるよりも障害の対処に多くの資源を費やすようになる8。
Meta の場合、チェックポイントの性能を主に制約しているのは、オプティマイザの状態を書き込む際のストレージ帯域幅 2TB/s である。復旧時にはさらに高い帯域幅が必要になる。データ並列の学習では、複数のGPUが部分的に重複したオプティマイザの状態を読み込まなければならないからだ。復旧に必要な正確な帯域幅はシャーディング戦略(ZeRO-1、2、3)によって異なるが、データ並列のランク数にもとづく単純な推定では、復旧時間は約5分となる9。
現在のチェックポイントのオーバーヘッドはAIのスケーリングをそれほど制約していないものの、モデルとクラスターの規模が大きくなるにつれて、ストレージとの接続がボトルネックになるおそれがある。そこで重要な問いが浮かぶ。耐障害性のある専用ストレージの必要性をまったく回避できるチェックポイントの戦略はあるのだろうか。
GPUメモリを使った別のチェックポイント戦略
チェックポイントに従来のストレージシステムを使う代わりに、GPUメモリを直接活用して障害に対処する二つのアプローチを検討する。一つ目のアプローチはチェックポイントを完全になくし、代わりにデータ並列のレプリカ(複製)を使って復旧する。二つ目のアプローチはチェックポイントのデータをクラスター全体に分散させ、各GPUの状態をクラスター内の他のGPUのメモリに保存する。復旧は、あらかじめ用意して予備として待機させておいたノードを使い、ストレージからではなく、複製を持つ他のGPUのメモリから直接読み込んで行う。Google DeepMind は、Gemini の学習で同様の戦略を使ったと説明している。
どちらの手法も、耐障害性を冗長なGPUメモリに頼っている。一方はシャーディングによってGPUのレプリカを維持し、もう一方は明示的なチェックポイントを使う。ここではチェックポイントのアプローチを取り上げる。学習の構成とは関係なく機能するからだ。これに対してシャーディングでは、コンテキスト長の変化に応じて並列化の設定を調整することがあり、各GPUの状態が完全に複製されていることを保証しにくくなりうる10。
Meta の Llama 405B の学習は、GPUメモリにチェックポイントを取るアプローチが現在の学習の最前線で実用可能であることを示している。具体的には、Llama 3.1 のチームは、チェックポイントに使ったメモリがGPU 1基あたりわずか4GBだったと報告している。つまり、GPU 1基あたり約76GBが空いており、活性化や勾配の保存に使えるほか、他のGPUのチェックポイントデータを保存することもできる。必要な計算量はモデルの規模の2乗に比例して増えるのに対し、メモリは1乗に比例して増えるだけなので、結果としてGPUの数(ひいては総メモリ量)が2乗で増え、チェックポイントの保存に必要な容量を常に上回る。
複製を保存しているGPU自体も故障しうるので、こうした障害対処のアプローチの有効性は複製数 に左右される。障害がノードの故障率 のポアソン過程に従うとすると、学習の1ステップ の間に障害が起きる確率は次のとおりである。
近似については脚注11を参照
必要な複製数を理解するために、障害の期待数 を、学習全体 にわたってモデル化できる。ここでいう障害は、 基のGPUからなるグループがまるごと故障して復旧が不可能になるもので、一度でも起これば学習は止まってしまう。
ここでの要点は、複製数 を増やすと、複数の独立した障害が同時に起こらないかぎりデータは失われなくなることだ。その可能性は、レプリカを一つ増やすごとに指数関数的に小さくなる。たとえば、DGX ノード単位で8基ずつまとめた1000基のGPUで60日間学習する場合(、)、バックアップのコピーが二つだけ()なら、学習533回に1回の割合で障害が起きる。しかしコピーが三つ()になると、障害の期待数はおよそ学習23億回に1回にまで激減する。レプリカを一つ増やすごとにこの安全係数が掛け合わされるので、 個のコピーを使えば、壊滅的な障害は極めて起こりにくくなる。
独立したレプリカの障害を除外できるとして、これらのアプローチではどれだけ速くチェックポイントと復旧を行えるのだろうか。チェックポイントでは 個のピアへのブロードキャストが発生するのに対し、復旧には1つのピアさえ利用できればよいので、律速となる操作としてチェックポイントに注目する。400Gb/s の H100 DGX のネットワーク接続を使う場合に、障害までの期待時間がチェックポイントに費やす時間と等しくなるのに必要なGPUの数を求めることができる。
これは、耐障害性のあるストレージに書き込んでいた以前の2.5秒と比べて、チェックポイントの速度が8倍改善したことになる。理論上の学習が実行可能な規模は、7,000万基から約5億6,000万基のGPUへと広がる。
Chinchilla にもとづくモデルの規模
Llama 405B の学習は現在のモデルの規模の目安になるが、数百万基のGPUを持つクラスターでこの規模のモデルを学習させることはないだろう。そうではなく、そもそも大きなクラスターを活用して、より大きなモデルを学習させるはずだ。そこで、さまざまなモデルの規模、ネットワークのトポロジー、最適化されたデータ移動を考慮した、GPUの数についてのより一般的なモデルが必要になる。
第一に、各GPUのシャードのコピーをクラスター全体に複数複製する必要はない。精度とオプティマイザの状態の係数を含めて と定義される、完全なオプティマイザの状態を一つ複製するだけで済むからだ12。このオプティマイザの状態を 個のピアノードに複製しなければならないので、クラスター全体でのネットワーク負荷の合計は となる。
この複製の速度は、クラスター全体の読み込み帯域幅によって制約される。GPU間の全対全通信を前提に設計された現在のシステムでは、GPUの数 と総帯域幅 の間に線形の関係があると仮定される。しかし、クラスターが数百万基のGPUにまで拡大すると、スイッチ段で集約を行う新しいハードウェアや、全対全通信よりも局所的な通信を優先する学習手法によって、この関係が変わるかもしれない。こうした将来の可能性に対応するため、線形()と平方根()の両方のスケーリング関係を、 の形で分析する。Blackwell 向けの NVIDIA の NVLink は小規模なクラスター(最大600基のGPU)で 900 GB/s を達成しているような専用ハードウェアもあるが、私たちは控えめに GPU間の接続速度を 50GB/s とし、どちらのスケーリングの仮定でも、システムの拡張性について同じ結論に至ることを確かめた。
第二に、モデルの規模をGPUの数に依存するものとして定義できる。Chinchilla のスケーリングに従う場合、計算量 はパラメータ数の2乗に比例し、 となるからだ13,14。この関係を使えば、最適なパラメータ数を三つの変数から決められる。GPUのピーク FLOP/s()、GPUの利用率()、そして であり、これらの積を使う。
H100 SXM の 989 TFLOP/s と50%のMFUを代入すると、次の簡単な式が得られる。
このGPUの数に依存するモデル規模の式を組み合わせ、、、 とすると、 について解くことができる。
現在のハードウェアの仕様では、障害の頻度がチェックポイントの時間に追いつくまでに維持できるGPUの最大数は、数百億基から数十垓(がい)基にまで及ぶ。この上限は、計算とネットワーク接続の相対的なスケーリングによって決まり、帯域幅のスケーリング( で表される)が決定的な役割を果たす。私たちの分析では、最上位のスイッチを経由した複製を仮定している。これはラック全体の停電のような局所的な障害から守るためだけに必要なものだが、実際の実装では近くのノードへの複製が好まれるだろう。こうした局所的な複製のアプローチは帯域幅の線形なスケーリングを支えるので、ハードウェア障害は将来の大規模な学習を制約する意味のある要因にはならないと結論できる。
待機中の予備ノード、メンテナンス、壊滅的な障害
現在の学習の手法のもとでは、ハードウェア障害が理論上スケーリングを制約することはないものの、工学的な課題は依然として大きい。実際には、新しいノードを一から用意するには何時間もかかることがあるが、100万基規模のGPUクラスターでは数分ごとに障害が起きるので、使われるのを待つ待機ノードの予備から即座に交換用のノードを出せるようにしておく必要がある。しかし、継続的に補充すれば、この予備は比較的少なくて済む。100万基のGPUクラスター(12万5,000ノード)で1時間あたり20件のノード障害が起き、交換に悲観的に見て1日かかるとしても、480ノード(容量の0.3%)の予備で足りる。手作業による対応が必要なために補充に数日かかったとしても、性能への影響は1%未満にとどまり、学習時間への影響は無視できる。
さらに最適化するなら、こうした待機中の予備ノードで、中断可能な優先度の低い処理を走らせて、クラスターの稼働率を保つこともできる。ただし、このアプローチの有効性は、ジョブのオーケストレーションシステム(SLURM、Kubernetes、MAST など)と、その中断・配備の性能に左右される。
クラスターのメンテナンスも課題であり、ドライバー、カーネル、ライブラリを定期的に更新する必要がある。Meta はこうした更新を、一度に少数のノードを更新してクラスターに戻す「メンテナンス・トレイン」という形で行っている。Llama 405B の学習期間中、こうした予定された更新はおよそ1日1回行われた15。しかし、AIの学習は同期的に進むため、ノードがそろっている必要があり、結局は更新の間に耐障害性のあるストレージへチェックポイントを取らなければならない。この運用上の制約が将来のスケーリングを制約することはないと見込まれる。システムはすでに障害からの復旧のために堅牢なチェックポイントの仕組みを使っており、耐障害性のあるストレージへのチェックポイントにどれだけ時間がかかろうと、それをメンテナンスの時間帯に流用できるからだ。
クラスターの規模に比例して増えるハードウェア障害のほかにも、考慮すべき障害の形態がある。この比例の性質を持たない障害(たとえば、ソフトウェアが持ち込むバグ)もあれば、クラスターの規模そのものによって起こりやすくなる障害もある。地震、ハリケーン、停電、宇宙線、さらには火災は考慮に入れていない。メモリを使った複製によって個々のハードウェア障害の影響は無視できるようになるので、こうしたシステム全体に及ぶリスクが主な懸念になる。それに対処するには遠隔のストレージを使ったチェックポイントが必要だが、それが学習速度に影響するのはチェックポイントを取っている間だけであり、規模を根本的に制約するわけではない。
結論
この記事では、現在と将来のチェックポイントの戦略と、それがモデルやクラスターのスケーリングとどう関わるかを分析することで、ハードウェア障害が実行可能な最大の学習に与える影響を推定した。主な結果は次のとおりである。Chinchilla にもとづくスケーリングにおおむね従い、障害の頻度が5万GPU時間に1回程度のままだと仮定すると、チェックポイントがAIの学習の規模を制約することはない。少なくとも近い将来や中期的な将来にはそうである。
耐障害性のあるストレージを使う現在のチェックポイントの戦略では、7,000万基のGPUで障害が学習の進行にとって決定的な問題になることが分かった。現在のハードウェアとモデルの規模で、豊富なGPUメモリ容量を活用してチェックポイントを保存すれば、この限界は5億6,000万基のGPUにまで押し上げられる。将来のモデルの規模や、現在の学習パラダイムの変化を考慮しても、学習の実行可能性に意味のある影響を与えるようなクラスター規模の実用上の上限は見当たらなかった。
この結論には三つの含意がある。第一に、通信パターンが現在の全対全のアプローチを超えて進化したとしても、ハードウェア障害がAIの学習の拡張性を制約することはない。第二に、高帯域のストレージシステムはもはや障害からの復旧に不可欠ではないので、ストレージのインフラは、チェックポイントよりも主に学習データの取り込みに向けて最適化できる。最後に、私たちの理論的な分析ではスケーリングの余地が十分にあるものの、こうしたGPUメモリを使ったチェックポイント手法を完全に実装するには、まだかなりの工学的な作業が残っている。現時点でそれを実証しているのは Google だけである。
謝辞
研究上の助言をくれた Robi Rahman、Jaime Sevilla、Tamay Besiroglu の各氏に感謝する。図とトップ画像をデザインしてくれた Robert Sandler 氏と、ウェブ開発を担当してくれた Andrew Souza 氏には特に感謝する。
付録A:チェックポイントの一般的なモデル
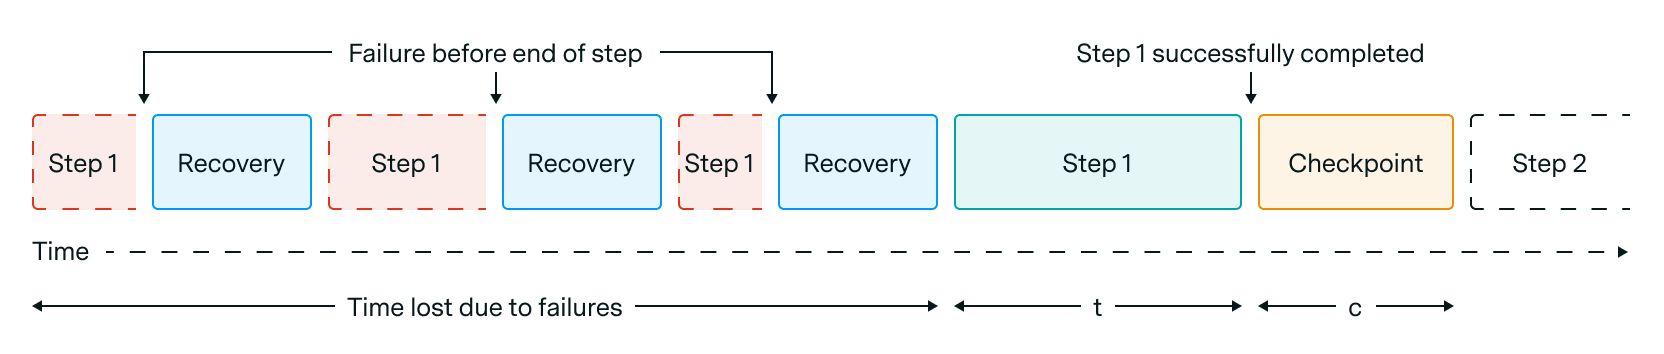
図2:障害までの期待時間(\(g \lambda\))がチェックポイントの平均間隔(\(t\))より短い場合、失われる時間の平均は、障害による再計算をすべて合計したものになる。
本文の近似モデルは、障害までの期待時間 がチェックポイントの間隔 より短い場合には成り立たなくなる。有用な作業の1区間の間に障害が複数回起こる場合、失われる時間の平均は ではなく、1つの不可分なステップが無事に完了するまでに重複して行った計算の合計になる(図2)。この挙動をモデル化する一般的な方法は、チェックポイントに到達するまでに複数回起こる障害に費やされる時間を明示的にとらえることであり、ここではそれを詳しく説明する。
次の障害までの時間が平均 の指数分布に従い、チェックポイントの時間間隔を 、チェックポイントごとに失う時間を とする。
すると、あるチェックポイントから次のチェックポイントまで到達するには、指数分布から変数 を、 となる最初の標本が得られるまで抽出していくことになり、かかる時間は次のようになる。
ここで は、 以上の値として抽出された最初の確率変数である。 も確率変数なので、この和は次のように表せる。
期待値をとると、すべての が独立であることから、次が得られる。
閉じた形では、この期待値は次のように計算できる。
これは、連続する二つのチェックポイントの間に 秒の「実際の進捗」が必要なときに、チェックポイント1回あたりにかかる時間である。学習に必要な有用なクラスター時間が一定だとすると、全体で必要なチェックポイントの回数は t に反比例するので、学習にかかる総時間は次の値に比例する。
したがって目標は、この式を最小にする を選ぶことである。微分して導関数をゼロとおくと、次の解が得られる。
ここで W はランベルトのW関数であり、ここでは主枝の値をとるものと解釈する。障害の間隔が、各チェックポイントの完了に必要な時間よりはるかに長く、 となる場合には、ランベルトのW関数の主枝の展開
( のまわりでの展開。Corless et al. 1996)を使って、次を得る。
パラメータ はクラスターのハードウェア故障率に対応し、 と表せる。ここで はGPU 1基あたりの故障率、 はクラスター内のGPUの数である。これにより、次の妥当な近似が得られる。
これは の領域で成り立つ。逆の の領域では、代わりにランベルトのW関数の主枝の漸近展開
を使って、次を得る。
失われる時間をモデル化する関数とその導関数は、Python で次のように実装できる。
import numpy as np
import math
from scipy import special

def optimal_checkpoint_interval_approx(c, g, f):
    return math.pow(2*c / (g * f), 1/2)

def fraction_time_lost_approx(t, c, g, f):
    return (c / t) + (g * f * t) / 2

def optimal_checkpoint_interval(c, g, f):
    lambda_ = g*f
    return (1 + special.lambertw((c * lambda_ - 1) / np.e).real) / lambda_

def time_lost_percentage(c, t, g, f):
    lambda_t = g * f * t
    return ((np.exp(lambda_t) - 1) / lambda_t + c / t) - 1

c = 2.43 / 3600 # in hours
f = 1 / 50000 # in GPU-hours
g = 16384 # GPUs
t = optimal_checkpoint_interval(c=c, f=f, g=g)
time_lost = time_lost_percentage(c=c, t=t, g=g, f=f)
注
-
Meta による Llama 3.1 405B モデルの学習は、16,384基のGPUを使って54日間にわたり、学習期間中に419回の障害に見舞われた。16384 GPU × 54日 ≈ 88万GPU日、88万GPU日 / 419回の障害 ≈ 障害1回あたり2100GPU日 ≈ 障害1回あたり5万GPU時間。 ↩
-
GPUの信頼性を正確に評価するには二つの難しさがある。小さな規模では障害がめったに起こらないこと、そしてメーカーが障害のデータをほとんど公表しないことである。ハードウェアには通常、製造上の欠陥や設置の問題によって故障率が高くなる初期の慣らし期間があるため、報告された故障率が代表的なものかどうかを確かめるのは難しい。Meta のAI学習専用クラスターからは、安定期に稼働している H100 GPU の信頼性について貴重なデータが得られるので、この記事では一貫してそのデータを使っている。 ↩
-
このモデルを第一原理から導いた後で、それが 1974年の Young の論文にさかのぼるモデルと同一であることに気づいた。ただし Young は、失われる時間をモデル化する出発点として指数分布を使っている。二つの式が等価であることを確かめるには、 を に、 を に置き換えればよい。 ↩
-
このモデルは、障害が障害の間隔 よりはるかにまれにしか起こらないことを仮定しているが、非常に大きなクラスターではこれが成り立たないかもしれない。この点を考慮に入れた、より一般的なモデルを付録Aに示す。 ↩
-
失われる時間2.1%は、Llama 405B の論文にある次のパラメータをモデルに代入して得たものである。チェックポイントの時間:405B × パラメータあたり3個の数値 × 4バイト = 4860GB、4860GB / 2TB/s = 2.43秒。故障率:1/50000 GPU時間。GPU数:16384。 ↩
-
MFU 41% ×(稼働時間100% − 失われる時間2.1%)= 40.14% ↩
-
5万GPU時間 / 2.5秒 = 7,200万基のGPU ↩
-
データ並列ランク128 × オプティマイザの状態4860GB / 2TB/s / 60秒 = 5.1分 ↩
-
たとえば、オプティマイザの完全なシャーディング(ZeRO-1)は不可能になる。オプティマイザの状態がすべてのGPUに均等に分割され、どのGPUも丸ごと複製されることがないからだ。データ並列の構成でさえ学習中に変わることがあり、実際には複製を行いにくくなりうる(たとえば Llama 405B の学習中。同論文の表4)。 ↩
-
x が非常に小さいときのテイラー級数による近似:、 ↩
-
AdamW はパラメータあたり3個の数値を使う。1)パラメータそのもの、2)()1次モーメント、3)()2次モーメントの推定値である。 ↩
-
Chinchilla:D = 20N、FLOPの推定 C=6ND、C=6N(20N)=120N^2 ↩
-
推論実行のコストを下げる経済的な動機から、Chinchilla 最適の水準を超えて過剰に学習させることがありうる。パラメータあたりのトークン数の比()を高くすれば、性能を保ちながら、より小さく効率的なモデルにできるからだ。そうなればチェックポイントの性能は上がり、私たちの分析はいっそう当てはまるようになる。 ↩
-
学習期間中、Meta は54日間で47回の計画的な中断を行った。 ↩