
レポート
「Semi-informative priors over AI timelines」を深く理解する
原題:Grokking “Semi-informative priors over AI timelines”
注記:
- 本稿では、Tom Davidsonの報告書「Semi-informative priors over AI timelines」を図解し、その主要な仮定と直観をまとめる。
- 図はこちらで見られる。一部のボックスをクリックすると、報告書の該当する部分へのリンクに飛べる。1
フィードバックと支援をくれたEpoch AIのチームに感謝する。とりわけ、詳細なフィードバックをくれたJaime SevillaとTom Davidsonに感謝したい。
要旨
「Semi-informative priors over AI timelines」の枠組みは、AGIの開発を一連のベルヌーイ試行とみなすモデルを仮定している。つまり、暦年の1年1年を、一定の確率 で成功するAGI構築の「試行」として扱う。
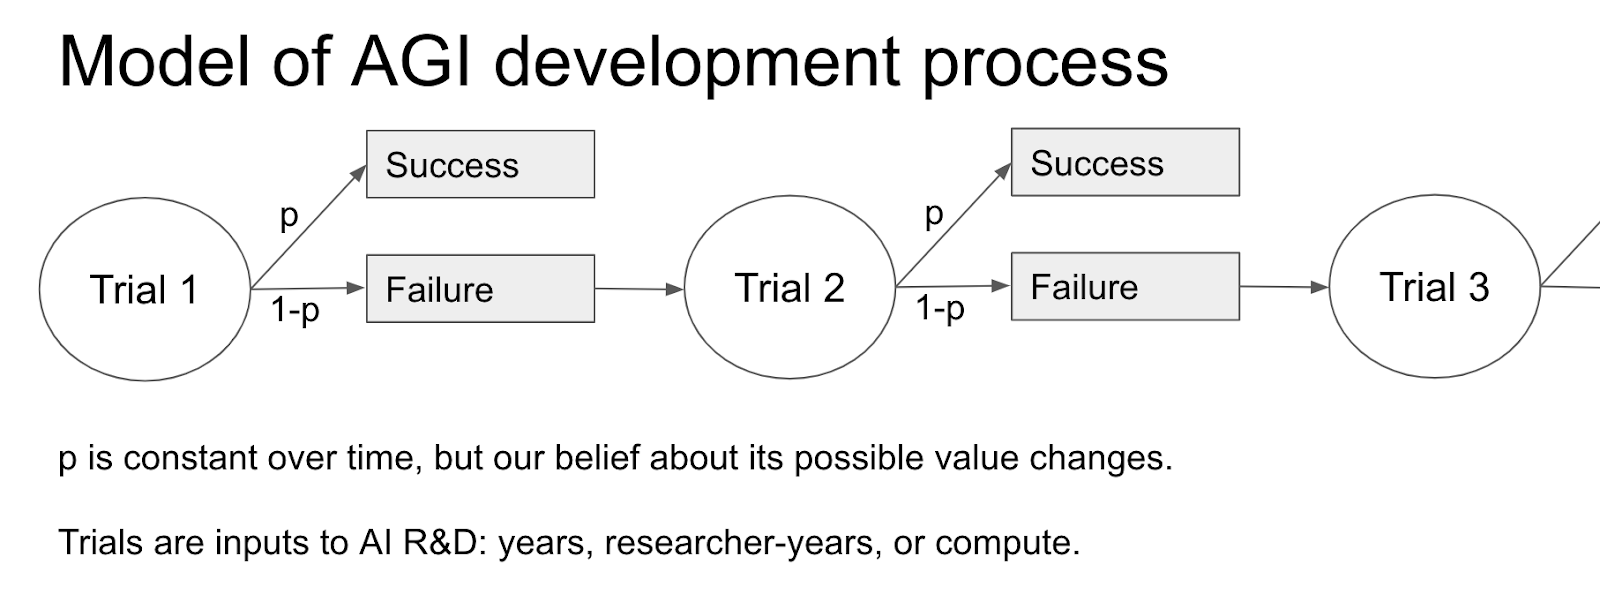
画像の出典:Davidson, 2021
しかし、この の値はわからないので、ラプラスの継起の規則を一般化したものを使って を推定する。そのためには、初回試行確率、つまりAI研究の最初の1年でAGIの構築に成功する確率と、仮想的な成功の数を指定する。後者は、証拠に基づいて の推定をどれだけ速く更新すべきかを決める。この枠組みは初回試行確率に非常に大きく依存しており、初回試行確率は参照クラスの主観的な選択によって決まる(詳しくはこちら)。
得られる証拠の量は、観察される試行の数によって決まり、試行の数は体制の開始時点によって決まる。これは、それ以前にAGIの開発に失敗していても、後の試行での成功確率について有益なことは何もわからない、という時点だと考えればよい。たとえば、1956年(ダートマス会議の年)が、人々が本格的にAGIの構築を試み始めた最初の年だと考えるなら、1956年以前にAGIがなかったことはあまり情報にならない。各試行を暦年の1年と考えると、体制の開始時点から2021-1956 = 65回の試行があり、それでもまだAGIは開発されていない。したがって65回の失敗した試行があり、これを使って を更新する。このとき「来年」は1957年ではなく2022年にあたる。
だが、なぜ試行が暦年の1年に対応しなければならないのか。答えは、その必要はない、ということだ! Davidsonは全部で三つの試行の定義の候補を検討している。
- 暦年試行:1試行 = 暦年の1年
- 計算量試行:1試行 = これまでにAIシステムの開発に使われた最大の計算量が1%増えること
- 研究者年試行:1試行 = これまでの研究者年の合計が1%増えること
この推論を延長すれば、AGIが 年後までに構築される確率を予測できる。Davidsonはこれを使って、 を次のように予測している。
この枠組みは、観察による証拠に基づく情報をわずかしか取り込まず、AIの到来時期について「半情報的な事前分布(semi-informative priors)」を与える、というのが基本的な考え方である。枠組みをもう少し詳しく示すと、次のようになる。
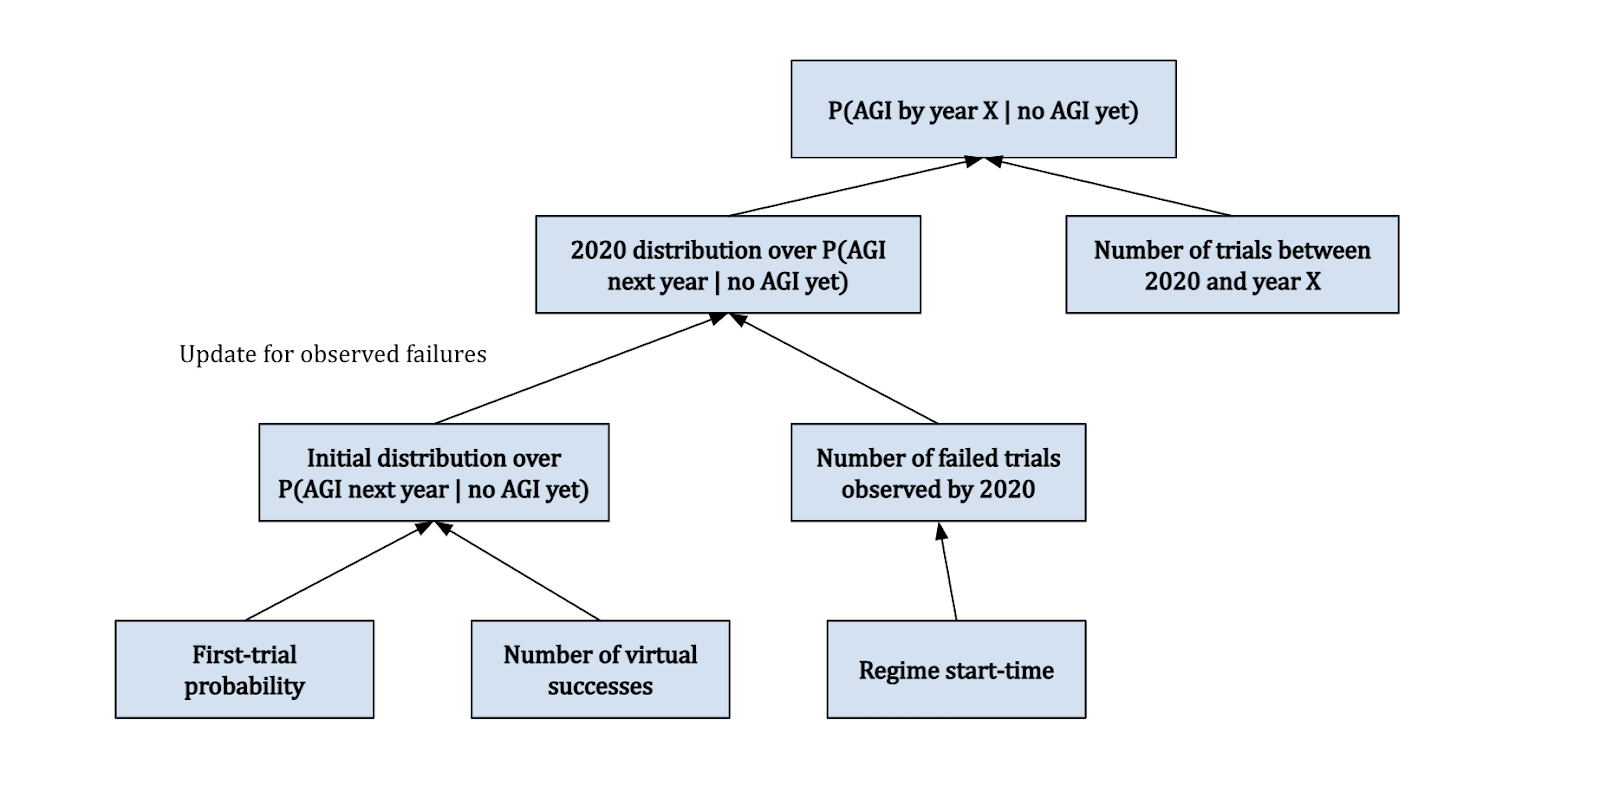
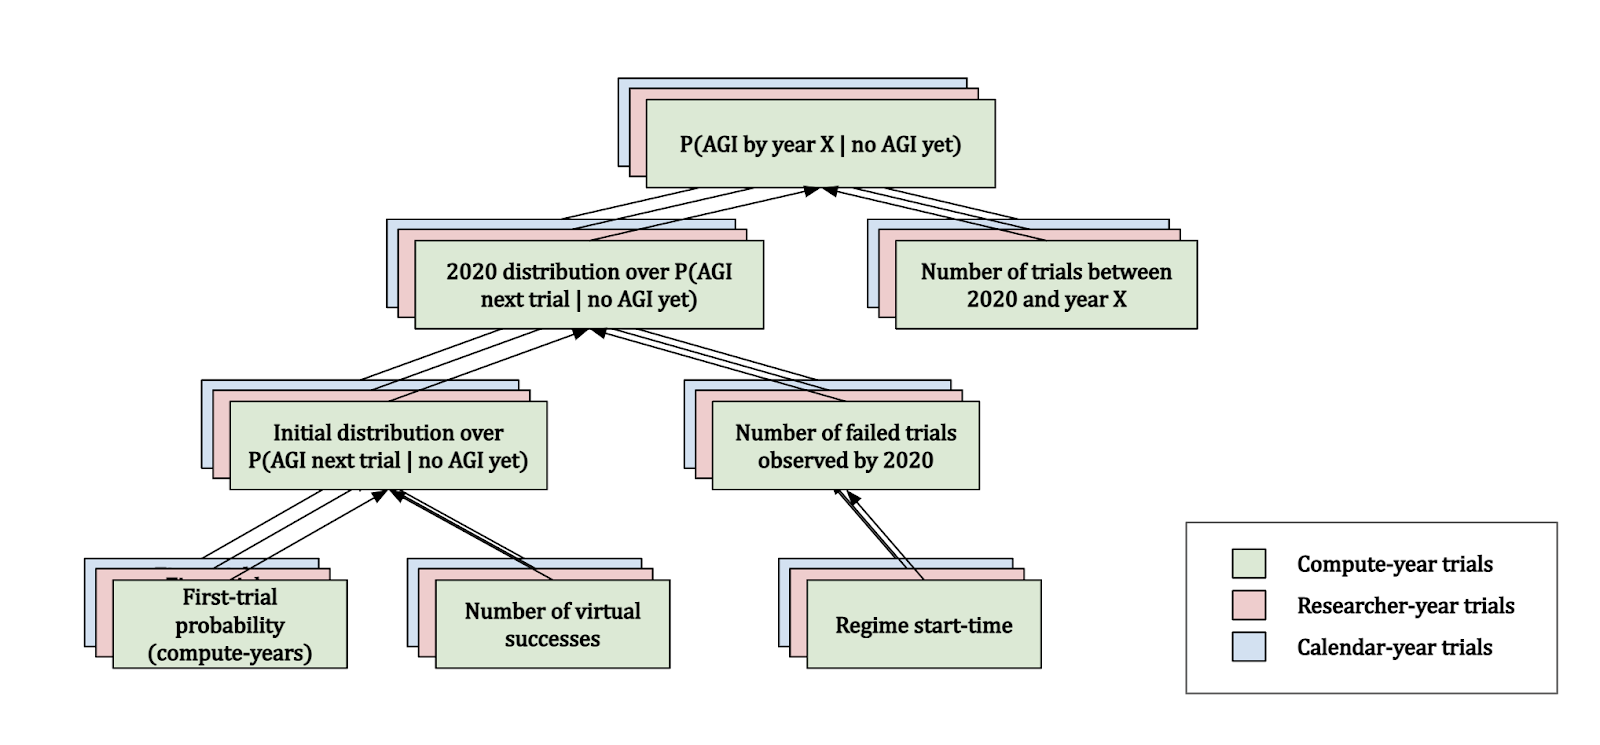
Davidsonは三つの異なる試行の定義を使っているので、実際にはこうした図が三つ得られる!
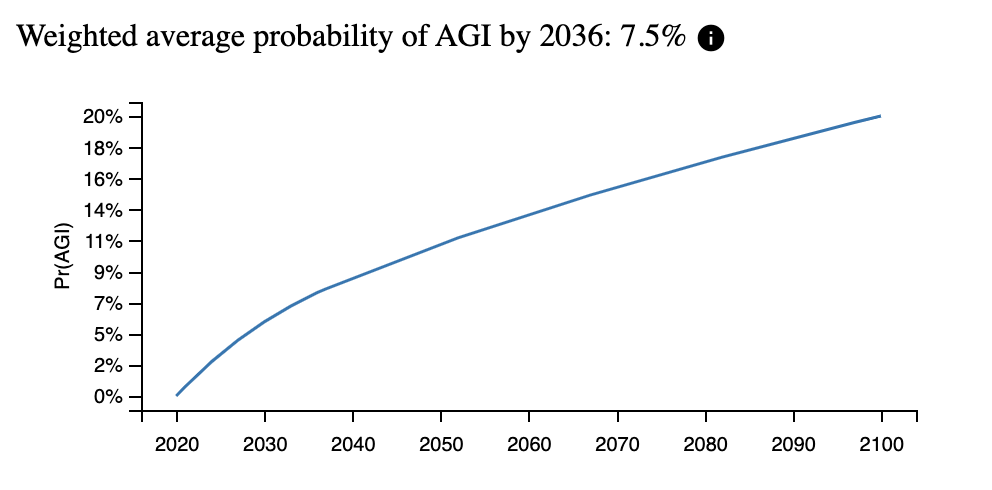
全体として、Davidsonはこれを使って という中心推定値を得ており、累積確率関数は次のようになる。
動機
AIの到来時期(タイムライン)を予測する一つの方法は、AIの内部の仕組みを考え、どんな種類の進展が最も重要かを推測し、そこから汎用人工知能(AGI)がいつ開発されるかについての確率分布を作ることである。これはAjeya Cotraが「Forecasting TAI with biological anchors」でとったアプローチである。同書は非常に詳細な報告書の草稿で、人間の脳との類推を使って、変革的AI(TAI)が最初に開発される時期を予測している。2
Tom Davidsonの報告書「Semi-informative priors over AI timelines」も、AIの到来時期を予測する詳細な報告書だが、Cotraの報告書とは異なるアプローチをとっている。AI開発の詳細を考えるのではなく、それについてほとんど何も知らないと仮定するのである3!
本稿の目的は、図をふんだんに使ってこのモデルを説明し、その仕組みについての大まかな直観をつかんでもらうことにある。それがAI予測についての読者の研究や理解に役立てば幸いだ。
ラプラスの継起の規則
AGIが最初に開発されるのはいつかを知りたいが、世界について知っていることは、これまでに 年が経過し、そのどの年にもAGIが開発されなかったということだけだとしよう。来年AGIが開発される確率をどう決めればよいだろうか4。
素朴なアプローチの一つは、各年を二つの結果がありうる「試行」と考えることだ。(1)対象の年にAGIの構築に成功する成功した試行と、(2)対象の年にAGIが構築されない失敗した試行である。そのうえで、来年AGIが構築される確率は、成功した試行の総数を試行の総数で割ったものだと仮定する。
過去 年のどの年にもAGIは構築されていないので、 回の試行のうち成功は0回である。したがって、来年AGIが開発される確率は0だと結論づけることになる……が、これは明らかにどこかおかしい!
問題は、AGIがいつか開発される可能性を、このアプローチがそもそも考慮していないことだ。まだ発明されていない技術について成功の数を数えるだけでは、あまり役に立たない。成功と失敗の両方の可能性を考慮するように、このアプローチをどう修正すればよいだろうか。
巧妙な方法の一つは、「仮想的な試行」を考えることである。各試行が成功か失敗のどちらにもなりうるとわかっているなら、それは、以前に「仮想的な成功」を1回、「仮想的な失敗」を1回観察したのと同じことだ。これらをそれぞれ観察された成功と失敗の総数に加えればよい。すると、式は次のように修正できる。
この式はラプラスの継起の規則と呼ばれ、過去に一度も観察されたことのない事象の確率を推定するアプローチの一つである。特に、試行の数と成功・失敗の数以外、世界について何も知らないことを仮定している。
この方法を当てはめると、来年AGIが構築される確率は になる。AIという分野が1956年の有名なダートマス会議で生まれたと仮定すれば、 で、、つまり約1.5%の確率になる。
この推論を延長すれば、AGIが 年後までに構築される確率を予測できる。Davidsonはこれを使って、 を次のように予測している。
これは素朴なアプローチよりはるかに妥当に思えるが、それでもまだ、たとえば次のような深刻な問題がある。
- 証拠を考慮する前の段階では、極端に強気である:たとえば、ラプラスの規則に従えば、1956年のダートマス会議の出席者は、AI研究の最初の1年でAGIが開発される確率を50%、最初の10年以内なら91%と予測すべきだったことになる!
- 「試行」の定義に左右されやすい:各試行を1年ではなく「1日」としていたら、結論はかなり違っていた可能性がある(詳しく)。
ここで起きているのは(ほかにもあるが)、継起の規則が事前の仮定をほとんど置かない、つまり無情報事前分布だということである。実際、あまりに情報がないので、研究開発の最初の1年で変革的な技術を構築するのはよくあることではない、という直観さえ捉えられない! AGIの到来時期を予測しようとするなら、もっとよいものがまだ必要なのは明らかだ。
事前分布をもう少し情報的にする
Davidsonが提案する解決策は、AIの研究開発についての常識的な直観と証拠をいくつか取り入れて、この事前分布をもう少し情報的なものにすることである。ラプラスの継起の規則が与える枠組みをより詳しく見ると、それがいくつかの要因に依存していることがわかる。
- 体制の開始時点:それ以前にAGIの開発に失敗していても、後の試行での成功確率について有益なことは何もわからない、という時点だと考えればよい。ここまでは1956年と仮定してきたが、そうである必要はない!
- 初回試行確率:体制の開始時点以降の最初の「試行」で成功する見込み
- 試行の定義:なぜ「1年」を1回の試行としているのか。他にどんな選択肢があるのか。
仮想的な成功の数という形で、もう一つ修正を加えることもできる。これは、新たな証拠が得られたときに、初回試行確率からどれだけ速く離れて更新するかに影響する。仮想的な成功が多いほど、AGIの構築がどれほど難しいかについての不確実性は小さくなり、そのため失敗した試行を多く観察しても更新の度合いは小さくなる。たとえば、最初の が1/100だとしよう。
- 仮想的な成功1回から始めた場合、100回の失敗した試行を観察した後、更新された は1/200になる
- これに対し、仮想的な成功10回から始めた場合、100回の失敗した試行の後、更新された は1/110になる
ここまでは来年AGIが開発されるかどうかを予測することを考えてきたが、本当に知りたいのは、AGIがそもそも開発されるとして、それはいつなのかである。Davidsonはこれに答えるため、一連の試行からなり、各試行が一定の確率 で成功するという、単純な開発モデルを仮定している。5この確率は と同じではないことに注意してほしい。後者は の値についての私たちの信念に対応するもので、 そのものとは異なる。
画像の出典:Davidson, 2021
分布 への四つの入力を、常識といくつかの関連する参照クラスを使って決めたとき、Davidsonはこの分布をAGIの到来時期についての「半情報的な事前分布」と呼ぶ。AGIへの進歩に原理的には影響しうる厄介な要因を山ほど考えるのではなく、最も関連がありそうな、選び抜いたいくつかの入力だけを見るのである。
Davidson (2021)をもとに作成
上の図は、枠組みがどう組み立てられているかを示している。初回試行確率と仮想的な成功の数を使って、来年AGIが開発される確率についての初期分布を作る。次に、指定した体制の開始時点に応じて、観察された試行に基づく2020年時点の証拠でこの分布を更新する。これにより、 についての2020年時点の分布が得られる。これを2020年から対象とする年 までの試行の数と組み合わせると、 についての最終的な分布が得られる。なお、これは実際には試行の定義にも依存する。これが図のどこに当てはまるかは後で論じる。
半情報的な事前分布を解き明かす
基本的な枠組みができたので、あとは入力変数(つまり、初回試行確率、仮想的な成功の数、体制の開始時点、試行の定義)にどんな値を割り当てるべきかを考えればよい。Davidsonは(感度分析によって)この四つの入力要因のうち初回試行確率が最も重要だと考えているが、いずれもかなり主観的な判断に基づいている。
それぞれを順に見ていこう。
初回試行確率
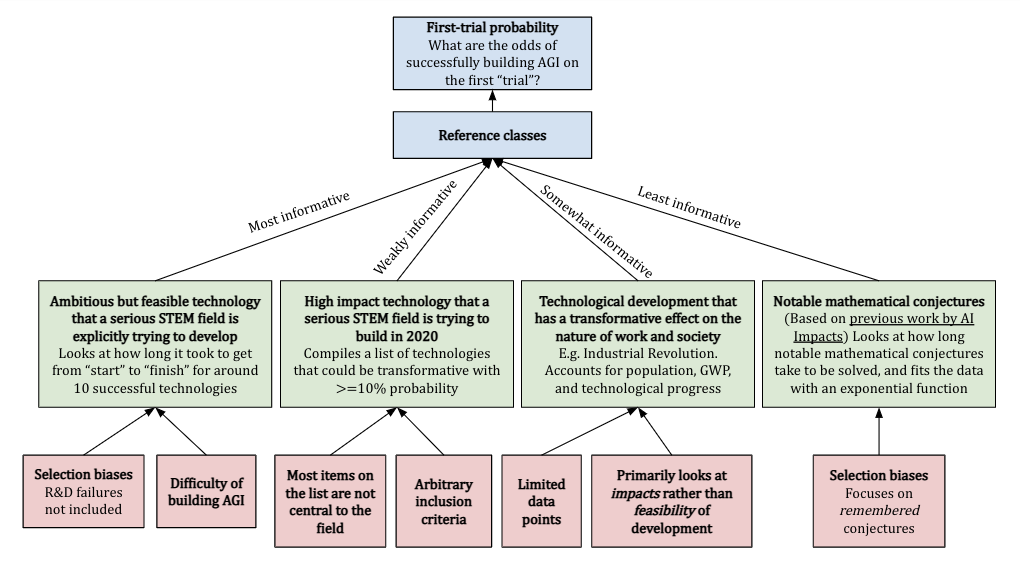
初回試行確率は、「最初の『試行』でAGIの構築に成功する確率はどれくらいか」を問うものである。これを表面的な検討だけで決めるのは非常に難しいので、Davidsonはいくつかの参照クラスから歴史上の事例を引いている。具体的には次のものを調べている。
- 本格的なSTEM分野が明示的に開発を目指している、野心的だが実現可能な技術の事例約10件(これと同じように、AIという分野は、AGIという野心的だがおそらく達成可能な目標の実現を明示的に目指している)
- 2020年に本格的なSTEM分野が構築を目指している技術のうち、社会に変革的な影響を与えうると考えてもおかしくないもの
- 仕事と社会のあり方に変革的な影響を与えてきた過去の技術
- 注目すべき数学上の予想と、それらが(実際に解決されたのなら)解決までにかかった期間
Davidsonはこれらの参照クラスを使って、初回試行確率に対する制約を導いている。そのためには、過去の事例から成功した試行の基準率を求めればよい。これらの事例のほとんどは最初の試行では成功していないので6、彼が使う方法の一つは、 回の試行の後に成功がいくつあるかを調べ、ラプラスの規則を使って逆算するというものだ。最終的に彼は、初回試行確率の最善の推測値として4%に落ち着いている。
注意しておきたいが、枠組みの最も重要な部分は、これらの参照クラスと、他の試行の定義に基づく上方修正である。どの参照クラスを選ぶかで、最終的な結論は大きく変わる。
仮想的な成功の数
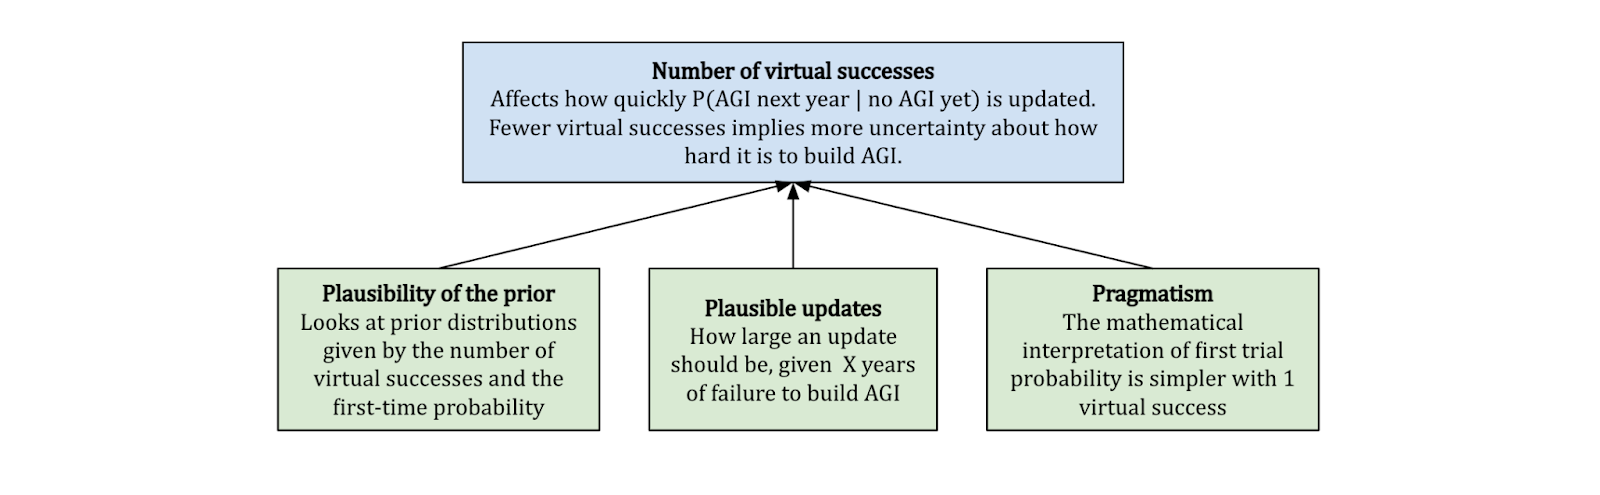
仮想的な成功の数によって、失敗した試行を観察したときにどれだけ速く更新すべきかが変わる。7更新の大きさは妥当なものであってほしいので、この数は大きすぎても小さすぎても困る。Davidsonは最終的に、実用性、事前分布のもっともらしさ8、新たな証拠を得たときの更新の大きさのもっともらしさを組み合わせて、報告書の大部分で仮想的な成功を1回としている。9
初回試行確率が低いときには、仮想的な成功の数をどう選んでもあまり違いは出ない。最初の事前確率がすでに小さければ、事前分布から(比率として)大きく更新しても、絶対的な意味ではあまり影響しないからだ。
体制の開始時点
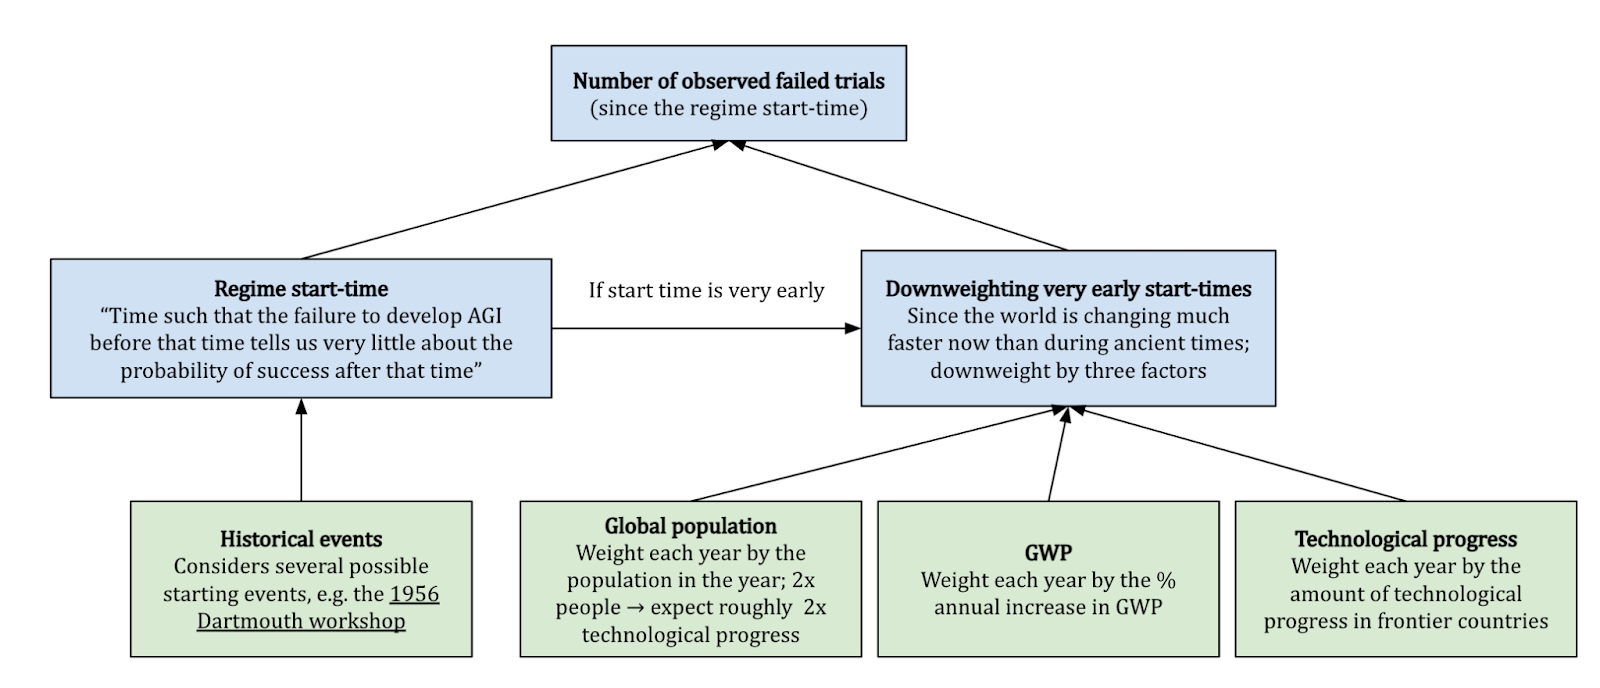
体制の開始時点とは、「それ以前にAGIの開発に失敗していても、それ以降の成功の確率についてはほとんど何もわからない」という時点であり、観察される失敗した試行の数に影響する。先ほどは1956年のダートマス会議をAI研究の自然な出発点と考えたが、他の候補(たとえば、最初のデジタルコンピューターが作られた1945年)も妥当に思える。
どの年にもAGIが一定の確率 で開発されると仮定することの問題は、非常に早い開始時点を考えると特に際立つ。人々は古代から仕事の一部を自動化しようとしてきたと主張して、それに合わせて開始時点を選んだとしよう。すると、この枠組みに従えば、古代のどの年にAGIが構築される見込みも、今日と同じだということになってしまう!
Davidsonはこの問題に対処するため、各年にその年の世界人口または経済成長を(正規化したうえで!)掛けることで、古代に行われた試行の数を現代に比べて割り引いている。10全体として、彼は1956年という開始時点を最も重視しているが、いくつかの代替案で感度分析も行っており、適切な割り引きを施せば、それらによって結論が大きく変わることはない。
試行の定義
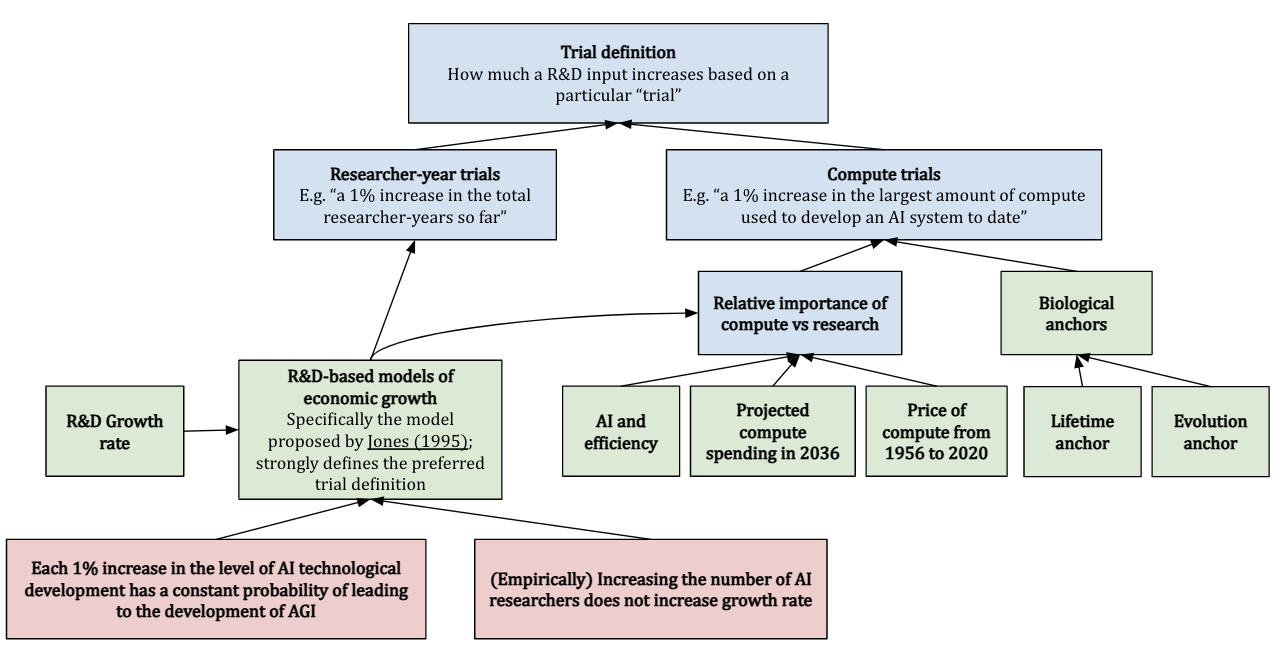
枠組みへの最後の入力は試行の定義であり、AGIの構築に向けた1回の「試行」が正確に何からなるかを定める。最初に検討したアプローチは暦年によるものだったが、たとえば次のような妥当な代替案もある。
- 計算量試行:計算量に基づく試行。たとえば、1試行 = 「これまでにAIシステムの開発に使われた最大の計算量が1%増えること」。この試行は、学習計算量の増加がAIの進歩の主な原動力であることを暗に仮定している11
- 研究者年試行:これまでに費やされた研究者年の数で定義される試行。たとえば、1試行 = 「これまでの研究者年の合計が1%増えること」。これは事実上、「AI技術の発展水準」が1%上がるごとにAGIが開発される確率が一定だと仮定していることになる。12
Davidsonは暦年による定義とあわせてこの二つの候補も検討し、どの試行の定義を選ぶかで、得られる確率が多少変わりうることを見出している。事実上、試行の定義に応じて、三つの別々の枠組みができることになる。
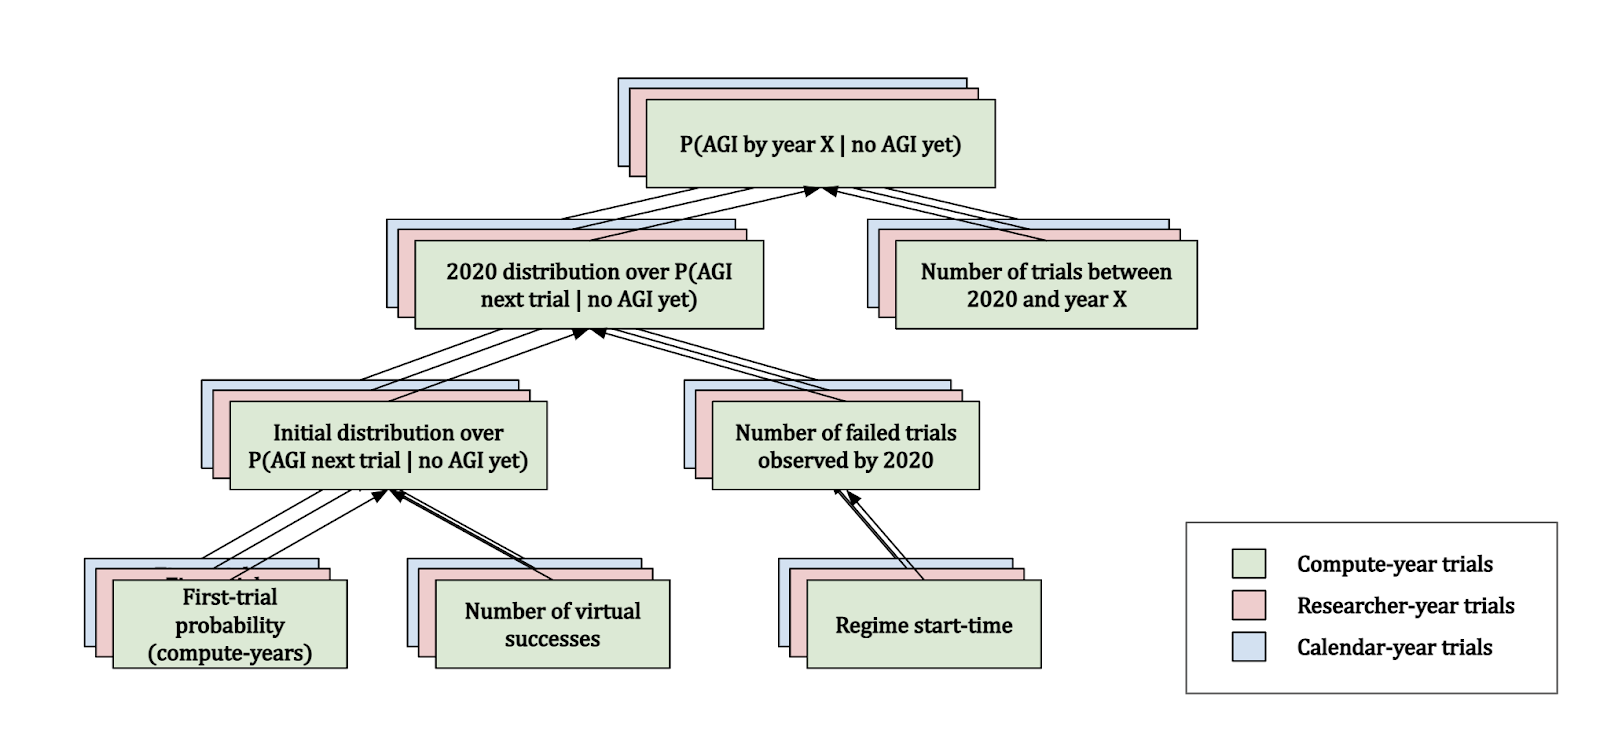
試行の定義を変えれば、おそらく初回試行確率も変わるはずだ。では、それはどう計算すればよいのか。Davidsonがとるアプローチの一つは、計算量試行と研究者年試行の初回試行確率を、暦年試行の初回試行確率から算出するというものである。ここでは詳しく立ち入らないが、さらに知りたい場合は報告書のこれらの節を見てほしい。
仮想的な成功を1回、体制の開始時点を1956年と仮定すると、次の結果が得られる。
P(AGI by 2036) | |||
試行の定義 | 低い側 | 中心推定値 | 高い側 |
暦年 | 1.5% | 4% | 9% |
研究者年 | 2% | 8% | 15% |
計算量試行 | 2% | 15% | 25% |
表の出典:Davidson, 2021
重要な点として、初回試行確率をうまく選べば、試行の定義を少し変えても予測が変わらないようにできる。これは、ラプラスの継起の規則を当てはめる際の、先に述べた問題の一つの解決に役立つ。13全体として、Davidsonは検討した三つの試行の定義それぞれに⅓の重みを割り当てている。
まとめ:最終的な分布
モデルの拡張
この枠組みでは、ここまで述べてきたものに加えて、三つの拡張も検討している。
- AGIの連言モデル:AGIの開発を、複数の独立したタスクがすべて達成されること(連言)として扱うことを検討する
- 更新規則に対する超事前分布:異なる更新規則にどんな重みを割り当てるかについての事前分布を更新する。更新規則そのものは四つの入力によって決まる14
- AGIが不可能である確率をある程度認める
ほとんどの場合、これらの拡張は最終的な数値と結論にそれほど大きな影響を与えない。
最終的な分布
以上をすべて組み合わせると、次の分布と予測値が得られる15。
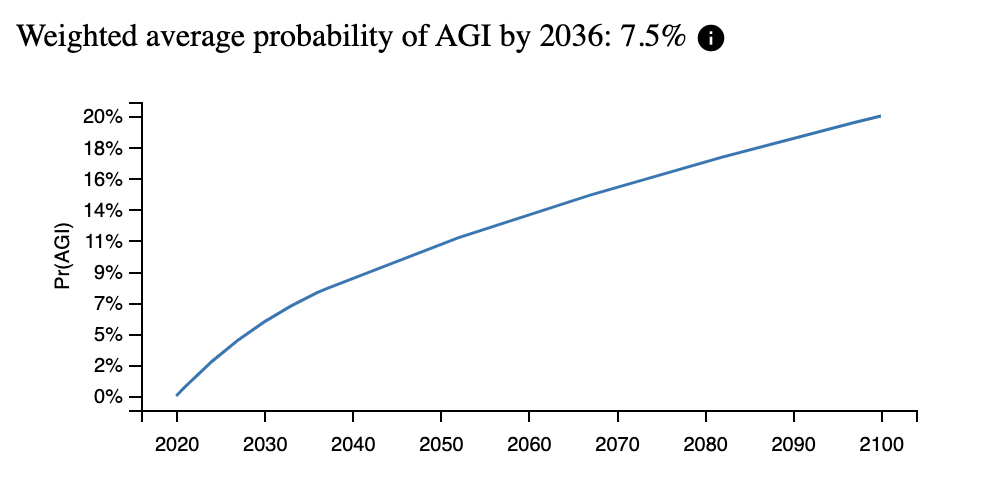
P(TAI before 2030) | P(TAI before 2050) | P(TAI before 2100) |
~6% | ~11% | ~20% |
10% | 50% | 90% |
~2044 | >2100 | >2100 |
Davidsonは、自身の枠組みの主な長所として次の三つを挙げている。
- 観察された失敗に基づく の更新の大きさを定量化する
- 直観的なパラメータの重要性をはっきりさせる。たとえば、初回試行確率、体制の開始時点、試行の定義である
- AGIの到来時期についての深い不確実性を表すのに適していると言える。たとえば、「AGIに向けた研究のうちどれだけを終えたか」についての主張を避けている
彼はまた、枠組みの主な弱点もいくつか指摘している。
- 非常に有益になりうる証拠のうち、取り込める種類が限られている。たとえば、AGIにどれだけ近づいているかである
- 近い将来についての予測が高すぎる。現在のAIシステムはAGIにはまったく及ばない能力しか持たないが、枠組みはこの証拠を考慮していないからである16
- AGIの定義に小さな変更を加えても反応しない
- 各試行の成功の見込みが一定だと仮定している(ただし、拡張で提案されたAGIの連言モデルはこの仮定を緩めている)
また、この枠組みを使うのが理にかなわない状況もある。たとえば、ある目標の達成に向けて「進歩のどれだけの割合」をすでに達成したかがわかっている場合である。AGIの開発についてこれを定量化するのは難しいかもしれないが、実はこれは、Median groupが以前に試みたアプローチと密接に関係している。
結論
私の考えでは、このモデルは次のことを示唆している。今世紀中にAGIが開発されることは少なくとも十分ありうる。つまり、近い将来にAGIが開発される可能性を退けるべきではなく、これまでAGIの開発に失敗してきたことは が低いことの強い証拠にはならない。
個人的には、この報告書がとったアプローチは非常に興味深かった。特に、継起の規則が抱える問題に対してDavidsonが提案する解決策がそうだ。これは予測に関する他の研究にとっても非常に価値がある可能性がある。報告書のブログ記事17を読み、この枠組みを使って自分なりの予測を立ててみることをお勧めする。
図はこちらで操作できる。ボックスは報告書の対応する部分にリンクしている。
注
-
緑のボックスは入力、赤のボックスは仮定や限界に対応し、青のボックスは「その他」に分類される。 ↩
-
これは、「内部の視点(inside view)」と「外部の視点(outside view)」によるアプローチの違いとして考えることもできる(ただしこの記事も参照)。Cotraの生物学的アンカーの報告書は内部の視点をとっており、おおむね、学習計算量がTAIを構築するうえで最大のボトルネックだという仮定に基づいて、変革的なモデルを学習できるようになるにはどれだけの計算量が必要かを定量化している。これに対してDavidsonの半情報的な事前分布の報告書は、AI開発の仕組みについてほとんど何も特定せず、類似の技術からの参照クラスと一般的なベイズの枠組みにより大きく依拠している。 ↩
-
これは日の出問題の変形であり、Pierre-Simon Laplaceがもともと解こうとしていたのはこの問題だった。 ↩
-
これはもちろん、いくぶん疑わしい仮定であり、後でこの点に立ち戻る。 ↩
-
実際、最初の試行で成功した事例の基準率だけを見るのでは、データが少なすぎるという大きな問題がある。歴史上のデータがとにかく足りないのだ! ↩
-
仮想的な成功ではなく仮想的な試行の数を考えることもできるが、Davidsonはそうしないことにしている。大まかに言えば、仮想的な試行を使うと、初回試行確率の効果と、観察された失敗した試行による効果を切り分けるのがそれほど簡単ではなくなる(詳しく)。 ↩
-
事前分布は、(1)仮想的な成功の数と、(2)初回試行確率の逆数をパラメータとするベータ分布を使って定義される。詳しくはこちらを参照。 ↩
-
「事前分布のもっともらしさ」は、ベータ分布の形に注目するものである。たとえば、確率密度が区間[0, 1/1000]と[1/1000, 2/1000]のどちらで大きくなると予想すべきか、といったことだ。一方、「更新のもっともらしさ」は、新たに観察された試行の結果を受けて、来年AGIが構築される確率の予想がどう変わるべきかを見るものである。たとえば(報告書から借りると)、「当初、AGIが開発される年間の確率を1/100と考えていたなら、50年間失敗が続いてもそれほど意外ではなく、推定値を1/600まで下げるべきではない」。 ↩
-
ちなみに、これはOpen Philanthropyの世界観調査(Worldview Investigations)のもう一つの報告書「Forecasting TAI with biological anchors」の中心にある主張でもある。この報告書については別の記事で論じた。 ↩
-
これは、研究者年の最初の1年の取り組みでAGIが開発される確率が無限大になるという意味ではない。AI技術の発展水準が「ゼロ」から始まっているわけではないからだ。要するに、体制の開始時点は「AI技術の発展水準が上がり始めた時点」の話ではない。詳しい議論はこの脚注を参照。 ↩
-
たとえば、試行の定義を1年ではなく1か月にしても、 の予測は変わらないでほしい。試行の定義を1か月にすると、普通なら観察される試行の総数が増え、そのぶん更新も大きくなるが、別の初回試行確率を選ぶことでこの効果は相殺される。 ↩
-
より具体的に言うと、(たとえば仮想的な成功の数が異なる)いくつかの異なる更新規則がどれも妥当に思え、どうすべきか迷っているとしよう。一つのアプローチは、更新規則の異なる選択による結果に重みを付け、それらの規則を使って証拠に基づき予測を更新することである。しかし、更新規則への重み付けそのものを更新することにも関心があるかもしれない。そこで超事前分布の出番となる(詳しく)。 ↩
-
これらの数値はWebPlotDigitizerを使って読み取った。 ↩
-
見方によっては、これはあまり説得力のある証拠ではないかもしれない。たとえば、「秘伝のソース」が発見されれば、AGIへの立ち上がりは極端に速くなると考える人もいるだろう。 ↩