
レポート
機械学習における計算量の傾向を外挿する
原題:Projecting compute trends in machine learning
要約
機械学習の画期的なモデルを集めた私たちのデータセットと、機械学習における計算量の傾向についての最近の分析を使い、機械学習モデルの学習に使われる計算量について、過去70年分の傾向を将来に向けて外挿する。シミュレーションでは、(a)深層学習(DL)時代と深層学習以前の時代における計算量の伸び率の推定の不確実性と、(b)「回帰時期」、すなわち現在の深層学習時代の計算量の傾向(倍増期間は約6か月)が終わり、ムーアの法則に対応する、歴史的により一般的な傾向に戻る時期についての不確実性を考慮している。回帰時期を8〜18年後と仮定し、アルゴリズムの進歩を考慮しない場合、私たちの外挿によれば、Cotra 2020 の生物学的アンカーの中央値は2046年8月ごろ[95%信頼区間:2039年6月、2060年7月]に超えられる可能性がある。つまり、計算量のスケーリングの歴史的なペースが、(これらの傾向がこれまで続いてきた期間に比べて)短期間でも維持されれば、変革的なモデルが登場しうると考えられる。
この研究はこの Colab ノートブックで再現できる。
注:ここで示すのは外挿であって予測ではない。この記事が答えるのは「過去70年間の歴史的な傾向を単純に将来へ延長すると、機械学習の計算量の将来について何が言えるか」という問いである。「あらゆることを考慮したうえで、将来の機械学習の実験でどれだけの計算量が使われると予想するのが最善の推測か」という問いには答えていない。
はじめに
私たちは最近、1952年から今日までの百を超える機械学習の画期的なモデルについて、学習に必要な計算量を注記したデータセットをまとめた。このデータを使い、将来の機械学習システムの学習に使われうる計算量について、単純な外挿を行う。
機械学習システムの学習にどれだけの計算量を使えるかという問いは、これまでにもある程度注目されてきた。最も知られているのは Cotra の生物学的アンカーの報告書である。Cotra の報告書は、(i)変革的なモデルの最終的な学習実行に必要な学習計算量(生物学的アンカーを使って推定)と、(ii)Y年に利用可能な実効計算量を分析することで、変革的AI(TAI)の到来時期を調べている。本稿では、(ii)の計算量の推定を、機械学習モデルの学習に使われる計算量の70年分の傾向を外挿したもので置き換える。
Cotra の「Y年に利用可能な実効計算量」は、(a)計算コスト、(b)計算への支出、(c)アルゴリズムの進歩の予測に分解されている。これに対し私たちは推定を分解せず、機械学習の画期的なシステムの学習計算量についての以前の調査をもとに外挿する。この傾向には、時間とともに変わる支出意欲と、時間とともに下がる計算コストが含まれるが、アルゴリズムの進歩は扱っていない。計算コストや計算への支出は、あえて予測していない。
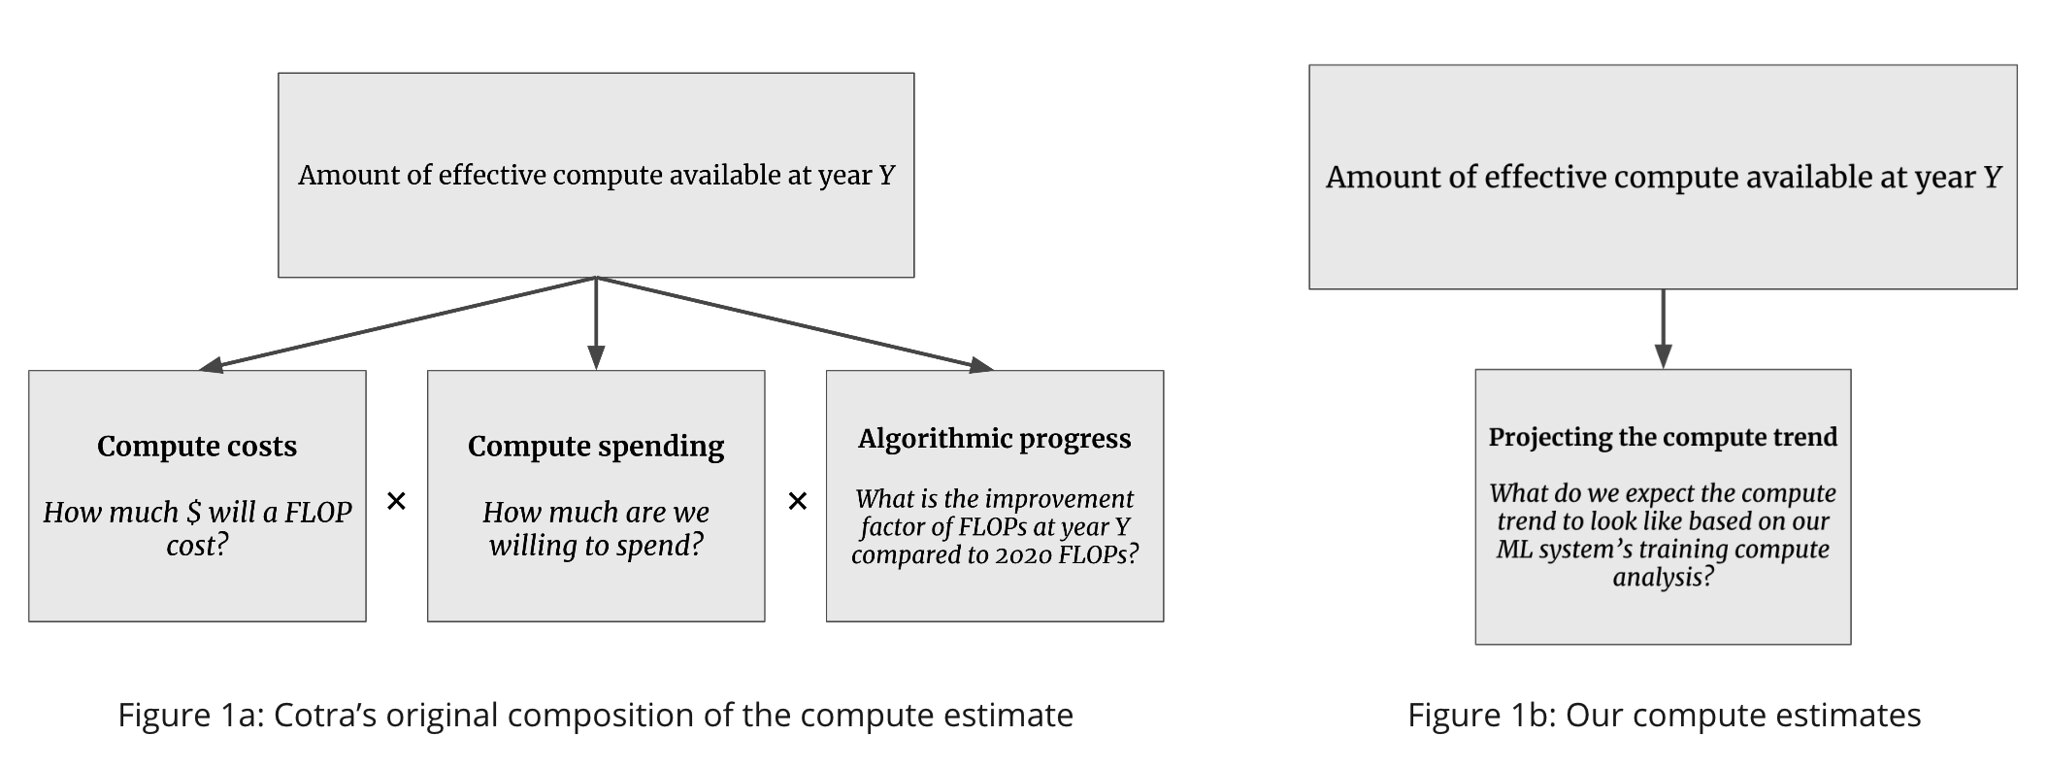
図1:本研究と Cotra 2020 との対比
この記事では、これまでに観察された傾向と、現在の6か月という倍増期間がどれだけ続きうるかについての基本的な見通しに基づく外挿を示す。つまりこの記事が答えるのは、現在の傾向を単純に将来へ延長したら将来について何が言えるか、という問いである。
これらの外挿が特に良い予測になるとは考えていない主な理由の一つは、今後数十年のうちに、ムーアの法則が何らかの重要な形で崩れる可能性が高そうだということだ。したがって、計算量をスケールさせるための予算(ドル建て)が経済成長率で伸びる場合、計算量の倍増期間は、歴史的に一般的だった約20か月よりかなり長くなると予想されるかもしれない。
現在のスケーリングの傾向はいつムーアの法則に戻るのか
機械学習における計算量の傾向についての最近の分析(Sevilla et al., 2022)で、私たちは、深層学習の登場以来、機械学習システムの学習に使われる計算量が6か月ごとに倍増してきたことを見いだした。これは、それ以前の歴史的な倍増期間(私たちの推定ではおよそ20か月で、ムーアの法則とほぼ一致する)よりはるかに速い。先行研究(Carey, 2018、Lohn and Musser, 2022)が指摘しているように、ムーアの法則を大きく上回るスケーリングのペースは何年も続けられない。経済成長をはるかに上回るペースで機械学習の計算への支出を増やし続けることは、何年も続けられないからだ。
そうなると、将来の機械学習システムで使われる計算量を外挿するうえで鍵となる問いは、現在の速い傾向が、歴史的にはるかに一般的だったムーアの法則に対応する傾向に戻るまでに、どれだけ続きうるか、である。
この問いに答えるため、私たちは Carey, 2018 の分析を再現する。ただし OpenAI の AI and Compute(Amodei and Hernandez, 2018)の数値ではなく、私たちの最近の分析(要約)の数値を使う。1 この分析は、大まかに言って三つのシナリオを示している。
- 弱気:計算のコスト性能比の改善が遅く、専用ハードウェアの改善もごくわずか。このシナリオでは、計算コストが1桁(OOM)下がるのに12年かかる。現在の6か月という倍増期間は、あと約8年維持できる。
- 中間:計算のコスト性能比の改善も、専用計算の改善も中程度。このシナリオでは、計算コストが1桁下がるのにおよそ7年かかり、専用ハードウェアの進歩によって傾向がさらに約3年延びる。現在の6か月という倍増期間は、あと約12年維持できる。
- 強気:計算のコスト性能比の改善が速く、専用計算も大きく改善する。このシナリオでは、計算コストが1桁下がるのに4年かかり、専用ハードウェアの進歩によって傾向がさらに約6年延びる。現在の6か月という倍増期間は、あと約18年維持できる。
大まかに言えば、これらのシナリオは「回帰時期」、すなわちスケーリングの傾向が現在の速い傾向よりもムーアの法則に近くなる時期について、次の分布で表せるだろう。
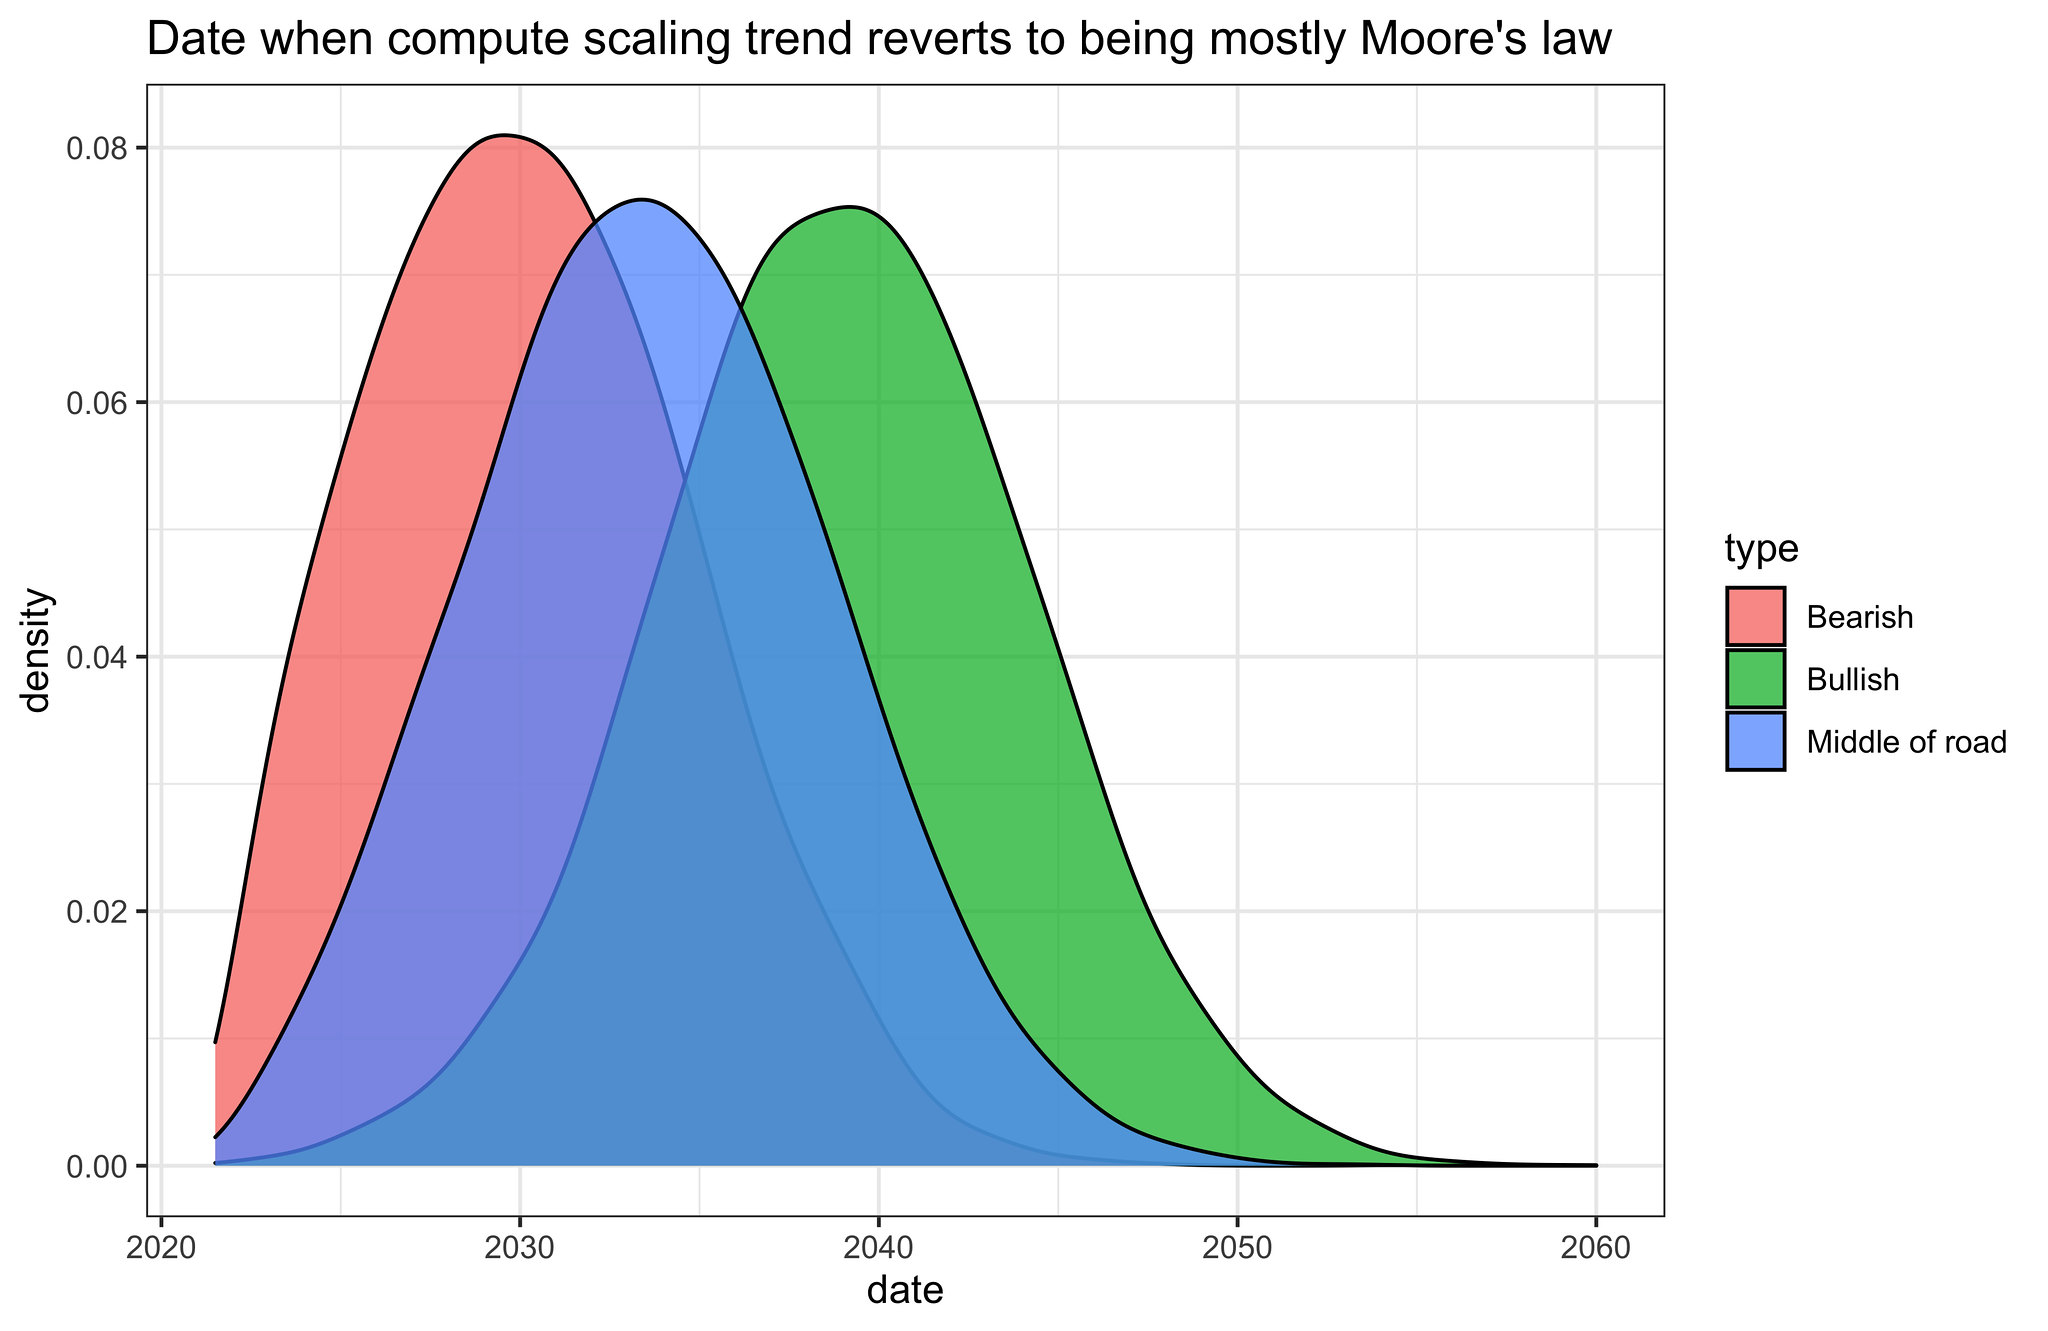
図2:Carey, 2018 の再現から得られた三つのシナリオにおおよそ対応する分布1
次に、私たちの最善の推測に基づき、「弱気」に0.75、「中間」に0.20、「強気」に0.05の重みを割り当てた加重線形プールを作り、これらの分布を混合する(この Colab ノートブックを使えば、自分で重みを設定できる)。
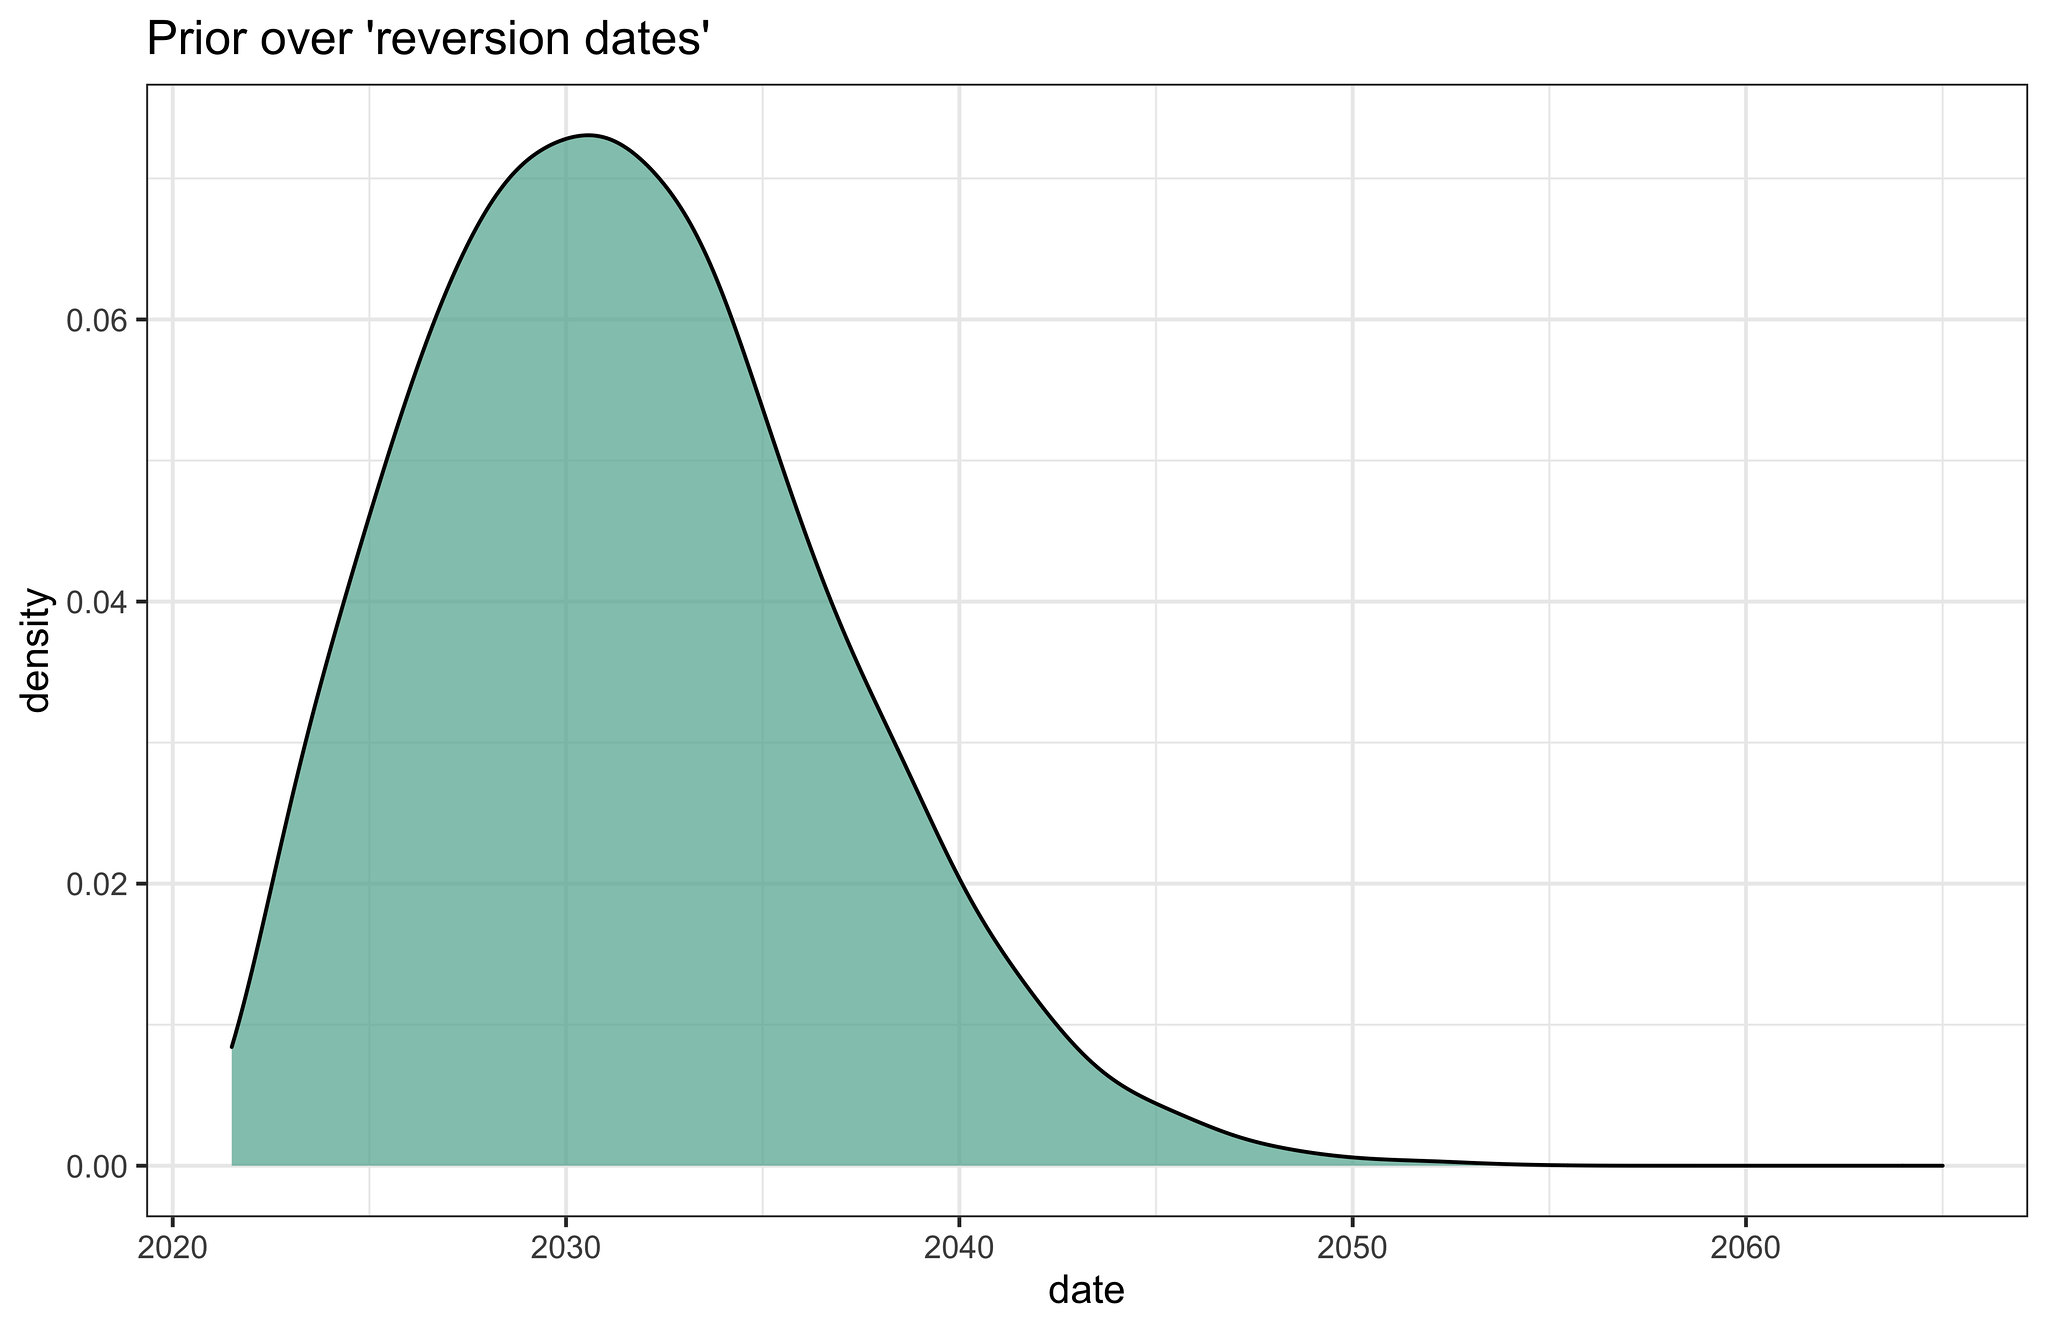
図3:回帰時期の事前分布についての私たちの最善の推測。上の分布を混合して作成した。
これを、速い傾向がムーアの法則に対応する歴史的により一般的な傾向にいつ戻るかについての事前分布として使える。
機械学習の計算量の傾向を外挿する
(a)深層学習時代と深層学習以前の時代における計算量の伸び率の推定と、(b)「回帰時期」、すなわち現在の深層学習時代の計算量の傾向が終わる時期の事前分布に基づいて、計算量の経路をシミュレートする。シミュレーションでは(a)と(b)の両方の不確実性を考慮している(詳細はこちら)。
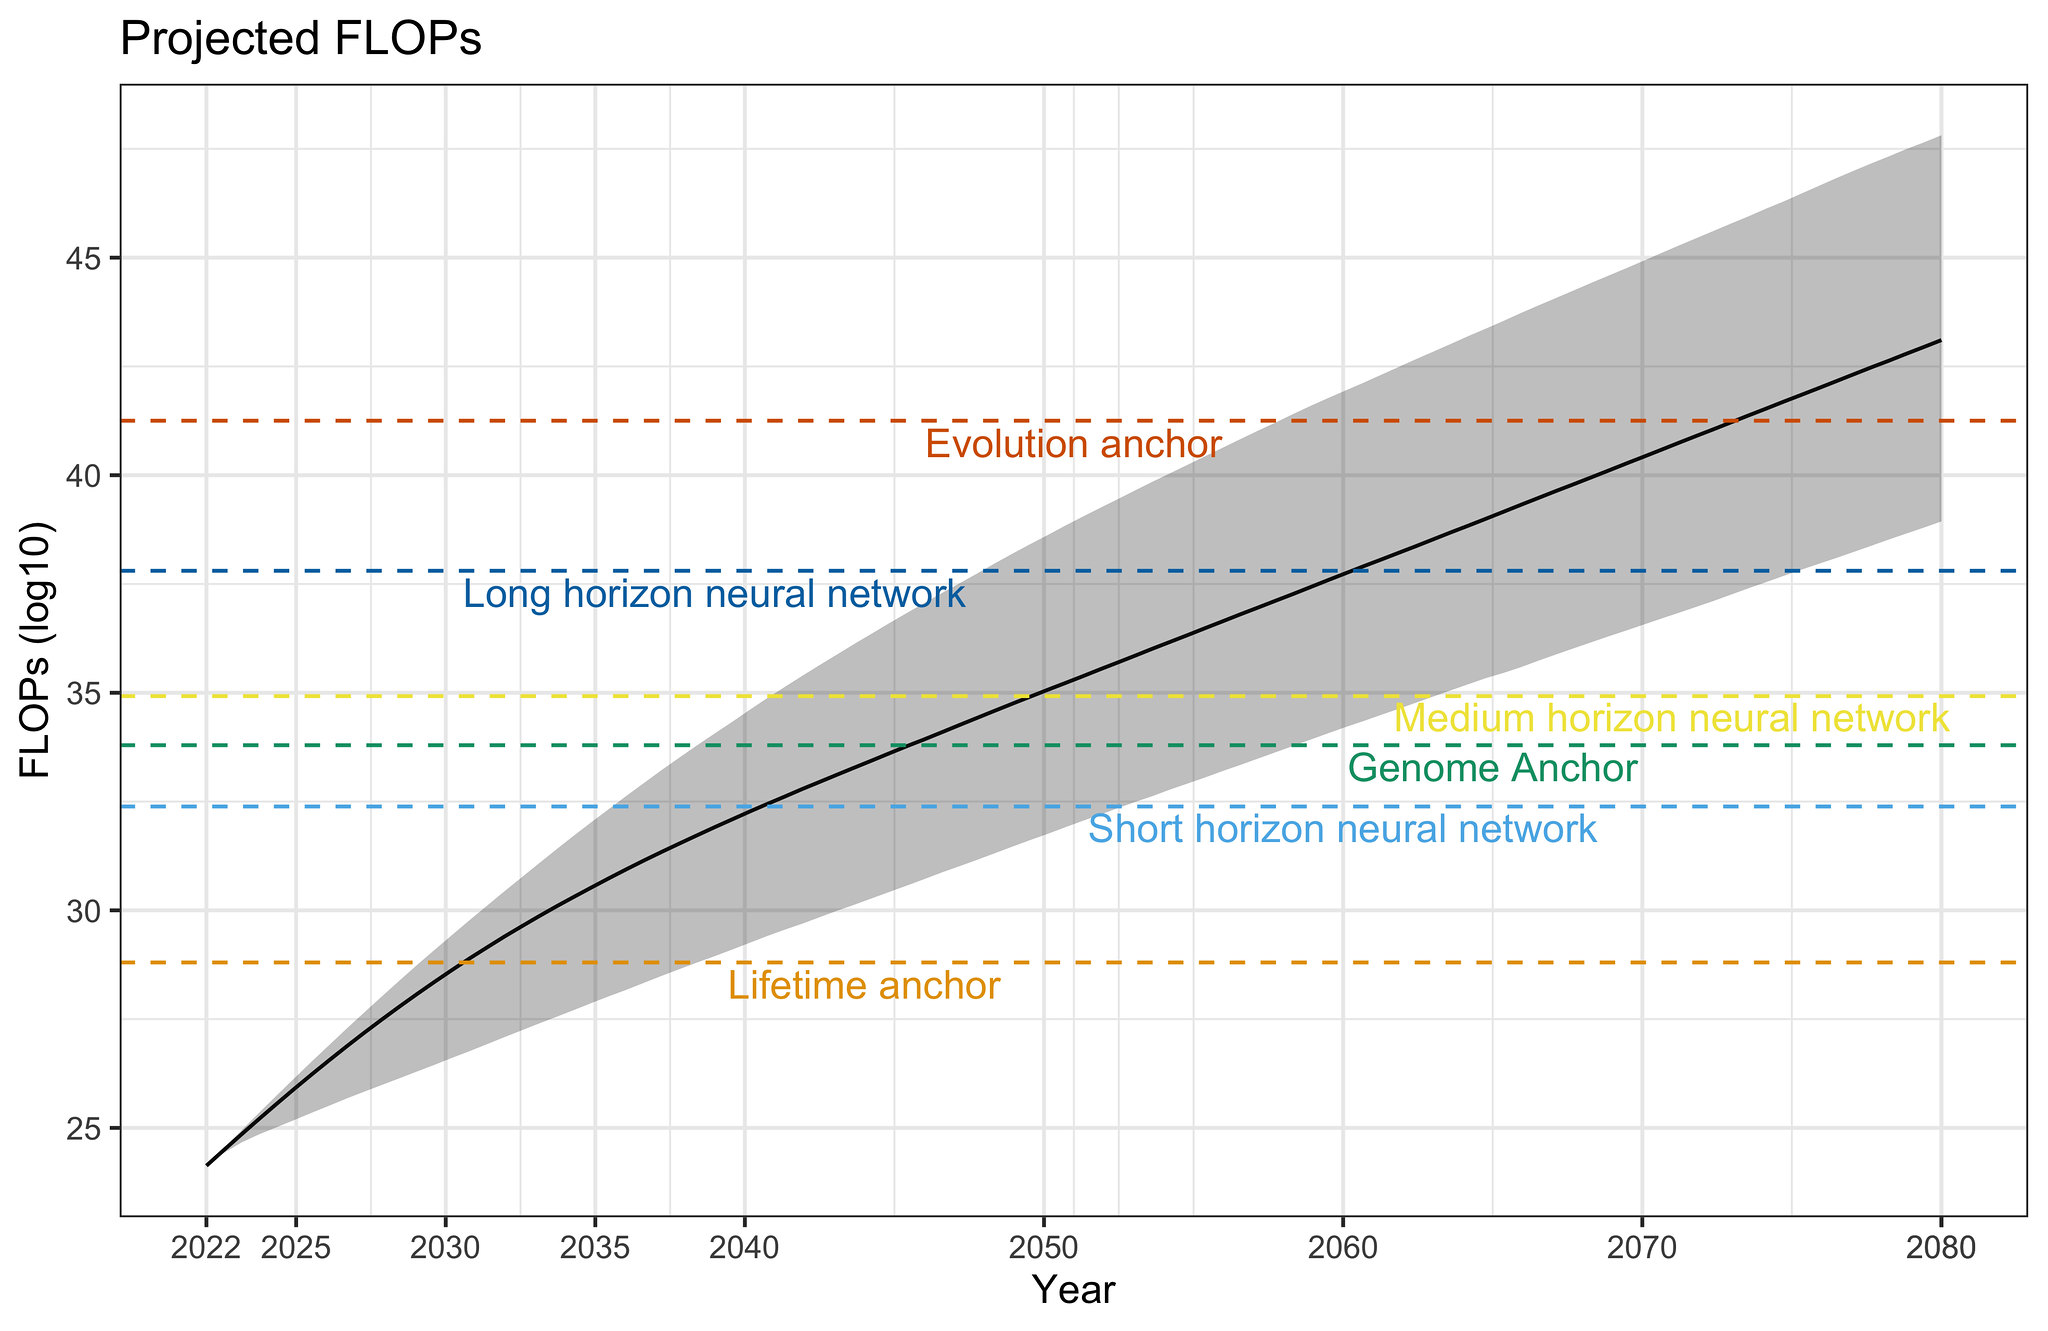
図4:外挿した1万本の計算量の経路。実線は各時点で外挿された計算量の中央値を、網掛けの領域は中央値の上下2標準偏差の範囲を表す。
シミュレーションから、機械学習モデルの学習に使われる計算量について次の外挿が得られる。
| 年 | 最大の機械学習モデルの学習に使われるFLOPの外挿値 | いくつのアンカーの必要計算量の中央値に足りるか |
|---|---|---|
| 2025 | [, ] | 0/6 |
| 2030 | [, ] | 0/6 |
| 2040 | [, ] | 1/6 |
| 2050 | [, ] | 3/6 |
| 2060 | [, ] | 5/6 |
| 2070 | [, ] | 5/6 |
| 2080 | [, ] | 6/6 |
表1:2025年から2080年までのFLOPの外挿値
これらの外挿によれば、アルゴリズムの進歩を考慮しない場合、Cotra 2020 の生物学的アンカーのうち最も控えめなものは2030年8月ごろ[95%信頼区間:2029年1月、2038年5月]に、中央値のアンカー(約 FLOP)は2046年8月ごろ[95%信頼区間:2039年6月、2060年7月]に、最も強いアンカーは2072年5月ごろ[95%信頼区間:2057年1月、2089年6月]に超えられる。
結論
機械学習における計算量のスケーリングの70年分から明らかになった傾向を単純に外挿すると、およそ25年以内に、大規模な機械学習の実験で使われる計算量が、変革的なモデルの学習に足りるかもしれないと Cotra 2020 が示した計算量の予算の半分を超えることが分かる。ここからはっきり分かるのは、機械学習における計算量のスケーリングの歴史的なペースが、(これらの傾向がこれまで続いてきた期間に比べて)比較的短期間しか維持されなくても、私たちが未知の領域に入りうるということだ。そこでは、変革的なシステムが学習される可能性が高いかもしれない。またこの研究からは、計算量の傾向を理解することが、機械学習の進歩を予測するうえで有望な方向でありうることもうかがえる。
シミュレーションの詳細
計算量は時間とともにある率 で指数的に増えると仮定する。
外挿では、 を で置き換える。これは、ムーアの法則の時代の伸び率についての私たちの最善の推測()と、深層学習時代の伸び率の推定値()との加重幾何平均として定義する。
ここで は、最小二乗法(OLS)で推定した深層学習時代(2010年以降)の伸び率を表すにすぎない。具体的には、私たちのデータセットを使って次のモデルを推定する。
は次のように定義する。
ここで は深層学習以前の時代の伸び率の推定値、 は20か月の倍増期間が意味する伸び率である。推定した伸び率と、20か月の倍増期間が意味する伸び率との幾何平均をとるのは、ムーアの法則が十分に確立されているため、ムーアの法則の確かさに比べて の誤差範囲が大きすぎるからである。そこで、推定値と、約20か月の倍増期間が意味する通常の伸び率との平均をとることで、ムーアの法則に対応する伸び率の精度を人為的に高めている。
重み関数 は次のように構成する。
なぜこの形なのか。これは値域が単位区間のロジスティック関数に似た関数で、 のときは を超え、 のときは に等しく、それ以外では を下回る。形は次のとおりである。
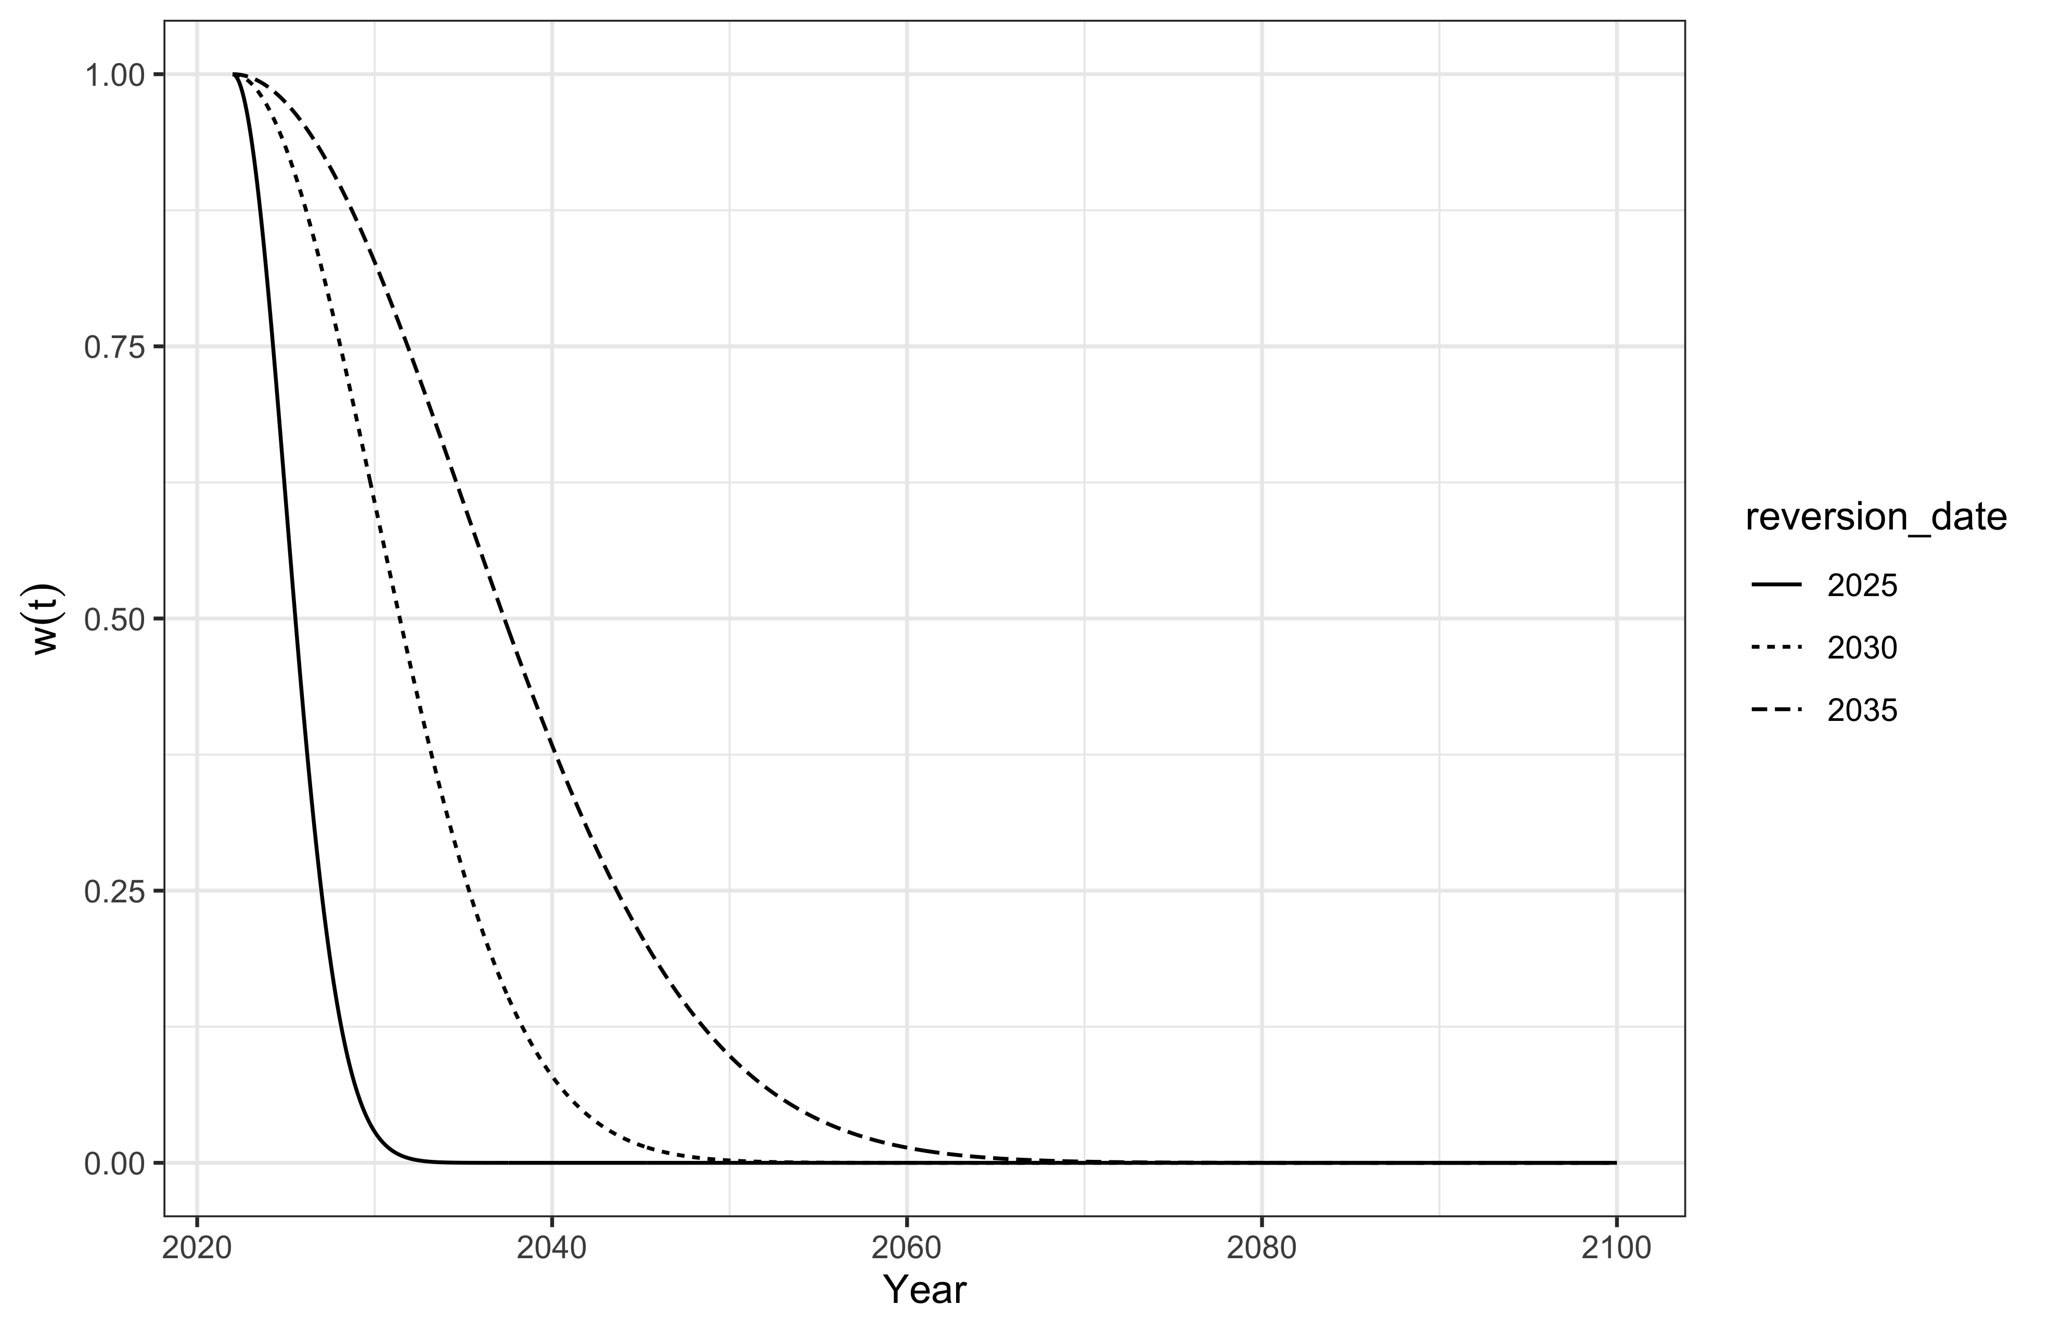
次に、ある経路 を次のようにシミュレートする。
- は、深層学習時代のデータから(復元抽出で)無作為に標本抽出したものに基づいて推定し、
- は、深層学習以前の時代のデータから(復元抽出で)無作為に標本抽出したものに基づいて推定し、
- は、回帰時期の事前分布から無作為に抽出した回帰時期に基づいて設定する。