
レポート
分散型学習はAIの電力問題を解決できるのか?
原題:Could decentralized training solve AI’s power problem?
はじめに
より賢いAIを目指して、企業は最大級のデータセンターの建設と、それを動かす電力の確保を競っている。
xAIはメンフィスに350 MWのColossusデータセンターを建設し、これを1.5 GWまで拡張する計画である。OpenAIの240 MWのAbilene Stargateデータセンターも、1.2 GWに達する計画だ。これらの単一のデータセンターは、完成すれば、1.2 GWのMaadenや1.6 GWのBahrainのアルミニウム製錬所のような、現在世界で最も電力を消費する施設に匹敵することになる。
そしてこの傾向が続けば、企業はまもなくこれを上回るかもしれない。学習用クラスターは、2020年代の終わりまでに10 GWに達すると予測されている。これは米国最大の発電所であるグランドクーリー・ダムの発電容量を上回り、2024年末時点のNVIDIA製AIチップ全体の設置電力容量にほぼ匹敵する。1
しかし電力会社はすでに、AIのハイパースケーラーが求める電力の供給に苦労している。米国最大の電力会社NextEraのCEOであるJohn Ketchumは昨年、一部の拠点なら1ギガワットはすぐに賄えるが、5 GWに対応するには「それなりの手間がかかる」し、10 GWとなればなおさらだと述べた。Mark Zuckerbergも最近のポッドキャストで、エネルギーの制約がAIのボトルネックになっていることを認め、「そのためのエネルギーを確保できるなら、おそらく今できるよりも大きなクラスターを構築するだろう」と語った。
解決策になりうるものがある。分散型学習を使えば、企業は小さめのデータセンターを異なる送電網の地域に(たとえば、それぞれ数百メガワットの余剰容量を持つ既存の発電所の近くに)建設し、一つのクラスターとして連携させて最先端のAIモデルを学習させられるかもしれない。
この分野の通説では、大規模な事前学習には一か所にまとまった大規模な計算資源が必要だとされている。
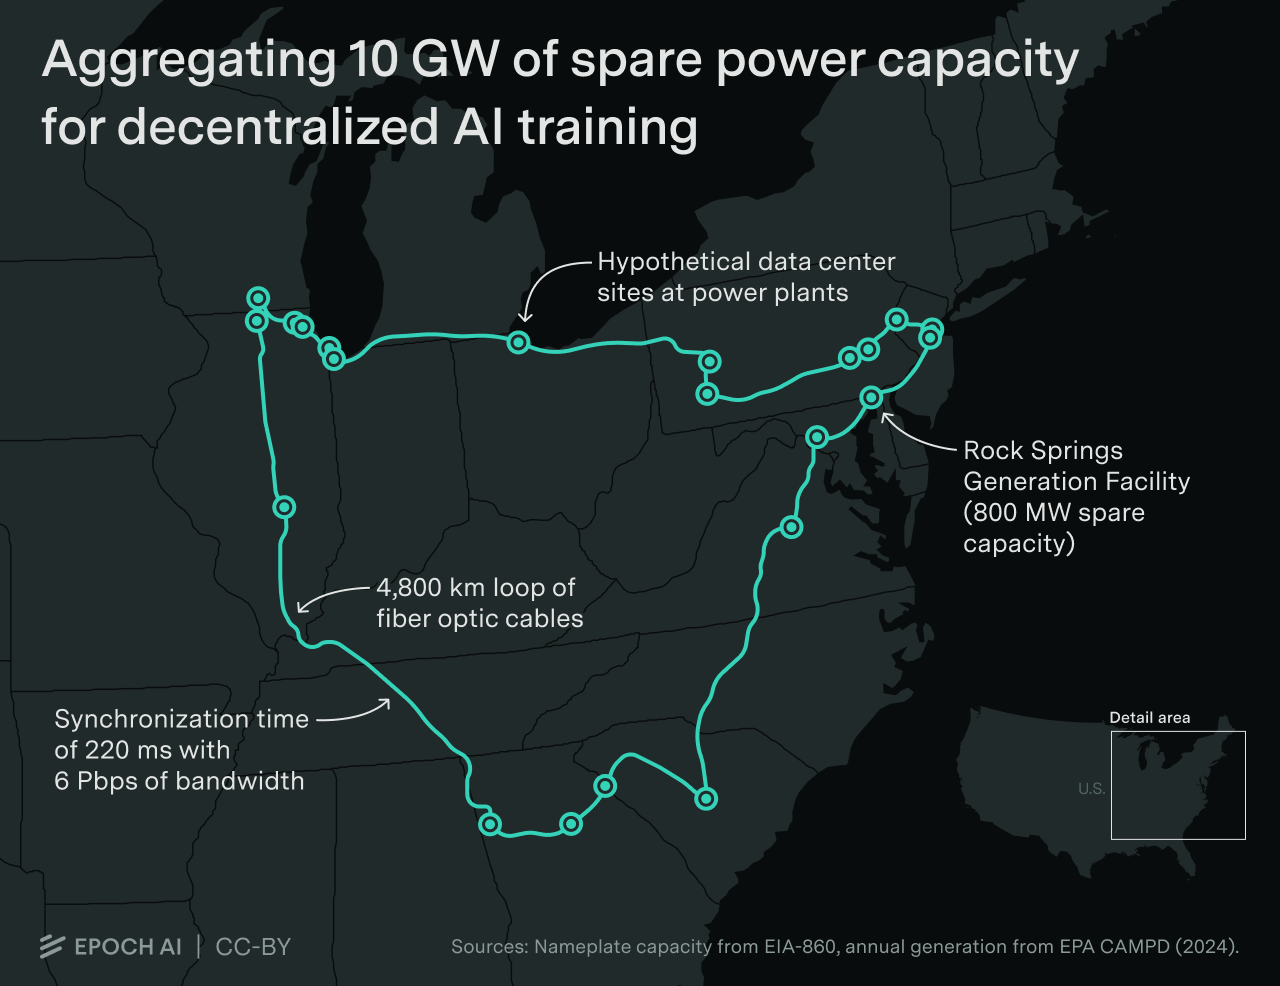
私たちはこれが誤りだと考える。本稿では、分散型学習を使って10 GWの学習を組織する方法を検討する。既存のガス火力発電所23か所の余剰容量を使い、その近くにデータセンターを建設して、全長4,800 kmの光ファイバー網で接続するという想定である。こうした学習をデータ並列化によってどう連携させられるか、その結果として求められる遅延と帯域幅の条件、そしてデータセンター拠点と比べたネットワークの建設コストを説明する。最後に、10 GWの学習を複数の拠点で行う場合と、単一のキャンパスを拡大する場合の長所と短所を分析する。
結論として、数GW規模のクラスターの学習を、数千キロメートル離れた数十か所の拠点に分散させ、それらを連携させて大規模な事前学習を行うことは、技術的に可能である。そうすれば、一か所で十分な電力を見つけるという課題が単純になり、しかも学習時間や建設コストは大きく増えない。この利点は、分散化で増えるエンジニアリング上の複雑さを埋め合わせるかもしれない。
企業は、学習上の制約や許認可の複雑さを最小限に抑えるために、巨大なキャンパスの拡大を好むかもしれない。それでも、電力会社が数GW規模の拠点を提供できない、あるいは提供したがらないからといって、AIのスケーリングが阻まれる可能性は低いと考えられる。
10ギガワットの学習を計画する
何よりもまず、現在の米国でデータセンター向けの電力をどこで確保できそうかを把握する必要がある。
新たに5 GWや10 GWのデータセンターを受け入れられる場所はほとんどないが、十分に活用されていない既存の発電インフラはある。送電網はピーク負荷に合わせて作られているが、多くの場所ではピーク負荷は比較的まれである。そのため送電網の利用率は低いことがあり、送電網をもっと効率よく使えば、利用できる電力は増える。2
私たちは、地域全体の電力の確保しやすさを測る代理指標として、余剰容量の大きい米国のガス火力発電所の一覧を作成した(詳細は付録を参照)。設備利用率で調整した容量が最も大きい拠点は、メリーランド州のRock Springs Generation Facilityで、約800MWの余剰容量がある。この発電所は1年の大半は稼働しておらず、年間の発電量は定格容量の2%にすぎない。稼働するのは地域の送電網のピーク負荷時だけである。
クラスターを10 GWまで拡大するため、米国東部の、イリノイ州からフィラデルフィア、ジョージア州にまたがる、余剰容量300 MW〜800 MWの既存発電所23か所を検討する。仮に、これらの拠点にデータセンターを建設し、4,800 kmの光ファイバーケーブルで接続すれば、10ギガワットを超える電力を活用できる。
実際には、これらの特定の発電所がそれだけの容量をデータセンターに回す準備ができているとは考えにくい。しかしこの例から、企業は近接する複数の場所からそれだけの電力を得られるはずだと考えられる。
どのようなモデルを学習させるのか
10ギガワットは膨大な電力である。GB200 NVL72サーバーを約51,000台(つまりGPU約370万基)設置でき3、その合計スループットは2e22 FLOP/sになる。4 こうしたクラスターの計算能力は、現在配備されているほぼすべてのAIチップの合計に匹敵する。5
これだけあれば、5e28 FLOPの学習を、約100日6、モデルFLOP利用率(MFU)30%7で行える。これは、これまでで最大の学習であるGrok 4の100倍の規模である。
これほど膨大な計算資源で、どのようなモデルをどう学習させるのかははっきりしない。ここでは、総パラメータ数72T、順伝播1回あたりのアクティブパラメータ数4Tのモデルを、2,000Tトークンで事前学習させる場合を想定する。8 比較すると、学習の詳細が分かっているモデルのうち最大のもの、Llama 4 Behemothは、パラメータ数2T、アクティブパラメータ数288Bで、30Tを超えるトークンで学習された。
実際には、この計算資源の多くは事前学習ではなく、合成データの生成や強化学習(RL)のロールアウトに使われるだろう。こちらのほうが並列化しやすい。9 本稿では、分散型学習の限界を最も厳しい条件で試すために、純粋な事前学習を取り上げる。また、既存のベストプラクティスと最先端のハードウェアを前提とする。10 GWのクラスターが実際に建設されるころには、おそらくもっと優れたハードウェアが使われるだろう。10
学習をどう分散させるのか
学習を分散させる方法は複数ある。行列積を複数のノードに分割すること(テンソル並列化)も、ニューラルネットワークの異なる層の計算を分散させること(パイプライン並列化)もできる。しかし、概念的に最も単純なのは、データの単位で学習を分散させる方法である。
学習の各ステップで、AIモデルはデータの大きなバッチを処理する。そのデータを使って、性能を高めるためにモデルのパラメータをどの方向に調整するのが最適か、つまり勾配を求める。
バッチ全体を一つのデータセンターで処理する代わりに、計算を複数のデータセンターに分割し、モデルの重みを更新する前にそれらを同期させて勾配を集約できる。これをデータ並列化と呼ぶ。GoogleがGemini 2.5の学習を、近接する複数のデータセンター棟に分割した際にも、同じ戦略が使われた。11 5月にはNVIDIAが、1,000km離れた二つのデータセンターの間で340Bパラメータのモデルを学習させる、同様の戦略を試した。
各バッチは、データセンターの計算能力に比例して分割される。各拠点は計算フェーズでローカルな勾配を計算し、次にそのローカルな勾配を互いに交換する。集約した結果を使って、同期フェーズでモデルの重みのコピーを更新する。
各データセンターの内部では、さらにデータ並列化を、そしてパイプライン並列化やテンソル並列化といった他の種類の並列化も適用して、各ローカルバッチの計算を利用可能なすべてのマシンに分割する。これを連携させるだけでもすでに難しく、慎重なエンジニアリングが必要である。本稿では、データセンター内部での連携の課題はすでに解決されているものとみなす。ここで扱うのは、遠く離れた拠点の間でデータ並列化を連携させるという、さらに加わる難しさである。
分散型学習は、非常に大きな規模で十分なスループットを維持できるか
技術的な観点からは、分散型学習が意味を持つのは、データセンター間の通信に費やす時間が学習を遅くしすぎない場合だけである。
理想的には、同期(つまりデータセンター間の通信)を処理と部分的に並行して行えるので、学習はあまり遅くならない。最悪のシナリオ、つまり同期と処理がまったく重ならない場合には、学習は同期に費やした時間の分だけ遅くなる。
各同期にかかる時間を、バッチの処理にかかる時間の5%以下に抑えることを目標とする。そうすれば、最悪の場合でも学習時間全体の増加は5%、つまり集中型の構成なら100日かかる学習に対して5日の増加にとどまる。
これを分析するには、各バッチの処理にかかる時間を知る必要がある。そのうえで、バッチごとに1回同期する必要があるので、同期1回あたりの通信時間をバッチ処理時間の5%未満に抑えられるかどうかを確かめればよい。
各バッチの処理にどれだけかかるか
各バッチの処理にかかる時間は、バッチサイズと、目標とする学習時間全体によって決まる。重要なのは、バッチサイズをいくらでも大きくできるわけではないことである。臨界バッチサイズと呼ばれるある大きさに達すると、それ以上大きくしても得られる効果は急激に小さくなる。12
臨界バッチサイズを求めた公開研究のうち、私たちが知る最良のものはBergsma et al. (2025)で、臨界バッチサイズは学習データセットの大きさのおよそ平方根に比例して大きくなるとしている。その結果を外挿すると、2,000Tトークンの学習データセットに対する臨界バッチサイズは11億トークンとなる。参考までに、DeepSeek v3は最大バッチサイズ6,300万トークンで学習された。13
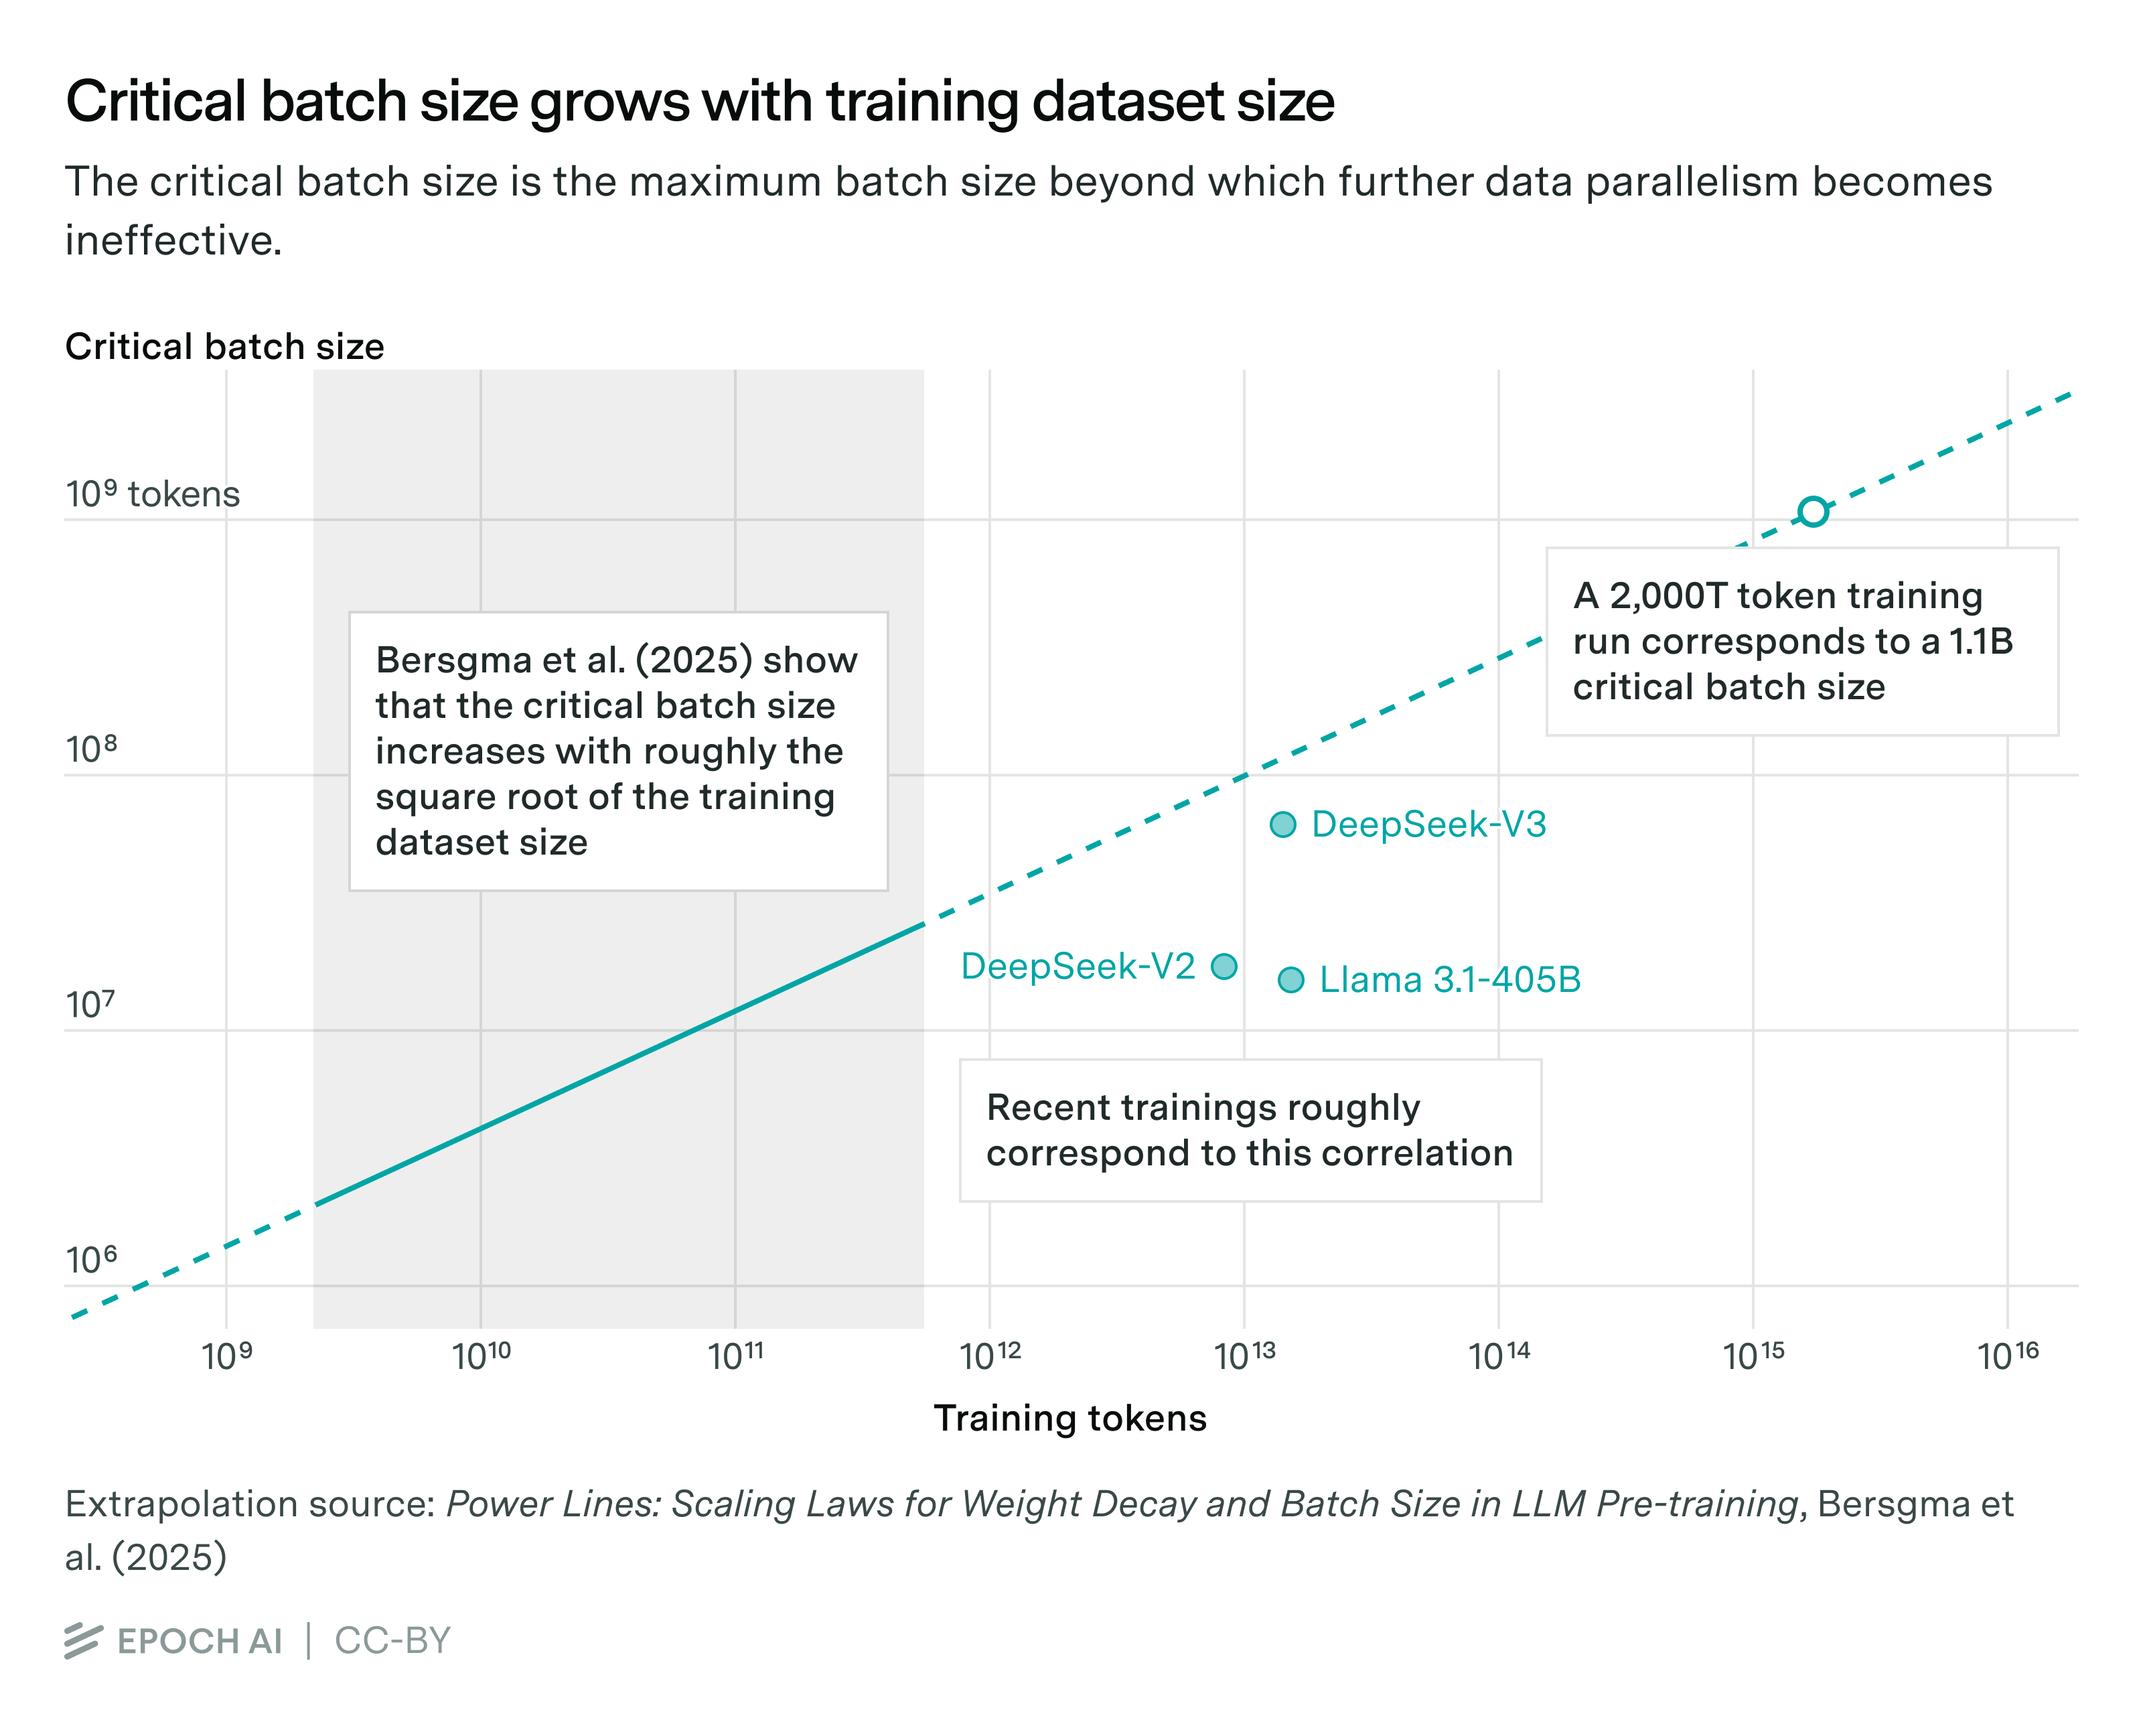
バッチサイズが11億なら、学習トークン2,000T ÷ バッチサイズ11億 ≈ 180万回の勾配更新となる。100日未満で学習を終えたいなら、各バッチは100日 ÷ 180万回の更新 ≈ 4.8秒未満で処理しなければならない。
ネットワークにどれだけの時間を費やすか
バッチあたりの処理時間を5秒とすると、同期時間の目標は250 ms未満となる。こうすれば、分散型学習で延びる時間は計算時間の5%以下、つまり100日の学習に対して最大5日の追加にとどまることが保証される。14
データセンター間の同期には、双方向リングAll-reduceアルゴリズムを使う。これを使えば、各同期をネットワークの1往復で完了でき、隣り合うデータセンターの各組の間の通信量はモデルの大きさに等しくなる。15
このとき、同期の過程に費やす時間の合計は、二つの要因で決まる。
- 伝搬遅延。ネットワークの長さと光ファイバー中の伝搬速度で決まる時間に、各データセンター内のスイッチやネットワーク機器での遅延を加えたもの。
- シリアライゼーション遅延。送信するデータ量(モデルの大きさで決まる)とネットワークの帯域幅で決まる。
このシナリオでは、各同期ステップを0.25秒未満で完了できるように、伝搬遅延を抑え、ネットワーク帯域幅を確保する必要がある。
伝搬遅延は十分に小さいか
データセンター同士がインターネット経由でつながっているだけなら、学習はすぐに通信がボトルネックになる。帯域幅10 Gbps・遅延100msの企業向けインターネット接続では、1秒未満で勾配を送信できるのは最大でも5億6,000万パラメータのモデルまでであり、現代のAI学習の規模にはとうてい足りない。16
しかし、AIデータセンターはインターネット経由では通信しない。企業はデータセンターの間に、学習用の通信専用に確保した長距離の光ファイバー回線を敷設する。
長距離通信の遅延は、主にネットワークの長さと光ファイバーの伝搬速度で決まる。現代の光ファイバーは光速の3分の2で信号を伝えられ、遅延は5us/kmとなる。17 したがって、4,800kmのネットワークの遅延は24msになる。18
ネットワークの各段も遅延を生む。データセンターのスイッチで光信号を電気信号に変換し、再び光信号に戻すのに約28usかかり19、NVL72サーバーとの通信にはホップあたり1us未満かかる。20 したがって、学習を数十か所のデータセンターに分散させる程度であれば、ホップあたりの時間による遅延の増加は無視できる。ただし、数千か所のデータセンターに分散させるつもりなら、これを考慮する必要がある。
まとめると、23拠点・全長4,800kmのネットワークであれば、遅延は目標の250 msを大きく下回る。
帯域幅はボトルネックになりうるか
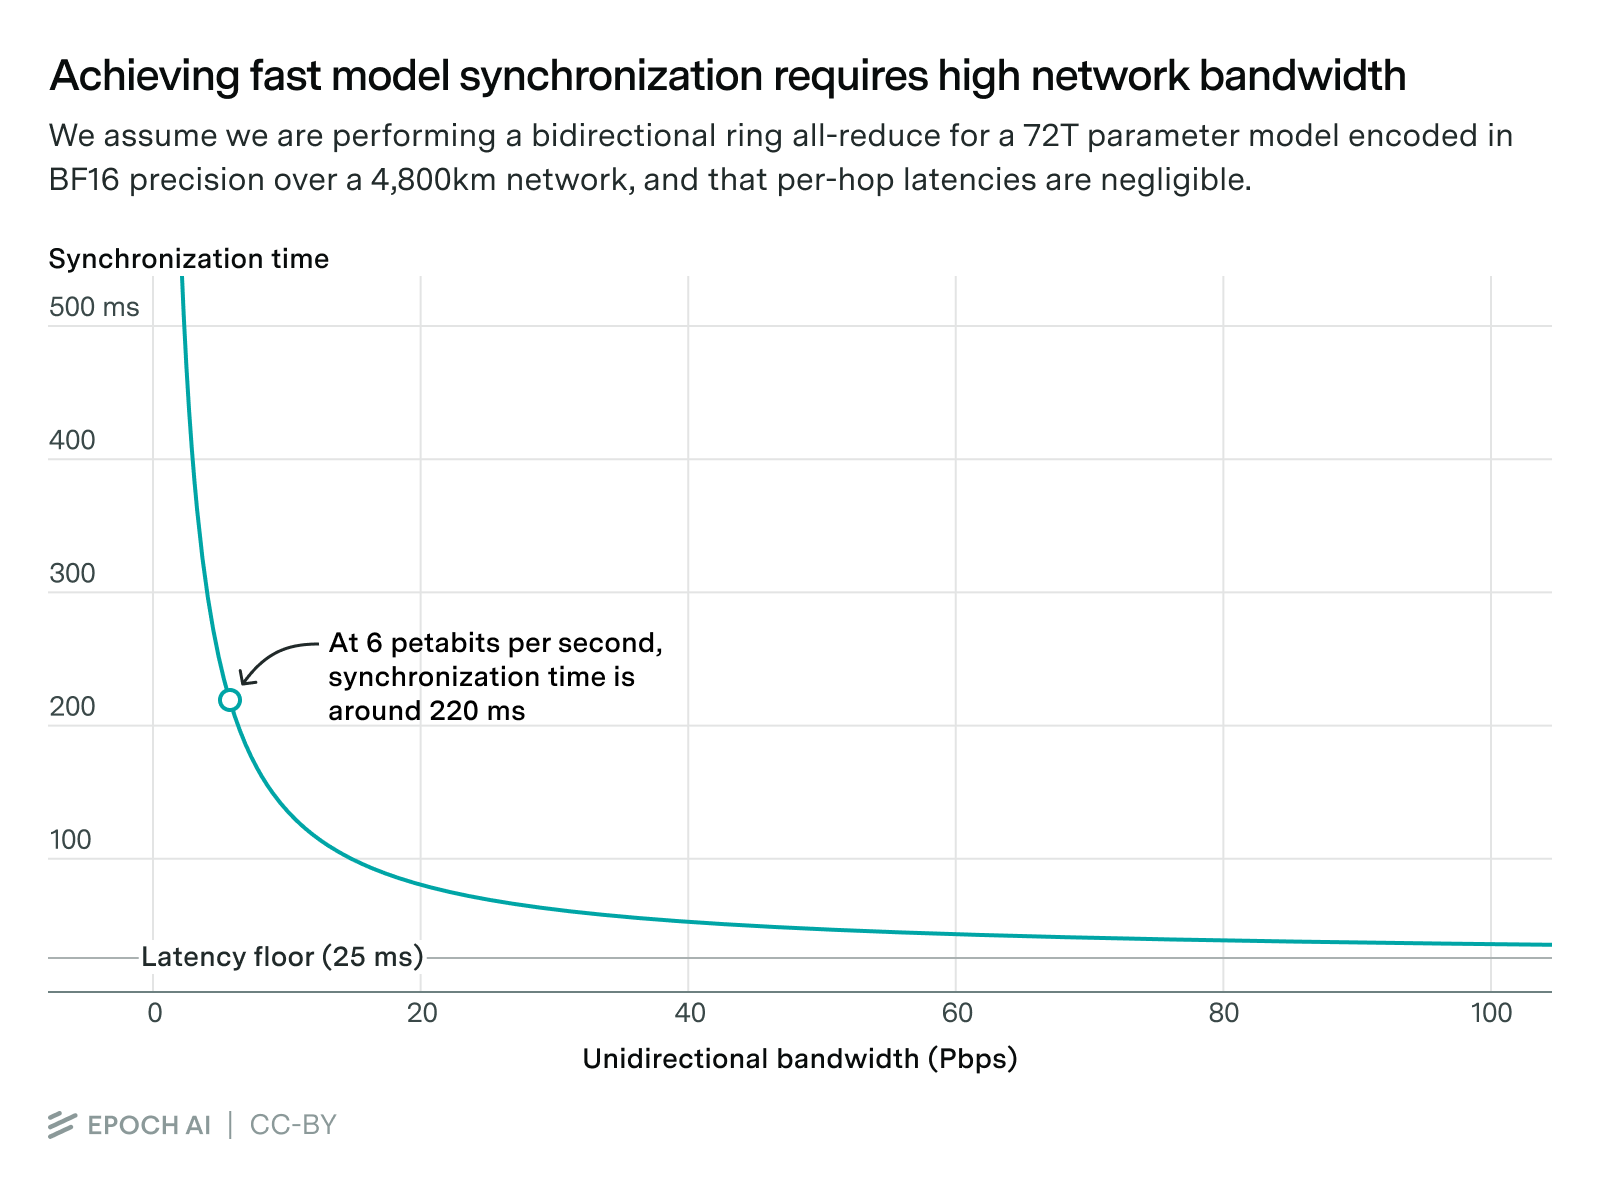
72Tパラメータのモデルの勾配を送信するには、ネットワーク内の隣り合うデータセンターの各組の間に、双方向それぞれ6Pbpsの接続が必要になる。遅延を考慮すると、これで勾配を約220msで送信できる21。これは、バッチの処理にかかる時間の5%未満で同期を行うのにも十分な短さである。
これは途方もない帯域幅である。比較すると、大西洋横断海底ケーブルMAREAのシステム容量は200Tbpsで、想定するデータセンター間接続の30分の1にすぎない。しかし次の節で見るように、ネットワーク帯域幅を増やすコストはデータセンターの建設コストに比べれば控えめで、6Pbpsの接続も十分に手の届く費用で実現できる。
前提の詳細はこちら。
そもそも、各拠点のNVL72サーバーは6Pbpsの帯域幅を支えられるのだろうか。NVL72の各ラックは18個のコンピュートトレイを備え、各トレイには外部との通信用に400GbpsのConnectX-7イーサネット接続ポートが4つある。したがって、NVL72あたりのネットワーク帯域幅の合計は、18コンピュートトレイ/NVL72 × 4ポート × 400 Gbps/ポート = 28.8 Tbps/NVL72となる。例として挙げたネットワークで最小のノードは、イリノイ州のNRG Rockford II発電所の隣にある拠点で、設置容量は300MWである。これはNVL72 GB200サーバーを約1530台設置するのに足り、イーサネット帯域幅の合計は1530 NVL72 × 28.8 Tbps/NVL72 ≈ 44 Pbpsとなる。この帯域幅を、リング内で隣り合うデータセンターへの2本のリンクと、データセンター内部を拡張するための建物間の接続とに振り分ける。全体として見れば、データセンターごとに6Pbpsの双方向接続2本を支えるのに十分なはずである。22
帯域幅をさらに増やせば、25msの遅延の下限を上回る範囲で、同期時間をさらに短くすることもできる。そうすれば、企業はより小さなバッチサイズを使ったり、学習時間の増加分をさらに減らしたりできる。本稿では6 Pbpsの接続のままとする。想定する10 GWの学習を行うにはこれで十分である。
ネットワークのコストは現実的か
こうしたネットワーク、つまり23か所のデータセンターを結ぶ全長4,800km・6Pbpsの光ファイバー網を構築するには、どれくらいの費用がかかるだろうか。このコストは、光ファイバーの敷設と、データセンター内のネットワーク機器に分けられる。
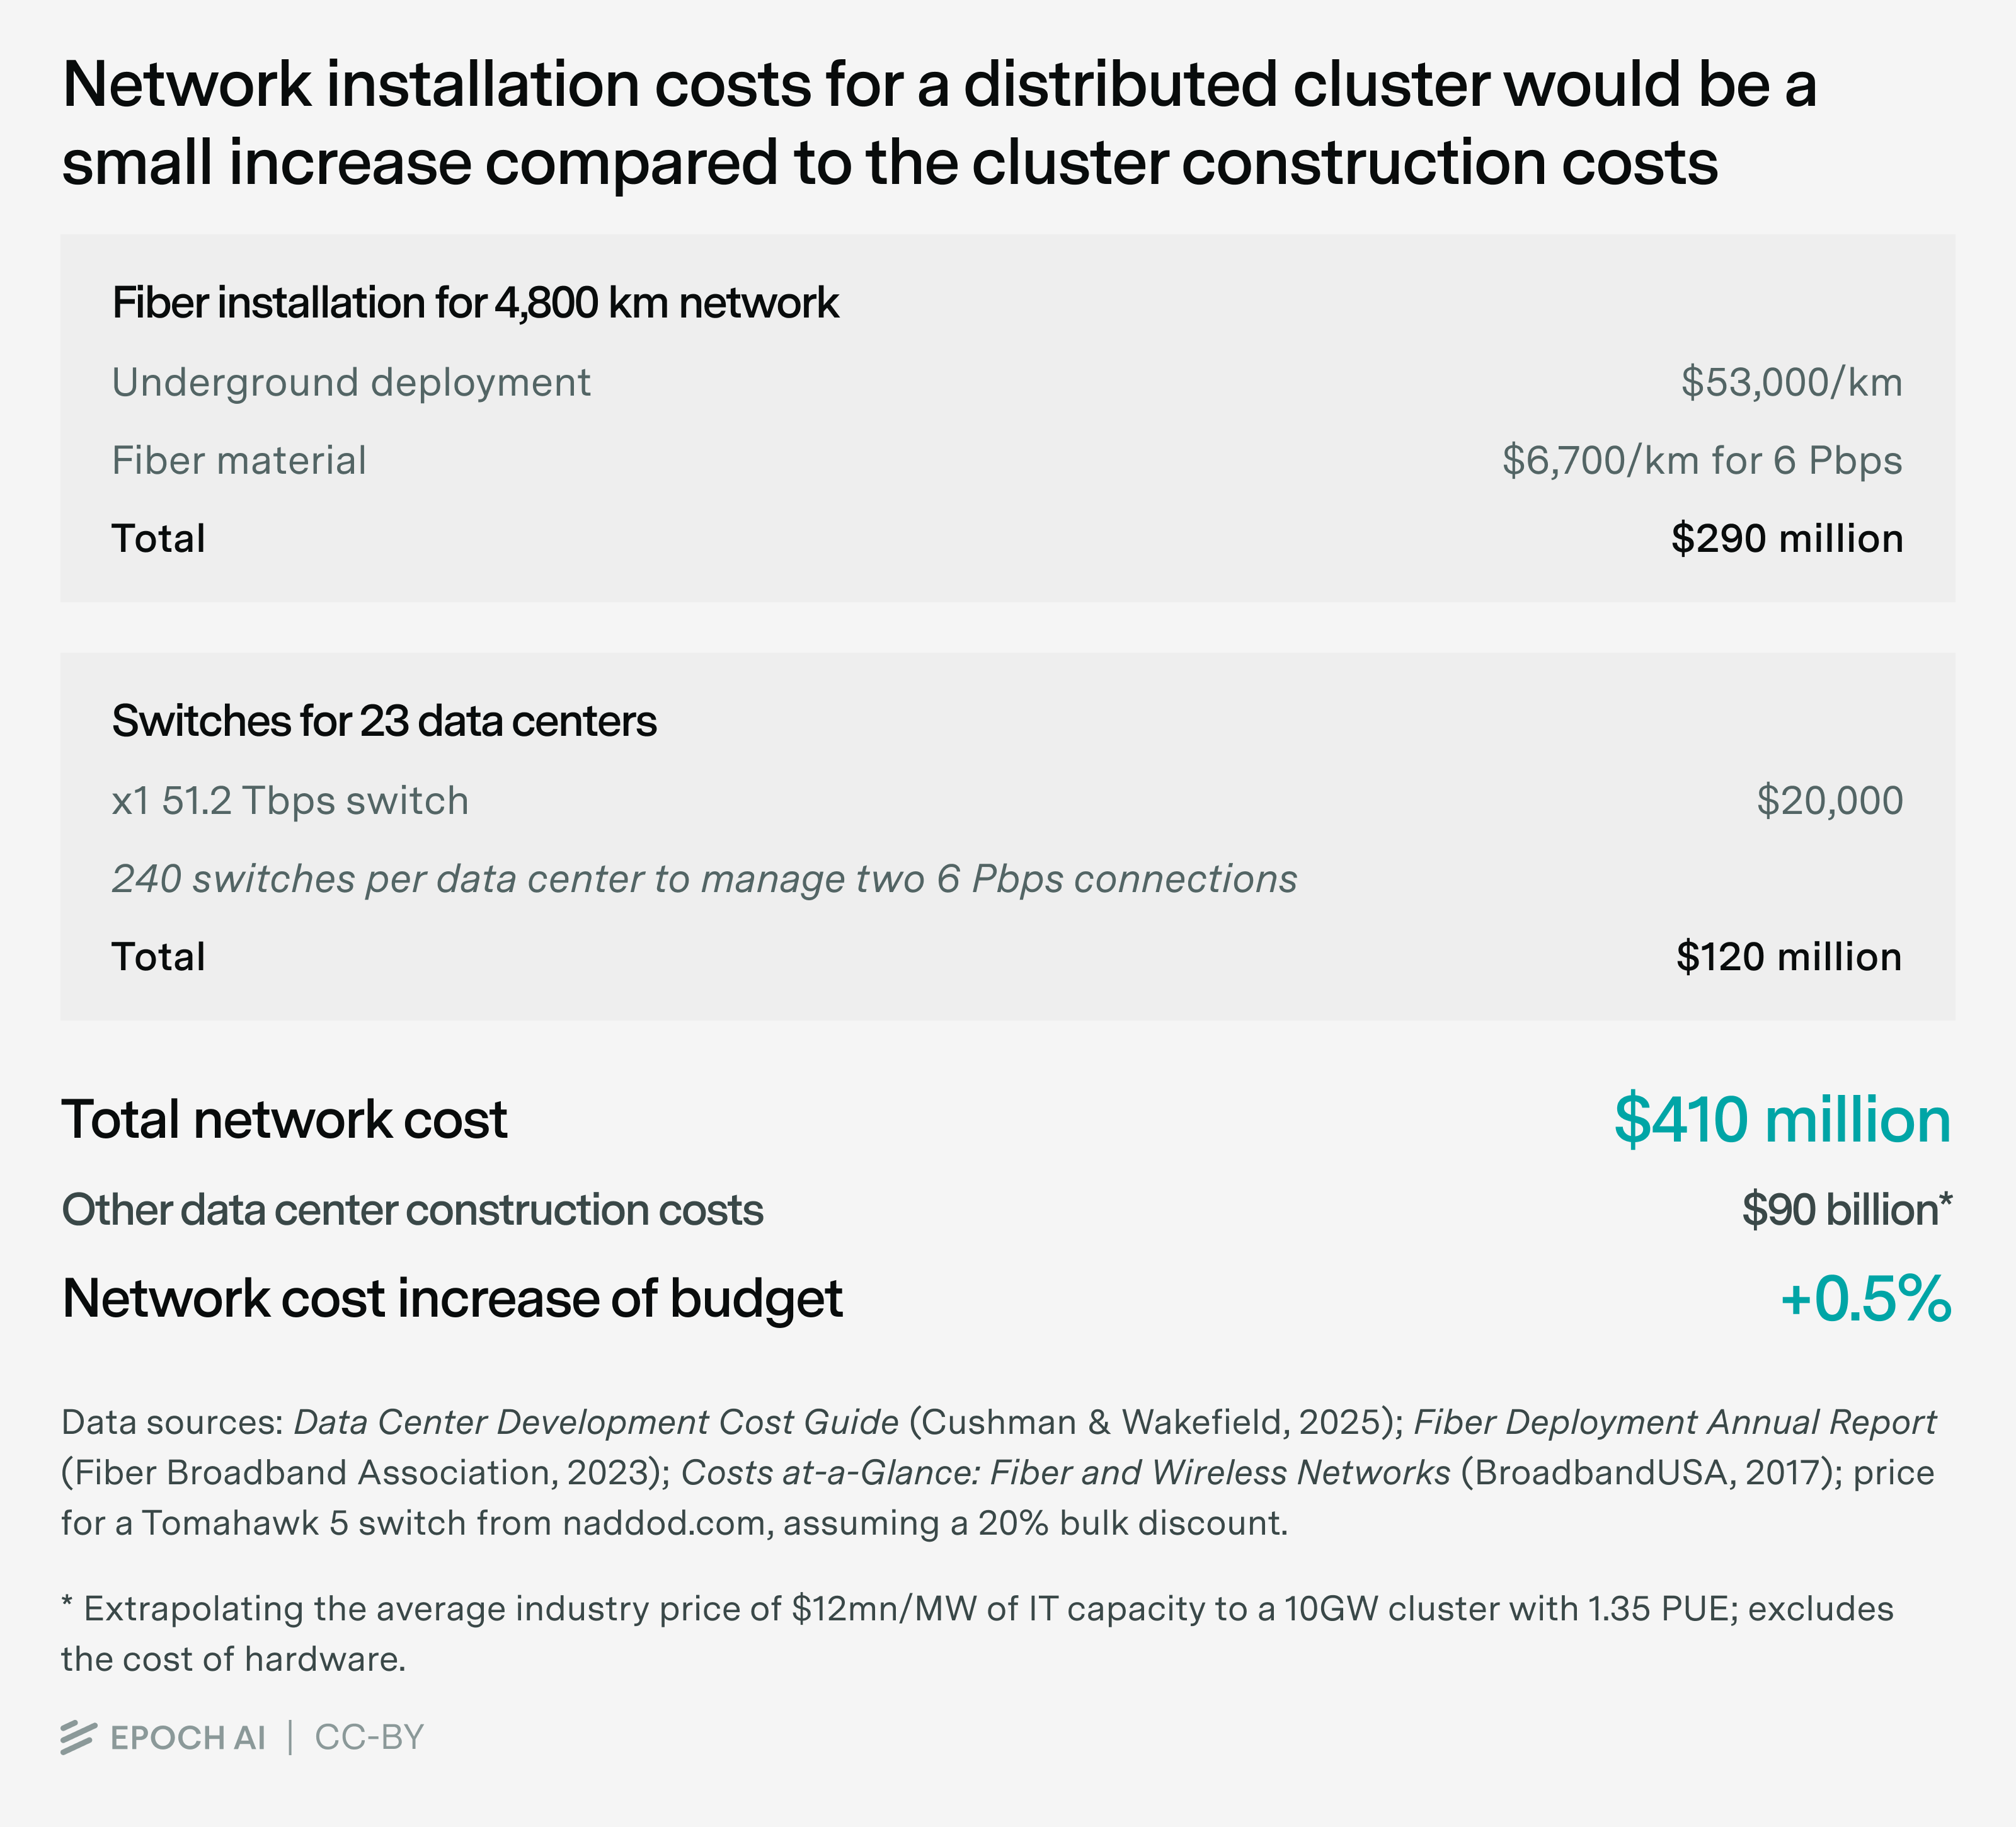
通常、光ファイバーは主要な幹線道路に沿って地中に敷設する。光ファイバーの地中敷設のコストは約53,000ドル/kmである。光ファイバーの素材費も必要だが、こちらははるかに安い。チャネルあたり800G、ペアあたり64チャネルとすると、双方向6Pbpsのポイント・ツー・ポイント接続を支えるには約120ペアのファイバーが必要で、ファイバーと被覆の素材費は約6,700ドル/kmとなる。したがって、4,800 kmのファイバーの敷設コストの合計はおよそ2億9,000万ドルになる。23
このファイバーを使うには、データセンターに光スイッチを備える必要がある。BroadcomのTomahawk 5スイッチは1台約2万ドルで24、51.2 Tbpsの接続に対応する。6Pbpsの接続を支えるにはデータセンターあたり240台のスイッチが必要で、23か所のデータセンター全体では合計1億2,000万ドルかかる。
合計すると、ネットワークのコストは4億1,000万ドルになる。
高額ではあるが、データセンターの建設コストに比べれば小さい。データセンター企業は、IT容量1メガワットあたり約1,200万ドルでデータセンターを建設すると提示しており、総容量10 GWのクラスターなら合計900億ドルになる。25 つまり、ネットワークによるデータセンター建設費の増加は1%未満である。必要なハードウェア機器のコストと比べれば、この増加分はさらに小さく見える。NVL72ラックだけでも、51,000台超のNVL72 × 300万ドル/サーバー ≈ 1,500億ドルかかる。
まとめると、全長4,800km・帯域幅6Pbpsのネットワークで、23か所のデータセンターにまたがる10 GWの分散型学習を支えられると結論づけられる。その代償は、学習の遅れが最大5日、データセンター建設費の増加が1%未満にとどまる。26
企業は実際に大規模な分散型学習へ向かうのか
要するに、各同期ステップを0.25秒で完了できるだけの容量を持つネットワークを構築することは技術的に可能であり、10 GWの分散型学習は実現しうる。
しかし、企業は実際にそれを選ぶだろうか。
大規模な分散型学習には、本質的な欠点が多い。ネットワークのリンクは故障箇所を増やすので、どの学習も、単一のローカルネットワークでつながったクラスターで行う場合より信頼性が下がる。大規模な分散型学習は、チェックポイントの保存、スケジューリング、同期がより複雑になるなど、エンジニアリング上の複雑さも増す。
地理的に分散した多数の施設を実際に建設し、ネットワークでつなぐこと自体にも、固有の課題がある。地域ごとにばらばらな許認可や規制の制度、地元で熟練労働者や資材を確保できるかどうか、といった問題である。光ファイバーのコストは予算の大きな部分を占めないとしても、州をまたぐ建設に必要な許認可の手配は複雑になるだろう。
さらに、集中型の学習のほうが将来の変化に強い。分散型の構成で機能する学習方式はどれも集中型の構成に容易に移せるが、通信量の多いプロトコルは集中型のクラスターでしか支えられない。AI分野の現在の動向(合成データの生成や強化学習の増加など)は明らかに分散型の構成に有利だが、新たな進歩によってこの均衡がひっくり返り、集中型の構成が優位に立つこともありうる。
そうであれば、現在AI企業が大規模な集中型のAIクラスターを計画しているのも驚くにはあたらない。たとえばCrusoeは、Tallgrassと共同でワイオミング州に建設中の1.8 GWのデータセンターについて、10 GWまで拡張できるよう設計されていると述べている。
では、大規模な分散型クラスターを構築することが理にかなうのはどのような場合だろうか。
何よりも、分散型の構成なら、クラスターの容量を増やす選択肢が広がる。その理由は複数ある。
第一に、本稿の学習の例のように、既存の発電所の余剰容量を活用して、その近くに(あるいは同じ敷地内に)データセンターを建設できるかもしれない。Norris et al (2025)によれば、新しいデータセンターが、送電網がピーク負荷に対応できるよう年22時間GPUの稼働を抑えることに同意しさえすれば、送電網にある既存の余剰容量76 GWを活用できる。これは、利用できる電力の近くに機会を見てデータセンターを置く、分散型の構成に有利に働くだろう。
第二に、電力会社はしばしば、非常に大規模な電力購入契約を結び、それに伴う送電インフラへの設備投資を行うことに消極的である。AIのエネルギー需要が落ち込んだり、OpenAIのような新興企業が倒産して電力購入契約を履行できなくなったりするリスクがあると見ているからだ。OpenAIやAnthropicがこれまで、借入によって自前のデータセンターを建設するのではなく、より大きなテック企業のパートナーにデータセンターの建設を頼ってきたのも、おそらくこれが一因である。このため電力会社は、異なる送電網の地域で、より小さな負荷の契約を結ぶほうを好むかもしれない。そうした契約なら、利用契約が破談になっても新しい顧客を見つけやすく、送電網インフラへの投資も少なくて済む。
第三に、すでに長い送電網への接続申請は、負荷が大きいほどさらに時間がかかり、200 MW以上の接続申請の処理には55か月以上かかっている。企業は送電網から独立した発電設備を建設することで、接続待ちの列をある程度回避している。たとえば、MetaのOrionやxAIのColossusの初期段階では、送電網から独立した数百メガワットの電力が供給された。
しかし、送電網から独立した発電を数ギガワットまで拡大するのは簡単ではない。大規模な天然ガスパイプラインのような主要なインフラが必要になるからである。私たちの知るかぎり、現在計画されているAIデータセンターで、1ギガワットを超える送電網から独立した発電を伴うものはない。
一般に、送電網から独立した発電はつなぎの手段とみなされており、最終的な目標は送電網からの電力である。たとえばCrusoeはAbileneについてこれを明確な計画として掲げており、xAIのColossusはすでにオフピーク時に送電網の電力の供給を受けている(ピーク時には敷地内の発電に切り替える)。
第四に、負荷が大きくなるほど、送電網の安定性にリスクが生じる。1ギガワットの負荷でもすでに相当なものであり、10ギガワットの負荷は米国の州まるごとの電力消費量を上回る。この問題は、使い方の不確かさによってさらに深刻になる。学習中の負荷はかなり予測しやすいが、その後の推論実行や研究の作業負荷ははるかに大きく変動する27。そのため、送電網インフラへの追加投資や、場合によってはきめ細かな資源の調整が必要になる。それに失敗すると、悪名高い4月のスペインの大停電のような事態を招く。
最後に、より小さな要因を二つ挙げておく。
第五に、既存の送電線は通常、数ギガワットの電力に対応する定格になっていない。米国で最も容量の大きい765 kVの2回線の送電回廊でさえ、単独で長距離を送れるのは6〜7 GWにすぎない。このため米国では、新たな大規模送電インフラなしに、送電網から電力を得る数GW規模のAIキャンパスを建設できる場所は限られる。ただし、中国、インド、EUは大容量の高圧直流送電線を敷設しており、なかには10GWを超える電力を送るケーブルもある。一方、米国は地理的条件と老朽化した交流インフラに制約されている。
第六に、分散型の構成は、将来の拡張に対してより柔軟である。大規模なキャンパスは、後の拡張に備えて何段階かに分けて計画されることが多いが、分散型のネットワークなら、データセンターを追加で接続することで、当初の計画を超えて拡大し続けられる。
こうした利点が、Microsoftの構想の背景にあるのかもしれない。Microsoftは、「地理的に異なる複数のAzureリージョンにまたがる大規模な分散学習を可能にする」ために、大規模AIデータセンターを結ぶ分散型の広域ネットワーク(WAN)を構築する構想を描いている。ウィスコンシン州のFairwater拠点は、すでに数ギガワットの電力を活用する計画になっている。28
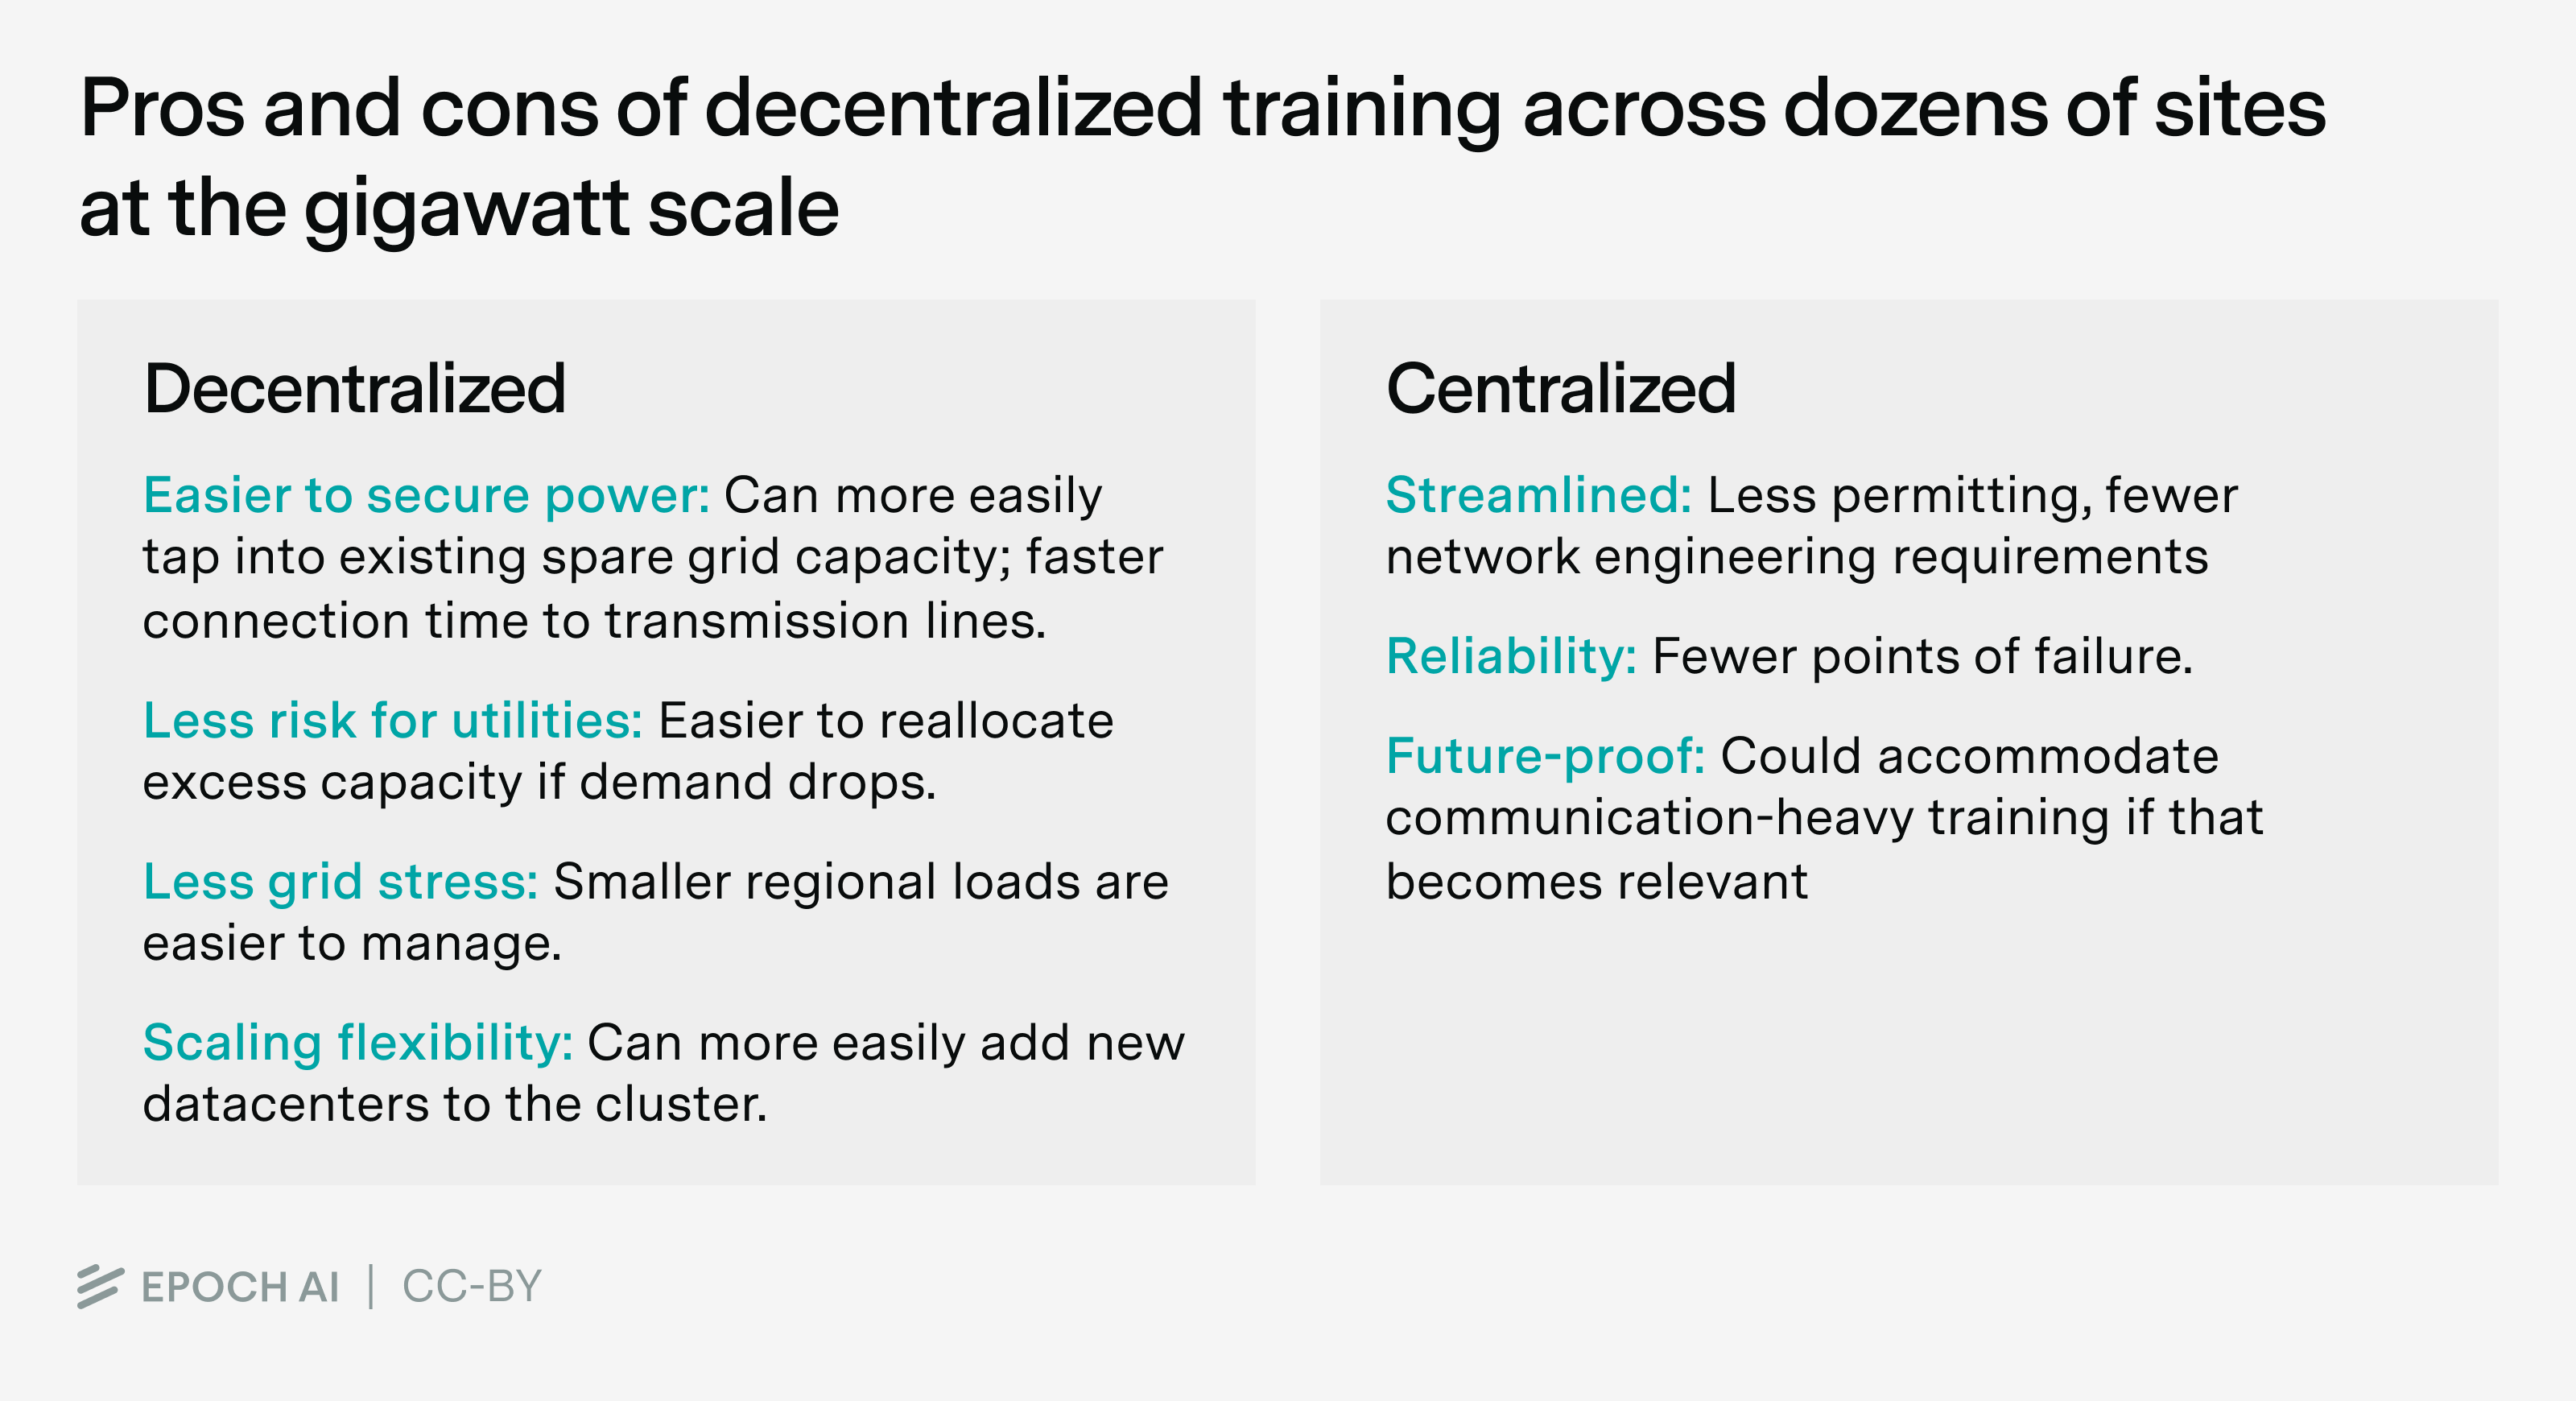
選択肢があるなら、企業は学習の複雑さを抑えるために、単一の大規模キャンパスを好むと予想される。しかし、分散型のクラスターなら、適した場所を見つけたり、電力会社と調整したりするのが容易になる。電力会社は、送電網の負荷をうまく管理するために、複数の地域にまたがる小さめの発電所を好むからである。
企業はできるかぎり多くの電力を持つ拠点の確保を目指し、ほかに選択肢がない場合にだけ分散型のクラスターに頼るだろうと私たちは予想している。実際には、企業は数メガワットから最大1ギガワットまでの単一拠点を建設し、10 GWを超える規模では、個々の拠点が数百メガワットから数ギガワットの分散型クラスターを構築するほうを選ぶと予想される。
学習の分散化は、多くの人が考えているより容易である。そのため、電力の確保は依然として大きな課題であるものの、AIのスケーリングを大きく鈍らせる可能性は低い。
コメントと支援をいただいたJean-Stanislas Denain、Greg Burnham、Anson Ho、Daniel Ziegler、Ryan Greenblatt、David Schneider-Joseph、Ben Cottier、Arthur Douillard、Harqs Singh、Erich Grunewald、Sandra Malagón、Lennart Heim、Tim Fist、Yafah Edelman、Ron Bhattacharyayに感謝する。
Lynette Byeが本レポートの編集と執筆に携わり、Robert Sandlerが記事のグラフをデザインした。
付録
付録A:米国の発電所の所在地
本稿のネットワークに選んだ米国のガス火力発電所の一覧。
天然ガス発電所の一覧は、2024年のEIA様式860(EIA-860)のシート3(発電機)から、発電所コードごとに集計し、定格容量 > 300MW、エネルギー源が「NG」のものを抽出して作成した。
続いて、EPAのCAMPDから各発電所の各発電機の2024年の年間発電量データを取得し、発電量と定格出力の比から設備利用率(利用割合)を計算した。これにより、最終的な設備利用率と利用可能な電力の推定値が得られる。
詳しい情報は付属のスプレッドシートにある。
| 発電所名(EIA) | 設備利用率で調整した利用可能容量(MW) | 緯度 | 経度 |
|---|---|---|---|
| Rockspring Generating | 779 | 39.71901 | -76.15976 |
| Troy Energy LLC | 702 | 41.47724 | -83.45983 |
| Tenaska Virginia Generating | 493 | 37.8667 | -78.3813 |
| LG&E Monroe | 464 | 33.8148 | -83.6954 |
| Tenaska Westmoreland Generating Station | 454 | 40.175247 | -79.69667 |
| Holland Energy Facility | 447 | 39.223145 | -88.75841 |
| MPC Generating | 382 | 33.8119 | -83.6953 |
| Sayreville Cogen | 381 | 40.439 | -74.3444 |
| Columbia Energy Center | 352 | 33.8697 | -81.0178 |
| Crete Energy Park | 351 | 41.429443 | -87.6187 |
| AES Ironwood | 350 | 40.3509 | -76.3658 |
| Hartwell Energy LP | 343 | 34.33959 | -82.81987 |
| Calumet Energy Team LLC | 312 | 41.6835 | -87.5563 |
| NRG Rockford II | 307 | 42.23856 | -89.1012 |
| Armstrong Energy LLC | 577 | 40.63802 | -79.35173 |
| MRP Elgin LLC | 533 | 42.00006 | -88.24457 |
| Sewell Creek Energy | 520 | 33.9486 | -85.2769 |
| Red Oak | 514 | 40.448673 | -74.34888 |
| MRP Rocky Road LLC | 414 | 42.0931 | -88.2397 |
| Riverside Energy Center | 384 | 42.583057 | -89.035545 |
| Ontelaunee Energy Center | 344 | 40.4219 | -75.9356 |
| Dickerson Power | 317 | 39.2097 | -77.4644 |
| Lower Mount Bethel Energy | 311 | 40.801926 | -75.10756 |
付録B:前提
本稿で検討する10GWの学習には、以下の前提を用いる。これらの前提が結論とどう関係するかは、こちらのスプレッドシートで確認できる。
| パラメータ | 値 | 注記 |
|---|---|---|
| NVL72のピークスループット(FLOP/s) | 3.60E+17 | スパース性なしのFP8でのNVL72 B200のピークスループットは360 PFLOPSである。 |
| NVL72あたりの設置電力(W) | 196,020 | HPEのNVL72 QuickSpecsには「ラックのTDP(熱設計電力)は公称132kW」とある。さらに、サーバー以外のIT機器のオーバーヘッド10%とPUE 1.35倍を含めた。 |
| NVL72のコスト(ドル) | 3.00E+06 | GB200 NVL72は約300万ドルとされる。 |
| データセンターの数 | 23 | データ並列(DP)学習を行う拠点の数。 |
| クラスター全体の電力容量(GW) | 10 | IT電力とPUEを含む、ネットワーク全体の電力容量。 |
| 最大ネットワーク長(km) | 4,800 | ネットワークの長さ。米国東部の、余剰容量100MW超のガス火力発電所23か所の近くにあるデータセンターを結ぶリングに相当する。 |
| 学習時間(秒) | 8.64E+06 | Gemini 1.0 Ultra、Llama 3、Grok 3の学習時間に合わせて、学習時間を100日と仮定する。ネットワークによる追加時間は含まない。 |
| 勾配更新テンソルのビット幅 | 16 | FP8の混合精度学習で、勾配の累積はBF16で行うと仮定する。 |
| スパース性 | 18 | モデルの混合エキスパート(MoE)のスパース性。総パラメータ数とトークンあたりのアクティブパラメータ数の比として定義する。DeepSeek v3は総パラメータ671B ÷ アクティブパラメータ31B = 18のスパース性だった。 |
| アクティブパラメータあたりのトークン数(tpp) | 500 | 学習トークン数とパラメータ数の比。学習計算量の面で最適なモデルの通常の目安は、パラメータあたり20トークンである。しかし、推論実行の効率を最適化するためにモデルは過剰学習されることが多く、最近のオープンソースのモデルはアクティブパラメータあたり最大480トークンで学習されている。 |
| ハードウェアFLOP利用率(MFU) | 30% | 注目すべきAIモデルのこれまでの学習に合わせ、モデルFLOP/s利用率(MFU)を30%と仮定する。 |
| 光ファイバーの遅延(s/km) | 5.00E-06 | White Paper on Huawei MS-OTN Low-Latency Network Solution、5us/km、図2-2。 |
| ホップあたりの遅延(us) | 28.00 | たとえば、Cisco NCS 2000 400 Gbps XPonder Line Card Data Sheetには、エンドツーエンドのスイッチ遅延が28usとある。 |
| データセンター間の帯域幅(Pbps) | 6.00 | ポイント・ツー・ポイントのネットワーク帯域幅。参考までに、大西洋横断海底ケーブルMAREAのシステム容量は200Tbpsである。 |
| チャネルあたりの帯域幅(bps) | 8.00E+11 | *800Gbpsは業界標準である |
| ペアあたりのチャネル数 | 64 | *64チャネルの光多重化装置は標準的な製品である。 |
| 光ファイバーの敷設(ドル/km) | $53,314 | Fiber Broadband Association Fiber deployment annual report 2023によれば、地中敷設のコストの中央値は16.25ドル/フィートである。 |
| 光ファイバーの素材(ドル/km/ペア) | $57 | *光ファイバーの素材費のみ。ファイバー1本は2.50ドル/フィートで、288心を収容し、1ペアに2心が必要である。したがって、3280 ft/km × 2.50ドル/ft ÷ 144 がペアあたりの追加価格となる。 |
| スイッチあたりの帯域幅(bps) | 5.12E+13 | Broadcom Tomahawk 5の仕様では、システム容量は51.2Tbpsとされている。 |
| データセンターあたりのスイッチ数 | 236 | 目標とするデータセンター間の帯域幅を光スイッチの帯域幅で割り、データセンター間の上りと下りのリンクを扱うために2倍して計算した。 |
| スイッチのコスト(ドル) | $21,599 | 20%の割引を仮定したBroadcom Tomahawk 5の小売価格。 |
| データセンターの単位建設コスト(ドル/MW) | $9 | 「19の市場で、重要負荷1メガワット(MW)あたりの開発コストは、高いほうではリノの1,500万ドルから、低いほうではサンアントニオの930万ドルまでばらつきがあり、平均は1,170万ドルだった」。これはIT容量あたりの数字なので、PUE 1.35で割った。 |
注
-
AIチップ全体の計算能力のストックは約4e21 FLOP/sである。H100、A100、V100、P100のFP16でのFLOP/sとTDPを使ってこのストックを設置電力に換算すると、GPUの電力は3.4 GWとなる。さらに、サーバーのオーバーヘッド2倍、サーバー以外のIT機器のオーバーヘッド10%、PUE 1.35倍を仮定すると、NVIDIAの設置容量は約10 GWとなる。↩
-
AIハードウェアは高価なので、ピーク負荷時にそれを遊ばせておくのは理想的ではなく、この戦略の有用性は限られる。しかし、分散型学習の構成では、各同期で各ノードがどれだけの容量を消費するかの配分をかなり柔軟に調整できる。とくに、ピーク負荷には最小限の停止時間で対処できることを考えればなおさらである。↩
-
たとえばHPEのNVL72 QuickSpecsによれば、NVL72ポッドの平均消費電力は1台あたり132kWである。サーバー以外のIT機器による10%の追加消費とPUE 1.35を考慮すると、NVL72あたりの設置容量は200kWとなる。したがって、10 GWのクラスターなら、10 GW ÷ NVL72あたり200kW ≈ 51,000ラックを支えられる。↩
-
GB200 NVL72の仕様書では、GB200 NVL72の公称スループットは、スパース性なしの8ビット精度で360 PFLOP/sとされている。FP8の混合精度学習を仮定する。↩
-
私たちの推定では、2024年末時点のNVIDIA GPU全体のピーク計算能力は約4e21 FLOP/sだった。それ以降も年2.3倍の傾向が続いたと仮定し、TPUの分として30%、Trainiumチップの分として10%を加えると、4e21 × 2.3^(10/12) × 1.4 ≈ 1e22 FLOP/sとなる。これは、私たちが推定した10GWのNVL72クラスターの能力に近い。↩
-
100日の学習は、Gemini 1.0 Ultra、Llama 3、Grok 3の学習と同程度である。↩
-
Epoch AIの注目すべきモデルデータベースでは、学習時のMFUは17〜55%である。GPT-4のMFUは約34%と推定されている。↩
-
これはアクティブパラメータあたり500学習トークンとなり、Chinchillaのスケーリングから見れば過剰学習のモデルである。これは最近のオープンソースのモデルと同程度である。推論実行を最適化するため、ここではモデルを過剰学習させるほうを選ぶ。↩
-
分散型の強化学習については、Prime IntellectによるINTELLECT-2のレポートの議論を参照。↩
-
なお、本稿で検討するのは、二十数か所の拠点にまたがる控えめな形の分散型学習である。1,000か所以上の拠点まで拡大することも考えられる。しかしその場合は、帯域幅の要件、ネットワークのホップ遅延、光スイッチのコスト、ハードウェアの制約に対処するための別の戦略が必要になる。利点はごくわずかだろう。非常に小さなデータセンターには、隠しやすいという点はあるかもしれないが、それ以外にほとんど利点がないからである。↩
-
Gemini 2.5が発表された時期から考えて、最終モデルは5e25〜5e26 FLOPの計算量で学習されたと予想される。8960基のTPUv5pからなる各ポッドのピーク性能は8ビット精度で918 TFLOP/sなので、HFU 30%で100日の学習を行うには、5e25〜5e26 FLOP ÷(8960 × 918 TFLOP/s × 30% × 100日)≈ 2〜20個のTPUv5pポッドが必要になる。これらのポッドは近接する2〜4棟の建物にあったと考えられる。たとえば、すべてNew Albanyのキャンパスにあったのかもしれない。TPUv5pの4チップサーバーの平均消費電力の実測値は2,176Wなので、このクラスターの受電電力は、2〜20個のTPUv5pポッド × 8960チップ/ポッド × 2,176W ÷ 4チップ × TDPと平均電力の比1.3 × サーバー以外のオーバーヘッド1.1 × PUE 1.35 ≈ 20〜200 MW(中央値:40MW)となるはずである。↩
-
そもそも、なぜ臨界バッチサイズが存在するのか。バッチサイズを大きくすると、性能を高めるためにモデルのパラメータを調整すべき最適な方向を、より正確に求められる。バッチサイズを大きくすればこの方向を測る精度は上がるが、バッチに十分なトークンを含めてしまえば、それ以上大きくしても得るものはほとんどない。↩
-
実際には、学習の初期のバッチサイズはもっと小さく、学習中に徐々に大きくして臨界バッチサイズに達する。しかし、学習の大部分は最大バッチサイズで行われるので、学習時間全体に大きな影響はない。↩
-
これは悲観的な仮定である。実際には、計算ステップと同期ステップを部分的に重ねて、学習時間全体を短くできるからだ。たとえば、バッチの最後の逆伝播が終わる前に、ネットワークの最終層のパラメータから先に勾配の同期処理を始められる。↩
-
双方向のall-reduceを行うには、最初のノードから時計回りに、最後のノードから反時計回りに、それぞれ集約(リダクション)を伝搬させる。二つの集約は真ん中のノードで出会い、そのノードが勾配の合計全体を集めて、時計回りと反時計回りの両方に伝搬させる。これを、すべてのノードが勾配のコピーを持つまで続ける。この処理は、勾配をネットワークのノード数と同じ数の部分に分け、ノードをずらしながら操作を行うことで並列化する。全体では M-1 回の通信ラウンドが必要で、その間に各単方向リンクは合計で M-1/M × N × 16ビットを送信(および受信)する。ここで N はモデルの大きさ、M はネットワーク内のノード数である。↩
-
低帯域幅の環境での学習は、活発に研究されている分野である。非同期学習や分散型の強化学習、勾配圧縮の技術によって、企業はインターネット経由で大規模なモデルを分散型で学習させられるようになるかもしれない。そうすれば、多数の拠点にある既存の余剰計算資源を活用できるかもしれないが、それが最先端の学習につながる可能性は低い。これは本レポートの範囲外である。↩
-
ガラスの屈折率の影響を避ける中空ファイバーを使えば、遅延をさらに改善できる。これは高頻度取引向けに実際に導入されて成功している方法である。しかし、通常の光ファイバーの遅延でも、本稿で論じている規模の学習を行うには十分に小さい。↩
-
ここでは、失われたり壊れたりしたパケットに対処するための再送にかかる時間を無視している。ホップごとの選択的再送による誤り制御プロトコルを考えよう。リングall-reduceの1周の間に転送されるビットの総量は、(23ホップ - 1)× 72Tパラメータ × 16ビット/パラメータ ÷ 23チャンク ≈ 1.1 Pbitである。ビット誤り率(BER)が1e-15未満と仮定すると、1周あたりのパケットの再送は平均で多くても1.1 Pbit × 1e-15 ≈ 1回と予想される。再送1回あたり、平均で5us/kmのファイバー遅延 × 4,800km ÷ 23 ≈ 1msの遅延が加わる(考える帯域幅が非常に大きいので、シリアライゼーション時間は無視できる)。これはネットワーク全体の遅延に比べれば小さな遅れである。↩
-
たとえば、Cisco NCS 2000 400 Gbps XPonder Line Card Data Sheetには、エンドツーエンドの遅延が28usとある。階層型のall-reduceアルゴリズムや専用ハードウェアを使えばこれを改善できるが、数十か所の拠点に分散させる程度なら必要ない。↩
-
スイッチからGB200 NVL72サーバーへ勾配を伝える遅延と、集約を計算する遅延を考慮する必要がある。NVL72が使うConnectX-7イーサネットポートの遅延について公開された資料は見つからなかったが、CX-6の遅延と同様に、ホップあたり800ns未満と推定する。この遅延がかかるのは、同期のラウンドのうち半分、つまりreduce-scatterのフェーズだけである。同様に、集約の計算時間も無視できる。例として挙げたネットワークで最小のデータセンター(300MW、つまりNVL72サーバー1530台)では、72Tパラメータ × 1 FLOP/パラメータ ÷(1530 NVL72 × FP8で360 PFLOP/s)≈ 同期1回あたり合計130nsである。ローカルな勾配更新の読み込みにかかる時間も無視でき、2 × 72Tパラメータ × 16ビット/パラメータ ÷(1560 NVL72 × 576 TB/s)≈ 同期1回あたり320usで、これはイーサネット通信の陰に隠れる。↩
-
勾配更新はBF16形式で保存・通信すると仮定する。したがって、72Tパラメータのモデルでは、同期のたびにデータセンターの各組の間で 72Tパラメータ × 16ビット/パラメータ ≈ 1.1ペタビットのデータを通信する必要がある。6Pbpsの接続なら、1.12 Pbit ÷ 6Pbps ≈ 190msで送信が完了し、これに24msの遅延が加わる。↩
-
all-reduceを拠点内のGPU以外の機器に任せれば、GPUサーバーに求められるネットワーク帯域幅を半分にできる。ネットワーク内での集約に対応したネットワーク機器さえある。↩
-
Fiber Broadband 2023 Fiber Deployment Annual Reportによれば、地中敷設のコストの中央値は16.25ドル/フィートである。BroadbandUSA 2017 Costs at-a-Glance: Fiber and Wireless Networks reportによれば、ガラスファイバーのコストは1フィートあたり0.50〜4.00ドルで、これにチューブの1フィートあたり0.55〜2.00ドルが加わる。これは業界標準の288心のファイバーの価格だと仮定する。↩
-
20%の大量購入割引を仮定した。↩
-
Cushman & Wakefieldの2025 Data Center Development Cost Guideは、「重要負荷1メガワット(MW)あたりの開発コストは、高いほうではリノの1,500万ドルから、低いほうではサンアントニオの930万ドルまでばらつきがあり、平均は1,170万ドルだった」と記している。これはIT容量あたりの数字なので、PUE 1.35を考慮すると、総容量10GW・IT容量7.7GWのクラスターのコストは約900億ドルとなる。↩
-
この分析には、増幅器や中継器のインフラのコストは含まれていない。調べたかぎりでは、これらのコストはばらつきが大きく、場所によって大きく変わるようだった。1kmあたり500〜1000ドル、つまり240万〜480万ドルが追加でかかると推定されるが、ネットワークの総コストを意味のあるほど変えるものではない。↩
-
分散型クラスターのもう一つの潜在的な利点は、推論実行の遅延が小さくなることである。しかし、本稿で検討している規模の分散化では、遅延の短縮はせいぜい25ms程度である。現代のAPIで最初の回答トークンが返るまでの時間は数秒単位なので、それに比べれば小さい。↩