
お知らせ
SWE-bench Verified を1台のマシンで1時間で実行する方法
原題:How to run SWE-bench Verified in one hour on one machine
はじめに
SWE-bench 用の Docker イメージの公開レジストリを公開する。コミュニティが、より効率的で再現性の高い SWE-bench の評価を行えるようにするためだ。レイヤーキャッシュをより上手に使うことで、レジストリの合計サイズを、SWE-bench の全2290イメージで67 GiB(10分の1)に、SWE-bench Verified の500イメージで30 GiB(6分の1)に減らした。これにより、32コア・RAM 128GB の GitHub Actions の VM 1台で、SWE-bench Verified を62分で実行できる。
私たちは、ベンチマーク評価の取り組みを率い、私の新しい上司となる経験豊富なエンジニアを募集している。詳細は本稿の末尾にある。
背景
SWE-bench は、現実のソフトウェアエンジニアリングのタスクで大規模言語モデルを評価するためのベンチマークである。人気のある12の Python リポジトリから集めた2,294件の GitHub の issue と、それを実際に解決したプルリクエストの組からなる。
各タスクでは、AIシステムに、プルリクエストがマージされる直前の状態のリポジトリと、issue の説明が与えられる。AIシステムはコードベースを修正して問題を解決しなければならない。成否は、AIシステムの解決策が、プルリクエストのマージ後のテストスイートに通るかどうかで判定される。つまりAIシステムは、人間の開発者の解決策の検証に使われたのと同じテストを満たす変更を作らなければならない。
SWE-bench Verified は、元のベンチマークから人間が検証した500問のサブセットである。(SWE-bench Verified が何を測っているのか、その結果をどう解釈すべきかの詳しい分析は、このベンチマークを掘り下げた記事を参照してほしい。)
SWE-bench は従来、実行するのが難しいベンチマークだとされてきた。たとえば All Hands のチームは、当初 SWE-bench Lite(300問)の実行に「数日」、つまり1問あたり10分超かかったと報告している。32台のマシンを並列に使うことで、これを「数時間」に短縮したという。
SWE-bench と Docker
SWE-bench の評価中、AIシステムは、必要な依存関係がそろったサンドボックスの中でコードベースを直接修正する。問題ごとに、PR がマージされる直前のリポジトリの状態を正確に再現する専用のサンドボックス環境が必要で、これらの環境は Docker イメージで指定される。SWE-bench のリポジトリには、SWE-bench のデータセットから Dockerfile とそのコンテキストを生成するスクリプトが含まれている。だが、実際のイメージを保存したイメージレジストリがないので、イメージはソースからビルドしなければならない。
ソースからのビルドには二つの問題がある。
速度:イメージのビルドには長い時間がかかる。開発用のマシンで作業するなら、ビルドは一度だけでよく、その後はキャッシュされる。しかし、私たちのベンチマーク・ハブのように、厳密に監査できる評価を大規模に行うには、使い捨てのクラウドの VM を使う必要がある。この場合、評価を実行するたびにすべてのイメージをビルドし直さなければならない。
再現性:ビルドの過程は外部のリソース(apt や PyPI のパッケージなど)に依存しているので、Dockerfile とローカルのコンテキストが同じでも、別の時点でビルドしたイメージが同一になるとは限らない。とくに Dockerfile が依存関係のバージョンを固定していない場合(後で見るように、SWE-bench の Dockerfile はたいてい固定していない)、イメージはビルド時の依存関係の解決結果に左右される。さらに、ある依存関係のあるバージョンが入手できなくなったり、別のアドレスに移ったりすれば、ビルドは失敗する。SWE-bench の issue の多くはもうかなり古い(たとえば2015年のもの)ので、この問題は時間とともに深刻になりうる。
そこで私たちの第一の貢献は、SWE-bench 用の Docker イメージの公開レジストリである。x86_64 アーキテクチャ向けの2290イメージを収めている(2294イメージのうち4つはビルドできなかった)。このレジストリは誰でも無料で使える。
さらに、イメージを最適化して、レジストリの合計サイズを6〜10分の1に減らした。本稿の残りでは、この最適化について説明する。
Docker のレイヤー構造
2294件の issue は12のリポジトリから集められているので、多くの issue が同じリポジトリを共有している。実際、分布は大きく偏っており、Django が2294件中850件、つまり issue の37%を占める。
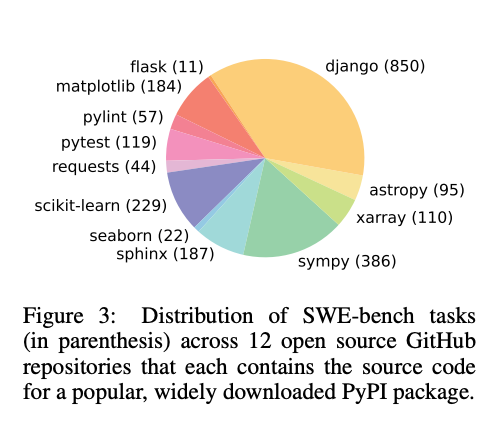
SWE-bench の issue のリポジトリ別の分布。全2294件のうち850件を Django が占めている。
また、多くの issue は時期が近いので、コードベースも似ている可能性が高い。たとえば1週間違いの Django の issue 二つは、依存関係がほぼ同じになる。主な違いは、二つの issue のあいだのアプリケーションコードの変更である(たいていコードベース全体のごく一部)。
これは Docker のレイヤーキャッシュにうってつけの使いどころだ。以下は、レイヤーキャッシュを少し単純化して1段落で説明したものである。Dockerfile の RUN、COPY、ADD の各命令は、それぞれ一つのレイヤーを作る。レイヤーは、コンテナのファイルシステムに対する特定の変更を表す。レイヤーは下から上へと積み重なる。各レイヤーはキャッシュされるので、あるレイヤーを変更すると、その上にある(それに依存する)レイヤーだけがビルドし直される。言い換えれば、Dockerfile のある命令を変えてビルドし直すと、その行とそれ以降の行のレイヤーがビルドし直される。それより前の行は再実行する必要がない。1
SWE-bench の Dockerfile は、プリンストン大学の研究者と OpenAI のスタッフが作成したものだが、レイヤーキャッシュをうまく活用しておらず、簡単にできる最適化の余地が多く残っている。
ここでは、私が行った最適化のうちいくつかだけを取り上げる。サイズと実行時間についての全体の結果まで飛ばしたい場合はこちら。最適化の全リストに興味があれば、このリポジトリのコミット履歴を見てほしい。
SWE-bench の Dockerfile の構造
典型的な Django のインスタンス django__django-13371 を詳しく見てみよう。2
SWE-bench のイメージはすべて、base、env、instance の3段階でビルドされる。多くの instance イメージが一つの env イメージに依存している。たとえば850の Django イメージは、12の env イメージに依存している。
Dockerfile はどれも実質的に同一で、実際の作業は setup_env.sh と setup_repo.sh のスクリプトに任せている。
これが base の Dockerfile である。
# Base (ghcr.io/epoch-research/sweb-c7d4d9d4.base.x86_64)
FROM --platform=linux/x86_64 ubuntu:22.04

## ... long apt install command omitted ...

# Download and install conda
RUN wget 'https://repo.anaconda.com/miniconda/Miniconda3-py311_23.11.0-2-Linux-x86_64.sh' -O miniconda.sh \
    && bash miniconda.sh -b -p /opt/miniconda3
# Add conda to PATH
ENV PATH=/opt/miniconda3/bin:$PATH
# Add conda to shell startup scripts like .bashrc (DO NOT REMOVE THIS)
RUN conda init --all
RUN conda config --append channels conda-forge

RUN adduser --disabled-password --gecos 'dog' nonroot
次が env の Dockerfile である。
# env (ghcr.io/epoch-research/sweb-c7d4d9d4.env.x86_64.e83e37f52c09532c62acfb)
FROM --platform=linux/x86_64 ghcr.io/epoch-research/sweb-c7d4d9d4.base.x86_64:latest

COPY ./setup_env.sh /root/
RUN chmod +x /root/setup_env.sh
RUN /bin/bash -c "source ~/.bashrc && /root/setup_env.sh"

WORKDIR /testbed/

# Automatically activate the testbed environment
RUN echo "source /opt/miniconda3/etc/profile.d/conda.sh && conda activate testbed" > /root/.bashrc最後に、instance の Dockerfile を示す。
# instance (ghcr.io/epoch-research/sweb-c7d4d9d4.eval.x86_64.django__django-13371)
FROM --platform=linux/x86_64 ghcr.io/epoch-research/sweb-c7d4d9d4.env.x86_64.e83e37f52c09532c62acfb:latest

COPY ./setup_repo.sh /root/
RUN /bin/bash /root/setup_repo.sh

WORKDIR /testbed/
補足:ここでは env と instance を別々の「段階」と呼んでいるが、これは本来のマルチステージビルドとは違う。詳しくはこの脚注を参照してほしい3。
Django 13371 のインスタンスの setup_env.sh と setup_repo.sh のスクリプトを見てみよう。
これが setup_env.sh のスクリプトである。
# setup_env.sh for `env` image e83e37f52c09532c62acfb
# (used by Django 13371)
set -euxo pipefail
source /opt/miniconda3/bin/activate
conda create -n testbed python=3.6 -y
cat <<'EOF_59812759871' > $HOME/requirements.txt
asgiref >= 3.3.2
argon2-cffi >= 16.1.0
...long list of dependencies truncated...
colorama; sys.platform == 'win32'
EOF_59812759871

conda activate testbed && python -m pip install -r $HOME/requirements.txt
rm $HOME/requirements.txt
conda activate testbed
そしてこれが setup_repo.sh のスクリプトである。
# setup_repo.sh for django__django-13371
set -euxo pipefail
git clone -o origin https://github.com/django/django /testbed
chmod -R 777 /testbed
cd /testbed
git reset --hard 3a9f192b131f7a9b0fe5783c684b23015fa67cc8
git remote remove origin
source /opt/miniconda3/bin/activate
conda activate testbed
echo "Current environment: $CONDA_DEFAULT_ENV"
python -m pip install -e .
ここには指摘したい点がたくさんあるが、SWE-bench の実行に必要なイメージ全体のサイズを減らすのに最も効く最適化は、どうすれば見つかるだろうか。
そこで、すばらしいツール dive(github.com/wagoodman/dive)を使う。これを使えば、イメージのレイヤーとそのサイズを確認できる。右側のファイルツリー表示で、各レイヤーでファイルシステムに実際に何が変わったかも見られる。
たとえば、Django 13371 のイメージについて、setup_env.sh が作るレイヤーに注目した dive の出力は次のとおりである。
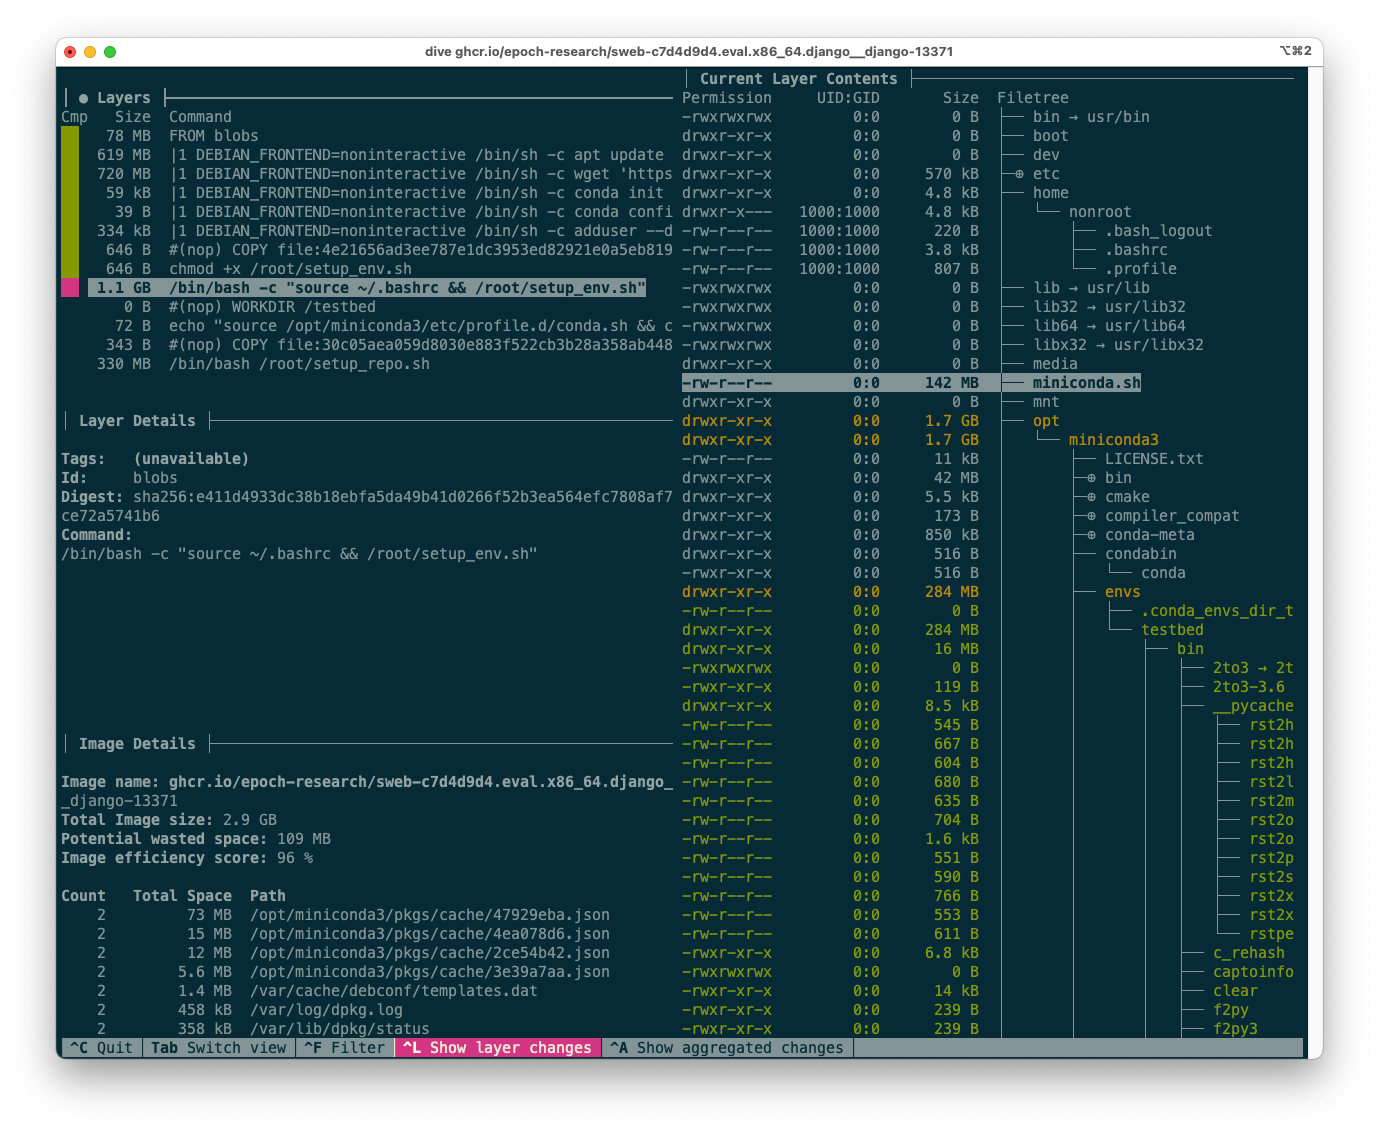
Django 13371 のイメージに対する dive ツールの出力。
次の節では、この出力をどう読み解いて最適化の手がかりを得るかを説明する。
git clone の処理を移す
上の出力の目立った特徴は、レイヤーのサイズ(左上)を見るだけで分かる。setup_repo.sh に対応する一番上のレイヤーが330MBもあるのだ。このレイヤーの最適化は、setup_env.sh のレイヤーの最適化より数十倍効果が大きい。setup_repo.sh のレイヤーはインスタンスごとに異なるからだ。(その比は SWE-bench 全体ではおよそ12対850、つまり70倍になり、SWE-bench Verified でも10倍を大きく超えるはずである。)
setup_repo.sh は、ディスク容量の面では大きく二つのことをしている。
- Django のリポジトリを git の全履歴ごとクローンする(
git clone -o origin https://github.com/django/django /testbed) - この特定のリビジョンに必要で、
envイメージにまだ入っていない追加の依存関係をインストールする(python -m pip install -e .)
どちらがより重要だろうか。レイヤーの中身を見ると、この場合、追加の依存関係はほとんど必要なく、330MBのほぼすべてがリポジトリのクローンで占められていることが分かる。
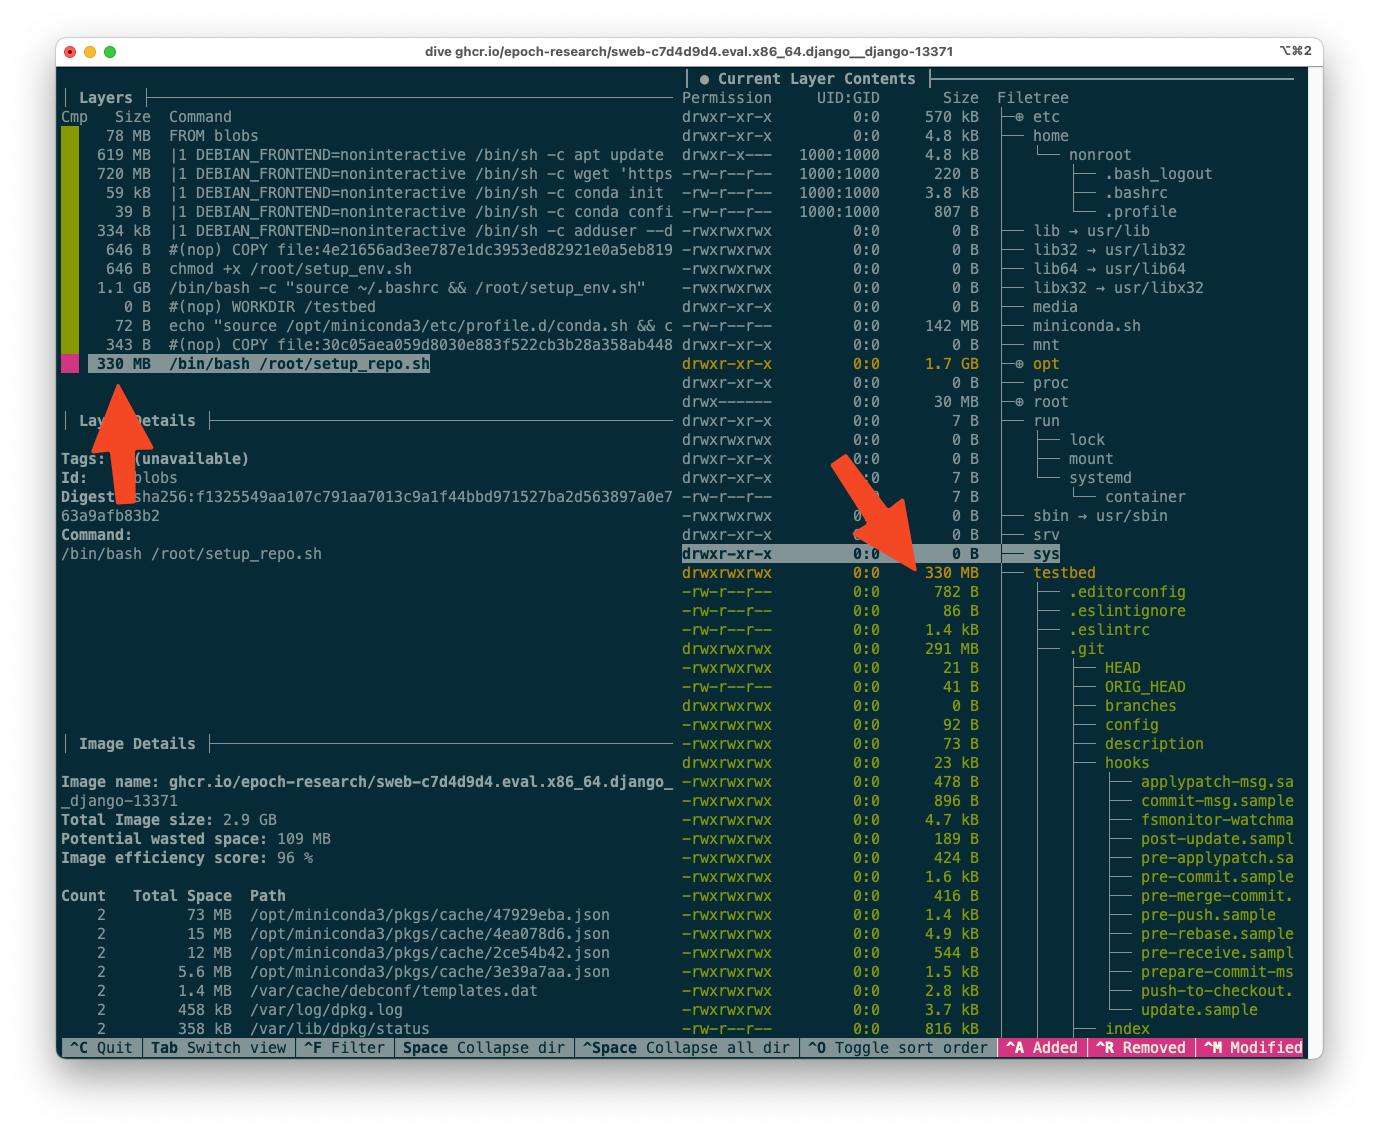
Django 13371 のイメージに対する dive の出力。最後の(一番上の)レイヤーに注目したもの。
ここに最適化の余地がある。git clone の処理を env イメージに移せば、多くの Django のインスタンスで共有できる。setup_repo.sh は正しいコミットに git reset --hard するだけでよくなる。.git に保存された git の履歴だけで、330MBのレイヤーのうち291MBを占めているので、この最適化はとりわけ効果が大きい。
新しい最後のレイヤーは40MBになる。
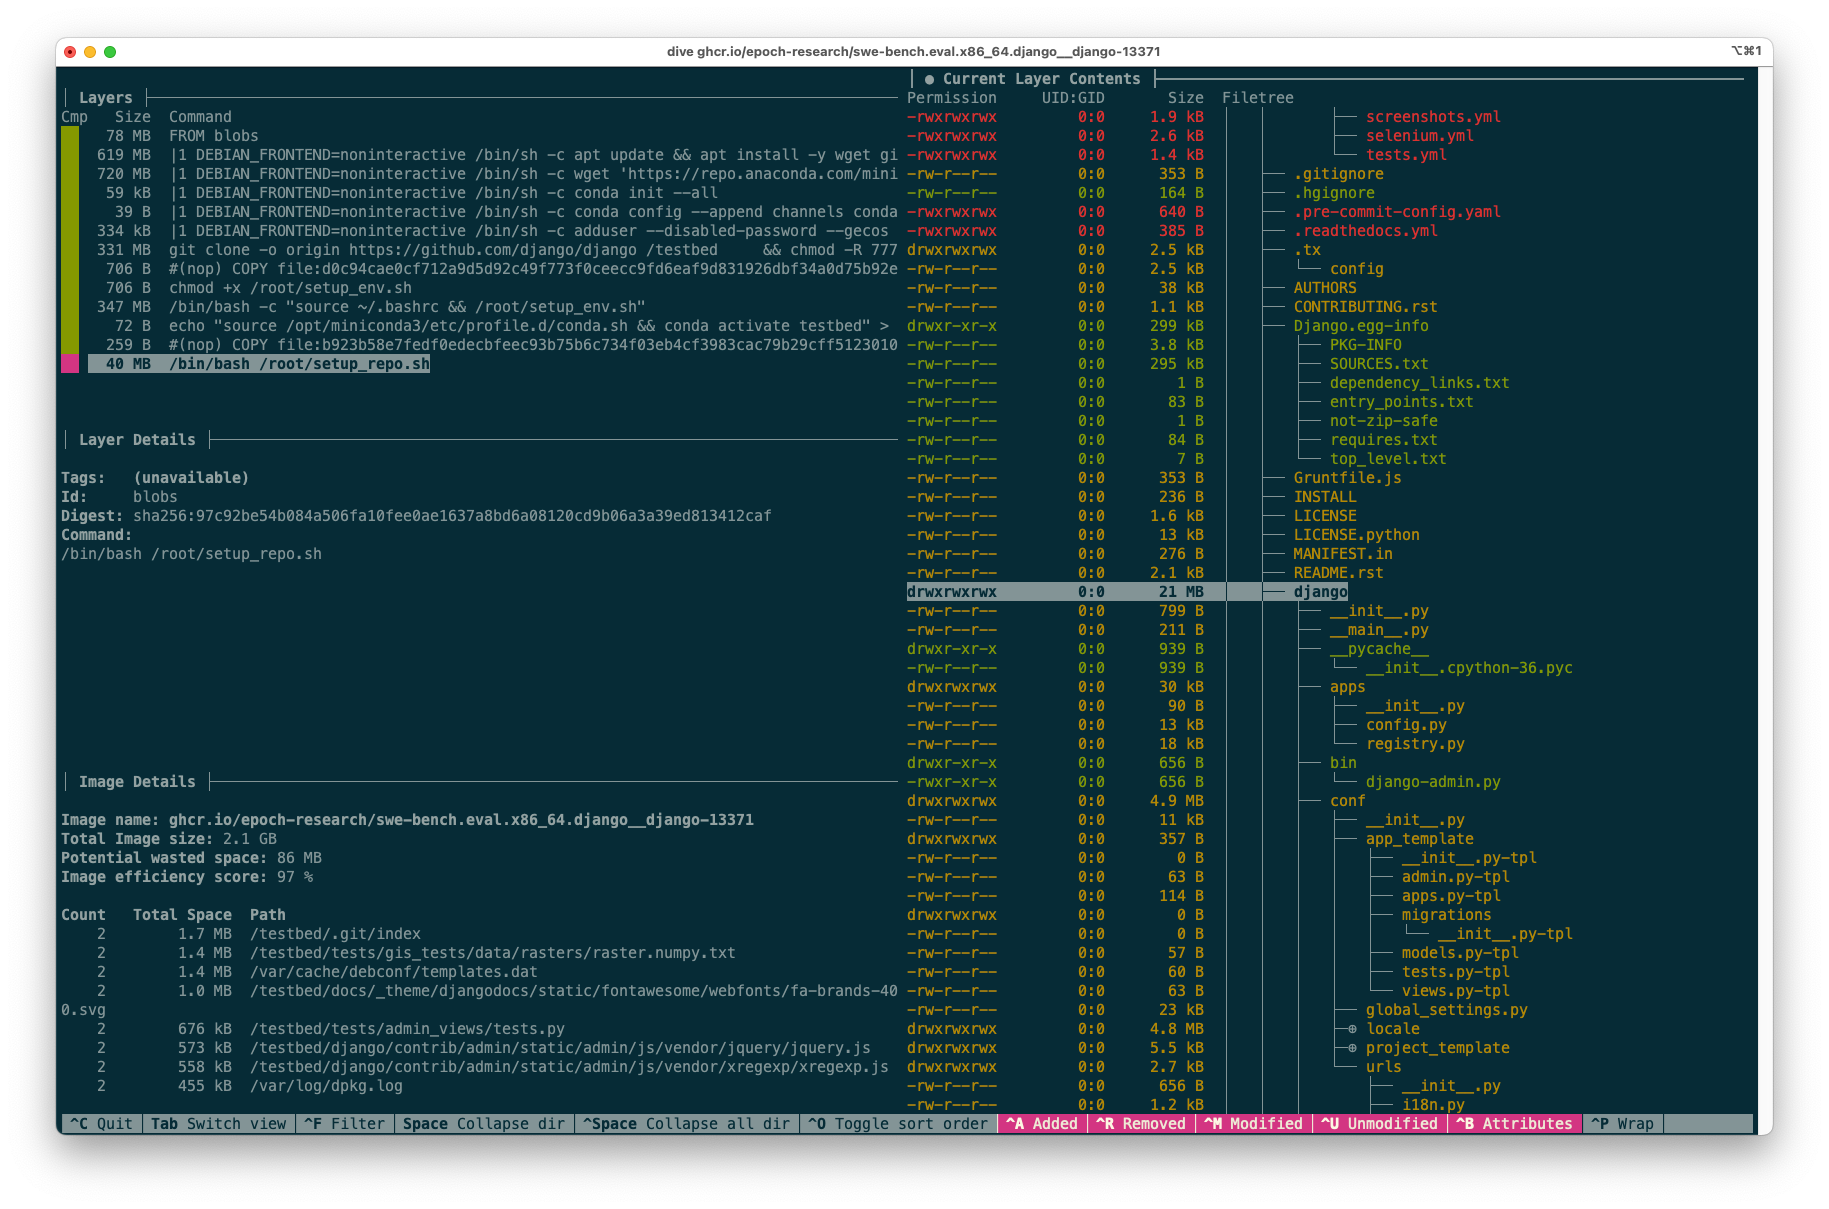
git clone の処理を env の段階に移した後、最適化された最後のレイヤーは330MBから40MBに減った。
このレイヤーのサイズにあたる二つのコードベースの差分は、まだまだ最適化できるに違いない。この例では、env の段階で最新版をクローンするだけという非常に素朴な方法を使っているので、差分はコードベース全体(git の履歴を除く)と同じサイズになっている。代わりに、instance の段階のリビジョンにより近いはずの適切なリビジョンをチェックアウトすることもできる。しかし今回のプロジェクトでは、最適化した instance のイメージが元のイメージと同一のままであることを確かめやすくするため、変更はできるだけ単純にとどめた。
git の履歴は含めるべきか?
今回のプロジェクトでは、純粋にサイズの最適化に絞った。公開レジストリのイメージは、SWE-bench の作者が用意した元のビルドスクリプトで生成されるものと同一であるべきだからだ。ただ余談だが、そもそも git の履歴を含めるべきかどうかは考えてみる価値がある。人間の開発者と同じように、モデルが過去の git の履歴にアクセスできるのは理にかなっている。しかしモデルは、PR がマージされた後の未来の履歴にアクセスできてはならない。未来の履歴に何らかの方法でアクセスできるなら、巧妙に不正をするモデルは理論上、評価で報酬ハッキングを行えてしまう。git reset --hard と git remote remove origin をした後でも、状況によってはそれが可能だと私は考えている。たとえばバージョンタグが使われていれば、モデルは git checkout <tag> で未来のタグをチェックアウトできる。あるいは、git fsck --lost-found などで、どこからも参照されていないコミットに何らかの方法でアクセスできるかもしれない。現時点でこれが問題になる可能性は低いと思うが、将来のモデルでは問題になりうる。
1.9 GB もある matplotlib の一番上のレイヤー
次に気づいたのは、matplotlib のイメージの多くがとくに大きく、9GBに達するものも珍しくないことだった。インスタンス matplotlib__matplotlib-23913 を見ると、setup_repo.sh は次のようになっている。
# setup_repo.sh for matplotlib__matplotlib-23913
set -euxo pipefail
git clone -o origin https://github.com/matplotlib/matplotlib /testbed
chmod -R 777 /testbed
cd /testbed
git reset --hard 5c4595267ccd3daf78f5fd05693b7ecbcd575c1e
git remote remove origin
source /opt/miniconda3/bin/activate
conda activate testbed
echo "Current environment: $CONDA_DEFAULT_ENV"
apt-get -y update && apt-get -y upgrade && DEBIAN_FRONTEND=noninteractive apt-get install -y imagemagick ffmpeg texlive texlive-latex-extra texlive-fonts-recommended texlive-xetex texlive-luatex cm-super dvipng
python -m pip install -e .
最後から2行目で、重い apt の依存関係を大量にインストールしている。これが原因の一つとなって、最後のレイヤーは1,900 MBにもなっている!
これらのコマンドは instance の段階に置くべきものだろうか。これらは、次のような設定用の辞書の pre_install キーから取られている。
# swebench/harness/constants.py

# ...
SPECS_MATPLOTLIB.update(
    {
        k: {
            "python": "3.8",
            "packages": "requirements.txt",
            "install": "python -m pip install -e .",
            "pre_install": [
                "apt-get -y update && apt-get -y upgrade && DEBIAN_FRONTEND=noninteractive apt-get install -y imagemagick ffmpeg libfreetype6-dev pkg-config texlive texlive-latex-extra texlive-fonts-recommended texlive-xetex texlive-luatex cm-super"
            ],
            "pip_packages": ["pytest", "ipython"],
            "test_cmd": TEST_PYTEST,
        }
        for k in ["3.1", "3.2", "3.3", "3.4"]
    }
)

SPECS_MATPLOTLIB.update(
    {
        k: {
            "python": "3.5",
            "install": "python setup.py build; python setup.py install",
            "pre_install": [
                "apt-get -y update && apt-get -y upgrade && apt-get install -y imagemagick ffmpeg"
            ],
            "pip_packages": ["pytest"],
            "execute_test_as_nonroot": True,
            "test_cmd": TEST_PYTEST,
        }
        for k in ["2.0", "2.1", "2.2", "1.0", "1.1", "1.2", "1.3", "1.4", "1.5"]
    }
)
pre_install のコマンドは matplotlib のバージョン k だけに依存し、個々のインスタンスには依存しない。したがって、このコマンドはより深いレイヤー、つまり env イメージに移すのが理にかなっている。そうすると一番上のレイヤーのサイズは1,900 MBから110MBへ、17分の1に減る。
pip のキャッシュを無効にする(あるいは、正気を失う方法)
はるかに単純な最適化は、pip のキャッシュを無効にすることだ。Dockerfile では、pip のキャッシュをイメージに残さないよう、pip に --no-cache-dir を渡すのが標準的なやり方である。この最適化をわざわざ取り上げるのは、これがきっかけで興味深い深みにはまり込んだからにすぎない。
セットアップ用のスクリプトには、あちこちに pip コマンドがある。差分を単純に保つため、私はこう考えた。pip のコマンドすべてに --no-cache-dir フラグを付けるより、環境変数 PIP_NO_CACHE_DIR を使うほうがよい、と。このきわめてまっとうな考えのせいで、私は人生の1日を失うことになった。
PIP_NO_CACHE_DIR=1 を設定していくつかのイメージで試すと、期待どおりに動いた。ところが、すべてのイメージをビルドし直そうとすると、一部のイメージがビルドできなくなっていることが分かった。次のような謎のトレースバックが出たのだ。
Traceback (most recent call last):
  File "/local/lib/python3.5/site-packages/pip/_internal/basecommand.py", line 78, in _build_session
    if options.cache_dir else None
  File "/lib/python3.5/posixpath.py", line 89, in join
    genericpath._check_arg_types('join', a, *p)
  File "/lib/python3.5/genericpath.py", line 143, in _check_arg_types
    (funcname, s.__class__.__name__)) from None
TypeError: join() argument must be str or bytes, not 'int'
pip の挙動がインスタンスによって変わりうることに私は当惑した。pip は、ほかのすべてのイメージが継承する base イメージで、最初にインストールされるものの一つだからだ。
RUN apt update && apt install -y \
...
python3 \
python3-pip トレースバックをたどると、2018年のこの古い GitHub の issue に行き着いた。この問題はこの PR で修正され、pip 19 以降に取り込まれていた。
しかし、私の base イメージはずっと新しいバージョンの pip を使っていた。
さんざん絶望し、歯ぎしりした末に、ようやく分かった。イメージは env の段階で、次のように Anaconda を使っていたのだ。
# swebench/harness/test_spec.py
cmd = f"conda create -n {env_name} python={specs['python']} -y"
Anaconda は Python のバージョンに応じて異なるバージョンの pip をインストールする。SWE-bench のデータセットで最も古い issue はかなり古い。古い Python を使っており、したがって pip も古い。たとえば Django 5470 は2015年のもので、対応するイメージは Python 3.5 と pip 10 を使っている。
では、pip < 19 で PIP_NO_CACHE_DIR=1 が pip をクラッシュさせるなら、どうやってキャッシュを無効にすればよかったのか。2016年の GitHub のコメントで知ったのだが、PIP_NO_CACHE_DIR=0 を設定すればよいのだ!
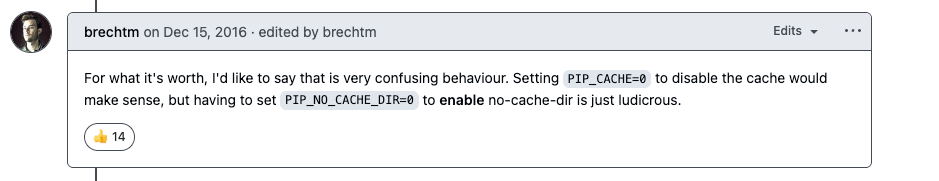
pip のキャッシュを無効にするのに PIP_NO_CACHE_DIR=0 を設定する必要があることに驚く、2016年の GitHub のコメント。
先ほどの PR(pip 19 に取り込まれたもの)はクラッシュを修正し、PIP_NO_CACHE_DIR=1 で期待どおりキャッシュが無効になるようにした。ただし後方互換性のため、PIP_NO_CACHE_DIR=0 でキャッシュが無効になるという「よく知られた」挙動も残された。
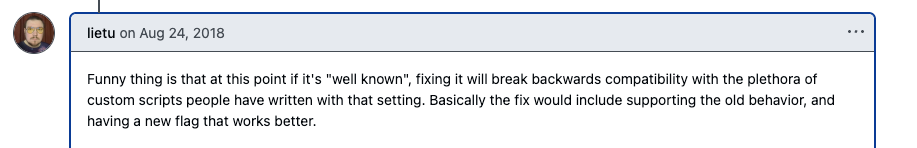
後方互換性について議論する、2018年の GitHub のコメント。
結局、PIP_NO_CACHE_DIR=0 を設定することで、すべてのインスタンスでキャッシュを無効にできた。もちろん、pip の最近のドキュメントはどれも、キャッシュを無効にするには PIP_NO_CACHE_DIR=1 を設定するよう指示しており、この挙動には触れていない。つまり私は、悪魔的に紛らわしい Dockerfile を作ってしまったわけだ。私はこの問題を説明する長いコメントをコードに書き、二度とこんなことはしないと誓った。
サイズへの効果
SWE-bench の2294個の Docker イメージは、約2,000 GBあるとされることがある。たとえばプリンストン大学と OpenAI のチームは次のように書いている。
デフォルトでは、ハーネスの
cache_levelはenvに設定されている。つまりハーネスは base イメージと環境イメージを保存するが、インスタンスイメージは保存しない。この設定では、base イメージと環境イメージは実行のたびに再利用されるが、約100GBのディスク容量を占める。リリース時点では、どの
cache_levelでハーネスを実行する場合も、約120GBの空きディスク容量が必要である。〔TAによる注:instance以外のどのcache_levelでも、という意味〕評価時間をできるだけ短くしたい利用者には、
cache_levelをinstanceに設定することを勧める。この設定では、ハーネスはすべてのインスタンスのイメージを保存する[…]。ただし、base イメージ、環境イメージ、インスタンスイメージのすべてが保存されるので、約2,000GBのディスク容量を占める。
(instance 以外のキャッシュレベルでの)120GBという数字は、評価の専門家のあいだで広く伝えられている。たとえば次のとおりである。
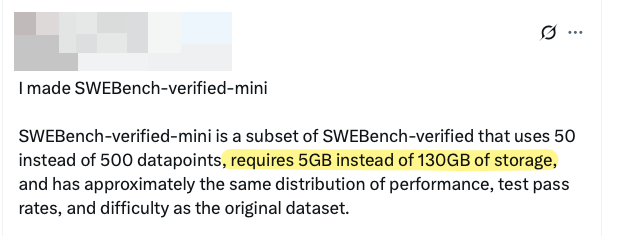
SWE-bench の評価に必要なディスク容量について伝えるスクリーンショット。
同様に、All Hands のチームは次のように書いている。
各エージェントはそれぞれ専用の環境で動くので、多数の環境を作る必要があり、それには数百ギガバイトの容量が要る
2,000 GBという数字がどこから来たのかは分からない。(元の)SWE-bench のイメージすべての個別のサイズを合計すると、3129 GiBになる。しかしこれは、イメージの多くが同じレイヤーを共有していることを無視している!Docker がこれらのイメージをビルドしたりプルしたりするとき、共有されたレイヤーは一度しか保存されない。
重複しないレイヤーのサイズだけを合計して正しく計算すると、最適化前の SWE-bench のイメージのサイズは684 GiBとなり、2,000 GBにはほど遠い。SWE-bench Verified の場合、元のイメージの実際のサイズは189 GiBである。(私の計算はスクリプト get_registry_size.py で再現でき、データもリポジトリで公開している。)
すべての最適化を行った後、SWE-bench のイメージの合計サイズは67 GiB(10分の1)になり、SWE-bench Verified のセットは30 GiB(6分の1)に収まった。
| SWE-bench(2290) | SWE-bench Verified(500) | |
|---|---|---|
| 最適化後(私たちのもの) | 67 GiB | 30 GiB |
| 元のイメージ | 684 GiB | 189 GiB |
| 元のイメージ(SWE-bench の作者による報告値) | 1,800 GiB (2,000 GB) | N/A |
SWE-bench Verified を約1時間で実行する
私たちのイメージレジストリを使えば、多くの主要なモデルについて、SWE-bench Verified を62〜73分で実行できる。具体的には、32コア・RAM 128GB の GitHub Actions のランナー1台でベンチマークを実行した。モデルには、会話全体で1問あたり30万トークンの上限を設けた(上限の対象は、会話中のすべてのリクエストの入力トークンと出力トークンの合計)4。主要な3モデルの実行時間は次のとおりだった。
gemini-2.0-flash-001:62分gpt-4o-2024-11-20:70分claude-3-7-sonnet-20250219:63分
先に述べたように、OpenHands は1台のマシンで1問あたり10分の評価時間がかかり、32台のマシンを並列に使うことで1問あたり約20秒まで短縮したと報告している。
私たちの最適化したイメージレジストリを使えば、大型のマシン1台で1問あたり約8秒の速度が出る。これは OpenHands の77倍の速さで、OpenHands が32台のマシンで達成した速度と比べても2.4倍速い。ただし、この比較は厳密に公平なものではない。OpenHands はハードウェアの詳細を公表していないが、おそらくもっと性能の低いマシンを使っていたからだ。
なお、私たちはこれらのモデルについて高いAPIレート制限を得ており、この実行時間を再現するにはそれが必要である。各評価では1億〜1億5,000万トークン(その大半はキャッシュされたトークン)を使ったので、評価中は毎分約200万トークンを使っていることになる。
イメージレジストリの使い方
私たちのイメージレジストリは公開されており、MITライセンスで、GitHub Container Registry でホストしている。各イメージには名前でアクセスでき、命名規則は SWE-bench の元の作者と同じにしている。現時点では、すべてのイメージに latest タグしかない。
名前の形式は ghcr.io/epoch-research/swe-bench.eval.<arch>.<instance_id> で、たとえば ghcr.io/epoch-research/swe-bench.eval.x86_64.astropy__astropy-13236 のようになる。
x86_64 では、2294イメージのうち2290(99.8%)をビルドでき、SWE-bench Verified のセットは500すべてをビルドできた。
arm64 では、2294イメージのうち1819を、動作を保証しない形で提供している。これらはテストしていない。
私の上司になりませんか?
この9か月、私はただ一人のエンジニアとして、Epoch AI の評価の仕組みをゼロから立ち上げてきた。私たちのベンチマーク・ハブの公開データはすでに政策立案者や研究者に使われており、Google で「AI benchmarks」と検索すると、たいてい上位3件に入る。だが私たちの目標ははるかに野心的だ。ベンチマーク評価の取り組みの先頭に立ち、私の新しい上司となる、リーダー経験のあるエンジニアを募集している。
自分が合っているかもしれないと思ったら、ぜひ応募してほしい!採用に至った人を紹介してくれた方には、5,000ドルの紹介ボーナスも用意している。
報酬は年20万〜30万ドルで、完全リモート勤務である。募集要項はこちら。この職について質問があれば、私にメールしてもらってもかまわない。
注
-
この比喩は紛らわしいかもしれないので注意してほしい。イメージはレイヤーを下から上へ積み重ねてビルドされるので、上のレイヤーは Dockerfile の後のほうに、下の(深い)レイヤーは Dockerfile の前のほうに来る。↩
-
この例は都合よく選んだものではない。Django のデータセットを issue 番号順に並べ、その中ほどから無作為に選んだ。(issue 番号はおよそ5000からおよそ17,000まであり、大半は10,000〜17,000の範囲にある。)↩
-
ドキュメントが説明しているように、マルチステージビルドの目的は、ある段階から別の段階へ成果物を選んでコピーすることである。
マルチステージビルドでは、Dockerfile の中で複数の
FROM文を使う。FROM命令はそれぞれ異なるベースを使うことができ、それぞれがビルドの新しい段階を開始する。ある段階から別の段階へ成果物を選んでコピーし、最終的なイメージに不要なものはすべて置いていくことができる。マルチステージビルドでは、成果物を選んでコピーすることで、最終段階を小さく、キャッシュしやすくする。SWE-bench では、段階は単に積み重なっているだけで、選んでコピーすることはしていない。キャッシュの観点からも、生成される最終的なイメージの観点からも、すべての命令を一つの Dockerfile に書いたのとまったく同じである。SWE-bench の作者が3段階に分けたのは、おそらく、生成される大量の Dockerfile を管理しやすくするためだろう。また、ディスク容量の限られたマシンでベンチマークを実行するとき、
instanceの段階だけを選んで削除できるようにするためでもあるだろう。↩ -
私たちのベンチマーク・ハブでの SWE-bench Verified の評価では、現在この上限を100万トークンにしている。また、評価はレジストリにあるイメージをそのまま使って実行しているのではなく、評価に使う SWE-Agent のツールを含むごく軽量なレイヤーをいくつか追加している。ほとんどのモデルでは、本番での実行時間は本稿の数字とほぼ同じである。出力の多い一部の推論モデルでは、100万トークンだとAPIのレート制限がボトルネックになる。評価の設定について詳しくは、ベンチマーク・ハブを参照してほしい。↩