
オピニオン
AIの未来を考えるための、計算資源にもとづく枠組み
原題:A compute-based framework for thinking about the future of AI
今後数十年で、AIはどのように展開していくと考えるべきだろうか。本稿では、AIによる自動化を考えるための、計算資源(コンピュート)にもとづく枠組みを説明し、擁護する。この枠組みは次の主張からなり、本稿全体でそれらを擁護していく。
- AIの最も顕著な影響は労働を自動化する能力であり、それはおそらく今世紀後半に生産性の爆発を引き起こし、歴史の流れを大きく変える。
- 有用な計算資源をどれだけ利用できるかが、AIの進歩を決める最も重要な要因であり、この傾向は予見可能な将来にわたっておそらく続く。
- 少なくとも短い期間で予測する場合には、重要で汎用的な性能指標のほとんどについて、AIの性能は比較的予測しやすくなる可能性が高い。
これらの考えはどれも新しいものではないが、私の目的は、この枠組みを1つのまとまった全体として明確に述べ、擁護する記事を提供することにある。そうすることで、AIの未来について Epoch AI の研究者たちが最も示唆に富むと考える見方を示す。この枠組みを使って、変革的AI(TAI)が2043年より前に到来する確率を47%とする根拠を示す。
概要
本稿の構成は次のとおりである。
第1部では、最も重要なのは、経済におけるさまざまな作業をAIがいつ自動化できるようになるかであると論じる。この節目の重要性は、AIが世界経済の成長率を大きく加速させ、世界を劇的に変えうると予測する経済の単純なモデルによって裏づけられる。
第2部では、AIの進歩を説明するうえで、データを利用できるかどうかは計算資源ほど重要ではないこと、そして計算資源はアルゴリズムの進歩を駆動するうえでも重要な役割を果たしているかもしれないことを論じる。
第3部では、AIの進歩は本質的に予測できないという広く持たれている見方に反論し、AIの能力は前もって予測できるかもしれないと考える理由を示す。
最後に第4部では、この枠組みを使って変革的AIの到来時期についての確率分布を組み立て、結論とする。1
第1部:AIによる広範な自動化
AIの到来時期(タイムライン)を論じるとき、注目すべき節目は汎用人工知能(AGI)、つまり「人間にできることはすべて」実行または学習できるソフトウェアシステムの開発だ、ということが当然視されがちである。しかし、この定義はあいまいである。たとえば、そのシステムがすべての人間を上回る必要があるのか、上位10%程度を上回ればよいのか、それとも中央値の人間を上回ればよいのかがはっきりしない。
おそらくもっと重要なのは、ある性質を備えた単一のソフトウェアシステムの到来を、なぜ気にかけるべきなのかがすぐにはわからないことである。一枚岩のAGIシステムが現れる前に、用途の限られたソフトウェアプログラムの集まりが世界を大きく変えることも十分ありうる(Drexler, 2019)。一般に、AIの到来時期は、AIが世界に及ぼす影響によって特徴づけるほうが有用だと思われる。しかし、それでも、AIがどんな影響を及ぼすと予想すべきか、その影響をどう測ればよいかという問いは残る。
出発点として、労働の自動化がAI開発の原動力になる可能性が高く、それがAI企業にこの技術を開発する巨大で直接的な金銭的動機を与えていると思われる。生産性爆発仮説によれば、AIが経済における重要な作業の大半を自動化できるようになれば、劇的な経済拡大が起こり、技術・科学・経済の成長率が現在より少なくとも1桁高くなる(Davidson, 2021)。
生産性の爆発は、経済成長の単純なモデルから頑健に導かれる帰結であり、このテーマを研究することがなぜこれほど重要なのかを説明する助けになる。注目すべきことに、生産性爆発のテーゼは、経済成長理論の分野で置かれるいくつかの標準的な仮定に、AIが人間の労働者の代わりになりうるという仮定を組み合わせるだけで、自然に導かれるように見える。この考えを次の節で説明する。2
だがその前に、この全般的な自動化の筋書きを、AIの未来についての別の見方と比べておく価値がある。広く影響力を持っているのは、Eliezer Yudkowsky と Nick Bostrom が描いたハードテイクオフのシナリオである(Yudkowsky 2013、Bostrom 2014)。このシナリオでは、AIの影響は局所的な離陸(テイクオフ)という形をとり、単一のAIシステムが世界のほかのすべてを合わせたよりもはるかに強力になる。しかも、この離陸はきわめて速く起こるので、世界の大半は手遅れになるまでそれに気づかないか、あるいはほかの理由でAIを止められない、と予測されることが多い。このシナリオは本質的に危険である。AIがその後、取り返しのつかない形で自らの意志を世界に押しつけるかもしれず、AIが人間の価値観と整合していなければ(ミスアラインメント)、それは破局的なものになりうるからである。
しかし、Epoch AI の研究者たちは、この特定のシナリオには懐疑的な傾向がある。ハードテイクオフのシナリオに対しては、信頼に足る反論が数多く出されている(たとえば Christiano 2018、Grace 2018)。私たちは、これらの反論がその可能性を排除するとは考えていないが、ハードテイクオフが既定の結末ではない(確率20%未満)と考える根拠にはなっている。この議論を蒸し返す代わりに、私たちの見方をよりよく理解してもらうために重要だと考える点をいくつかだけ挙げておく。
ハードテイクオフを予想する最も顕著な理由は、おそらく再帰的自己改善という考えから来ている。AIが自分自身を改善でき、それによって自己改善がさらにうまくなり、それが繰り返されるというものである(Good 1965)。しかし、AIがAIを改善することで変化が加速するという考えはありそうに思えるものの、この再帰的な改善が空間的に異常なほど局所化すると信じる強い理由はないと私たちは考えている。単一のAIエージェントが自分自身を改善するのではなく、この加速はおそらくもっと分散的なもので、AIが研究開発全般を加速させるという形をとるだろう。このより一般的な現象を再帰的技術改善と呼んで、再帰的自己改善という狭い場合と区別しよう。後者は、単一のAIが能力の面で「急上昇(foom)」し、きわめて短期間(たとえば数週間)のうちに世界のほかのすべてを合わせたものをしのぐ、という場合である。
AIの影響が強く集中するのではなく分散すると考える理由は数多くある。おそらく最も重要なのは、AIの進歩のボトルネックが、純粋な革新の才能よりも主に計算資源にあるなら、当初は力を持たないAIシステムが、半導体産業をすでに掌握していないかぎり、知能を爆発的に高めるのははるかに難しいと思われることである。後の第2部では、計算資源がAIの進歩の最も重要な原動力だと考える一応の(prima facie)理由があると論じることで、この前提を裏づける。
爆発的成長の単純なモデル
技術革新がない場合、産出は投入の増加に比例して増えると考えるのが妥当だろう。たとえば、労働者の数を2倍にし、労働者が頼る道具や建物、道路などの数も2倍にすれば、産出も2倍になる。これが、規模に関して収穫一定であるということの意味である。
しかし、労働者の数を2倍にすると、アイデアが生み出される速さ、ひいては技術革新の速さも上がる。この事実が重要なのは、しばしば Paul Romer に帰される重要な洞察、つまりアイデアには非競合性があるという洞察のためである。アイデアの非競合性とは、ある人がアイデアを使っても、ほかの人がそのアイデアを使うことを妨げないということである。たとえば、あなたが連鎖律を使っても、ほかの人が連鎖律を使えなくなるわけではない。このため、労働者がほかの人の生み出した技術革新を取り入れることで、生産への投入を2倍にすると産出は2倍を超えて増えると予想される。驚くべきことに、新しいアイデアが時とともにはるかに見つけにくくなるという現実的な仮定のもとでも、この効果はきわめて大きい(Erdil and Besiroglu 2023)。
規模に関して収穫逓増であり、投入が蓄積されて時間とともに継続的に再投資されうることを踏まえると、経済成長の準内生的モデルによれば、長期的には人口増加の帰結として生産性の爆発が見られるはずであり、経済成長は時とともに高い水準へ向かっていく。
このモデルが信頼できると思えるのは、人類史における成長の加速を単純に説明すると同時に、この加速が20世紀半ばのどこかで減速したように見える理由もすっきり説明するからである。
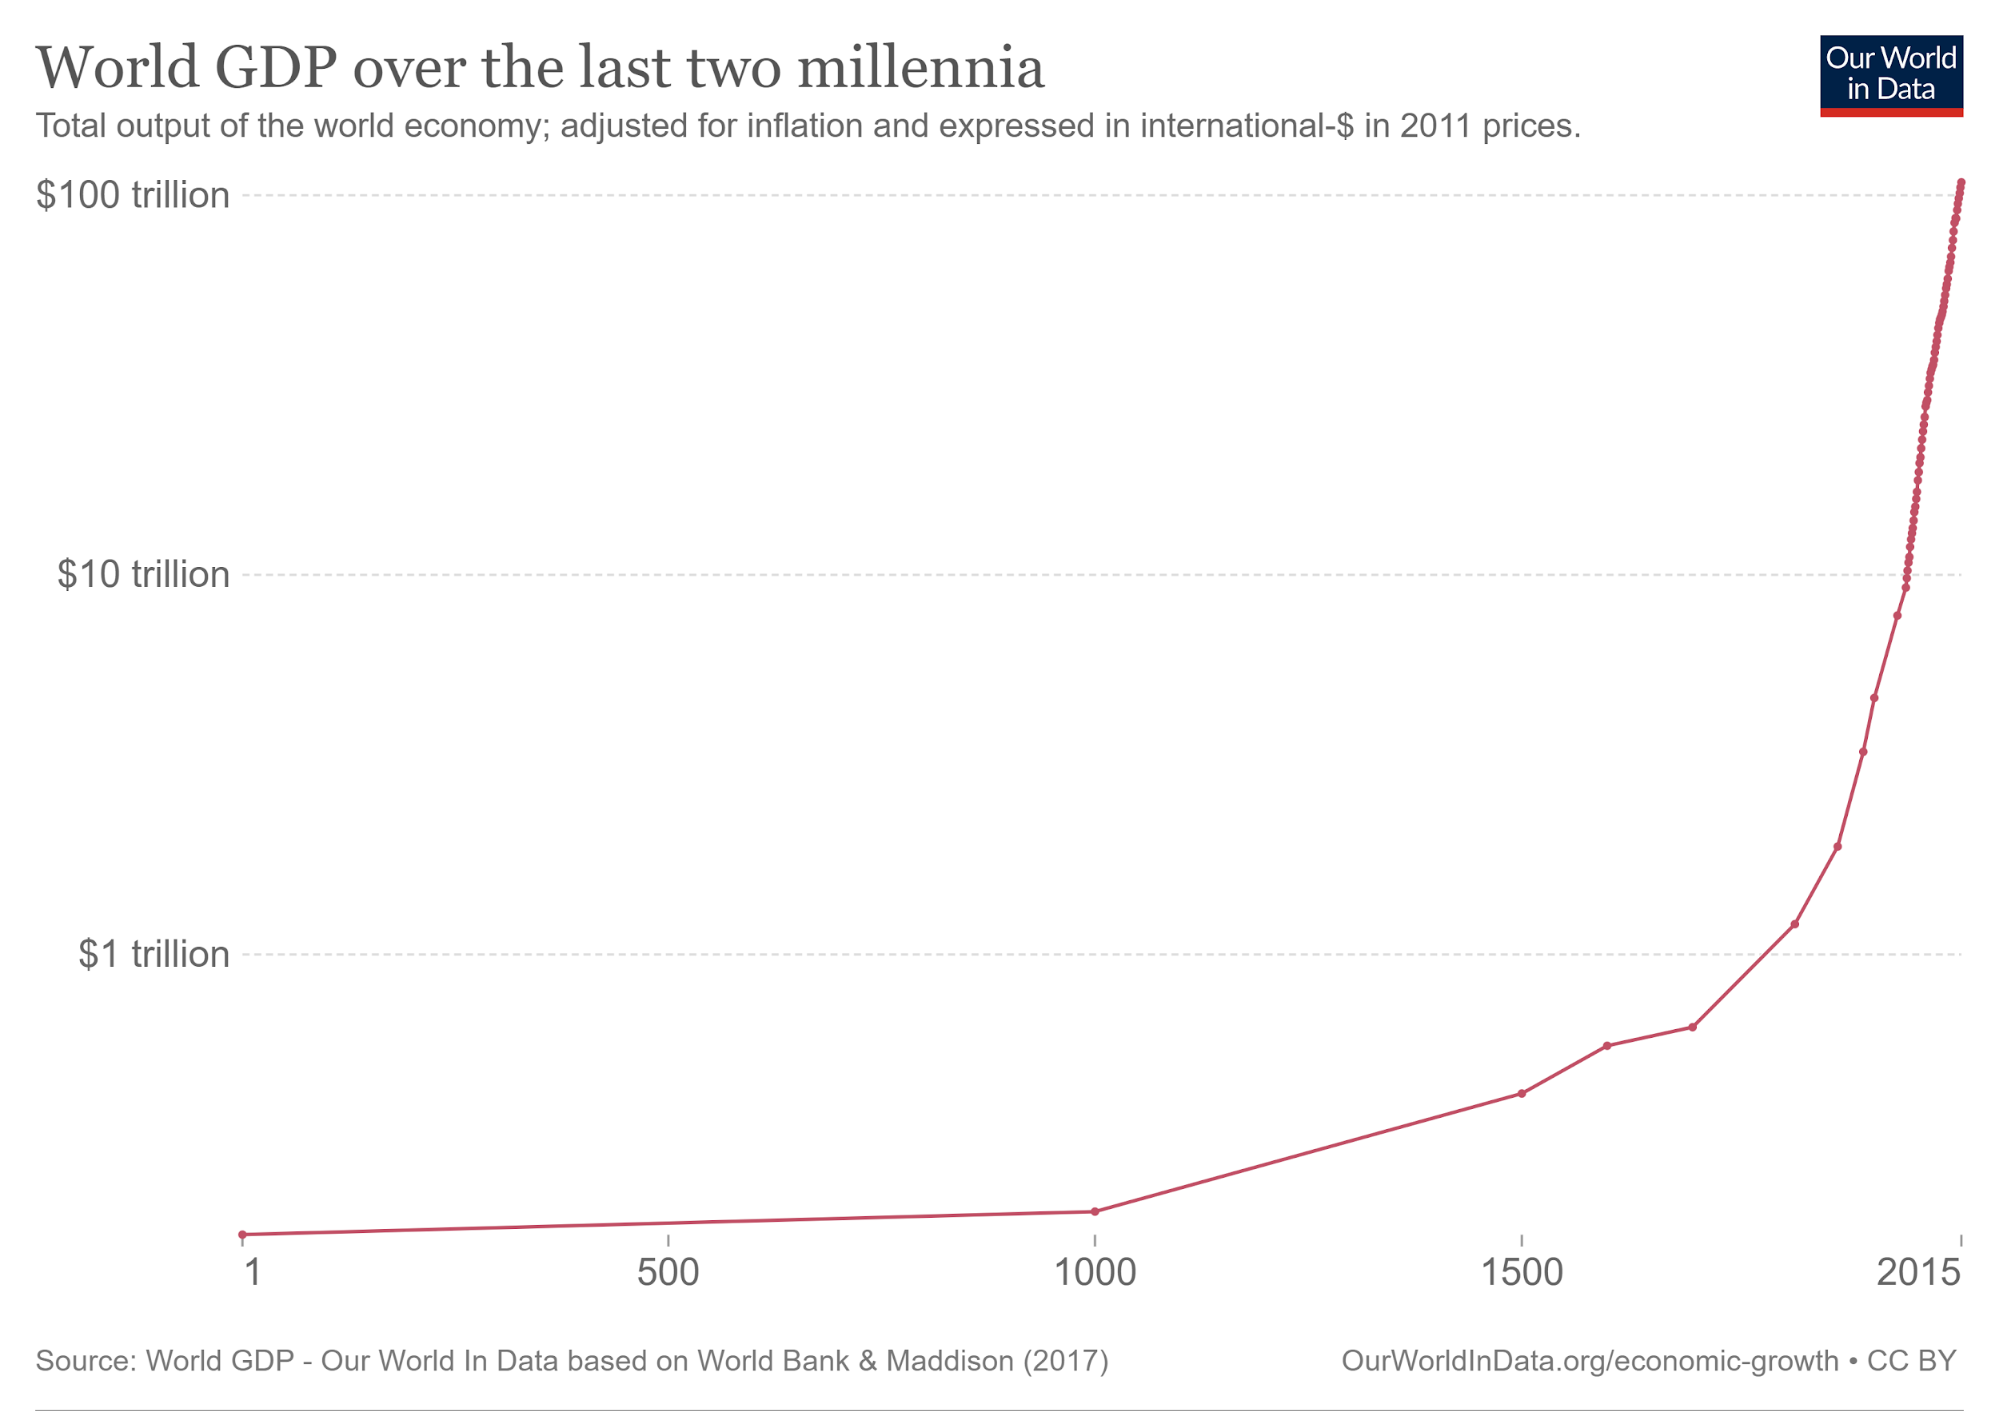
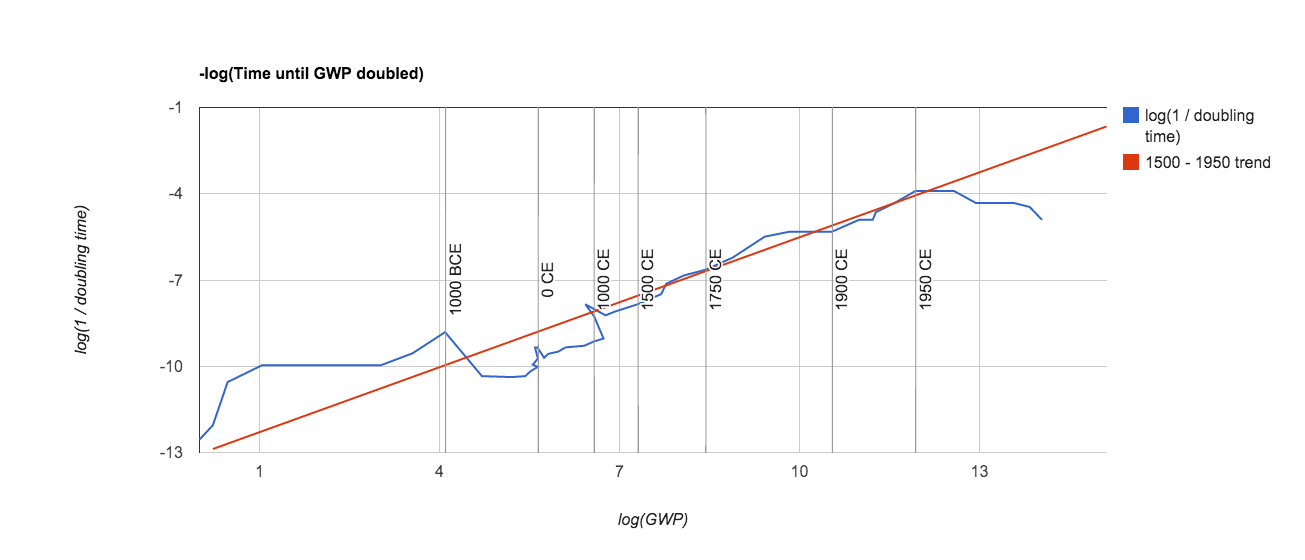
AI Impacts による図。
20世紀半ばごろに観察された減速は、人口転換を考慮すれば、準内生的モデルからそのまま導かれる。人口転換によって人口増加と経済成長の結びつきが断たれ、出生率が低下し、最終的には経済成長率も低下したのである。
これに対して、計算機ハードウェアの製造は人口増加と同じ制約に縛られないので、AIの労働力は非常に速く拡大しうる。人間の子どもを育てるのにかかる時間よりもはるかに速くである。おそらくもっと重要なのは、ソフトウェアはきわめて安価に複製できることである。したがって、AI労働者の「人口」は劇的に拡大しうるし、その過程で技術革新を生み、人口の拡大と同時にAIの性能も高めていける。
したがって、AIによる成長を意図的に遅らせるよう協調しないかぎり、人間の労働の代わりになるAIの導入は、経済の成長率を劇的に高める可能性が高いと思われる。少なくとも、物理的なボトルネックがそれ以上の加速を妨げるまではそうであり、それが起こるのは、現在の基準からすればきわめて高い成長水準に達してからかもしれない。
注目すべきことに、技術革新という仮定を取り除いても、爆発的成長という結論は維持できる。Carlsmith(2020)が、人間の脳は毎秒およそ FLOP を使うと推定したことを考えてみよう。FLOP あたりで人間の脳と同じくらい経済的に有用なソフトウェアを設計できるようになれば、新しい計算機ハードウェアを製造できるのと同じ速さで、人間に相当する労働者の人口を増やせることになる。計算資源の価格が現在のおよそ FLOP/$ のまま一定だと仮定すると、この単純なモデルでは、経済の産出のたとえば45%を新しい計算機ハードウェアに再投資すると、経済成長率は30%を超える。当然ながら、FLOP の価格が時とともに下がれば、この結論はさらに強まる。
もちろん、高度なAIがいずれ爆発的成長を引き起こしうるとわかっても、それがいつ起こると予想すべきかについてはあまりわからない。この生産性の爆発がいつ起こるかを予測するには、まずAIの進歩を駆動するものについて論じる必要がある。
第2部:計算資源を中心に据えたAI自動化の理論
ディープラーニングという現在のAIのパラダイムでは、性能を左右する主な投入要素は3つあるように見える。アルゴリズムの進歩、計算資源、データである。アルゴリズムの進歩はひとまず脇に置き、予見可能な将来の進歩を説明するうえで、最終的には計算資源が最も重要になるという一応の論拠を示す。
少なくとも、計算資源の増大が過去のAIの進歩を支えるうえで重要な役割を果たしたと考える強い理由はあるように思われる。過去10年で最も目覚ましいAIシステムのほぼすべて、たとえば AlphaGo Zero や GPT-4 は、たとえば1980年なら法外な費用がかかったであろう量の計算資源を使って学習された。歴史的に、多くのAI研究者は、汎用AIを生み出すには知能についての正しい理論を考え出すことが肝心だと信じていた。しかし研究者たちは、目覚ましい成果が出たのは、計算の価格が十分に下がって単純で「盲目的」な手法がうまく働きはじめてからだったということを、何度も繰り返し思い知らされた(Sutton 2019)。
この1年の間に、インターネット上で利用できるデータの総量が近い将来AIの進歩を制約しうるという予測が出てきた。しかし、Epoch AI の研究者たちは、こうした予測を疑う強い理由がいくつもあると考えている。
最も重要なのは、スケーリング則に関する最近の研究によれば、学習の際に計算資源を最適に配分するなら、パラメータ数と学習データはほぼ同じ速さで増えると予想されることである(Hoffmann et al. 2022)。学習計算量はパラメータ数と学習トークン数の積に比例するので、これは、必要なデータ量が計算資源のおよそ半分の速さで増えることを意味する。その結果、一般に、データよりも計算資源のほうが大きなボトルネックになると予想される。
より詳細な調査もこの知見を裏づけている。Villalobos et al. 2022 は、データセットの規模が増える現在の傾向を、少なくとも2030年まで、ことによると2050年まで維持できるだけの低品質なインターネットデータがあると推定している。3
計算資源を使って必要なデータを生成することで、ほぼ無制限の合成データを作れる可能性もある(Huang et al. 2022、Eldan and Li 2023)。また、動画や画像といったマルチモーダルなデータで学習すれば、必要な「相乗効果」が得られる可能性もある。つまり、あるモダリティでの学習によって別のモダリティでの性能が上がり、その逆も起こるということである(Aghajanyan et al. 2023)。そうなれば、テキストデータの入手に限りがあることがボトルネックにならず、モデルをはるかに大きな規模で学習できるようになる。ある規模を超えると、複数のモダリティで学習するほうがテキストだけで学習するよりも概念の学習に役立つ可能性を示した研究があり、この可能性に信憑性を与えている。
大まかに言えば、Epoch AI の研究者たちは現在、予見可能な将来には、利用できるデータの総量が汎用的なAIの進歩を制約することはないと考えている。とはいえ、データ全般のボトルネックという考えは、AIが特定の作業についてのデータによってボトルネックに陥るという考えとは区別することが重要である。中期的な将来にインターネットデータを使い果たすことはなさそうだが、広範な自動化が、乏しい高品質なデータ源でAIを学習させる必要がある一部の不可欠な作業のデータによってボトルネックに陥ることは、比較的ありそうに思われる。
不可欠だが入手しにくいデータ源がボトルネックになれば、それが解消されるまでAIの進歩は制約され、AIの影響が現れるのは遅れる。とはいえ、30年以上続くような非常に長い遅れが生じる可能性は、言語モデルの最近の発展に照らすと、あまりありそうにない。
背景を説明しておくと、基盤モデルのパラダイムでは、モデルは2段階で学習される。モデルを膨大で多様なコーパスで学習させる事前学習の段階と、事前学習データから得た知識を生かしつつ、モデルをより狭い作業で学習させるファインチューニングの段階である(Bommasani et al. 2021)。基盤モデルの下流での性能は、事前学習データの規模、ファインチューニングデータの規模、転移ギャップの関数として、転移のスケーリング則でうまく記述できるように見える(Hernandez et al. 2021、Mikami et al. 2021)。転移ギャップとは、事前学習から得られる利益の最大値として定義される。
ある作業から別の作業への転移ギャップが小さければ、高い性能を達成するうえでは、ふつうファインチューニングのデータよりも計算資源のほうが重要になる。というのも、転移ギャップが小さければ、より大きな容量で事前学習の分布をただ長く学習し、より多くの知識をファインチューニングの作業に転移させることで、効率よく性能を高められるからである。経験的には、自然言語の作業どうしの転移ギャップは比較的小さいように見える。GPT-4 のような大規模な基盤モデルは、作業に特化したファインチューニングがごくわずかでも、多種多様な作業で最高水準の性能を出せるからである(OpenAI 2023)。
もちろん、言語以外の作業どうしの転移ギャップは、言語の作業で観察されたものより大きいかもしれない。とくに、ロボット工学におけるシミュレーションから現実への転移ギャップは大きく、埋めるのが難しいかもしれない。これは多くのロボット工学者がこれまで主張してきたことである(たとえば Weng 2019)。しかし、ロボット工学における転移ギャップの大きさや、それがさまざまな作業でどう変化しているかを厳密に定量化しようとする試みは比較的少ないようである(Paull 2020)。ロボットの作業どうしの転移ギャップについての理解が深まるまでは、どの作業が計算資源よりもデータによって制約されそうかについて、確信を持って述べるのは難しいだろう。
とはいえ、言語モデルでの最近の目覚ましい成果を踏まえると、知的な作業どうしの転移ギャップは、手に負えないほど大きくはない可能性が高い。したがって、少なくとも情報を扱う労働については、作業を自動化するうえで、データよりも計算資源のほうが重要なボトルネックになる。米国の仕事の40%近くは完全にリモートで行うことができ、しかもそうした仕事は米国のGDPの中で不釣り合いに大きな割合を占めている(Neiman et al. 2020)。そのため、純粋に知的な作業を自動化するだけでも、産出の成長率が何倍にもなり、世界に巨大な影響を及ぼすことは十分ありうる。
アルゴリズムの進歩はどうか
以上の議論はアルゴリズムの進歩の役割を無視しているので、AIの進歩について不完全な姿しか描いていない。アルゴリズムの進歩は、一定の性能に到達するのに必要な学習計算量を時とともに減らすもので、少なくとも過去10年間はきわめて速かった。たとえば Erdil and Besiroglu 2022 は、ImageNet で一定の性能に到達するのに必要な学習計算量が、およそ9か月ごとに半減してきたと推定している。ただし、この値には大きな不確実性がある。
実際、混合整数線形計画法、SATソルバ、チェスエンジンなど、さまざまな分野で、進歩を説明するうえでアルゴリズムの進歩は計算資源と同じくらい重要であることがわかっている。これは興味深い一致であり、アルゴリズムの進歩がどこから来るのかを明らかにする手がかりになりうる(Koch et al. 2022、Grace 2013)。理論的な観点からは、アルゴリズムの進歩が究極的にどこから来るのかについて、少なくとも3つの主な説明があるように見える。
- 理論的な洞察。これはすぐに取り入れて性能を高めることができる。
- 規模によって採用が可能になる洞察。これはハードウェアが十分に進歩してはじめて起こる。一部のアルゴリズムは遅いハードウェアではうまく働かず、十分な規模まで拡大してはじめてうまく働きはじめ、それ以降に広く採用されるようになる、ということかもしれない。
- 新しいアルゴリズムの実験。たとえば、新しいアルゴリズムの候補について妥当な選択肢をすべて効率よく試すには、大量の計算資源が必要なのかもしれない。
これらの説のうち、(1) では先に述べた速さの一致を説明できない。しかし、たとえば Hanson 2013 が指摘するように、説 (2) と (3) なら問題なくこの一致を説明できる。どちらの場合も、アルゴリズムの進歩を最終的に駆動したのはハードウェアの進歩だからである。そうだとすれば、ここでも、計算資源が進歩を説明する最も重要な要因であるという一応の論拠が得られるように見える。
とはいえ、この結論は推測にもとづくものなので、あくまで暫定的に採用することを勧める。一般に、アルゴリズムの進歩を何が駆動しているのか、さらにはそれがどれくらいの速さで起こっているのかについてさえ、まだ多くの不確実性が残っている。
アルゴリズムの進歩を測る能力に影響する重要な要因の1つは、ある作業でのアルゴリズムの進歩がほかの作業にどの程度一般化するかである。これまでのところ、機械学習におけるアルゴリズムの進歩についてのデータの多くは ImageNet のものである。しかし、ImageNet でアルゴリズムを効率化する方法は2つあるように見える。1つ目は、汎用的な作業に当てはまる、より効率的な学習アルゴリズムを発明することである。2つ目は、ImageNet でだけ狭く進歩をもたらす、作業に特化した手法を開発することである。
私たちがより気にかけているのは汎用的なアルゴリズムの進歩の速さであり、理論上、特定の狭い作業でアルゴリズムの進歩の速さを測ると、それは過大評価されることになる。この考察から、推定値が汎用的な意味でのアルゴリズムの進歩を誇張していると考える理由の1つがはっきりする。
第3部:AIの性能の予測可能性
たとえ計算資源が機械学習の進歩の究極の原動力であり、アルゴリズムの進歩がそれと歩調を合わせて進むとしても、作業がいつ自動化されると予想すべきかを予測するには、まず学習計算量を性能に対応づける何らかの方法が必要である。
幸い、そのような方法を開発できると考える理由はいくつかある。AIの性能は規模の関数として本質的に予測できないという主張もあるが、この主張は誇張されていると考える理由がある。最近、Owen 2023 は、検討した作業の大半について、ニューラルスケーリング則が予測する上流の損失を考慮に入れれば、AIの性能を十分に後ろ向きに予測(レトロディクト)できることを見いだした。この手法がほかと違っていたのは、それまでの研究より多くの情報を活用した点である。それまでの研究の多くは、学習データの規模の役割を脇に置き、性能をモデルの規模の関数として後ろ向きに予測しようとしていた。
モデルの性能を予測するうえでおそらく最大の障壁は、創発的能力の存在である。創発的能力とは、ある規模のモデルで突然現れ、そのため、より小さな規模での性能を外挿しても予測できない能力と定義される(Wei et al. 2022)。現在、創発的能力がどれほど広く見られ、どれほど重要なのかについて活発な論争があり、創発的とされる能力の大半は幻にすぎないと断じる人もいる(Schaeffer et al. 2023)。
少し一般化しすぎることを承知で言えば、Epoch AI の私たちは、少なくとも近い将来については、AIの性能は予測可能だと比較的楽観的に考えている。これは、十分に探究されていない多くの研究の流れに依拠した複雑な論争だが、私たちは楽観的になれる暫定的な理由をいくつか見いだしている。
AIの性能の予測が手に負えるものかもしれない理由
創発の例の多くは、その作業での性能が本質的に不連続であることから生じているように見える。たとえば、平方採中法が生成する数列の次の数をまったく予測できないことと、次の数を完全に予測できること(これにはアルゴリズムを学習することが必要になる)の間には、離散的な違いがある。そのため、モデルがある規模でこの作業を突然学習しても驚くにはあたらない。
しかし、科学的推論のように、私たちが自動化したいと考える作業のほとんどはこうした形をとらない。とくに、重要な知的作業のほとんどについて、「その分野についてとにかく推論できる」ことと「その分野について完璧に推論できる」ことの間には、なだらかな連続体があると考えるのがもっともらしい。このモデルは、創発はおもに、労働を自動化する能力の急激な飛躍にはつながらない作業で起こると予測する。
さらに、経済的な価値はふつう、1つのことだけをうまくこなすことではなく、互いに補い合う多くのことをうまくこなすことから生まれる。創発は汎用的な作業よりも狭い作業で最もよく見られるようであり、汎用的な作業での性能を、狭い下位作業の集まりにわたる平均的な性能とみなせば、これは理にかなっている。
たとえば Owen 2023 は、BIG-bench の作業の平均と MMLU の作業の平均のどちらでも、規模の関数として性能がなだらかに向上するように見えることを見いだした。どちらも、解くのに複雑な推論能力を要する多種多様な作業を含んでいる。こうした事実から、経済におけるすべての作業を合わせた平均的な性能も、規模の関数としてきわめてなだらかに向上するかもしれないことが分かる。
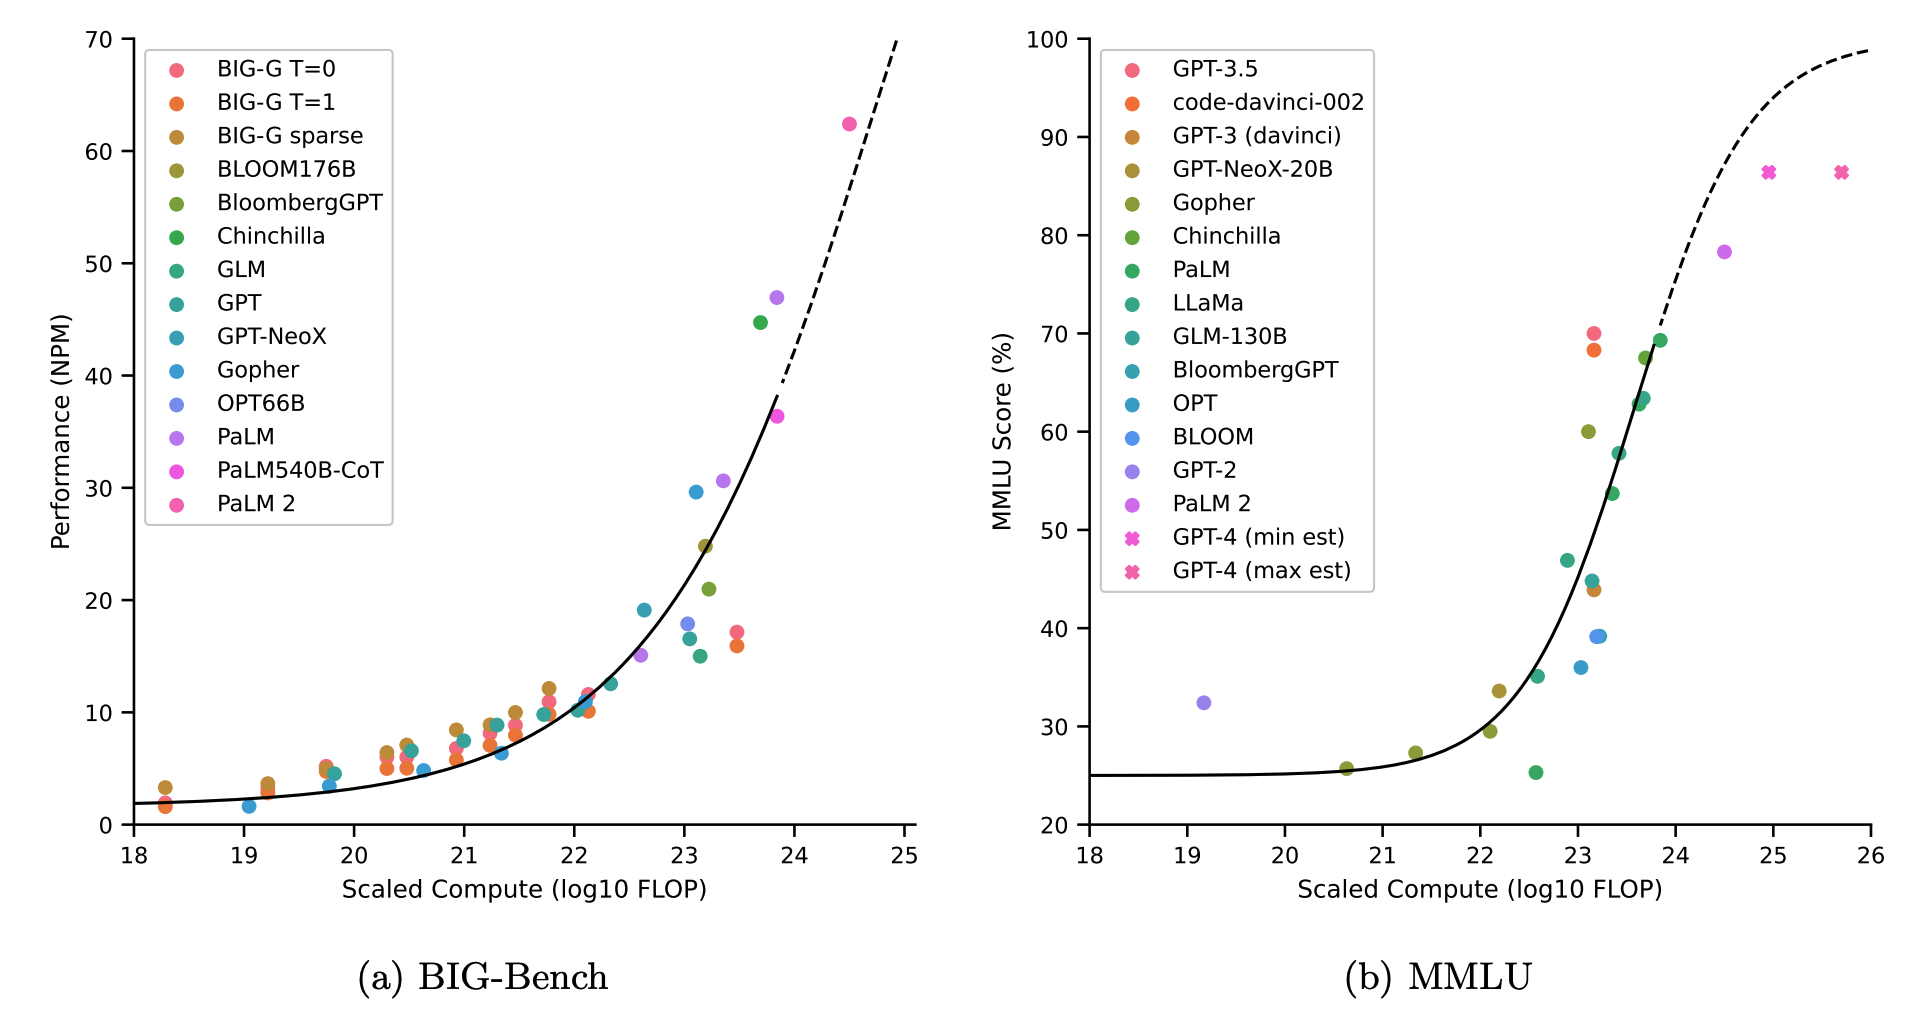
ベンチマークの総合的な性能は、規模からかなり予測できる。図は Owen 2023 より。
モデルの性能を予測するには、学習への投入以外の情報も取り入れられることにも注意が必要である。たとえば Jason Wei は、代理指標を使って主要な指標での性能を予測する方法がまだ十分に探究されていないと指摘している。4
理論モデルによる性能の予測
もちろん、AIの性能が原理的には規模の関数として予測可能だとしても、経済における作業の大半で、AIが現在どのように向上しているかについてのデータはない。そのため、AIがいつ広く導入されるかを予測するのは難しい。いずれこうしたデータが手に入ることを期待しているが、さしあたり、AIの重要な能力を予測したいなら、この問題をより理論的な観点から考えざるをえない。
「直接的アプローチ(Direct Approach)」とは、変革的AIを予測するという問題にいくらかの光を当てようとする理論モデルに私が付けた名前である。これはほかのモデル、主に Ajeya Cotra の生物学的アンカーの手法を補完することを目指している。
この名前は、経験的なスケーリング則を直接解釈することで高度なAIを予測しようとすることに由来する。以下は、このモデルの主な仮定と結果の概略である。より包括的な説明は最近のブログ記事で行った(報告書の全文もある)。
私の見るところ、知的労働を自動化するうえでの重要な難しさは、機械に長い系列にわたって確実に考えさせることにあるように思われる。「確実に考える」とは、「文脈をまとまりよく取り込んだ、論理的で一貫した理由づけを考え出し、真で関連のある結論に達すること」を意味する。「長い系列」とは、知的作業のうち最も難しく最も重要な部分がふつう行われる、十分に長い範囲を意味する。
この定義は厳密ではないが、モデルの学習分布における上流の損失を解釈するための単純な枠組みを導入すれば、この考えを理論的な分析にかけやすくできる。
この枠組みの根底にある基本的な仮定は、見分けがつかないことは能力があることを意味する、という考えである。たとえば、AIが人間の書いた数学論文と見分けのつかない数学論文を書けるなら、そのAIは少なくとも人間の数学者と同程度の能力を持っているはずである。そうでなければ、AIの出力と人間の出力を見分ける何らかの方法があることになる。
さらにいくつかの数学的な仮定を置けば、スケーリング則を使って、モデルが生成した出力と学習分布の出力を、望む信頼水準で見分けるのに平均して何トークン必要かを計算できる。5
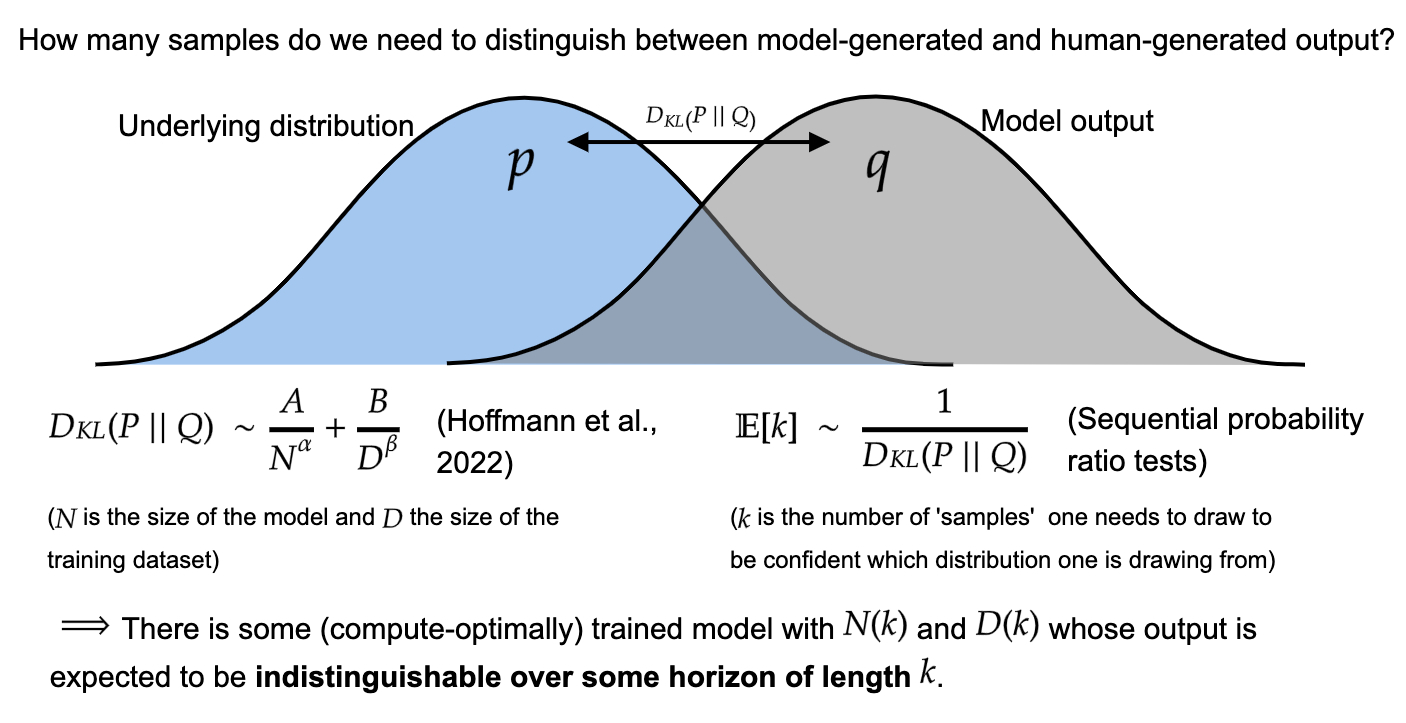
見分けがつかないことは能力があることを意味するという仮定のもとで、この方法を使えば、長い範囲にわたって能力を発揮できる、つまり長い系列にわたって確実に考えられるモデルを学習させるのに必要な学習計算量の上限を求めることができる。このモデルが直接の推定値ではなく上限を与えるのは、将来は、ディープラーニングで人間のふるまいを模倣する以外の方法で変革的AIが作られるかもしれないからである。
これらの結果は次の図にまとめられる。図は、2022年のアルゴリズムのもとで、見分けやすさが計算資源の関数としてどう変化するかを示している。本質的なパラメータは2つある。(1) 言語モデルが知的労働を自動化できるようになるまでに、確実で質の高い推論を行えなければならない範囲の長さ(ホライズンの長さ)と、(2) 理想的な予測器と比べて、人間が出力を見分ける能力(「減速(slowdown)」パラメータと呼ぶ)である。後者は、人間が「正しい」結果をどれほどうまく見抜けるかの限界を定める。ごく大まかに言えば、減速の推定値が低いほど、モデルが実在の人間の代わりになるには、より賢い判定者から見てもモデルの出力が見分けられないものでなければならない、と考えることに対応する。slowdown=1 は理想的なベイズ的判定者にあたる。
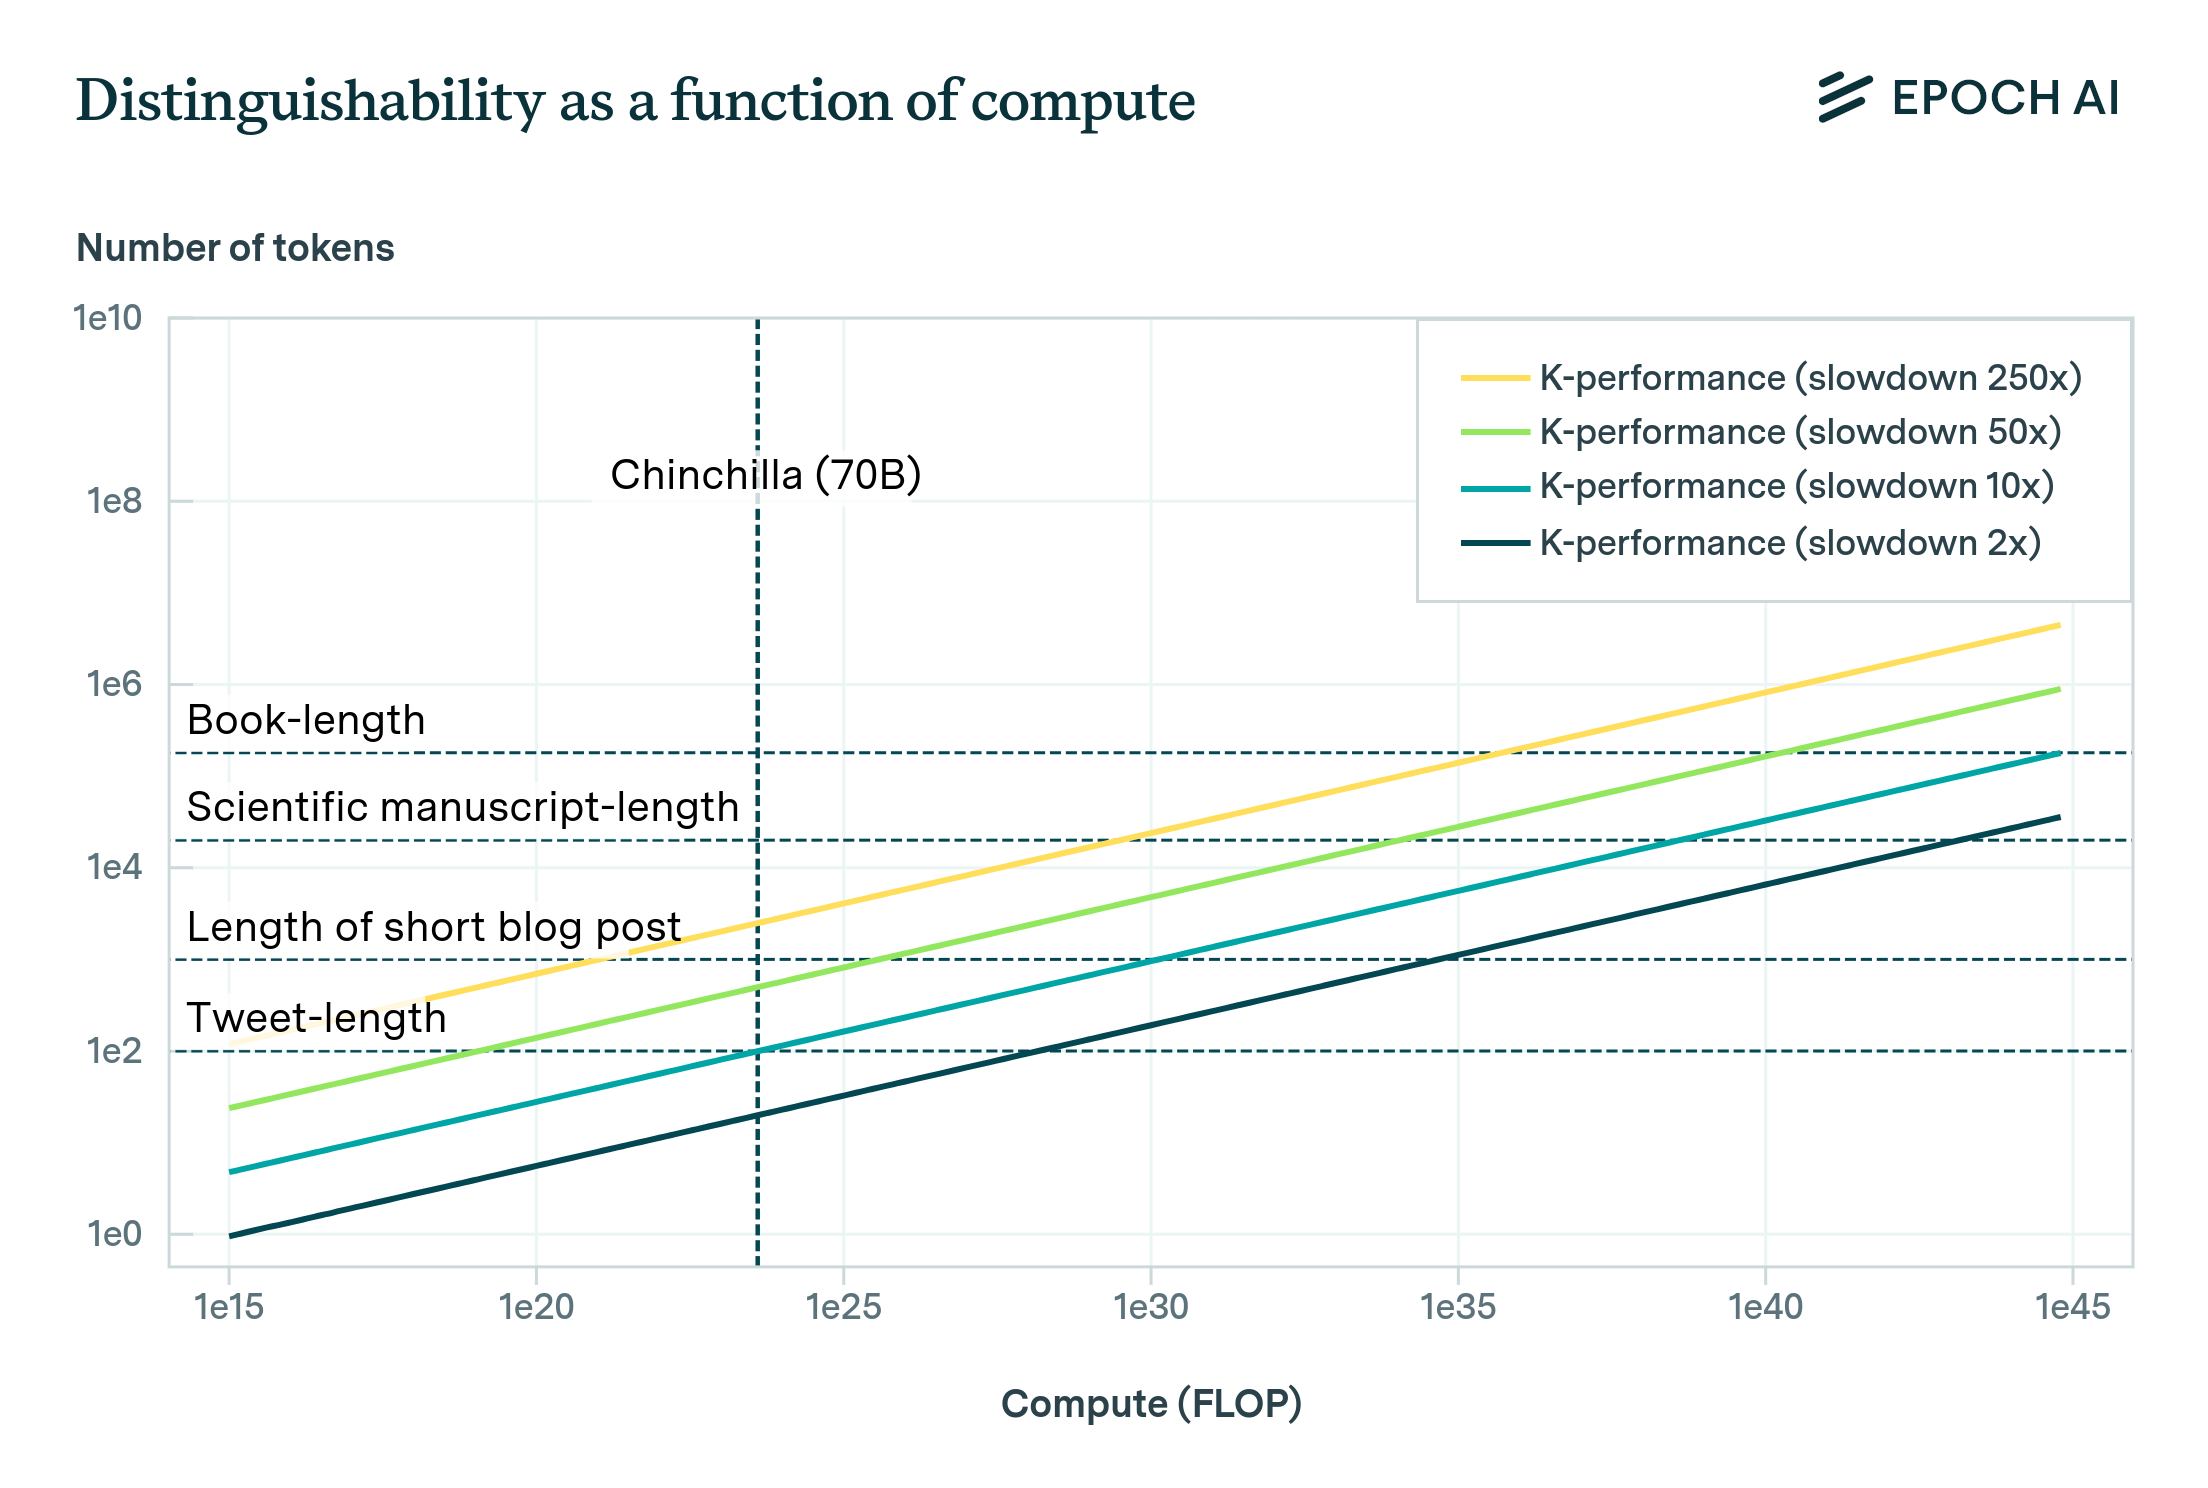
直接的アプローチは、一般的なインターネットデータで学習した Hoffmann et al. 2022 に依拠しているので、より複雑な分布には当てはまらないかもしれない。とはいえ実際には、べき乗則のスケーリングは、多種多様なデータ分布、さらにはアーキテクチャをまたいでも、いたるところで見られることがわかっている(Henighan et al. 2020、Tay et al. 2022)。これらのべき乗則の係数はしばしばかなり異なるものの、スケーリングの指数はデータ分布をまたいでよく似ているように見える(Henighan et al. 2020)。したがって、直接的アプローチを使った推定は、Hoffmann et al. 2022 の研究で使われたデータが単純であるために系統的に偏っているかもしれないが、この偏りは、それを念頭に置いておくだけで(たとえば推定値に計算資源を2桁上乗せするなどして)補正できると考えられる。
この効果を考慮したうえで、私個人としては、直接的アプローチは、2022年のアルゴリズムを使えば、平均的な科学論文を超える長さの系列にわたって人間とほぼ見分けがつかないモデルを、おそらく約 FLOP 未満で学習させられることの有力な証拠になると考えている。注目すべきことに、この量は Bio Anchors 報告書にある進化のアンカーの約 FLOP よりはるかに小さい。しかも、これはあくまで、幅広い作業で人間の性能に並ぶのに必要な本当の学習計算量に対する、厳密には(緩い)上限である。
第4部:AIの到来時期のモデル化
計算資源がAIの中心的な原動力であり、変革的AI(TAI)がディープラーニングという現在のパラダイムに似たものから生まれるのであれば、TAIの到来を推定するのに使える、少数の自然なパラメータがあるように見える。1 それらのパラメータは次のとおりである。
- TAIを学習させるのに必要な総学習計算量
- 最大規模の学習への支出の増加率の平均。これはおそらく、世界総生産(GWP)のかなりの割合のところで最大値に達する
- 計算機ハードウェアの価格性能比の向上率の平均
- アルゴリズムの進歩の成長率の平均
Epoch AI は、これらのパラメータについての自分なりの推定値を入力し、TAIの到来時期の分布を得られるインタラクティブなモデルを作った。
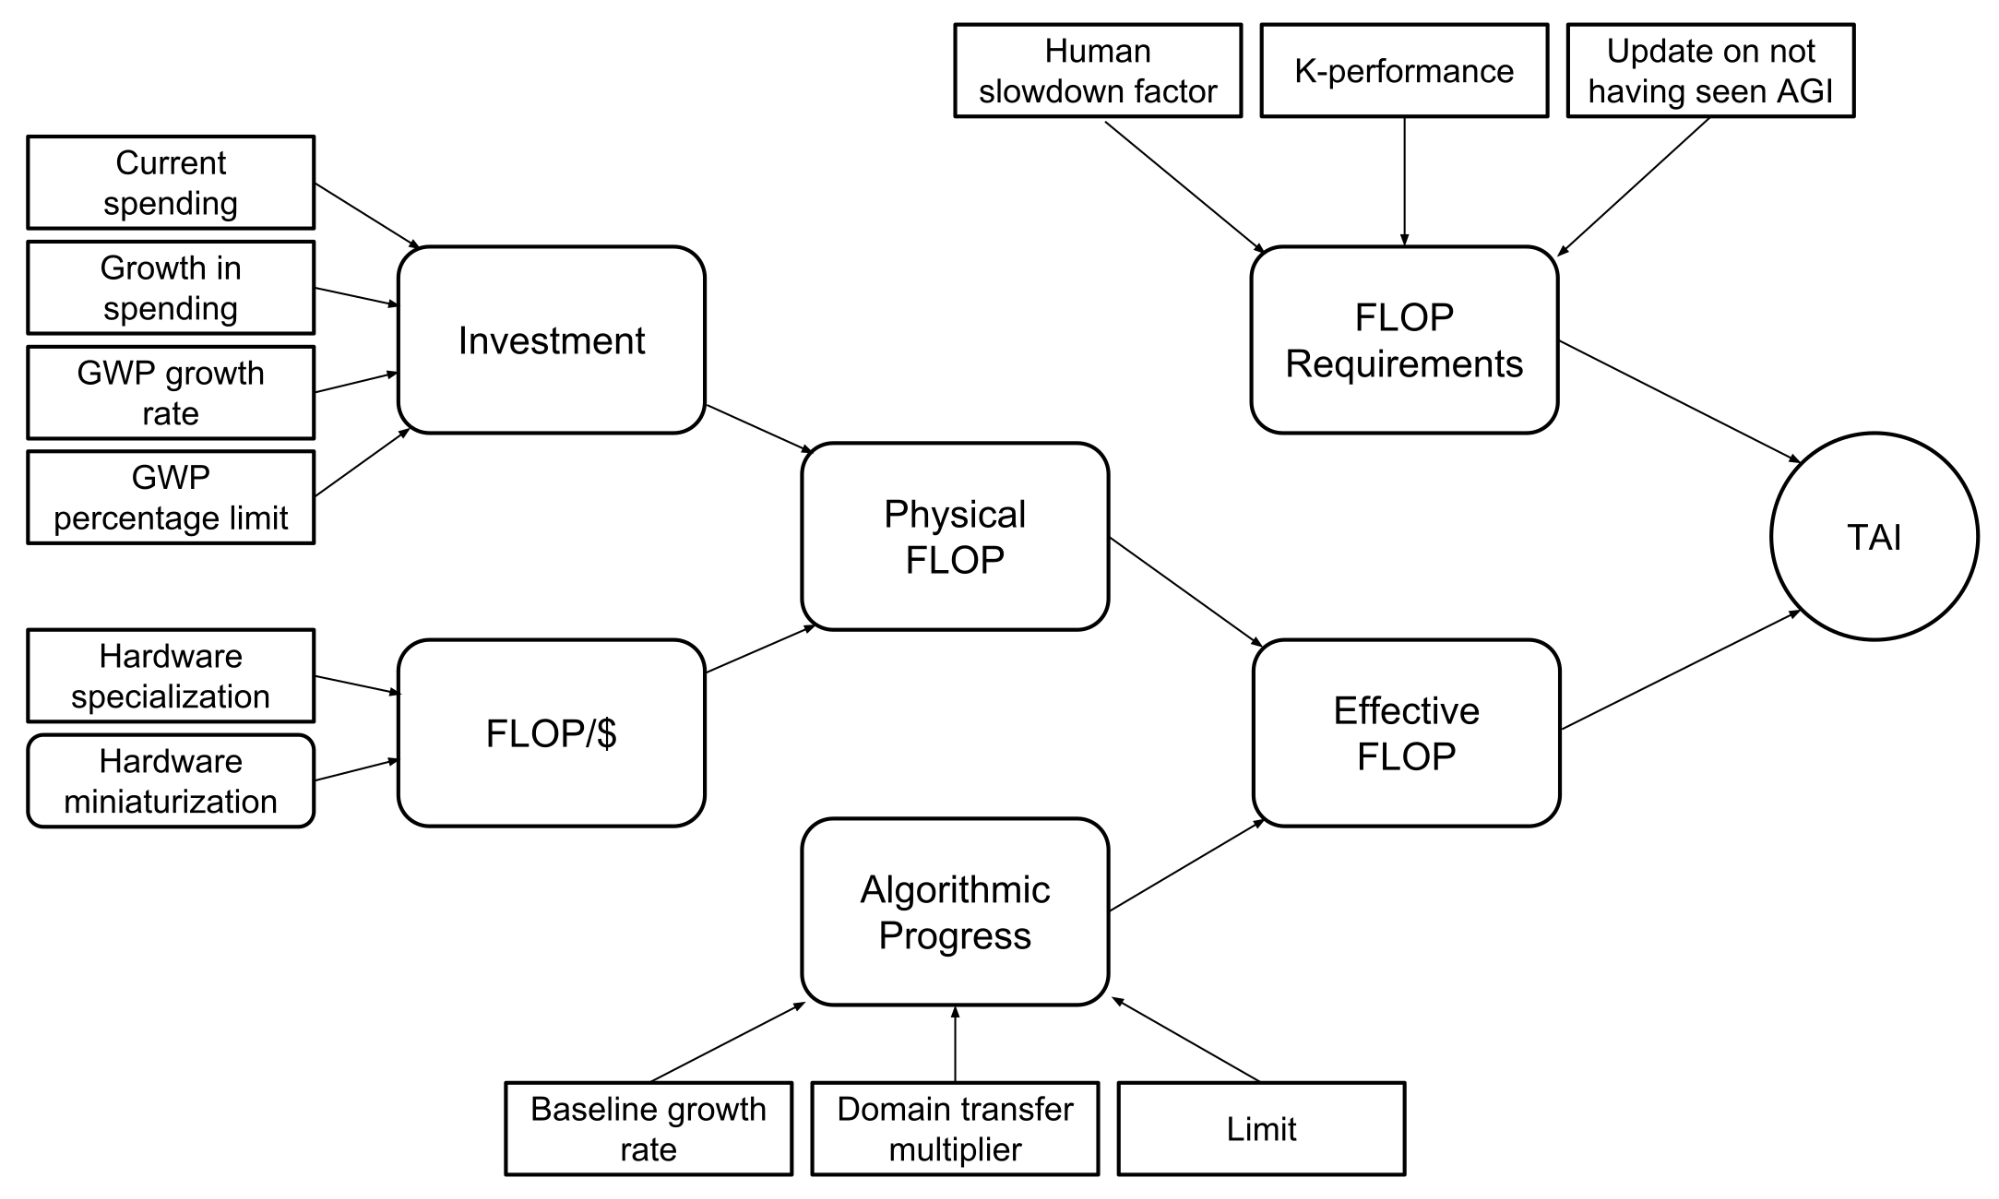
Epoch AI のチームが開発したインタラクティブなモデルの概観。
このインタラクティブなモデルは、各パラメータについて既定の推定値を用意している。学習計算量の必要量の分布を推定するには直接的アプローチを使っているが、代わりに生物学的アンカーが与える分布を使うことも簡単にできる。パラメータの値は過去のデータから推定している。私たちの経験では、妥当なパラメータ値を与えると、このモデルはたいてい短期から中期の到来時期、つまり今から5〜45年の範囲を示す。
とはいえ、このモデルは2つの重要な理由で控えめなものである。1つ目は、直接的アプローチが、TAIを学習させるのに必要な学習計算量の直接の推定値ではなく、上限しか与えないことである。2つ目の理由は、このモデルが、支出の増加率、価格性能比の平均的な向上、アルゴリズムの進歩の成長が、過去とほぼ同じ速さで続くと仮定していることである。しかし、AIが経済の産出を拡大させれば、これらの各パラメータの成長率を加速させるかもしれない。
作業が段階的に自動化されることで、これまでの傾向がどう加速しうるかを扱うには、本稿で示せるよりも慎重な分析が必要になる。この効果がどれほど強いかを直感的につかむには、Davidson(2023)が開発したモデルを調べるとよい。既定のパラメータ設定では、完全な自動化は2040年ごろ、つまり今から17年後に達成される。部分的な自動化の効果を無効にすると、6 この結果が達成されるのは2053年、つまり今から30年後になる。
ごく短い到来時期への反論
計算資源を中心とする枠組みは、ごく短い到来時期(4年未満)を否定するいくらかの証拠にもなる。単純な議論の1つは、現在の計算資源のストックに目を向け、人間の脳に匹敵する計算効率を持つAGIのソフトウェアがすぐに手に入ったとして、変革的な成長が可能かどうかを見るというものである。AGIが目前に迫っていると考えているのでなければ、これは大胆な仮定であることに注意してほしい。しかも、この場合でさえ、ごく短期間での変革的な成長は疑わしい。
この主張を裏づけるために、NVIDIA の H100 80 GB GPU が現在約3万ドルすることを考えてみよう。NVIDIA がAI関連のハードウェア市場を支配していることを踏まえると、次のように推論できる。同社のデータセンター売上高は現在、年間150億ドル規模であり、売上高の年平均成長率が2012年以降約21.3%で、その間にハードウェアも急速に進歩したことを考えると、現在世界にある H100 80 GB と同等のAIハードウェアは、おそらく750億ドル分に満たない。H100 80 GB GPU は最大でも約4000 TFLOP/s しか使えないので、これは、世界のすべてのAIハードウェアを合わせても、最大で約 FLOP/s しか生み出せないことを意味する。
Carlsmith(2020)による人間の脳の計算量の推定値の中央値は約 FLOP/s である。つまり、人間の脳に匹敵する計算効率を持つAGIのソフトウェアが突然手に入ったとしても、現在のハードウェアのストックでは、最大でも人間約1,000万人に相当する労働者しか維持できない。
(1) AGIは上位1%の労働者と同じくらい生産的でありうる、(2) AGIは眠る必要がなく、一日中ずっと最大の生産性で働ける、といった事実を踏まえて、この推定値を1〜2桁引き上げたくなるとしても、現在の資源で展開できるAGIの労働力は、約30億人と推定される現在の人間の労働力よりもまだ小さい。
さらに、ほとんどすべての技術には、最初に開発されてから何十億もの人々に採用されるまでに時間差がある。技術の採用にかかる時間差は時代とともに大きく縮まってきたものの、最近の技術の証拠を見ると、AIの時間差もおそらく1年を超える。
したがって、2023年時点でAGIのソフトウェアがすぐそこまで来ていると仮定したとしても、計算機ハードウェアの製造を少なくとも1桁拡大しなければならず、AIが完全に採用されるまでには、文明はかなりの期間を要するように見える。典型的な半導体工場の建設にはおよそ3年かかることを考えると、今後4年以内に爆発的成長(GWPの成長率30%超)が起こる可能性は低いと思われる。
ただし、超知能のソフトウェアが目前に迫っているのであれば、ごく近い将来に変革的な成長が起こることはありうると私は考えている。7 しかし、現在のAIシステムは超知能に近いとは言えないので、超知能が目前に迫るには、AIの進歩の速さが突然高まる必要があると思われる。そのような突然の加速の最もありそうな原因は、超知能に至る前のシステムが技術の進歩を加速させることだろう。しかし、すぐ上で論じたように、超知能以前のAIによって技術の進歩全般が急速に加速することは、今後数年のうちにはきわめて考えにくい。
私個人のAI到来時期の見通し
2023年5月時点で、私は、ごく短い(4年未満の)TAIの到来時期は、現在の証拠のもとでは事実上排除される(約1%)と考えている。巨大なAI労働力を急速に展開するのに必要な大規模な変化と、私が強力だと考えるハードテイクオフへの反論を踏まえてのことである。また、汎用ロボット工学でこれまで目覚ましい進歩がないことを踏まえて、短い到来時期の確率をいくらか削りたいとも思う。世界の労働の大半は現在、身体を使う要素を必要としていることを考えると、これは重要な考慮事項に思える。とはいえ、その間に大きな遅れや戦争などの大災害がないと仮定すれば、TAIはおそらく15年以内に到来すると私は考えている。8 この見方は、TAIの学習に必要な量についての私の分布にもとづいている。その分布は、2023年のアルゴリズムで FLOP あたりを中心とし、標準偏差は約3桁(OOM)である。9
条件を付けずに、ありうる遅れ(大きなものになる可能性が高いと私が考える規制を含む)とモデルの不確実性をすべて考慮すると、TAIの到来時期についての私の全体的な中央値はむしろ今から20年後くらいであり、何十年も先まで延びる長い裾がある。
こうした証拠のすべてが指し示していると私が考えることをまとめるため、TAIの到来についての私の信念を表す確率分布を下に描いた。中央値(2045年)と最頻値(2029年)の差がかなり大きいことに注意してほしい。10
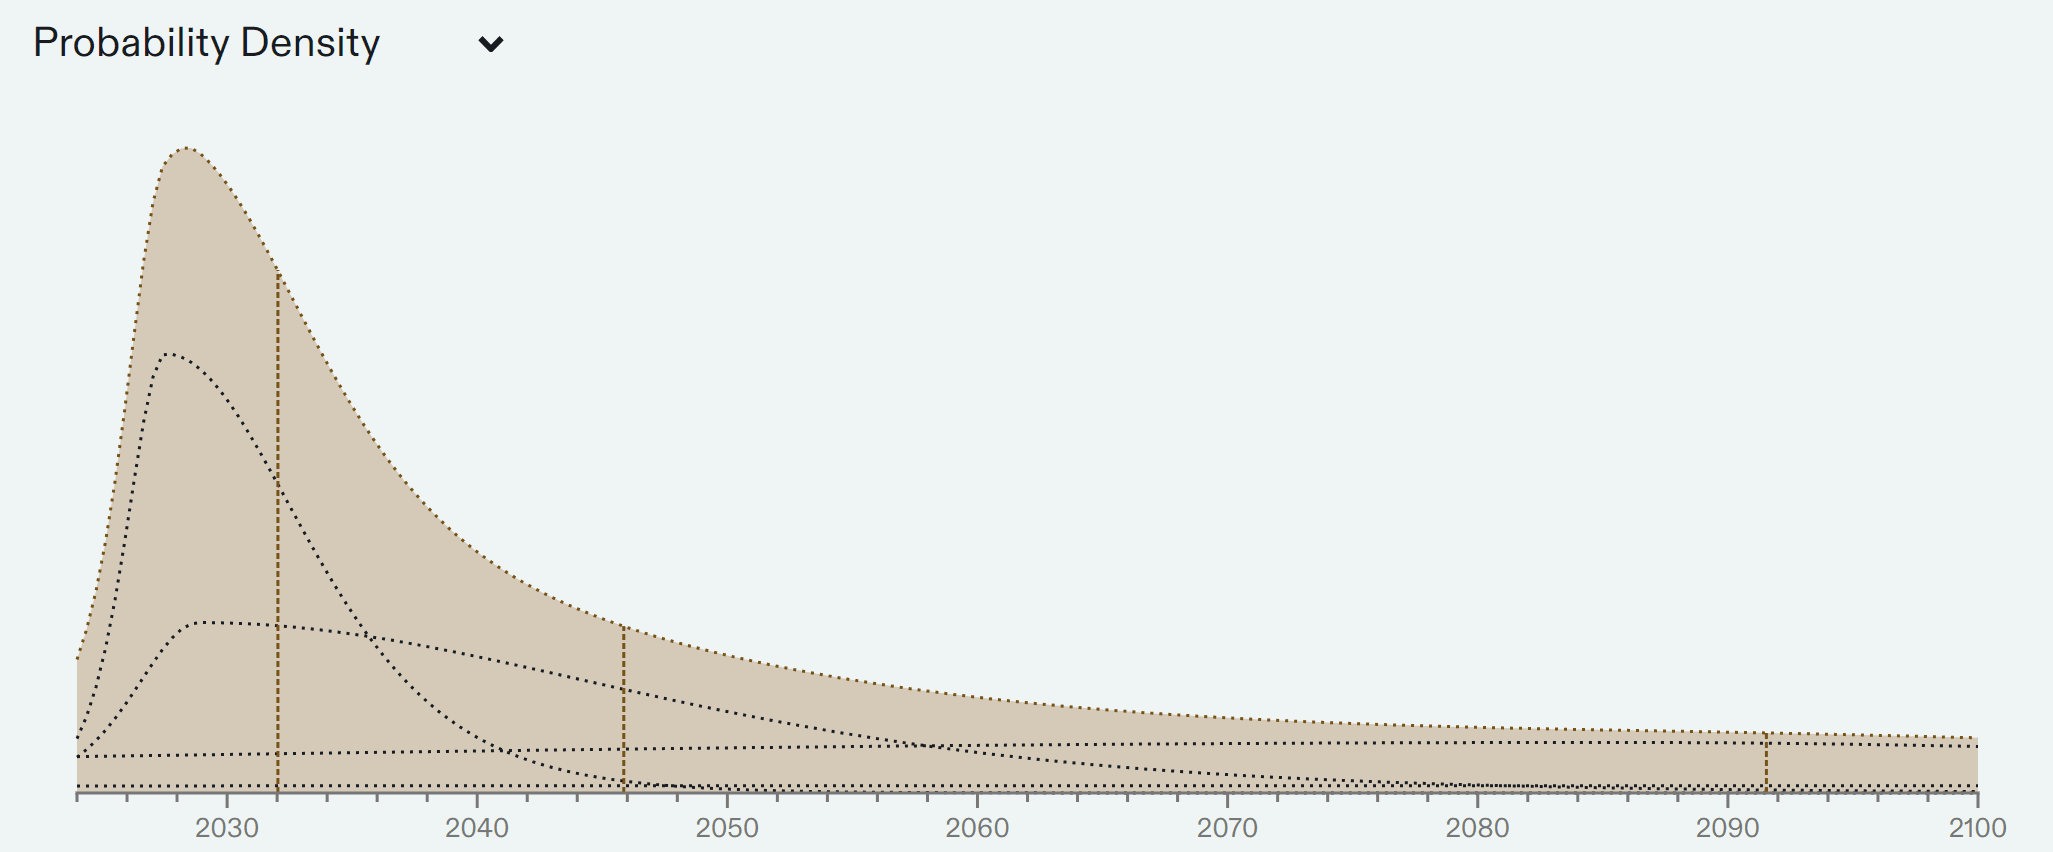
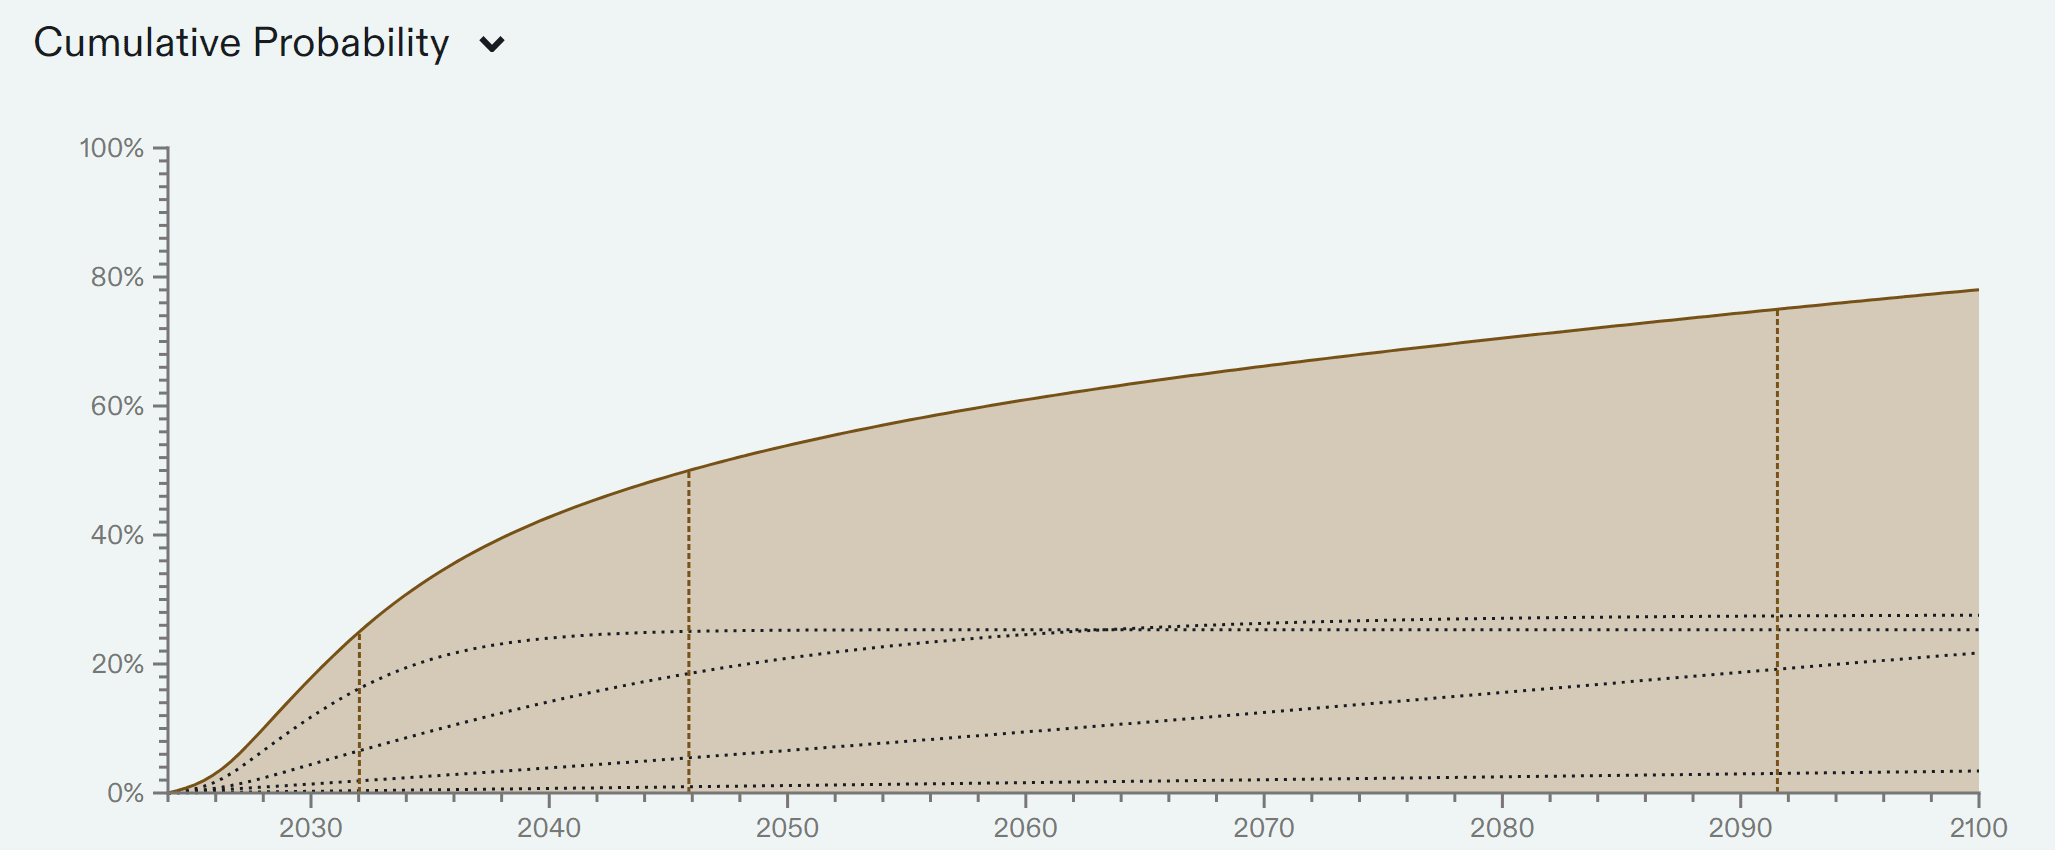
この図からさまざまな年を見て、その年より前にTAIが到来するという私の無条件の確率を読み取ることができる。脚注11を参照してほしい。参考までに、この分布では、TAIが2043年より前に到来する確率は47%である。
結論
これらの議論が成り立つとすれば、変革的AIは今後数十年のうちに開発される可能性が高いと思われる。本稿では主に、AIが経済成長を加速させる可能性について論じてきたが、価値観の不整合(ミスアラインメント)や人間の無力化といった、AIがもたらすほかの帰結も、控えめに言っても、さらに検討する価値がある(Christiano 2014、Ngo et al. 2022)。
本稿の執筆を通じて支援と助言をくれた Tamay Besiroglu、Jaime Sevilla、David Owen、Ben Cottier、Anson Ho、David Atkinson、Eduardo Infante-Roldán、そして Epoch AI チームのほかのメンバーに感謝する。Adam Papineau は原稿の編集を担当した。
注
-
Karnofsky 2016 と Cotra 2020 にならい、TAIを、高度なAIがもたらしうる変革的な帰結(主に経済成長の加速)によって定義する。ただし、AIが極端で広範な帰結をもたらす、ほかのもっともらしいシナリオもカバーできるよう、さらに2つの条件を加える。
TAIの定義:TAIの年を、2022年以降で、次の節目のいずれかが達成される最初の年と定義する。
- 世界総生産(GWP)が、それ以前の年間の最高値の130%を超える
- 世界の一次エネルギー消費量が、それ以前の年間の最高値の130%を超える
- 地球上で生存する生物学的な人間が10億人未満になる
1つ目の条件の意図は、本稿全体で強調している。AIの最も顕著な影響は労働を自動化する能力であり、それが生産性の爆発を引き起こす、というテーゼを述べているからである。 2つ目の節目は、世界がAIによって急速に変革されるものの、その変化がGDP統計に反映されないシナリオをカバーするために含めた。たとえば、GDPが系統的かつ大幅に誤って測定されている場合である。3つ目の節目は、AIが生産性の爆発を引き起こさなかったにもかかわらず、世界にきわめて深刻な悪影響を及ぼすシナリオをカバーする。より具体的には、Eliezer Yudkowsky と Nick Bostrom が検討したハードテイクオフのシナリオを含めたい。この場合、AIがGWPやエネルギー消費を劇的に拡大させなくても、AIが「変革的」でないと主張するのは難しいからである。 ↩ 2
-
生産性爆発仮説についてのより詳しい議論としては、Davidson 2021 または Trammell and Korinek 2020 を読むことを勧める。 ↩
-
この結論はやや控えめなものだった。学習中に見るトークン数が、インターネット上のテキストデータの総ストックを超えた時点でデータを使い果たすと仮定していたからである。しかし、現在の大規模言語モデルが1エポック(学習データセット全体を1周すること)を超えて学習されることはまれだが、モデルを複数エポックにわたって学習させられない強い理由はないように見える。実際、2020年ごろより前の言語モデルでは、それが標準的なやり方だった(Komatsuzaki 2019)。
複数エポックにわたって学習させると性能が大きく劣化したと報告する研究もあるが(Hernandez et al. 2022)、そうならなかった研究チームもある(Taylor et al. 2022)。複数エポックにわたる学習が有害だと信じる強い理論的理由は現時点で見当たらないので、繰り返されたデータで学習することによる性能の劣化は、解決できない問題ではないと私たちは考えている。ただし、複数エポックにわたって学習させても利益はわずかにすぎないのかもしれず、そうであれば、いずれにせよこの点はあまり意味のない論点になる(Xue 2023)。 ↩
-
代理指標の有用性を説明するために、ありうる例を挙げる。多段階の推論課題での正答率は規模の関数として突然向上する一方で、1段階の推論での性能はもっと予測しやすく向上する、ということがあるかもしれない。多段階の推論は、互いに独立した1段階の推論の連なりに分解できると考えるのがもっともらしいので、独立した試行を重ねることの数学的な帰結として、多段階の推論での性能はある規模でいくぶん突然「創発」するように見えるかもしれない、と先験的に予想される。それが正しければ、研究者は1段階の推論での進歩を測り、その情報を使って、確実な多段階の推論がいつ現れるかを予測できる。 ↩
-
中心となる考えは、モデルのスケーリングのデータがあれば、削減可能な損失が規模とともにどう下がるかを推定でき、それをモデルから見た学習分布の KLダイバージェンスと解釈できる、というものである。大まかに言えば、KLダイバージェンスは2つの分布の間の識別情報を教えてくれるので、それを使えば、モデルを真の分布と見分けるのに平均していくつのサンプルが必要かを求められる。 ↩
-
これは、テイクオフ速度モデルで学習 FLOP ギャップのパラメータを1に設定することで実現できる。 ↩
-
Bostrom 2003 にならい、超知能を「科学的創造性、一般的な知恵、社会的スキルを含め、事実上あらゆる分野で最も優れた人間の頭脳をはるかに上回る知性」と定義する。 ↩
-
以下は、協調による遅延がなく、大きな規制がなく、大国間の戦争やその他の大規模な外生的破局がなく、世界的な経済恐慌がなく、現実についての私の基本的な信念がおおむね正しい(たとえば、私がシミュレーションの中に生きていたり、精神病的な破綻を経験していたりしない)という条件のもとでの、私個人のTAIの到来時期の見通しである。
↩ -
変革的な FLOP の必要量を、TAIの年(定義は脚注1)の前年における最大規模の学習の規模と定義する。ただし、大きな規制など、TAIを遅らせる行動がとられないと仮定する。 ↩
-
この分布は、いくつかの批判を踏まえて少し変更したことに注意してほしい。以前の図は、2030年より前にTAIが到来することに、非現実的なほど低い確信度しか置いていなかったと思う。 ↩
-
↩年 P(TAI < 年) 2030 18% 2035 34% 2040 43% 2043 47% 2045 50% 2050 54% 2060 61% 2070 66% 2080 71% 2090 74% 2100 78%