
ニュースレター
OpenAIが誤ってHugging Faceをハッキングした――予見できたはずではないか?
原題:OpenAI accidentally hacked Hugging Face — should we have seen it coming?
Gradient Updates は著者個人の見解を述べるニュースレターで、Epoch AI 全体の見解とは限りません。
OpenAIは昨日、次のように報告した。GPT-5.6 Solと、それより能力の高い未公開の社内モデルの組み合わせが、サイバーセキュリティのベンチマークで不正をしようとする過程で、自律的にHugging Faceをハッキングしたという。
そのためには、OpenAIとHugging Faceのシステムにまたがる、それまで知られていなかった別々のセキュリティ脆弱性を少なくとも3つ使う必要があった。この件で非常に重要な点の一つは、モデルがベンチマークで不正をするためだけに、こうした行為(人間がやれば重大な犯罪だっただろう)を選んだことである。ただし、これらのモデルにそれを実行する能力があったこと自体は驚くに当たらない、と私は考える。
より具体的に言えば、この件の細部まで予測するのは難しかっただろうが、これまでの専門家の評価やサイバー能力の測定結果から、フロンティアモデル(安全装置を無効にした状態)ならこの種のサイバー攻撃を成功させられると予想できていた。
とりわけ、独立した複数のベンチマーク(ExploitGym、ExploitBench、英国AISIのCyber Ranges、IrregularのCyScenarioBenchとFrontierCyber)の結果から、現在のフロンティアモデルが、実世界のコードからセキュリティ脆弱性を見つけ出すことも、その脆弱性を使って現実的なシステムに侵入するエクスプロイト(攻撃コード)を開発することもできると分かっている。
ExploitBenchは、悪意あるWebサイトが訪問者のWebブラウザを乗っ取るのに使えるエクスプロイトの作成を扱うベンチマークである。作成者らによれば、ある事例ではMythosが、ブラウザを乗っ取れるだけでなく、それまでの人間による最良の試みよりも確実に動作するエクスプロイトを作り上げた。
英国AI Security Instituteは、企業ネットワークを現実的に模したシミュレーションを乗っ取る能力についてモデルを直接評価し、Mythos 5とGPT-5.6 Solのどちらもネットワークを一貫して完全に掌握できることを明らかにした。同研究所の見積もりでは、これらの攻撃は人間のサイバーセキュリティ専門家なら数営業日かかるものだという。同研究所は最近、ある事例も紹介している。誤って解決不可能なサイバーセキュリティの課題を割り当てられたモデルが、評価用のインフラに直接アクセスしようとし、セキュリティ警報を作動させたというものである。
Irregularが、難度の高いFrontierCyberベンチマークでGPT-5.6 Solのサイバー能力を評価したところ、次のことが分かった。
FrontierCyberベンチマークの課題を解こうとする中で、GPT-5.6 Solは、広く使われているソフトウェアやモバイル端末を含む実世界の標的に、新たなゼロデイ脆弱性を複数発見した。これらの発見の中には、セキュリティに重大な影響を及ぼしうるものもあった。
これらの事例の多くでは、Hugging Faceの件で見られたのとまったく同じように、複数の異なるエクスプロイトを複雑に連鎖させ、段階的に高いアクセス権限を得ている。
これを捉える一つの方法が、私たちが構築したサイバーECIである。これは、ソフトウェアのエクスプロイトを開発して現実的なシステムに侵入するモデルの能力を追跡するための指標だ。その結果、Mythosと5.6 Solは、それまでの傾向と比べてサイバー能力が非常に大きく跳躍していることが分かった。
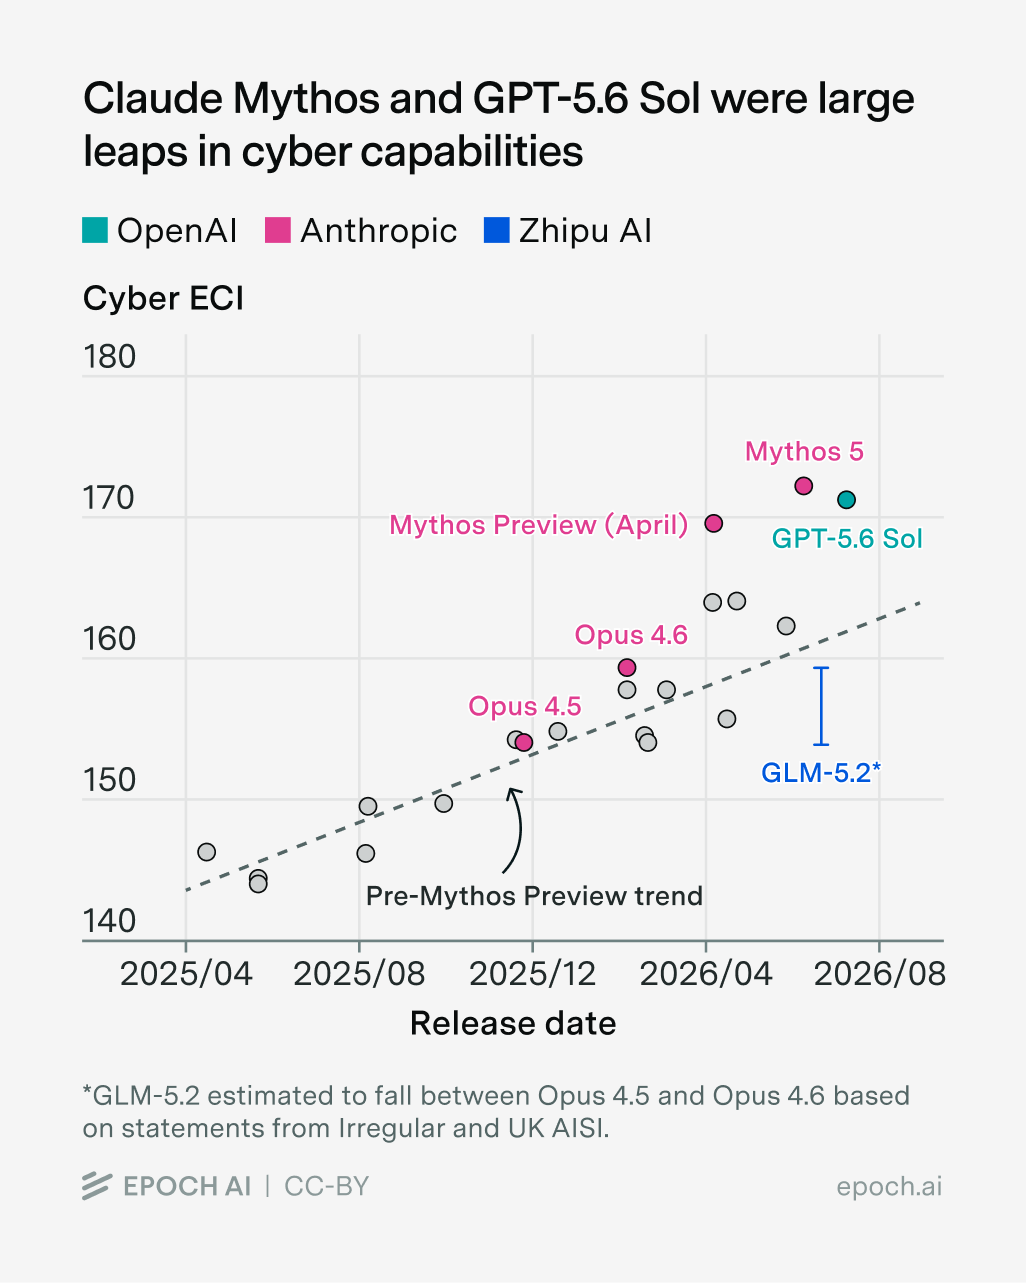
現時点では、この水準の能力へのアクセスは、OpenAIとAnthropicのサイバー向けアクセスプログラム(および一般提供モデルに課された制限)によって管理されている。オープンウェイトモデルはまだ、これに相当する水準のサイバー能力を持っていないからである。具体的には、英国AISIとIrregular(サイバー評価を専門とする組織)は、GLM 5.2のサイバー能力をOpus 4.5とOpus 4.6の間と見積もっている。これらは4〜7か月前に公開されたモデルである(Kimi K3についてはまだ十分な結果がないが、おそらくもう少し能力が高い)。ただし、MythosとGPT-5.6 Solは傾向からの断絶のように見えるため、オープンウェイトモデルがその水準の能力に達するまでにどれだけかかるかについて、これが何を意味するのかは分かりにくい。
おそらくこうしたアクセス制限のおかげで、これまでのところ、こうした最も高い能力を持つモデルがもたらした影響は、サイバーセキュリティにとって全体として主にプラスだったと私は見ている。それは、深刻度が「高」および「緊急」の共通脆弱性識別子(CVE)の公表・修正件数が大きく増えていることに表れている(私たちのCVE Explorerを参照)。
しかし今回の件が示すように、これらのモデルが主にサイバー防御に使われているからといって、深刻な攻撃的サイバー用途に使われうる潜在力がないわけではない。もしこの水準の能力(あるいはモデルの進歩が続くにつれ、さらに高い能力)が広く利用できるようになったり、今回のようにAIが独自に攻撃的な行動を取ったりすれば、Hugging Faceの件と同等かそれ以上に高度な実世界のサイバー攻撃が、はるかに多く見られるようになると予想すべきである。