
ニュースレター
Mythosのサイバー能力は誇張されているのか?
原題:Are Mythos’ cyber capabilities overhyped?
Gradient Updates は著者個人の見解を述べるニュースレターで、Epoch AI 全体の見解とは限りません。
Anthropicの言うことが本当なら、Claude Mythosファミリーは、AIのサイバー能力の大きな飛躍である。Anthropicは、Mythos Previewを発表した際、このモデルはあまりに危険なので、「世界で最も重要なソフトウェアを守る」ための1億ドル超の取り組みを立ち上げなければならないと考えた。そして火曜日には、サイバー関連のベンチマークで小幅に性能を上げたClaude Mythos 5を公開し、自らを上回ってみせた。1
しかし懐疑的な人々は、Anthropicは誇張している、少なくともMythosについてそこまで騒ぐ必要はない、と論じてきた。たとえば、GPT-5.5はさまざまなサイバー関連のベンチマークでMythos Previewと互角なのに、その公開はサイバー上の大惨事にはつながらなかった、と指摘する人もいる。
では、Mythosは本当にサイバー能力の大きな飛躍なのか。それを確かめるため、私たちは手に入る限りの公開された証拠をすべて調べた。証拠の大半はMythos Previewに関するものだが、結論はMythos 5にも当てはまるはずだ。本稿では、私たちがわかったことを説明する。
Epoch AI の最新情報を受け取る 購読する
コードの脆弱性の発見と悪用まず、AnthropicがMythos Previewを公開したときに実際に何を主張したのかを詳しく見てみよう。
「この1年で、[AIモデルは]脆弱性を見つけ出し、それを悪用する方法を編み出す驚くべき能力を示してきた。Claude Mythos Previewは、こうしたサイバー技能における飛躍を示している[…]」
つまり、Anthropicが語っているのは、具体的には二種類のサイバー能力の飛躍である。この二つを混同しないよう注意しなければならない。
一つ目は脆弱性の発見、つまりソフトウェアの弱点を見つけることである。たとえば、コードベースを細かく調べ、バッファオーバーフローのように、コンピューターのメモリを破壊するのに使えるコード行を探すことがこれにあたる。
重要なのは、これが二つ目の能力であるエクスプロイトの開発とは別物だということだ。こちらは、既知の脆弱性を利用して、許可されていない動作をさせることである。先の例でいえば、プログラムをクラッシュさせたり、ハッカーが好きなコードを実行できるようにしたりする形でメモリを狙いどおりに破壊するための、適切な入力を見つけることがこれにあたる。
サイバー攻撃を最後までやり遂げるには、攻撃者はこの両方の能力を必要とする。弱点を見つけたら、それを利用するエクスプロイトを設計しなければならない。Anthropicの主張は、Mythos Previewが両方の能力を大きく向上させたというものだ。では、公開されている証拠は何を示しているのか。
Mythos Previewはエクスプロイトの開発で大きく前進したMythos Preview(ひいてはMythos 5)が能力の大きな飛躍だったかどうかを確かめるには、サイバーセキュリティのベンチマークのスコアを見るのが自然だ。そこで私たちは、主にAIがどれだけうまくエクスプロイトを作れるかを測る、約15のサイバー関連ベンチマークを集めた(細かい点はすべて付録を参照)。そして、分野別のEpoch能力指数(ECI)の手法を修正したものを使ってそれらを集約し、Cyber-ECIを作った。モデルのスコアを時系列でプロットすると、次のようになる。
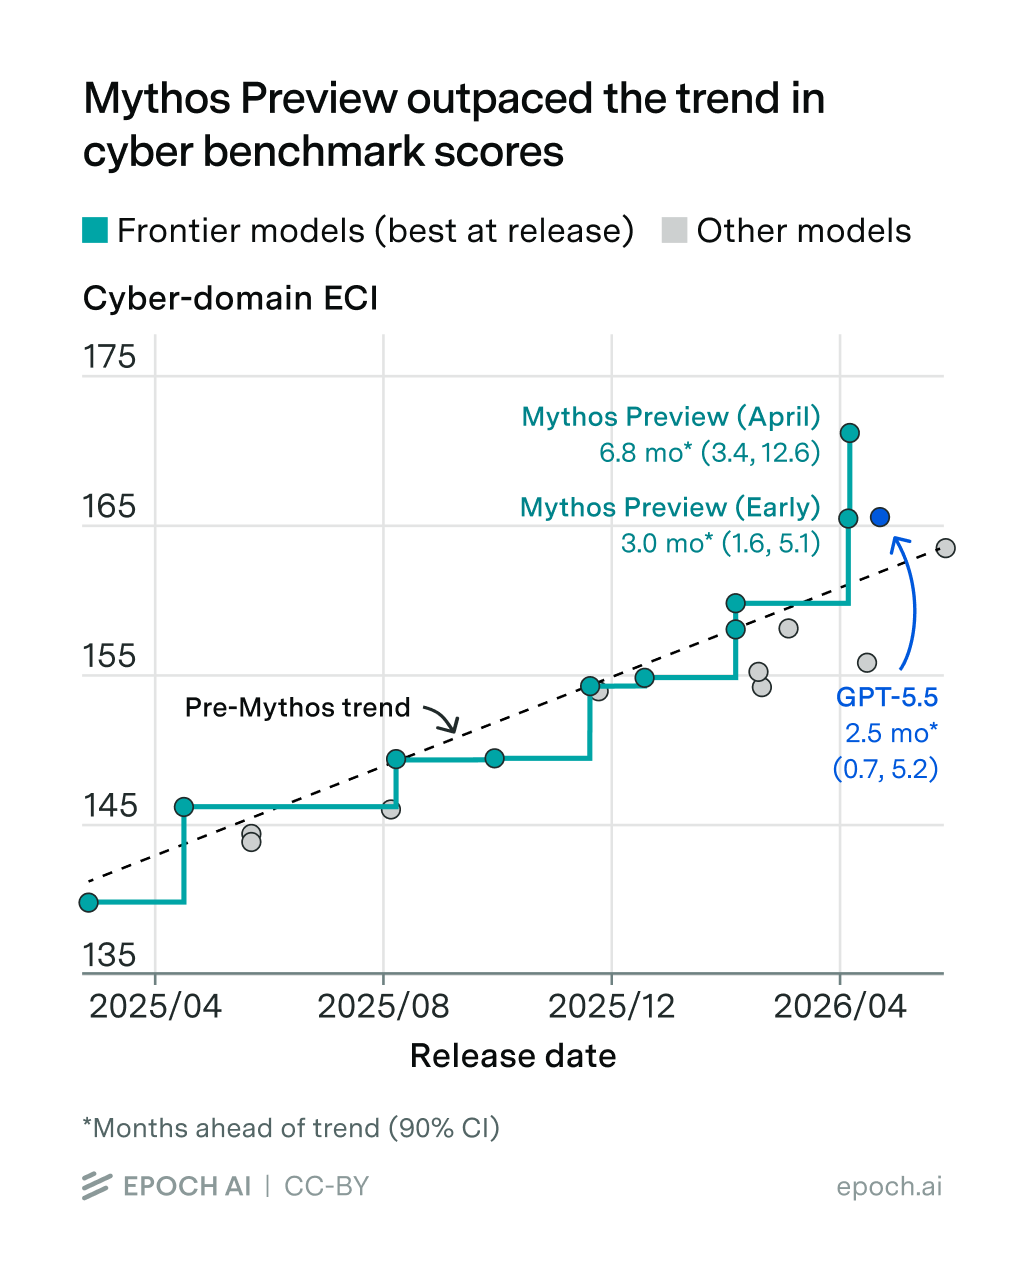
目を引くのは、Mythos Previewが、2025年初めから見られる線形の傾向をはるかに上回り、約7か月先行しているように見えることだ。2これは、予定より「わずか」2〜3か月先行していたOpenAIのGPT-5.5よりも先を行っている。3
だがそうだとすれば、なぜMythos PreviewはGPT-5.5より目立って優れているようには見えない、と論じた人がいたのか。手がかりの一つはグラフにある。紛らわしいことに、Mythos Previewには二つの版がある。内部のチェックポイントから取った「初期」版と、はるかに強力な「4月」版である。4Project Glasswingの参加者に公開されたのは後者で、私たちがより重視するのも後者だ。ただし注目すべきことに、いくつかのベンチマーク評価は初期版で行われており、初期版のサイバー能力は実際にGPT-5.5にきわめて近かった。したがって、そうした人々が間違っていたとは限らない。単にMythos Previewの初期版について語っていただけなのだ。その後、UK AISIが行ったように4月版をベンチマークで評価すると、構図は変わった。
混乱のもう一つの原因は、GPT-5.5とMythos Preview(4月版)の比較に当初使われたベンチマークの多くが、飽和に近かった、つまり取りうる最高スコアに近かったことだ。5そのため、Mythos Preview(4月版)はエクスプロイトの開発でGPT-5.5よりはるかに優れていても、そうした特定のベンチマークのスコアだけでは見分けにくかったのかもしれない。幸い、その後ExploitBenchやExploitGymのような飽和していない新しいサイバー関連のベンチマークが公開されたので、今ではCyber-ECIで能力の大きな差を見て取れる。
いずれにせよ、Cyber-ECIは、Mythos Previewがコードの弱点を悪用するAIの能力の大きな飛躍だったことを明確に示唆している。これはAnthropicの実世界での分析によっても裏づけられている。具体的には、Mythos Previewは、任意コード実行を可能にするエクスプロイトの開発で、以前のモデルよりはるかに優れていることをAnthropicは見出した。以前のモデルはこれをめったにできなかったが、Mythos Previewは、脆弱性についての情報が最小限しかなくても、これを頻繁に達成する。6
Mythos Previewが脆弱性の発見で実際にどれほど前進したかははっきりしない脆弱性の悪用とは違い、ソースコード内の脆弱性を見つけるAIの能力を測る、飽和していないベンチマークは存在しない。7しかし、企業が発見した脆弱性の数の推移を見ることはできる。具体的には、Anthropicの取り組み「Project Glasswing」の一環として、Mythos Previewを使って自社のソフトウェアを守った企業によるものである。結果は、Mythos Previewの公開と時を同じくした巨大な急増である。
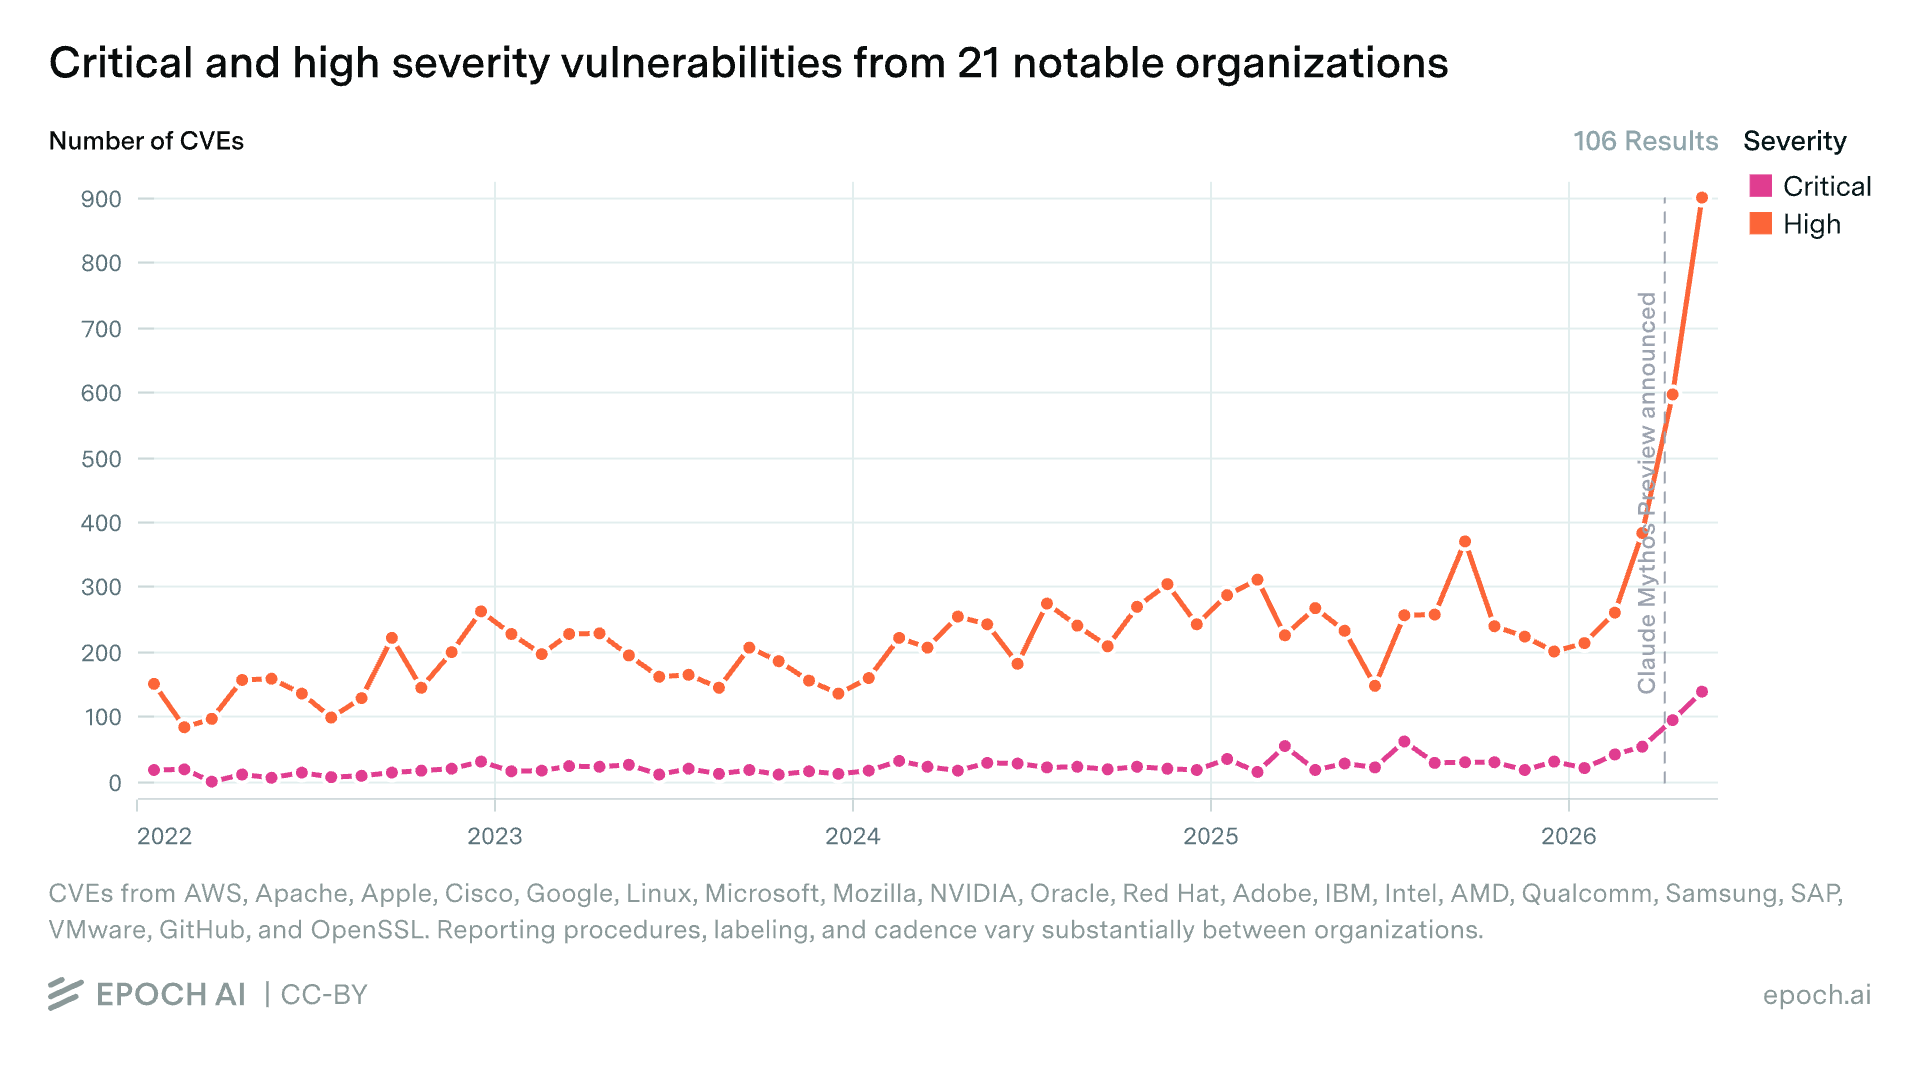
「CVE」は「Common Vulnerabilities and Exposures(共通脆弱性識別子)」の略である。本稿の目的では、単に標準化された方法で追跡されている脆弱性のことを指す。
Cyber-ECIのグラフと同様、これは動かぬ証拠のように見える。注目すべき21の組織による深刻度「高」と「緊急」の脆弱性は、4月に2025年の基準値を142%、5月には262%上回った。さらに、脆弱性は最初に発見されてから公に記録されるまでに時間がかかるので、この数はおそらくまだ増え続ける。
これは、私たちが見てきたより定性的な証拠とも整合しているように見える。たとえば、Mythos Previewは、徹底的にテストされたソフトウェアの中で長年生き残ってきた微妙なバグを見つけた。Project GlasswingでAnthropicと提携した企業の報告を見ることもできる。8たとえば次のようなものだ。
- Mozillaは、Mythos Previewは一流のセキュリティ研究者と同等に優れていると評価したが、まったく新しい種類の脆弱性を掘り起こしたわけではなかった。
- Palo Alto Networksは、Mythos Previewのようなフロンティアモデル(OpenAIのモデルを含む)は「脆弱性の特定にきわめて効果的」だと述べた。同社によれば、フロンティアモデルは3週間足らずで「丸1年分のペネトレーションテストに相当する作業」をこなした。
- CloudflareとPalo Alto Networksはどちらも、Mythos Previewが深刻度の低いバグを連鎖させて深刻度の高いエクスプロイトに仕立てられることに言及した。それが、深刻度の低い脆弱性のうちどれを修正すべきかの優先順位付けに役立ったという。
- AWSは、Mythos Previewは以前のモデルより優れており、最も入念にテストされた環境の一部でもコードを強化する「さらなる機会を特定する」のに役立ったと述べた。
しかし、これらの証拠は、Mythos Previewが脆弱性検出能力の大きな飛躍であることを必ずしも意味しない。以前のモデルでもこれらの脆弱性を見つけられた可能性があり、グラフに見られる急増は、こうしたコードの弱点を見つけるための支出が急増したためかもしれない。なにしろProject Glasswingには最大1億ドルのAPIクレジットが含まれている(そしてOpenAIのDaybreakが投資総額をさらに上乗せしている)。9
実際、Mythos Preview以前のモデルも脆弱性を見つけるのが得意だったことを示す証拠がいくつかある。たとえば、スタートアップのAISLEは、Anthropicが紹介したMythos Previewによる脆弱性のいくつかを、小規模なオープンモデルの一部でさえ認識できると主張している。脆弱性の発見は多くの防御側が並行して探す形をとりやすいので、原理的にはこれは大きな意味を持ちうる。
もう一つの例は、コードライブラリcurlのメンテナーたちによるものだ。curlは世界で最も入念に監査されているコードベースの一つで、伝えられるところでは、Project Glasswing以前から複数のAIコードスキャナーを使っていた。したがって、これはおそらく、Mythos Previewにとって私たちの知る限り最も難しい脆弱性検出タスクの一つであり、案の定、このケースではモデルの貢献はずっと控えめなものだったようだ。見つかったのは深刻度の低い脆弱性1件だけで、ほかに誤検知が4件あった。この発見について、curlの主任メンテナーは次のように述べている。
「この構成が、Mythos以前に他のツールが見つけてきたものと比べて、特に高い、あるいは高度な水準で問題を見つけているという証拠は見当たらない。」
この発言からは、Mythos Preview以前にも、AIがすでに脆弱性を見つけるのが非常に得意だったことがうかがえる。Mythos Previewが見つけられたはずの脆弱性は、すべて以前のAIに見つけられてしまっていたようなのだ。
とはいえ、curlのメンテナーたちは誤検知が少なかったことも強調しており、Cloudflareも同様の感想を述べている。これは一つには、Mythos Previewがエクスプロイトの作成に非常に優れていることに由来するようだ。エクスプロイトを作れれば、検出した脆弱性が単に弱点のように見えるだけでなく本物であることを確かめやすくなる。
以上をまとめると、証拠が示しているのは、Mythos Previewは脆弱性の発見に非常に優れている(ひょっとすると一流のセキュリティ研究者に匹敵する)が、以前のAIもすでにこれが非常に得意だったということだと私たちは考える。とはいえ、Mythos Previewはいくつかの点で以前のモデルをしのいでいる。脆弱性の深刻度の評価に優れ、誤検知も少ない。AIが発見した脆弱性を評価するのに必要な人間の時間と労力がはるかに少なくて済むので、これだけでも実務上の影響は十分に大きいかもしれない。
結論というわけで、公開されている証拠についての私たちの現時点での見方はこうだ。Mythos Previewはエクスプロイトの開発で明らかに大きく向上しており、GPT-5.5よりはるかに優れ、過去の傾向より7か月先行していた。そしてMythos 5はそれよりさらに小幅に優れている。しかし、Project Glasswingにはおそらく支出の大幅な急増が伴っていたため、予算が一定の場合にMythos Previewが脆弱性の発見でどれだけ優れているかは、あまりはっきりしない。脆弱性の発見でのMythos Previewの優位は、むしろ誤検知率の低さと、発見した脆弱性の優先順位付けの的確さに集中している可能性が高い。Mythos 5についてもおそらく同じことが言えるが、実世界での利用報告が何を語るかは、もう少し待って見る必要がある。
最後に、最初の議論に立ち返ろう。Mythosがサイバー能力の全般にわたる大きな飛躍だったとは断言できないが、Mythosファミリーのサイバー能力は単なる「誇大宣伝」ではない。こうした能力が広く利用できるようになれば、おそらくサイバーセキュリティは新たな局面に入り、成功するサイバー攻撃の大幅な増加を防ぐために、脆弱性をはるかに速く修正しなければならなくなるだろう。
本稿へのフィードバックと支援をくれた Lynette Bye、Elliot Stewart、Stefania Guerra に感謝する。
付録:Cyber-ECIに含まれるベンチマークUK AISIのCTFスイート
説明:AISIは、AIモデルが標的システムの弱点を特定・悪用して隠された「フラグ」を取得しなければならない、旗取り(CTF)形式の課題のスイートを持っている。これは「Technical non-expert(技術的な非専門家)」「Apprentice(見習い)」「Practitioner(実務者)」「Expert(専門家)」の4段階の難易度に分かれている。それぞれを別個のベンチマークとして含め、平均のpass@1成功率でスコアを付けた。
入手に関する注記:値は、UK AISIが公開したグラフから読み取った。「Apprentice」と「Technical non-expert」の結果は、こちらの「Beginner CTF Challenge」のグラフから、「Practitioner」と「Expert」の結果は、こちらの「Advanced CTF Challenge」のグラフから取った。
UK AISIのサイバーレンジ
説明:AISIは自らのサイバーレンジを次のように説明している。「複数のホスト、サービス、脆弱性が、順を追った攻撃の連鎖として配置された、模擬ネットワーク環境。AIエージェントは目標を与えられてネットワーク上に置かれ、攻撃経路の全体を自律的に見つけて実行しなければならない。」サイバーレンジは「The Last Ones」と「Cooling Tower」の二つがある。スコアは、エージェントが平均して(pass@1で)何「ステップ」をこなせたかを、完全な成功(たとえばネットワーク全体の掌握)に対応する最大値と比べて付けられる。私たちはこれを%のスコアに換算した。
入手に関する注記:Opus 4.6までのモデルの値は、AISIのサイバーレンジに関する論文から取った。それ以降のモデルの「The Last Ones」での値は、UK AISIが公開したこちらのグラフから読み取った。なお、1億トークンを使った実行の結果だけを含めている。例外はGPT-4oで、1,000万トークンの上限で実行されたが、その性能は上限よりはるか手前で明らかに頭打ちになっていたためである。
AISIは、Mythos Preview(4月版)が「Cooling Tower」を10回中3回の試行で完全にクリアした(他のモデルはすべて10回中0回)と報告しているが、平均の性能は示していないため、この情報を組み込むことはできなかった。
Microsoft CTI-REALM
説明:これは、サイバー防御を明示的に対象とした唯一のベンチマークである。サイバー脅威インテリジェンスの報告を与えられたモデルに、エンドポイントやクラウドのテレメトリーログに適用する検出ルールを生成させる。スコアは、モデルの判定ルールがどれだけうまく機能するかに基づく、[0,1]の範囲の平均「報酬(Reward)」として与えられる。
入手に関する注記:Mythos Preview(初期版)以外のすべてのモデルの値は、論文から取った。Mythos Preview(初期版)の結果は、こちらのグラフから取った。
CVE-Bench
説明:CVE-Benchは、悪用可能な既知の脆弱性を持つ40のWebアプリケーション環境を集めたもので、モデルはエクスプロイトを作って、8つの能力(ファイルへのアクセス、権限昇格など)のいずれかを達成しなければならない。成功すれば1点、失敗すれば0点である。
OpenAIは、このベンチマークを34の環境からなるサブセットとして実行している。モデルに脆弱性の説明もソースコードも与えない「0-day」の構成を使い、平均のpass@1の結果を報告している。
入手に関する注記:結果はOpenAIのシステムカードから取った。「browsing」の構成だけを使っている。あるモデルについて複数のシステムカードで異なるスコアが報告されている場合は、最新のものを採った。結果はすべて次の資料から得られる。
- GPT 5-codexとGPT 5.1-codex-maxについてはGPT 5.1-codex-maxのシステムカード
- GPT 5.2-codexについてはGPT 5.4のシステムカード
- GPT 5.3-codex、GPT 5.4、GPT 5.5についてはGPT 5.5のシステムカード
Cybench
説明:Cybenchは、4つの異なるCTF大会から集めた、プロレベルの旗取り(CTF)タスク40問からなるベンチマークである。タスクは、(2024年時点で)新しく、意味があり、幅広い難易度にまたがるように選ばれている。スコアは平均のpass@1成功率である。
入手に関する注記:値は、公開リーダーボードの「Unguided % Solved」から取った。
CyberGym
説明:CyberGymは、過去の脆弱性1507件からなるベンチマークで、モデルは脆弱性の説明を与えられ、クラッシュを引き起こすコードを生成しなければならない。
モデルのスコアは、pass@1でクラッシュを引き起こせた脆弱性の割合(%)である。
成功と数えるのは、その脆弱性に対処したはずの修正済みのコードではクラッシュが起こらない場合だけである。私たちは、脆弱性の約5%は説明が十分に具体的でないことに気づいたため、上限を100%ではなく95%として結果を換算した。
私たちは、これでは不十分で、このベンチマークは実質的に飽和していると考えている。プロンプトは、与えられた脆弱性だけを使わなければならないことをあまり明確に示しておらず、Anthropicの報告によれば、正しい脆弱性を狙うという制約がなければ、フロンティアモデルは95%以上の確率でクラッシュを引き起こせるからだ。
入手に関する注記:値は公開リーダーボードから取った。加えて、Opus 4.7の結果をそのシステムカードから追加し、Opus 4.6の結果を、そこでの注記に合わせて74%に更新した。GPT 5.5-cyberも、こちらから結果を取って追加した。
CyScenarioBench
説明:Irregularが開発したベンチマークで、サイバーレンジと同様に、モデルはエンドツーエンドのタスクを成功させなければならない。スコアは、完全にやり遂げた実行の割合(pass@1)である。各社の間で数値が比較可能であることは、Irregularに確認した。
入手に関する注記
AnthropicのMythos 5発表記事から:
- Mythos 5: 36.7%
- Mythos Preview: 29.2%
- Opus 4.8: 16.6%
OpenAIのシステムカードから:
- GPT 5.5: 26%
- GPT 5.4: 9%(5.5のシステムカードから)
- GPT 5.2/5.3: 0%
- Muse Spark: 0%
Gemini 3 ProのFrontier Safety Framework報告書から:
- Gemini 3 Pro: 0%(「v2」の第三者によるサイバー関連ベンチマーク)
ExploitBench
説明:ExploitBenchは、JavaScriptエンジンV8の実際の脆弱性41件からなるベンチマークで、いずれもブラウザのサンドボックス内で任意コード実行(ACE)を可能にすることがわかっているか、強く疑われている。モデルは脆弱性の説明を与えられ、標準的なセキュリティ緩和策を有効にした環境で、それに基づくエクスプロイトを開発するよう指示される。
モデルのスコアは、「はしご」の上で到達した16の能力(任意の読み取りアクセスなど)のうちいくつに達したかで付けられる。ACEに到達すれば16/16となる。
私たちは、すべての環境でのすべての試行にわたって到達した能力の平均割合(%)をpass@1でスコアとした。(環境, モデル)の組ごとに、「後押し(nudging)」を使った場合と使わなかった場合の最大値を採っているので、結果はWebサイトに示されているものとわずかに異なる(入手に関する注記を参照)。
入手に関する注記:Mythos Preview(4月版)以外のすべてのモデルについては、HuggingFaceのこちらにある実行全体の記録から結果を得た。なお、結果は複数のブランチにある「runs.parquet」ファイルのいくつかの版に分散している。
「Mythos Preview(4月版)」の結果はHuggingFaceに含まれていないため、各環境で到達した能力の平均として、Webサイトから直接取った。
この構成を選んだのは、ExploitBenchの各環境を、性能を平均するのではなく、そのまま指数に組み込めるようにするためだったが、結局、今回の分析ではそうしないことにした。
ExploitGym
説明:JavaScriptエンジンV8、Linuxカーネル、ユーザー空間のプログラムにある実際の脆弱性898件からなるベンチマークである。重要なのは、任意コード実行(ACE)を可能にすることがわかっている脆弱性だけに絞り込んでいないことだ。
モデルは各脆弱性の説明を与えられ、標準的なセキュリティ緩和策を無効にした環境で、それを使ってACEを達成するよう指示される。与えられた脆弱性を使って(LLMによる判定で評価)ACEを達成すれば(秘密の文字列にアクセスできたかで評価)1点、そうでなければ0点で、pass@1を使う。報告されるスコアは、すべての脆弱性にわたる平均の性能である。
ベンチマークの作成者は、個人的なやり取りの中で、既定の設定(標準的なセキュリティ緩和策を無効にした状態)では脆弱性の60〜70%がACEを許すと見積もった。そこで私たちは、上限を100%ではなく65%として結果を換算した。上限を50%以上のどの値にしても、私たちの結果はほとんど変わらない。
入手に関する注記:「Success」の合計数は、こちらの表1から直接取った。先に述べたとおり、結果は、悪用できた脆弱性の数を達成可能な脆弱性の数に対する割合(%)として換算しており、後者は0.65*898 = 583.7とした。
InterCode-CTF
説明:このベンチマークは、モデルが標的システムの弱点を特定・悪用して隠された「フラグ」を取得しなければならない、旗取り(CTF)形式の課題のスイートである。
入手に関する注記:サイバーセキュリティのタイムホライズンを調べる研究の一環として、Lyptus Researchが実行したもの。こちらから入手した。
NL2Bash
説明:自然言語の指示を、サイバーセキュリティのタスクでよく使われるbashの呼び出しに変換しなければならない、単純なベンチマークである。
入手に関する注記:サイバーセキュリティのタイムホライズンを調べる研究の一環として、Lyptus Researchが実行したもの。こちらから入手した。
OpenAI CTF
説明:NYU CTF Benchを絞り込んだサブセットである。AIモデルが標的システムの弱点を特定・悪用して隠された「フラグ」を取得しなければならない、旗取り(CTF)形式の課題のスイートである。
OpenAIはほとんどの場合「Professional」(最高難度)の段階しか実行していないので、ここではそれだけを含めている。結果は次のように生成されている。「各CTF課題について16回のロールアウトを実行し、最良のロールアウトの組についてpass@12の指標を記録する」。
結果は二組に分かれている。o3とそれ以前のモデルで実行された「original」の構成と、GPT 5以降のモデルで実行された「refactored」の構成である。
入手に関する注記:結果はOpenAIのシステムカードから取った。「browsing」の構成だけを使っている。あるモデルについて複数のシステムカードで異なるスコアが報告されている場合は、最新のものを採った。
originalの構成の結果はo3のシステムカードから取った。refactoredの構成の結果は次の資料から取った。
- GPT 5-codexとGPT 5.1-codex-maxについてはGPT 5.1-codex-maxのシステムカード
- GPT 5.2-codexについてはGPT 5.4のシステムカード
- GPT 5.3-codex、GPT 5.4、GPT 5.5についてはGPT 5.5のシステムカード
OpenAIのサイバーレンジ
説明:OpenAIは15の内部サイバーレンジのスイートを持っている。「サイバーレンジの演習は、現実的な模擬ネットワークの中で、完全にエンドツーエンドのサイバー作戦を遂行するモデルの能力を測る。これらの演習は長丁場で、モデルには、(1)抽象的な敵対的目標を達成するための計画を立てること、(2)実環境で見られそうな脆弱性、設定ミス、弱点を悪用すること、(3)こうしたエクスプロイトを連鎖させてシナリオの目標を達成すること、が求められる。」OpenAIは、それぞれのレンジについて二値のpass@16の結果を個別に報告している。
入手に関する注記:結果は、各モデルの「combined pass rates(合算の合格率)」を報告しているOpenAIのシステムカードから取った。
- GPT 5.3-codexのシステムカードにGPT 5.1-codex-maxのスコアがある
- GPT 5.5のシステムカードにGPT 5.2-codex、5.3-codex、5.4、5.5のスコアがある
AnthropicのSCONE-Bench
説明:Anthropicは、2020年から2025年の間に悪用されたEthereumのスマートコントラクト405件からなるベンチマークを作成した。モデルは各スマートコントラクトのコードを与えられ、脆弱性を発見して悪用しなければならない。Anthropicは(模擬的に)盗み出した金額(ドル)を主な結果の指標としているが、ここでは悪用できたコントラクトの割合(%、pass@8)だけを使う。
入手に関する注記:ほとんどの結果は、こちらに掲載された「success rates on all exploits」のグラフから読み取った。Mythos Previewの100%という結果は、この記事の「[Mythos Previewは]テストしたすべての脆弱性の悪用に成功した」という記述から得た。
XBOW-Web
説明:XBOWは、Mythos Previewへのアクセスを与えられたサイバーセキュリティ企業である。同社は内部の「Web Exploit」ベンチマークを持っており、6つのフロンティアモデルの結果を報告している。結果は成功オッズ(成功率/失敗率)で報告されているので、私たちはこれを単純な成功率に換算し直した。それ以上の詳細を同社に確認することはできなかった。
入手に関する注記:こちらのグラフから読み取った。
注
-
Anthropicは、Mythos 5のシステムカードでこれを明言している(強調は引用者)。「Mythos 5は、私たちがサイバー関連のタスクで評価した中で最も高い能力を持つモデルでもある。エクスプロイトの開発のような技能を試す評価では、Claude Opus 4.8を大きく上回るスコアを出しているが、Claude Mythos Previewをわずかに上回るにすぎない。」 ↩
-
向上の多くは、ExploitGym、ExploitBench、AISIのサイバーレンジ、AnthropicのSCONE-Benchでの大きな伸びによるものである。さらに、Mythos PreviewはCybenchとCyberGymを実質的に飽和させている。 ↩
-
信頼区間を含めると、Mythos Previewの4月版はおそらく7か月先行しており、90%信頼区間は3〜13か月である。比較すると、GPT-5.5は3か月先行しており、90%信頼区間は1〜5か月である。 ↩
-
「初期」版はMythos Previewの初期のチェックポイントのもので、「4月」版は4月7日にProject Glasswingの参加者に提供されたものである。これらのモデルをそれぞれ「Mythos Preview(初期版)」「Mythos Preview(4月版)」と呼ぶ。また、特に断らない限り、「Mythos Preview」と言うときは常にMythos Preview(4月版)を指す。 ↩
-
ベンチマークは、スコアが100%未満でも、機能的には飽和していることがある。ベンチマークの作り方の問題(問題文の誤りなど)のために、完璧な性能を発揮してもそれ以上のスコアは取れないか、取れても偶然によるものになるからだ。 ↩
-
これらの結果をCyber-ECIに組み込まなかったのは、本稿の公開予定の直前に公表されたためであり、また、このタスクで達成可能な最高性能(ECIを算出するのに必要)がはっきりしないためでもある。 ↩
-
Mythos 5のシステムカードで論じられている、Anthropicの非公開のOSS-Fuzzベンチマークが、存在する中で最も近いものかもしれない。ただし、これは悪用の能力も見ている。モデルは脆弱性を見つけ、それを使ってエクスプロイトを開発しなければならないが、クラッシュを基本の成功とみなしている。クラッシュを引き起こせた割合は、Mythos 5が80%で、Mythos Previewの76.7%、Opus 4.8の61.5%を上回った。 ↩
-
これらはAnthropicと提携し、無料のAPIクレジットを与えられた組織なので、完全に中立なものとして受け取るべきではない。 ↩
-
ただし、Project Glasswingに参加した企業は、必ずしもこれらのAPIクレジットの代金を支払っていたわけではないので、厳密には価格がいくらなのかははっきりしない。 ↩