
ニュースレター
インターネット越しの分散学習はどこまでスケールできるか?
原題:How far can decentralized training over the internet scale?
Gradient Updates は著者個人の見解を述べるニュースレターで、Epoch AI 全体の見解とは限りません。
以前、私はハイパースケーラーの文脈で分散学習を論じた。Microsoft、Googleなどの巨大企業は、相互に接続されたギガワット級のデータセンターを建設しており、これを使えば前例のない計算規模でモデルを学習させられる可能性がある。分散させれば、一つの巨大な学習実行を、より扱いやすいギガワット級の10のブロックに分けることで、1か所で10GWの電力を確保するという難題を回避できるかもしれない。
しかし、分散学習と聞いて人々がまず思い浮かべるのは、同じ企業が所有する巨大なデータセンター群が遠く離れた場所どうしでモデルを学習させる姿ではない。人々が思い描くのはむしろ、何千もの小さなデータセンターや個人の消費者が、余っている計算資源をインターネット越しに持ち寄り、どの単独の主体にも手に負えないほど大きな学習実行を組み上げる姿だ。
このビジョンを追求している企業は多い。Pluralis Research、Prime Intellect、Nous Researchは、すでに大規模なモデルの分散学習に成功している。しかし実際には、インターネット越しの分散学習は、より集中型の学習に大きく後れをとってきた。これらの企業の最大のモデル(Pluralisの8B Protocol Model、Prime IntellectのINTELLECT-1、NousのConsilience 40B)でさえ、学習に使われた計算量は、現在のフロンティアモデル(xAIのGrok 4など)の1,000分の1である。
そして重要なことに、AIを監視・規制するための提案の多くは、インターネット越しの分散学習がフロンティアに大きく後れをとり続けることを前提にしている。計算資源は、少数の巨大なデータセンターであれ、光ファイバーケーブルの専用ネットワークで結ばれた多数の小さめの(とはいえ依然として大きな)データセンターであれ、集中していれば追跡しやすい。フロンティアモデルをそのような形で学習させることが一握りの最大手企業にとってしか経済的に割に合わないかぎり、政府はそれらを比較的容易に規制できる。
しかし、何千台ものコンピュータを使ったインターネット越しの学習は実現不可能だ、という前提が崩れれば、規制は慌てて後を追うことになるかもしれない。
この記事では、インターネット越しの分散学習という分野の現状を概観し、批判的に検討する。私の結論は、分散学習は急速に(年約20倍で)成長しており、フロンティア規模でも技術的には実現可能だが、分散型の開発者がこの10年のうちにフロンティア級の計算資源を集める可能性は低い、というものだ。
Epoch AI の最新情報を受け取る 購読する
インターネット越しの分散学習は実現可能か?
インターネット越しの分散学習は、工学的に見て、集中型の開発より明らかに難しい課題である。
分散学習には、大きな追加の課題が三つある。帯域幅の小さい通信、可用性が一定しない異種混在のデバイスからなるネットワークの管理、そして信頼と協調の問題だ。後の二つも重要ではあるが、最終的に大規模な学習の妨げにはならないと私は考えている。1
より重要な問題は帯域幅の小ささである。消費者の一般的なインターネットのアップロード帯域幅は約60Mbpsだ。この程度の帯域幅しかないノードに単純なデータ並列で学習を分散させると、6,710億パラメータのDeepSeek v3型のモデルを学習させるのに5,000年かかる。2
しかし、Pluralis、Prime Intellect、Nous Researchは、すでに数十億パラメータのモデルを学習(および事後学習)させている。鍵となるのは、必要な帯域幅を減らす一群の手法だ。これらの手法によって、データ並列、モデル並列、RL学習といったさまざまな種類の分散学習ができるようになった。
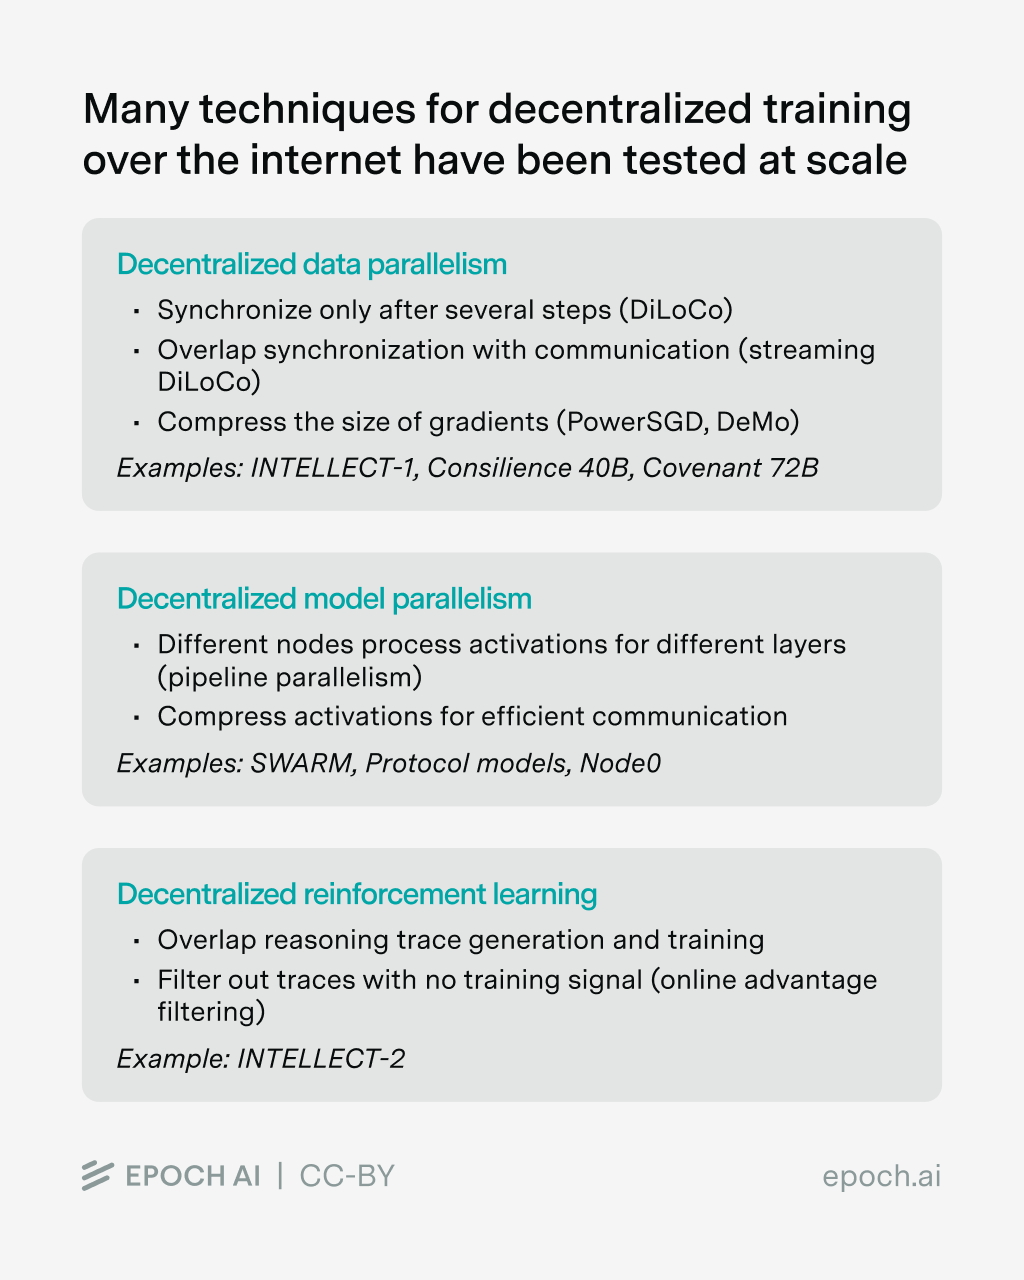
分散データ並列
データ並列で学習を複数のデータセンターに分散させる場合、各データセンターはバッチごとに1回通信して、勾配の更新を同期させる。
インターネット越しに学習させる場合、この通信コストは法外なものになる。たとえば、一般的なアップロード速度が約60Mbpsだとすると、同期時間を10分未満に抑えながら学習させられる最大のモデルは、32ビットの勾配で6億パラメータという、かなり小さなモデルになる。3
解決策の一つは、各データセンターや個々のコンピュータ(各ノード)が互いに通信する頻度を減らすことだ。つまり、バッチごとに重みを同期させる代わりに、各ノードに複数のバッチを独立に処理させ(これを「内側のステップ」と呼ぶ)、各ノードが積み重ねた勾配の更新を同期のステップ(「外側のステップ」)で集約する。
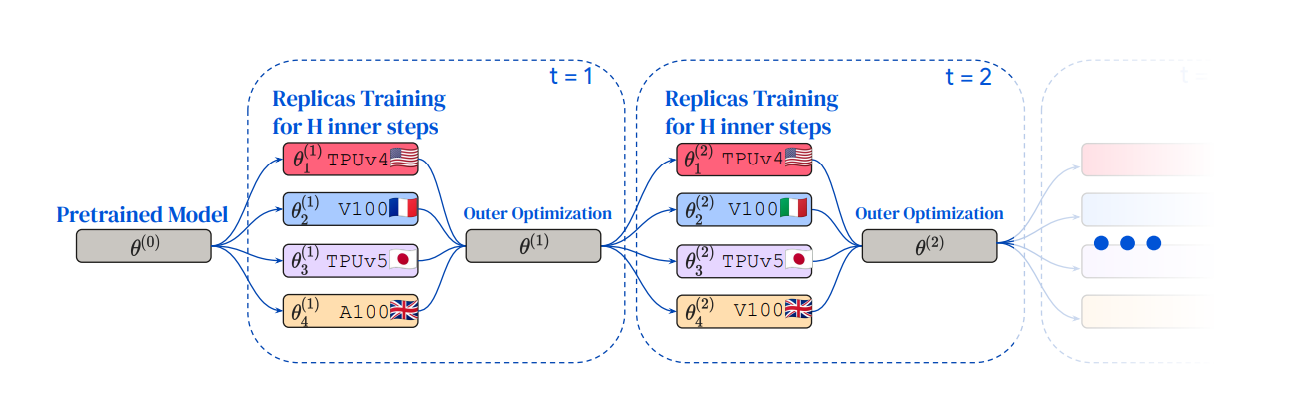
Douillard et al. (2023)の図。各ノードはモデルの複製を保持し、何回かの内側のステップを独立に学習してから、ノード間で同期する。
この手法は、Stich et al. (2018)などの先行研究を土台として、Douillard et al. (2023)のDiLoCo論文で実証された。この手順は通常の学習手順と同等ではないので、性能を損なうことがある。しかしDiLoCoの著者らは、内側のステップを最大500回にしても性能の低下はわずかで、必要な帯域幅を500分の1に減らせることを見出した。
DiLoCoの大きな弱点として強調しておきたいのは、ノード数が増えるにつれて性能が下がることだ。具体的には、ノードを1から8に増やすと、学習計算量を1.5分の1に減らしたのと同等になる(Charles et al, 2025の表4と表11を参照)。単純に当てはめると、1万ノードまでスケールさせれば、同じ性能を得るのに集中型の学習の6倍のFLOPが必要になることになる。これは無視できない差だが、より長く学習させるか、より大きなクラスタで学習させることで補える。
帯域幅への負荷をさらに減らすには、勾配のサイズを小さくすればよい。実際に主に使われている方法は量子化で、勾配をより低いビット精度で通信する。INTELLECT-1の学習実行のように勾配を8ビットに、あるいはStreaming DiLoCo論文のように4ビットに落とせば、一般的な32ビットでの勾配の同期に比べて、必要な帯域幅を2〜4分の1にできる。1ビットの勾配更新を試した研究さえある(Tang et al, 2021; Lu et al, 2022)が、大規模での有効性はまだ示されていない。
別の種類の圧縮にスパース化がある。これは、各回の通信で、勾配のうち最も重要なもの(top-kスパース化)か、ランダムに選んだ一部(ランダムスパース化)だけを送る手法だ。Nous Researchの分離モーメンタム(DeMo)オプティマイザはその変種で、大きな更新を優先し、小さな勾配は重要とみなされる閾値に達するまで蓄積する。
量子化とスパース化はどちらも、通信される勾配の質を下げる。これに対抗するためによく使われる手法が誤差フィードバックの蓄積である。計算された勾配と実際に通信された勾配の差を保存しておき、後の更新で送るのだ。
これらの手法は組み合わせることができる。CocktailSGDは、量子化とスパース化を組み合わせて、最大200億パラメータのモデルをファインチューニングする実験を行っている。MuLoCoは、これらの手法にさらにDiLoCoとMuonオプティマイザを組み合わせている。SparseLoCoも同様の手法をとっており、現在Covenant AIによる分散学習実行Covenant72Bの一部として大規模に適用されている。
DiLoCoはさらに最適化できる。Streaming DiLoCo論文でDouillard et al (2025)は、学習しながら、パラメータの異なる部分集合ごとに同期を順番に行う方法を説明している。これにより計算と通信を重ね合わせることができ、DiLoCoと4ビットの勾配量子化と合わせれば、帯域幅への負荷は単純なデータ並列の100分の1になる。
分散モデル並列
今日の分散学習のほとんどはデータ並列を利用しているが、モデル並列を試しているところもあり、特にPluralis Researchが目立つ。
モデル並列では、モデルのパラメータそのものをノード間で分割する。これには大きな利点が一つある。各ノードがモデル全体を保持する必要がないので、消費者向けGPUのようにメモリの小さいノードでも、モデルのサイズを制約することなくネットワークに参加できるのだ。
たとえば、Ryabinin et al (2023)のSWARM並列の論文は、分散型のパイプライン並列を提案している。各ノードがモデルの層の一部を処理し、ノード間で活性化と勾配を受け渡す方式だ。この論文は二乗・三乗則を指摘している。モデルの次元を大きくすると、通信量は線形にしか増えないが、計算量は二次関数的に増える。つまり、大きなモデルほど通信のオーバーヘッドの影響を受けにくく、帯域幅の小さい環境ではパイプライン並列が現実的な選択肢になる。
PluralisのProtocol Modelsは、各層の活性化を小さな部分空間に制約することでパイプライン並列をさらに最適化し、サイズを最大100分の1にしている。これにより、Llamaに似た80億パラメータのモデルを分散型で学習させたほか、75億パラメータのモデルをボランティアのネットワークで学習させた。
モデル並列のほかの形態も試されている。Prime Intellectは、分散型の合成データ生成プロジェクトであるSYNTHETIC-2でパイプライン並列を使った。Ryabinin and Gusev (2020)のlearning@homeパラダイムや、Zhang et al (2025)のSPESプロトコルは、学習と推論実行のために、混合エキスパート(MoE)の異なるエキスパートを異なるノードに分割する。PluralisはRamasinghe et al (2025)で分散型のコンテキスト並列も試している。これは、異なるノードが系列の異なる部分を処理し、アテンションのコンテキストを計算するために協調する必要がある方式だ。
分散RL学習
昨年以来、推論のための学習とも呼ばれる、RLによる事後学習の手法が存在感を増している。
典型的なRL学習の方式(GRPOなど)では、最新のモデルのチェックポイントで多数の推論過程を生成する。各推論過程は、グループ内の他の推論過程と比べて自動的に採点される。その得点を使ってモデルの重みを更新し、得点の低い推論過程に対して、得点の最も高い推論過程の相対的な対数尤度を高める。
非同期RLでは、推論過程の生成を古いバージョンのモデルで行うことを許す。古いといっても、多くは現在のチェックポイントより2〜5ステップ遅れている程度だ。これには、更新の通信と推論過程の生成を重ね合わせて、通信のボトルネックを和らげられるという利点がある。
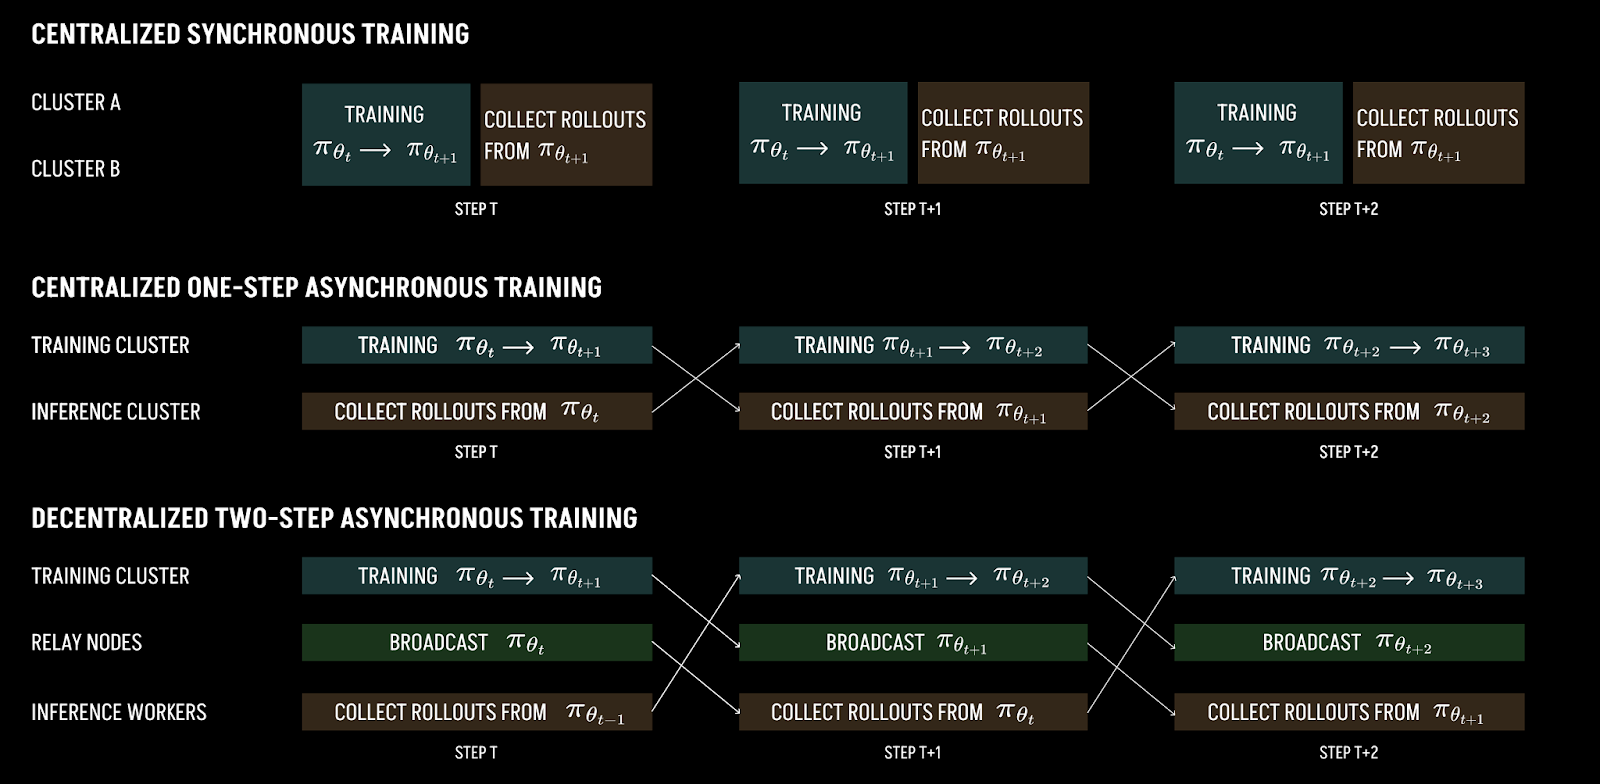
INTELLECT-2の公開記事の図。非同期RL学習を説明している。
これまでで最大の分散RL学習実行は、Prime IntellectによるINTELLECT-2である。800台を超えるノードの出力を協調させて推論過程を生成し、非同期RLを用いてQwQ-32Bのベースモデルを事後学習させた。
同期RLでは、従来の事前学習に比べて、計算の負担が推論実行の側に偏る。FLOPで見た計算量の比率は同じ(活性化を計算する順伝播1回に対して、勾配を計算する逆伝播ではその2倍の計算量がかかる)だが、推論過程の生成はメモリ帯域に律速されるため、逆伝播よりも多くのGPU時間を要する。非同期RLでは、最新のモデルの重みで順伝播をやり直す必要があるので、推論実行の計算量はさらに大きくなる。
INTELLECT-2はオンライン・アドバンテージ・フィルタリングを用いて、負担をさらに推論実行の側へ移している。アドバンテージのない推論過程のグループは学習信号を生まないので、捨ててしまうのだ。これにより、学習ノードの4倍の計算資源を使う分散型の推論実行ネットワークが実現した。
さらに最近、Prime IntellectはINTELLECT-3の学習実行を発表した。これは、より大規模なファインチューニングと非同期RLによる事後学習の実行だったが、集中型の環境で行われた。この学習実行の成功は、将来のより大規模な分散RL学習実行への道を開くものだ。
まとめると:フロンティア規模のインターネット越しの分散学習はおそらく実現可能
私の全体的な印象では、ここまで論じてきた手法をすべて組み合わせれば、現在存在するものよりはるかに大きな分散型モデルを学習させられるだろう。
たとえば、これまでで最大級の分散事前学習実行の一つであるINTELLECT-1のモデルを見てみよう。これは100億パラメータのモデルを1兆トークンで学習させたもので、計算量は6e22 FLOPになる。しかもこの学習実行は、帯域幅に対処するために、基本的な分散学習の手法を実質的に二つしか使っていない。同期1回あたり内側のステップが100回のDiLoCoと、8ビットの量子化である。
SparseLoCoのように4ビットまで量子化し、25%のスパース化を適用すれば、理論上は8倍大きいモデルを学習させられる。Chinchillaのスケーリングに従えば、これで計算量が約64倍の学習実行が可能になる。Templarは現在、同様の戦略で720億パラメータのモデルを分散学習させている。
さらに言えば、INTELLECT-1の学習実行では、参加ノードは約38分間独立に動いてから、7分間かけて同期していた。Streaming DiLoCoを適用すれば、この通信の大部分を隠せるだろう。重ね合わせのスケジュールを最適化すれば、2倍大きいモデル、つまり計算量が4倍のモデルを学習させられる可能性がある。4
先に触れたように、これらの手法の多くは性能をある程度損なう。無視はできないものの、性能の低下は実際には小さいように見える。たとえば、開発者が報告した評価結果に基づくと、INTELLECT-1のEpoch能力指数(ECI)は98前後になる。これはたとえばQwen2.5-Coder 1.5Bと同程度で、このモデルもINTELLECT-1が公開されたのとほぼ同じ時期に、同程度の計算量で学習させられたものだ。
私の結論は、帯域幅を減らす手法を試す余地は十分にあり、インターネット越しでもはるかに大きな学習実行が技術的に可能だ、というものだ。これらの手法は集中型の学習に比べて質をいくらか犠牲にするし、多くはまだ大規模でも、互いに組み合わせた形でも検証されていないので、すべてがうまくいくわけではない。しかし道筋は十分に多いので、帯域幅が近いうちに分散学習の規模を制約することはないと私は楽観している。
分散型の開発者は必要な計算資源を集められるか?
技術的には実現可能だとしても、計算資源のフロンティアに到達するには途方もない量の資源が必要だ。
これまでで最大の分散事前学習実行は、INTELLECT-1、Protocol Model 8B、Consilience 40Bである。これらの計算量は6e22〜6e23 FLOPの範囲にあり、Grok 4のような現在最大のモデルの学習に使われたと私たちが推定する計算量の1,000分の1だ。
これらを学習させるために、Prime Intellectのプラットフォーム、Nous ResearchのPsyche Network、Pluralisのダッシュボードといった分散型ネットワークが構築されてきた。私たちが見つけた中で現在稼働している最大のネットワークはCovenant AIのTemplarで、現在9e17 FLOP/sの実効スループットを達成している。これは現在のフロンティアAIデータセンターの約300分の1の規模だ。フロンティアAIデータセンターは、理論上約3e20実効FLOP/sの学習スループットをもつ(たとえばMicrosoftのFairwaterアトランタ拠点。MFU 30%、8ビット学習を仮定)。
現時点では比較的小さいとはいえ、分散学習実行の規模が驚くほど速く拡大してきたことは理解しておく価値がある。2020年以降、分散学習プロジェクトの計算規模は60万倍に増えており、成長率に換算すると年約20倍になる。
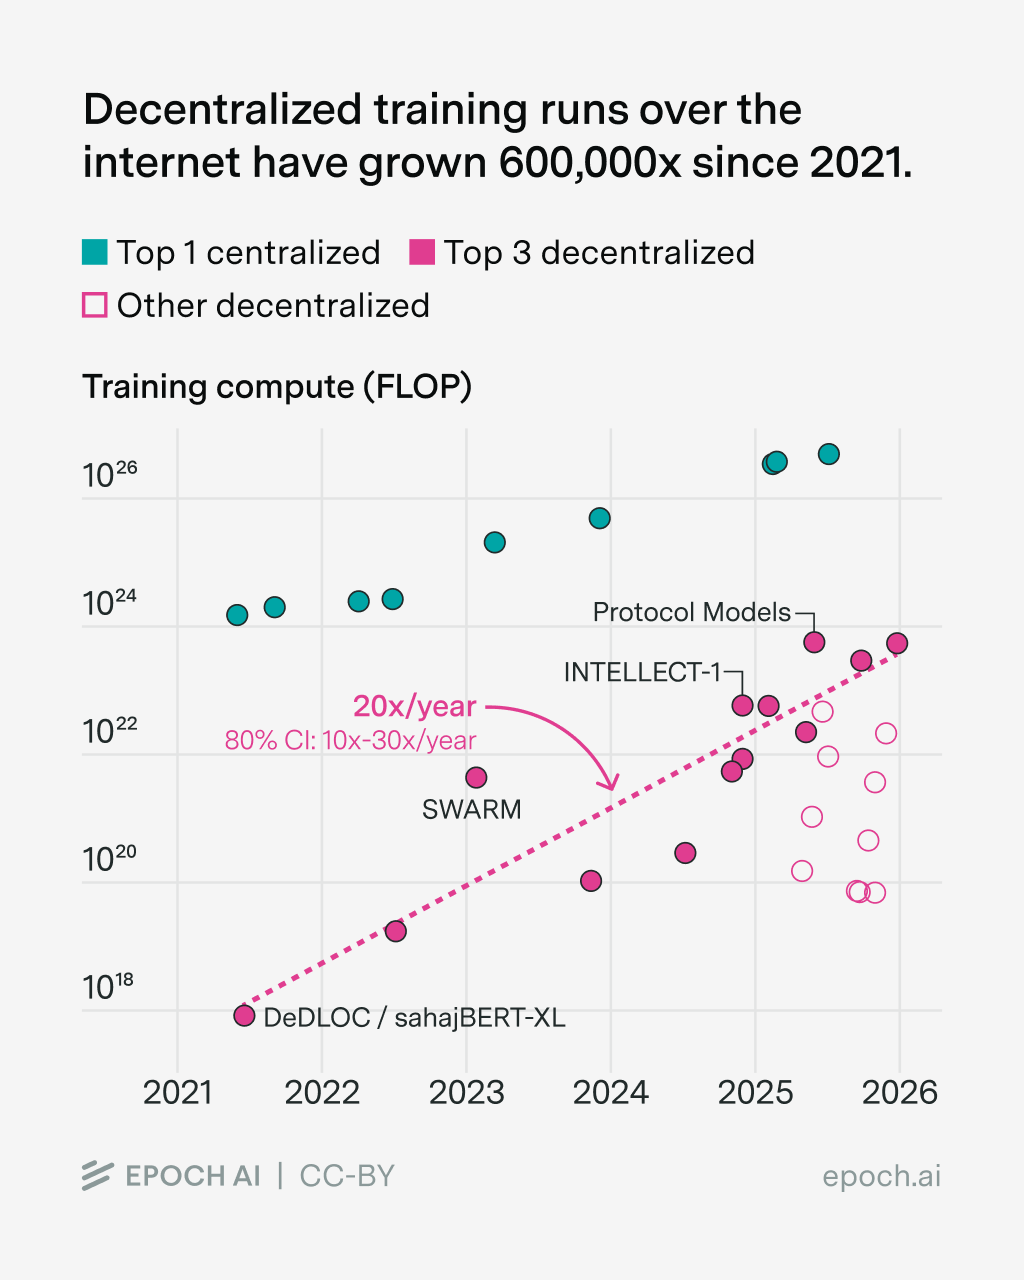
これは、最近年5倍で伸びているフロンティアAIの学習の成長率さえはるかにしのぐ。両方の傾向が続けば、分散学習が集中型の学習の規模に追いつくまでに5年半かかる。
だが、この成長は維持できるのだろうか? 分散学習が到達しうる最大規模を見積もる手がかりとして、三つの参照クラスを調べる。これまでで最大のボランティア・コンピューティングのプロジェクト、最大級の暗号資産ネットワークの規模、そして現在の余剰計算能力の推定量である。
最後のものから始めよう。現在、NVIDIA、TPU、Trainiumのデバイスを合わせて、H100換算(H100e)で約1,570万台のAI計算資源がある。これに対し、AnthropicのNew Carlisle拠点のような現在最大のデータセンターが抱えるのはH100換算で約30万台、つまりAI計算資源の総ストックの2%未満だ。計算資源全体のかなりの部分が長期間遊休状態にあり、インターネットを介した分散学習に使える可能性がある。
したがって理論上は、これまでに達成されたより大きな規模の分散AI学習に活用できるAI計算資源が、膨大に存在する。
しかし、それだけの計算資源を活用するのはおそらく不可能だ。分散学習プロジェクトが利用できるのは、既存の計算資源のごく一部にとどまるだろう。それが正確にどれだけかを見極めるのは難しい。
一つの方法は、最大の分散コンピューティングのプロジェクトと比較することだ。これまでで最大の共同計算プロジェクトはfolding@homeで、創薬に関わるタンパク質の動態をシミュレーションするボランティア・コンピューティングのネットワークである。folding@homeは最盛期に2.43e18 FLOP/sのピークスループットを達成した。これは当時のスーパーコンピュータ上位500台の合計を上回る。2.43e18 FLOP/sあれば、分散型のネットワークで2.43e18 FLOP/s × 100日 ≈ 2e25 FLOPの学習実行を行える。現在のフロンティアに届くほどではないが、Llama 3、GPT-4、Gemini 1.0 Ultra、Claude 3 Opusなど、一つ前の世代のフロンティアAIモデルに匹敵する規模だ。
あるいはBitcoinと比較することもできる。Bitcoinの分散型のハッシュ計算ネットワークは、300億ドル分の既存インフラを擁している。5 AIでいえば、これはギガワット級の拠点一つにほぼ相当し、3e27 FLOPの規模でモデルを学習させられる。これは現在でもフロンティア規模の学習実行に十分である。
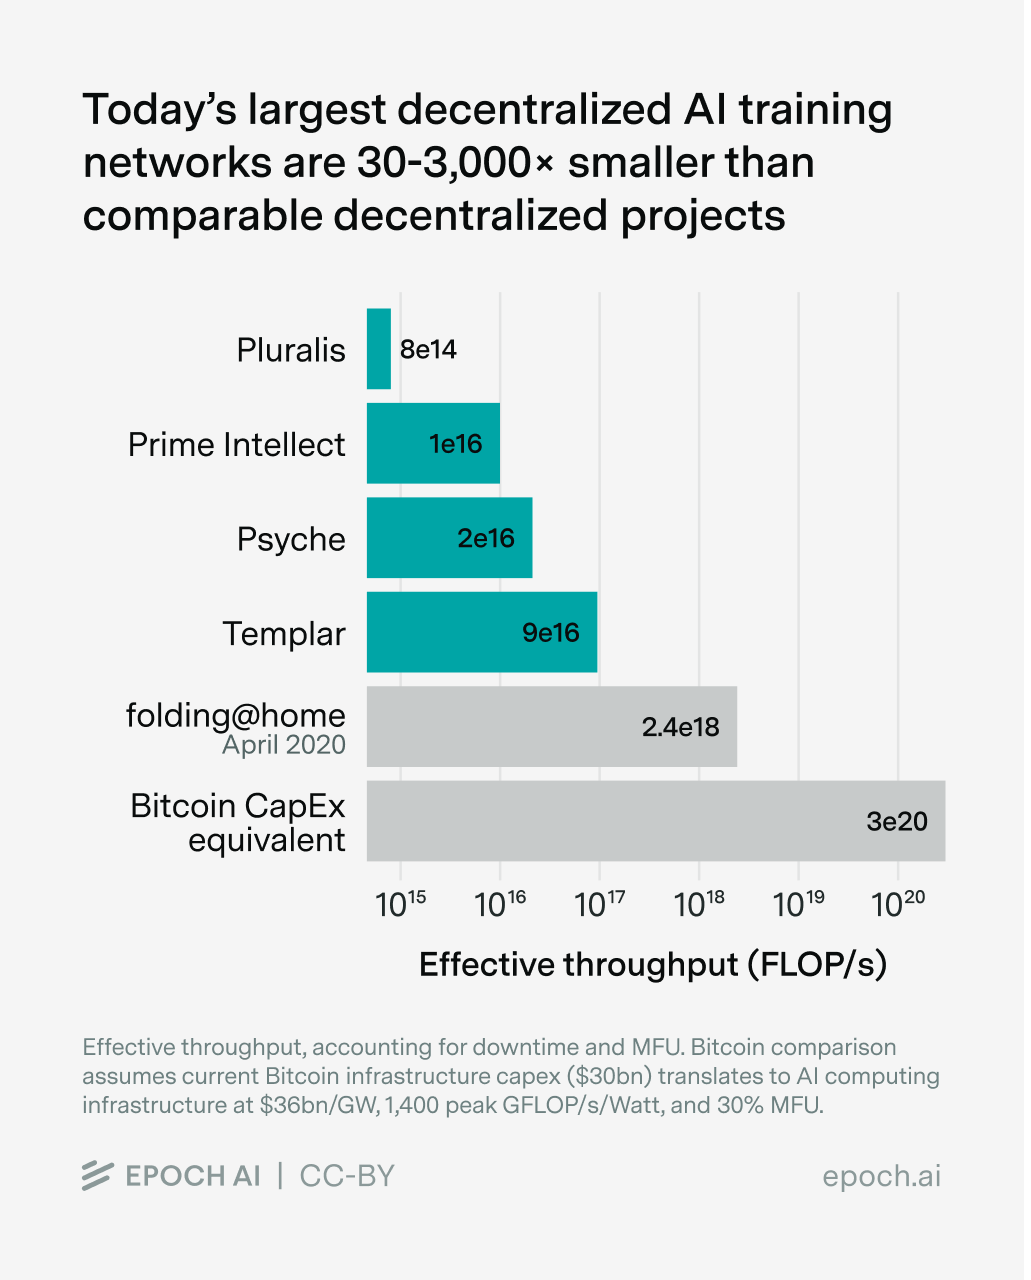
folding@homeとBitcoinという参照クラスから考えると、現在最大の分散学習ネットワーク(Prime Intellectのものなど)は30〜3,000倍に拡大できそうだ。学習期間を長くすることと組み合わせれば、現在の50〜5,000倍の計算量でモデルを学習させるのに十分だ。つまり、分散学習実行の現在の速い成長は3〜6年続きうると考えられる。
結論
インターネット越しの分散学習は、世界中の大量の遊休計算資源を活用できる可能性があることから、多くの開発者の想像力をかき立ててきた。
技術的な実現可能性は重要な懸念事項だ。しかし、帯域幅は重要な技術的課題を突きつけるものの、試されている手法は十分に多いので、はるかに大きなモデルが学習させられる見通しについて私は楽観している。
フロンティア企業は、より効率的なデータセンターを建設する余裕があるので、インターネット越しの分散学習を追求する可能性は低い。したがって、インターネット越しの分散学習は、分散型ネットワークに注力する小規模な企業の領分にとどまる可能性が高い。6
したがって私が不確かだと考えているのは、そうした分散型ネットワークがどれだけの計算資源をかき集められるかである。これまでのところ驚くほど速く成長してきたが、まだフロンティアからは遠い。folding@homeのような過去のボランティア・コンピューティングのプロジェクトや、Bitcoinのような分散型コンピューティングのネットワークの規模を見ると、分散学習ネットワークが今後数年で30〜3,000倍に拡大する余地はあると思う。妨げがなければ、現在の成長率で進んでも、分散学習実行が規模の面で学習のフロンティアに追いつくのはこの10年のうちにはないだろう。仮に追いついたとしても、帯域幅を減らす手法による性能の低下のせいで、集中型の学習には後れをとるだろう。
それでも、分散学習はAIのきわめて重要な一部になりうる。分散型ネットワークがオープンウェイトと結びついたままであるかぎり、フロンティアを追う、より大きなオープンモデルの登場につながるかもしれない。また、小規模な分散学習プロジェクトがフロンティア級の大量の計算資源を集める可能性は低いものの、計算効率の進歩とハードウェアの効率の向上のおかげで、分散学習実行がフロンティアからそれほど大きく後れをとることはないと予想している。
実務上の含意の一つは、分散学習プロジェクトによって、規制の対象にできるモデルの規模に上限が生じることだ。少なくとも、そうした規制の執行が、大規模なデータセンターで学習が行われることを前提にしているかぎりは。
コメントと提案をくれたArthur Douillard、Max Ryabinin、Eugene Belilovsky、Sami Jaghouar、Fares Obeid、Josh You、Aaron Scherに感謝する。グラフのデータはJaeho LeeとVenkat Somalaが収集した。編集はLynette Byeが担当した。
この記事のための調査の一環として、分散学習に関する100本以上の論文を調べた。これらの論文に注釈を付けたデータベースはこちらで見られる。
注
-
異種混在で一定しないネットワークの管理には相当な工学的資源が必要だが、巧みな工学的工夫によって最終的には実現可能である(たとえばSWARMやTaskletsに関する研究を参照)。 ↩
-
DeepSeek v3は、バッチサイズ6,300万で14.8兆トークンを学習しており、更新回数は合計で14.8T / 63M ≈ 23.5万回になる。32ビット精度では、更新1回あたり2 × 6,710億パラメータ × パラメータあたり32ビット / 60 Mbps ≈ 8日かかり、学習全体では23.5万回 × 1回あたり8日 ≈ 5,000年かかる。 ↩
-
60 Mbps × 10分 / 2(アップリンクとダウンリンク) / パラメータあたり32ビット ≈ 6億パラメータ。 ↩
-
適切なストリーミングのスケジュールを使えば、通信時間を計算の裏に完全に隠したまま、38分 / 7分 ≈ 5分の1の帯域幅で同じモデルを学習させられる。単純に考えれば、パラメータが5倍のモデルを学習させられることになる。しかし、より大きなモデルはより大きなクラスタで学習させるので、外側のステップ1回あたりの計算時間は短くなる。通信時間はモデルサイズに比例して増える。計算時間はバッチサイズとモデルサイズに応じて増え、計算能力に応じて減る。バッチサイズはデータセットサイズの0.3乗に比例して増え、データセットサイズはChinchillaのスケーリングのもとではモデルサイズに比例して増える。そして計算能力は、Chinchillaのスケーリングのもとではモデルサイズの2乗に比例して増える。したがって、モデルサイズをn倍にすると、計算時間は倍に減り、同期時間は倍に増える。同期時間は、計算時間を下回っているあいだはほぼ完全に隠せるので、同じ帯域幅のまま、となるところまでモデルを大きくできる。これをについて解くと、倍大きいモデルを学習させられることになる。 ↩
-
SECのEDGARシステムに提出されたIREN (Iris Energy) — “November 2024 Monthly Investor Update”には、「1 EH/s = 導入コスト3,000万ドル」(マイニング用ハードウェアとインフラの設備投資を含む)とあり、その前提(フリート効率15 J/TH、ASIC価格1THあたり18.9ドル、インフラの設備投資1MWあたり75万ドル)が挙げられている。YChartsによればハッシュレートは942.95 EH/sである。この二つの数字を組み合わせると、Bitcoinのインフラは約300億ドルと評価される。 ↩
-
Google DeepMindとMetaは分散学習について重要な研究を発表している。その大きな動機の一つは、分散学習の手法を応用して、古いハードウェアを再利用したり、耐障害性の問題に対処したりできることだ。 ↩