
レポート
学習データセットのサイズの傾向
原題:Trends in training dataset sizes
要点
- 注目すべき機械学習モデルを200以上集め、それぞれの学習データセットのサイズを推定した。
- 視覚と言語のデータセットは、これまでそれぞれ年0.1桁(OOM)と年0.2桁のペースで大きくなってきた。
- 2014〜2015年ごろに何らかの移行があったようで、それ以降、学習データセットははるかに大きくなり、(言語の場合は)小さなデータセットが姿を消した。これは、サンプルサイズが小さいことによる見かけの効果にすぎないかもしれない。
- ゲーム、音声、推薦、描画の傾向も示すが、これらの分野ではサンプルサイズがごく小さいので、ある程度疑ってかかることを勧める。
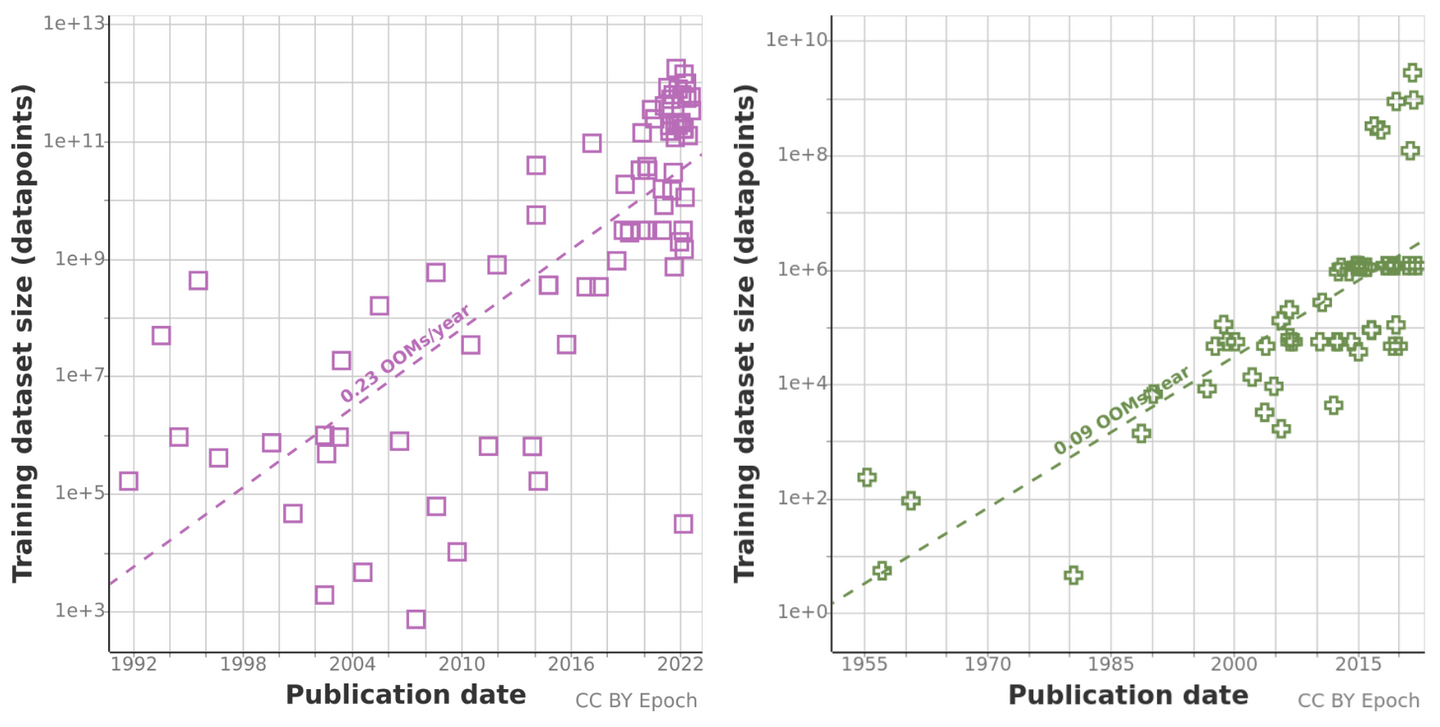
図1:言語(左)と視覚(右)の学習データセット。
| 分野 | 規模(データ点) | 年間の伸び (桁/年) | 年間の伸び (桁/年)(95%信頼区間) | システム数 |
| 言語 | 1e2 - 2e12 | 0.22 | [0.18 ; 0.28] | 79 |
| 視覚 | 2e3 - 3e9 | 0.09 | [0.08 ; 0.11] | 55 |
| 音声 | 9e2 - 3e12 | 0.21 | [0.17 ; 0.30] | 13 |
| ゲーム | 7e5 - 4e11 | 0.09 | [0.08 ; 0.15] | 12 |
| 推薦 | 1e8 - 1e10 | 0.05 | [0.00 ; 0.47] | 11 |
| 描画 | 6e4 - 4e9 | 0.43 | [0.17 ; 0.64] | 10 |
表1:分野ごとの傾向のまとめ。規模は観測されたデータセットのサイズの最大値と最小値、年間の伸びは最もよく当てはまる指数関数の傾き(と95%信頼区間)である。
はじめに
データは機械学習(ML)モデルの主要な材料の一つである。機械学習の進歩を時系列で理解するには、学習データセットの変化を理解する必要がある。
この文書では、独自に作成した機械学習モデルのデータセットを用いて、分野ごとの学習データセットのサイズの歴史的な傾向を明らかにする。方法の節では、学習データセットのサイズを定量化する方法と、データベースへの収録基準を説明する。データセットのサイズの傾向の節では、分野ごとのデータセットのサイズの傾向を示す。
方法
データセットのサイズの測り方
あるデータセットに含まれるデータの量を定量化する標準的な方法はない。以下は、データセットのサイズを定量化する方法として私たちが検討したもので、それぞれに問題がある。
- バイト数(非圧縮):この方法の問題は、動画や高解像度の画像のように、冗長性がきわめて高い種類のデータがあることだ。4K画像はHD画像の10倍の画素をもつが、おそらく10枚の異なるHD画像ほどの情報は含んでいない。
- バイト数(圧縮後):この方法の問題は、圧縮方式に左右されることだ。
- データ点の数:データの種類ごとに、データ点の単位を選ぶ。たとえば言語なら単語1語、視覚なら画像1枚である。この方法には1番目と逆の問題がある。16x16の画像も4K画像も同じ1データ点と数えるが、後者のほうがおそらく多くの情報を含んでいる。
- 情報理論的な尺度:実行は不可能に思える。コルモゴロフ複雑性は計算不可能であり、相互情報量やエントロピーのようなほかの尺度も推定が難しいことが多いからだ(ただし、まずまずの試みとしてこの論文を参照)。
最終的に、3番目の方法をとることにした。モデルの学習データセットのサイズを、学習中に見た固有のデータ点の数と定義する。ここでデータ点とは、分野ごとに定めた具体的な単位である。この決定についての詳細は、私たちの文書「Measuring dataset size in machine learning」にある。
この定義からは、きわめて重要な帰結が生じる。分野ごとに単位が違うので、学習データセットのサイズは分野をまたいで直接比較できない。表2に、各分野とそれに対応するデータ点を示す。
| 分野 | データ点 |
|---|---|
| 視覚 | 画像の枚数(例:30億枚の画像で学習したモデルのデータセットのサイズは30億) |
| 言語 | 単語数(例:1兆の英語トークンで学習したモデルのデータセットのサイズは約7,500億語。正確な量はトークン化の方法による) |
| 音声 | 単語数(例:毎分150語の音声8時間分で学習したモデルのデータセットのサイズは7万2,000語) |
| ゲーム | タイムステップ数(例:平均20タイムステップのエピソード300回分で学習したモデルのデータセットのサイズは6,000) |
表2:各分野でのデータ点の定義
私たちのデータベース
200以上の機械学習モデルとその学習データセットのサイズを集めたデータベースを作成した。機械学習の論文は膨大な数にのぼるので、一連の収録基準で探索の範囲を絞り込む必要があった。収録されるには、モデルが次のいずれかを満たす必要がある。
- 論文の被引用数が1,000を超える。
- 最高水準を更新した。
- 歴史的な重要性に疑いの余地がない。
- 重要な場面で展開された。
各モデルは、解くように設計されたタスクに応じて分野に分類する。表3に、各分野の概要を示す。システムを分類したら、論文からデータセットのサイズをとり、適切な単位に換算する。私たちの単位と論文の単位の間に決まった換算係数がないこともあるので、多くの場合は近似を伴う。
| 分野 | タスクの例 | DB内のモデル数 |
| 言語 | テキストの生成と分類 | 79 |
| 視覚 | 画像の生成と分類 | 55 |
| 音声 | 音声の認識と生成 | 13 |
| ゲーム | Atari、囲碁 | 12 |
| 推薦 | 協調フィルタリング | 11 |
| 描画 | テキストからの画像生成 | 10 |
表3:データセットの分野
データセットのサイズの傾向
視覚
1998年から2016年にかけての視覚のデータセットの変化は、MNIST と ImageNet に大きく左右されてきた。この期間のモデル全体の約3分の1が、これらのデータセットで学習されていた。伸びは年0.11桁(OOM/年)で、最大のデータセットは約100万枚の画像からなる ImageNet だった。しかし2016年ごろから、ごく大きなデータセットがいくつか現れた。その最大のものは、30億枚の画像からなる JFT-3B である。これが今後の伸びのペースを変えるかどうかは、まだ判断するには早すぎるようだ。
1e6枚と1e8枚の間の空白はいささか不可解だが、サンプルサイズが小さいことによる見かけの効果だと考えている。
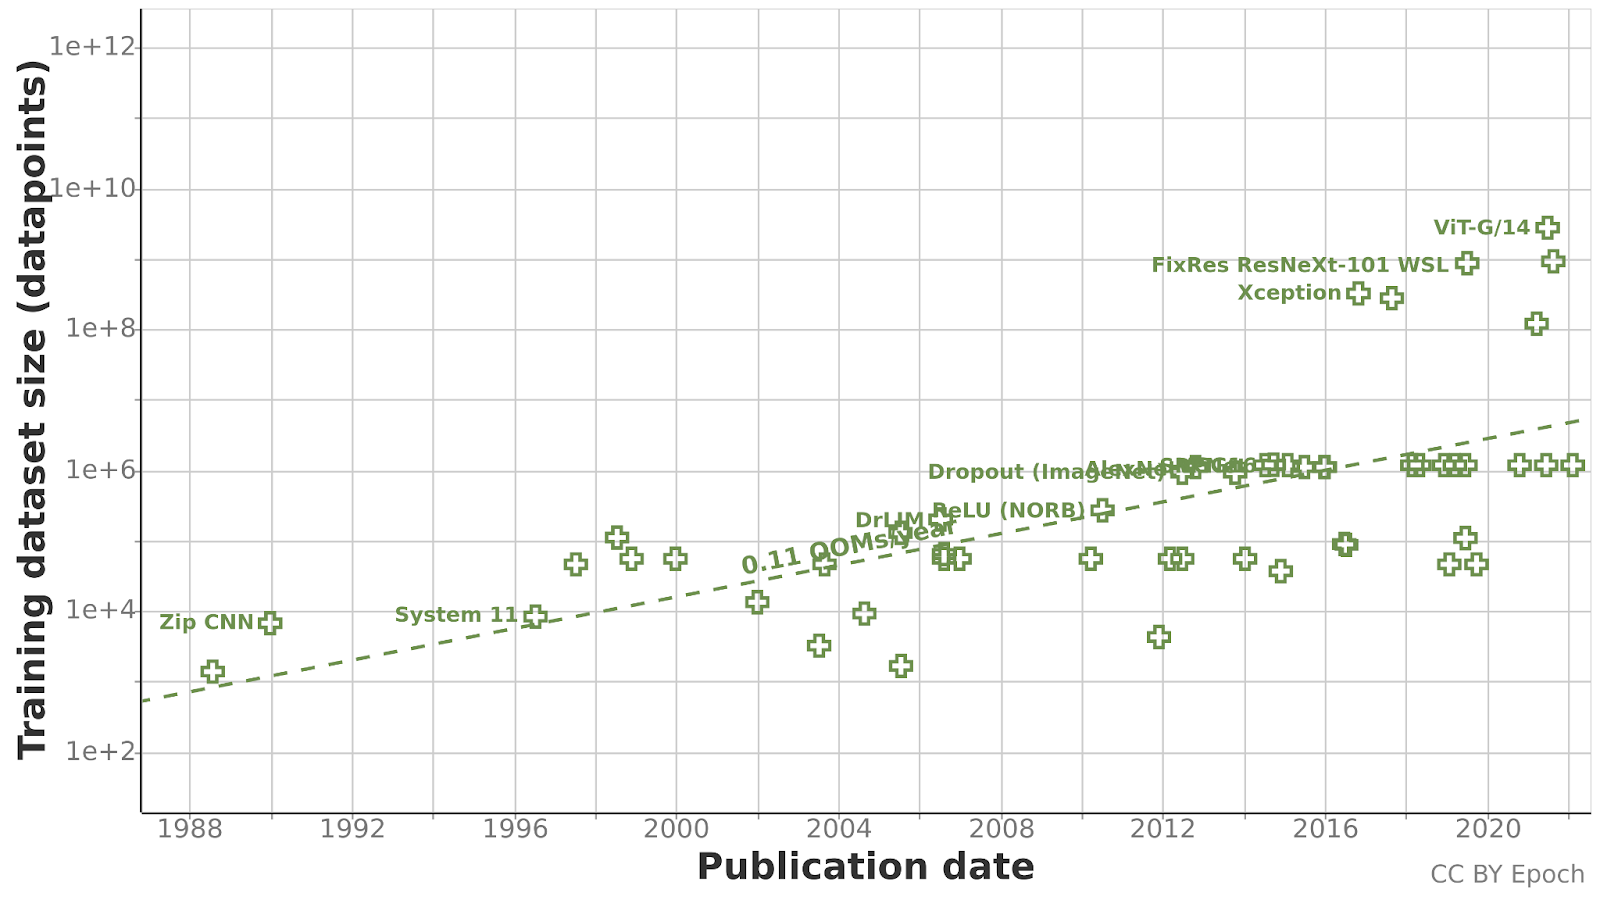
図2:視覚のデータセットの変化。かなりの数のモデルが6e4と1e6の近くに集中している。これらはそれぞれ MNIST と ImageNet のサイズである。
言語
言語モデルの学習データセットは1990年以降、年0.23桁のペースで大きくなっており、1990年から2022年までの伸びは合計7桁に達する。データからは、2014年以降この伸びが速まったことがうかがえるが、サンプルサイズが小さいので確信はもてない。これまでに観測された最大の言語データセットは、1.87e12語の FLAN データセットである。
目を引くのは、2014年までは Deep Belief Networks(2e5語未満で学習)のように、ごくわずかなデータで学習された注目すべきモデルもあったことだ。しかし2016年以降は、注目すべきモデルのほぼすべてが1e8語を超えるデータで学習されている。これは、Transformer のように、はるかに多くのデータで学習できる、より効率的なアーキテクチャが採用されたことを反映しているのかもしれない。
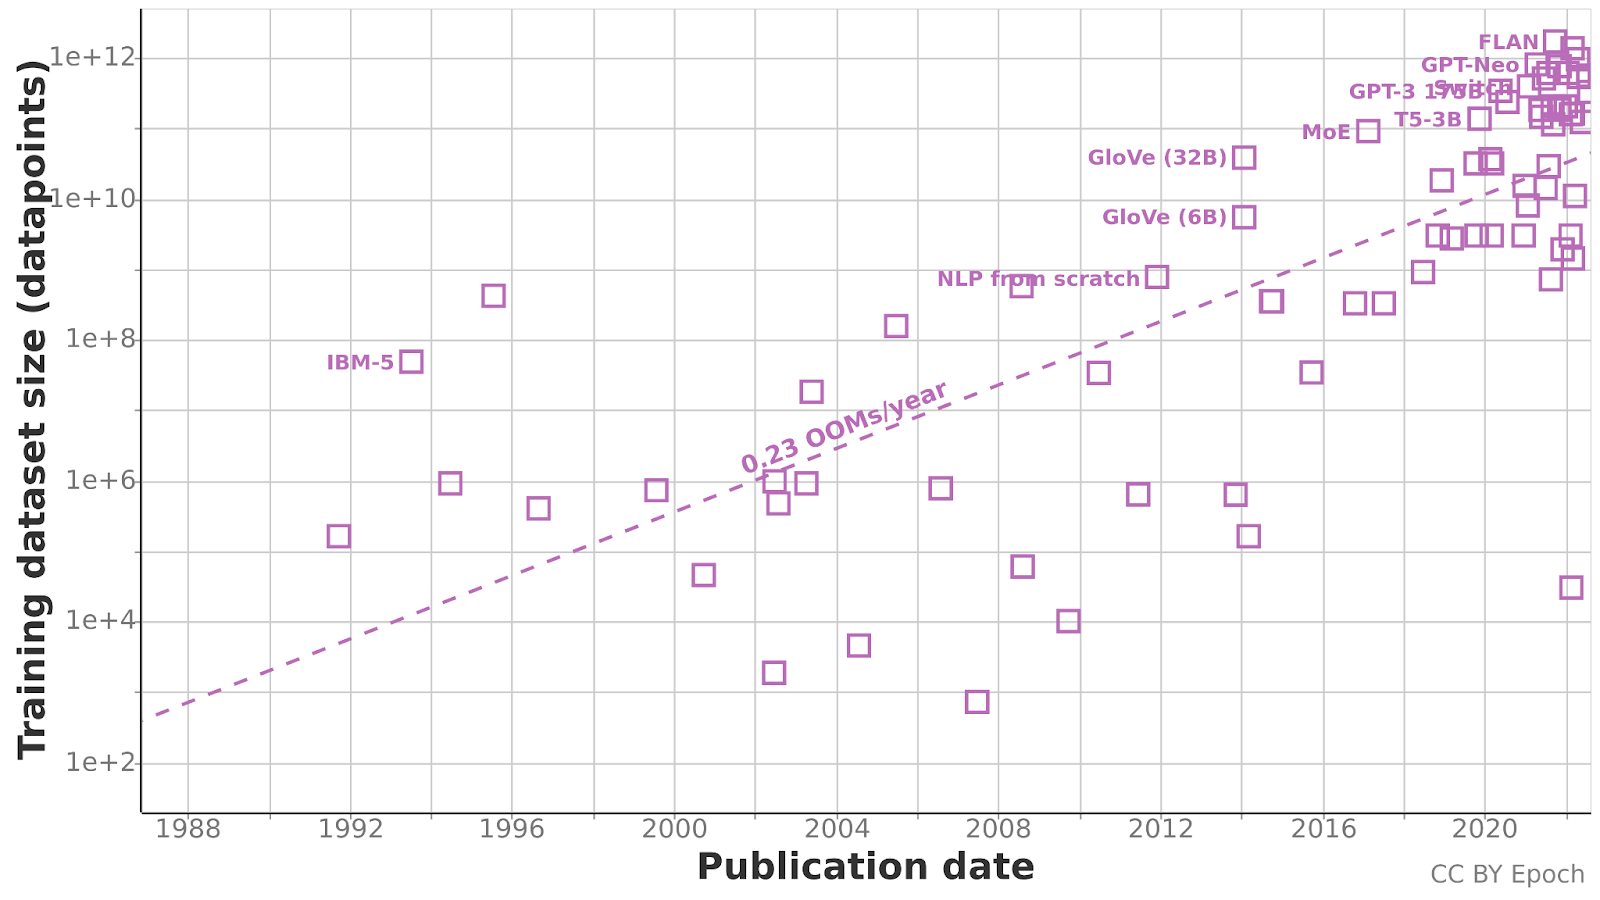
図3:言語のデータセットの変化
その他の分野
残りの分野についてはデータがごくわずかしかないので、結論はきわめて不確かである。ほかの四つの分野を図4に示す。
ゲームと音声のモデルはどちらも言語や視覚と似たパターンを示しており、2014〜2016年以降のモデルはすべて大量のデータを使っている。
推薦モデルの大半は、単一のデータセットと時期に集中している。これらは Netflix Prize のコンペティションの参加作だったからである。
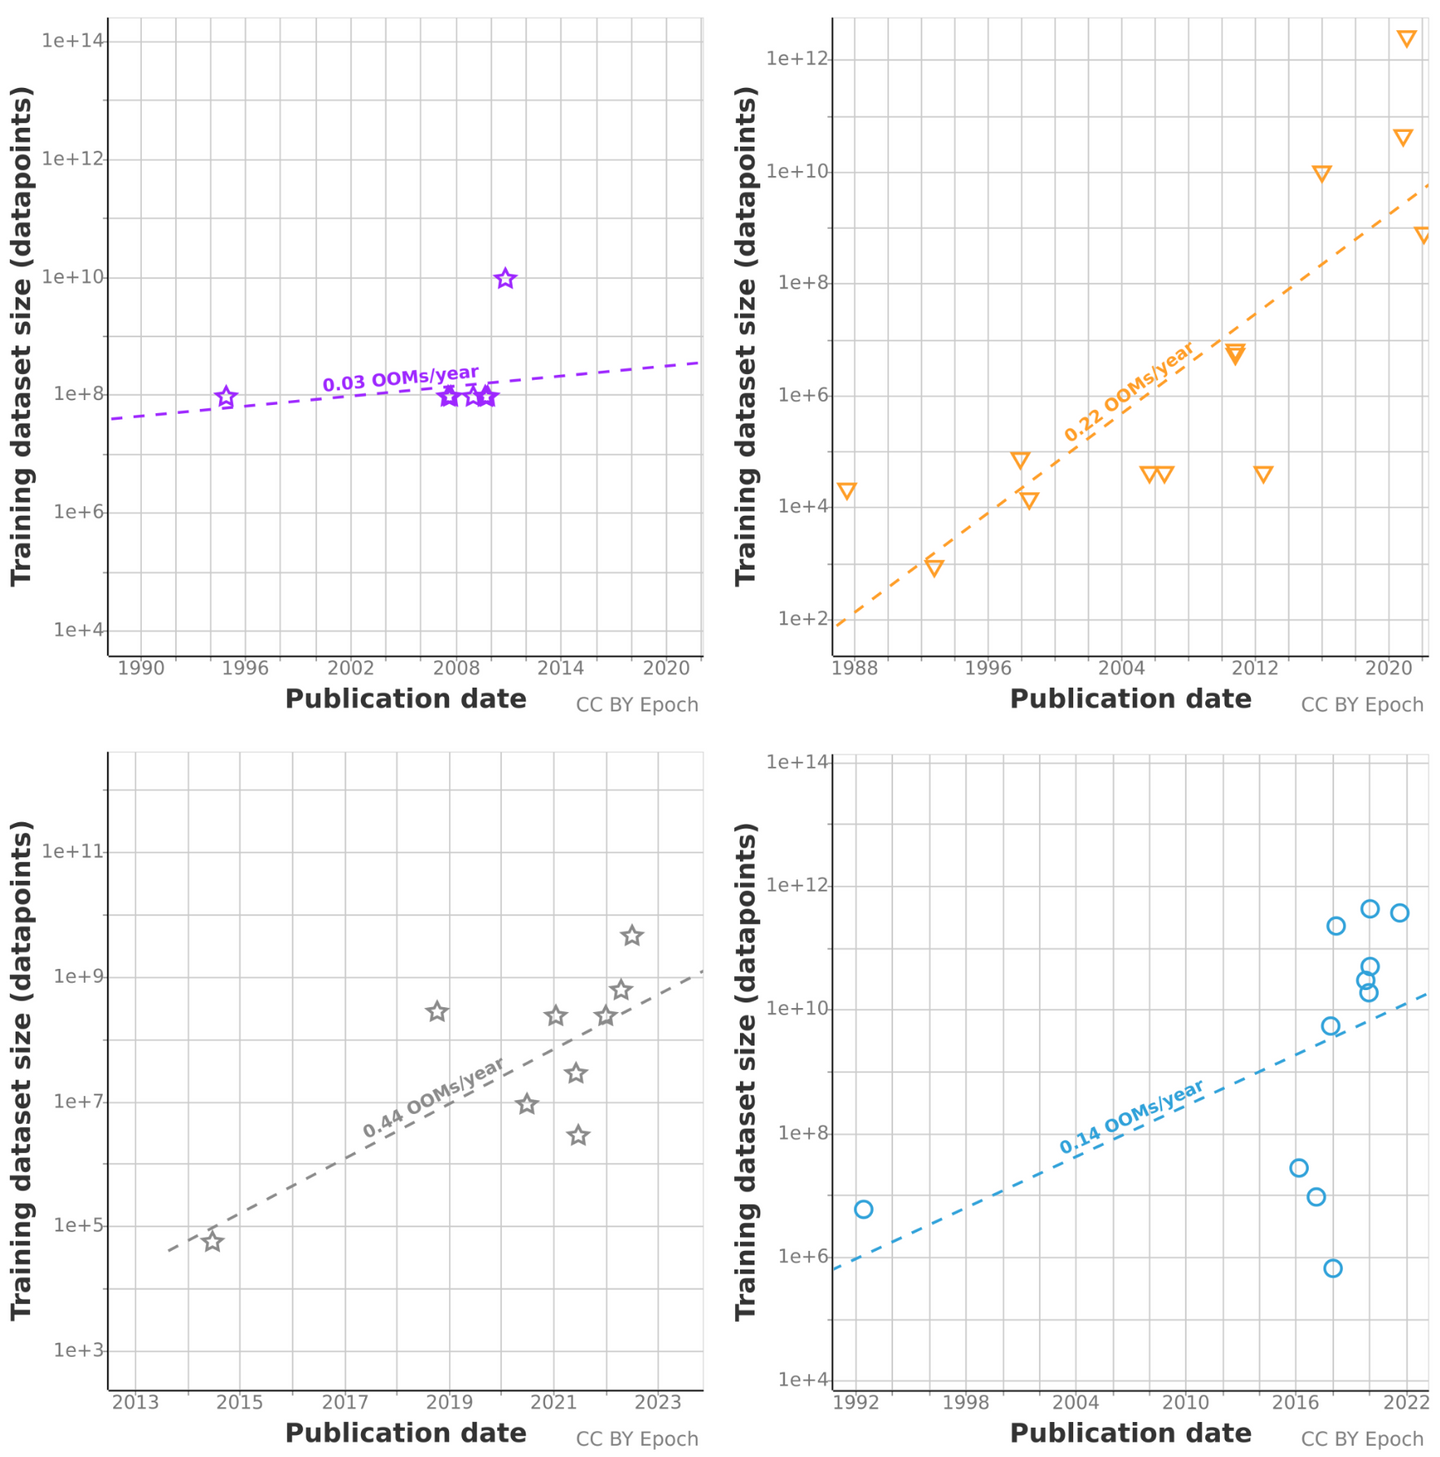
図4:推薦(左上)、音声(右上)、描画(左下)、ゲーム(右下)の傾向
結論
機械学習モデルとその学習データセットのサイズのデータベースを作成し、いくつかの分野でその伸び率を推定した。どの分野でもサイズは時とともに大きくなっているが、視覚と言語以外の分野では、サンプルサイズが小さすぎて意味のある結論を出せない。
言語、視覚、音声の分野では、2014〜2015年以降に移行があった証拠が見られる。この時期には、それまでの10年間に一般的だったものより桁違いに大きなデータセットが現れている。
計算資源の使用量とモデルのサイズの歴史的な傾向と合わせれば、これらの傾向は機械学習の過去の進歩を理解するのに役立ち、ひいてはこの分野の今後についてより良い予測を立てるのに役立つかもしれない。