
レポート
急落する思考の価格
原題:The plunging price of thought
要点
- AIは、歴史上のほかのどの変革的技術よりも速く安くなってきた。 一定水準のAI性能を達成するコストは、2023年以降、四半期あたり約47%、年13倍のペースで下がっている。 この価格低下は、DNA解読の4倍、計算資源の6倍、リチウム電池の18倍、そして(1973年までの1世紀でみた)電力の54倍の速さである。
- より粗い証拠からは、OpenAI が GPT-3 を全面公開した2021年11月、つまり商用LLMの推論実行(インファレンス)が始まって以来、思考の価格が少なくともこの速さで下がってきたことがうかがえる。
- 価格低下の速さは分野によって異なる。ゲームを使ったパズルでは四半期あたり39〜43%と遅く、数学の問題では四半期あたり50〜52%と速い。
- 一定水準の性能にかかるコストは、その水準が初めて達成された直後、つまりそれが最高水準(SOTA)であるときに最も速く下がることが多い。 AI能力を測る5つの主要ベンチマークのうち3つで、このパターンが見られる。 5つすべてを平均すると、SOTAとして登場したばかりの性能のコストは四半期あたり66%(年75倍)下がる。 2年後には下落の速さは半分になり、四半期あたり32%(年4.7倍)となる。
データとコードは GitHub で公開している。 多数のグラフや表を見て回れる補足ページもある。
概要
「ChatGPT」の「GPT」は「Generative Pre-trained Transformer(生成型事前学習済みTransformer)」の略で、その中で動くAIの仕組みを技術的に表した名前である。 とはいえ、OpenAI の GPT モデルの開発者たちは、この頭字語のもっと古い意味、すなわち汎用技術(general-purpose technology)を意識していたに違いない。 彼らは、蒸気機関や電力、インターネットと同じように、大規模言語モデルがいずれ社会のあらゆる面に関わるようになると正しく見通していた。
AIブームが、自らが必要とする投入物(チップ、電力、さらには電気技師の労働)の価格を押し上げるほど強力なマクロ経済的な力であることは、いまや広く理解されている。 あまり知られていないのは、その逆説的な裏面である。こうしたデータセンター群が生み出す産出物の価格は、きわめて速く下がっているのだ。
このグラフは原文でご覧ください。
次のグラフにいくつか例を示す。 2025年1月31日、OpenAI は「推論」モデルのシリーズの新版 o3 を公開した。 私たちの推定では、o3 は1問あたり平均30セントのコストで、博士課程レベルの物理学・化学・生物学を扱う多肢選択式の試験 GPQA Diamond で75%のスコアを達成できた。1 それから18か月足らずのうちに、OpenAI は GPT-5.6 Luna を公開した。 このモデルは同じスコアを、1問あたり0.04セント(0.0004ドル)で達成した。 18か月足らずで、思考の価格が725分の1になったことになる。 新車の表示価格が5万ドルから69ドルに下がったようなものだ。 これほど速く安くなった汎用技術は、歴史上ほかに見当たらない。
この傾向を測るため、私たちは新しく、より包括的なデータセットで性能を分析した。このデータセットには、過去3年間にわたる、数学・ハードサイエンス・知的ゲームを扱う5つのAI性能ベンチマークが含まれる。
この期間全体で、一定水準の性能にかかる価格は四半期あたり約47%、つまり年13倍のペースで下がっていることがわかった。 ゲームを使ったパズルでは下落が遅く四半期あたり約39〜43%(年7〜10倍)、数学の問題では速く四半期あたり50〜52%(年16〜19倍)である。
一定水準の性能にかかるコストの下落は、時間とともに遅くなる傾向がある。ただし、このパターンはどこでも見られるわけではない。 一つの説明として考えられるのは、ある性能水準が初めて達成されたとき、AI企業は短い間だけそれに割増価格をつけられるが、やがて競争と技術の進歩によって価格が急速に押し下げられる、というものだ。 時間がたつと、この動きは鈍くなる。 5つの主要ベンチマークで平均すると、コストは最初のうち四半期あたり66%(年75倍)下がる。 2年後には下落の速さは半分になり、四半期あたり「わずか」32%(年4.7倍)となる。
この分析には大きな注意点がある。 AI企業が一部のベンチマークに向けて意図的にモデルを学習させている(「ベンチマーク狙い」、benchmaxxing)可能性があり、その場合、ベンチマーク上の改善は現実の作業での改善を上回る。 そうでないとしても、ベンチマークで好成績を挙げることは、役に立つ仕事をすることと同じではない。 私たちはフロンティア、つまりある水準の性能を出せるモデルのうち最も安いものに注目するので、暗黙のうちに、作業ごとに最も費用対効果の高いモデルを執拗に探し続けるAI利用者を想定していることになる。実際の利用者はそれほど頻繁にモデルを切り替えないので、ここまでの節約は得られない。 私たちのデータは不完全でノイズも多い。対象期間はかろうじて3年で、AIモデルとベンチマークのすべての組み合わせを含んでいるわけでもない。 価格の下がり方はモデル、ベンチマーク、期間、性能の範囲によって異なり、このばらばらな実態を平均する妥当な方法はいくつもある。 全体として、私たちの最終的な数値は現実をおおむね代表していると考えているが、正確な値として読むべきではない。
本レポートの残りでは、分析を詳しく説明する。 一部は技術的な内容になる。
先行研究
AIの価格がどれほど速く下がっているかを定量化したのは、私たちが初めてではない。 Andreessen Horowitz の Guido Appenzeller による2024年の記事は、GPT-3 が一般公開されてからの3年間で、LLMのコストが1000分の1、つまり年10倍のペースで下がったことを示した。 その数か月後の2025年3月、Epoch AI の分析は、6つの性能ベンチマークで年9〜900倍の下落を見いだした。 最近では Demirer, Fradkin, and Tadelis (2026) が同様の分析を行い、Artificial Analysis Intelligence Index のさまざまな性能水準について、2023〜25年の価格の推移をグラフにした。
これらの分析はいずれも、その性能を実際に達成するのにかかるコストではなく、一定の性能を達成できるモデルのトークンあたり価格を測っていた。 推論モデルが登場して(OpenAI は2024年12月に o1 を公開した)、この違いを無視するのはいっそう問題になった。 推論モデルははるかに多くのトークンを有効に使える一方、その結果として、より小さくトークンあたりの実行コストが安い基盤LLMから高い性能を引き出せる。
2025年9月、Håvard Tveit Ihle は、2種類のコーディング課題集について性能とコストを直接比較した分析を LessWrong で公開した。 この分析では、コストが1.4〜2か月ごとに半減している(年64〜380倍)ことがわかった。
これまでで最も徹底した分析は、Gundlach et al. による2026年3月の論文である。この論文も、実際のコストを性能と比較している。 本分析と同じく、データ全体と、各時点でコストのフロンティアを形づくるモデルの部分集合の両方について傾向を推定している。 さらに、性能水準別(高性能側ほど価格が速く下がる)と、モデルの種類別(オープンかクローズドか、密なモデルか専門家混合(mixture of experts)か)にも分けて分析している。 全体として、年5〜10倍の下落を見いだしている。
データ
本分析の大きな新しさは、各モデルの費用と性能の連続的な関係全体をとらえる方法で、コストの傾向を分析する点にある。
あるLLMがあるベンチマークで1ドルのコストで80%を取り、別のLLMは0.50ドルで60%が上限だとすると、どちらが費用対効果が高いかは自明ではない。 強いほうのモデルも、推論トークンを減らして動かせば、弱いほうのモデルより安く60%を達成できるかもしれない。
より一般的に言えば、私たちの関心は費用対効果の「パレート」フロンティア、つまり各時点で利用できるモデルを使って各性能水準を達成する最も安い方法を描き出すことにある。 LLMに無制限の予算を与えたときのコストと性能だけを推定したのでは、描かれないまま残る領域が多く、フロンティアも大きく取りこぼしかねない。 現在のLLMはどれも、推論の設定を低・中・高・最大のどれにするか、予算の上限を課すかどうかによって、さまざまな水準の性能を出せる。
モデルの費用対性能曲線を描く一つの方法は、推論レベルとトークン予算をさまざまに変えて、ベンチマークで何度も実行することである。 しかし、この方法は費用も時間もかかる。 そこで私たちは、米連邦政府の AI標準・イノベーションセンター(CAISI)が開発した手順に従う。 この手順では、予算の制約を高く設定した(あるいは制約なしの)ベンチマーク実行の記録(トランスクリプト)を使って、より厳しい予算のもとでの性能を予測する。 基本的な考え方はこうだ。ベンチマークは多数の問題から成るので、LLMが一定の予算を使い切る前にいくつの問題に答えるかを推定できる。 必要な情報はトランスクリプトにある。各問題に答えるのにモデルが何トークンを使ったか、そしてどの問題に正解したかである。2
1問あたりの任意の予算 X トークンについて、出力トークンが X 未満で正解した問題の数を合計する。 これは、モデルが打ち切られるまでに使える費用の上限だと考えればよい。 ある予算の閾値までにモデルが答えを出せなかった問題は、当て推量で正解する確率で採点する。これはたとえば4択問題なら0.25、その他の種類の問題では事実上0となる。 これをさまざまな予算について繰り返すと、仮想的な支出額の関数としての性能曲線が得られる。
この手順については、LLMが予算を知らされた場合に実際に出す性能を見誤るおそれがある、という懸念が一つある。 もしモデルが、より低い閾値で良いスコアを取るよう最適化すべきだと告げられていれば、CAISI の方法でシミュレートしたように問題を黙って打ち切る場合よりも良い成績を出すかもしれない。
この懸念を確かめるため、私たちは評価を修正し、1問あたりの予算をモデルに明示的に伝えた。 結果を見ると、思考モデルを高い思考量で動かした版は、予算を告知されると低予算での性能がしばしば向上するものの、告知なしの標準的な条件で動かした低い思考量の版を上回るわけではないようだった。 つまり、思考モデルを単に低い思考量で動かすだけで、高い思考量で上限を告知して動かした場合と似た費用対性能曲線が得られる。 (いくつかのモデルの例は図3を参照。) したがって、すべての思考レベルにわたって CAISI の方法を使う限り、モデルが取りうるコストと性能の範囲の大部分はおそらくカバーできる。
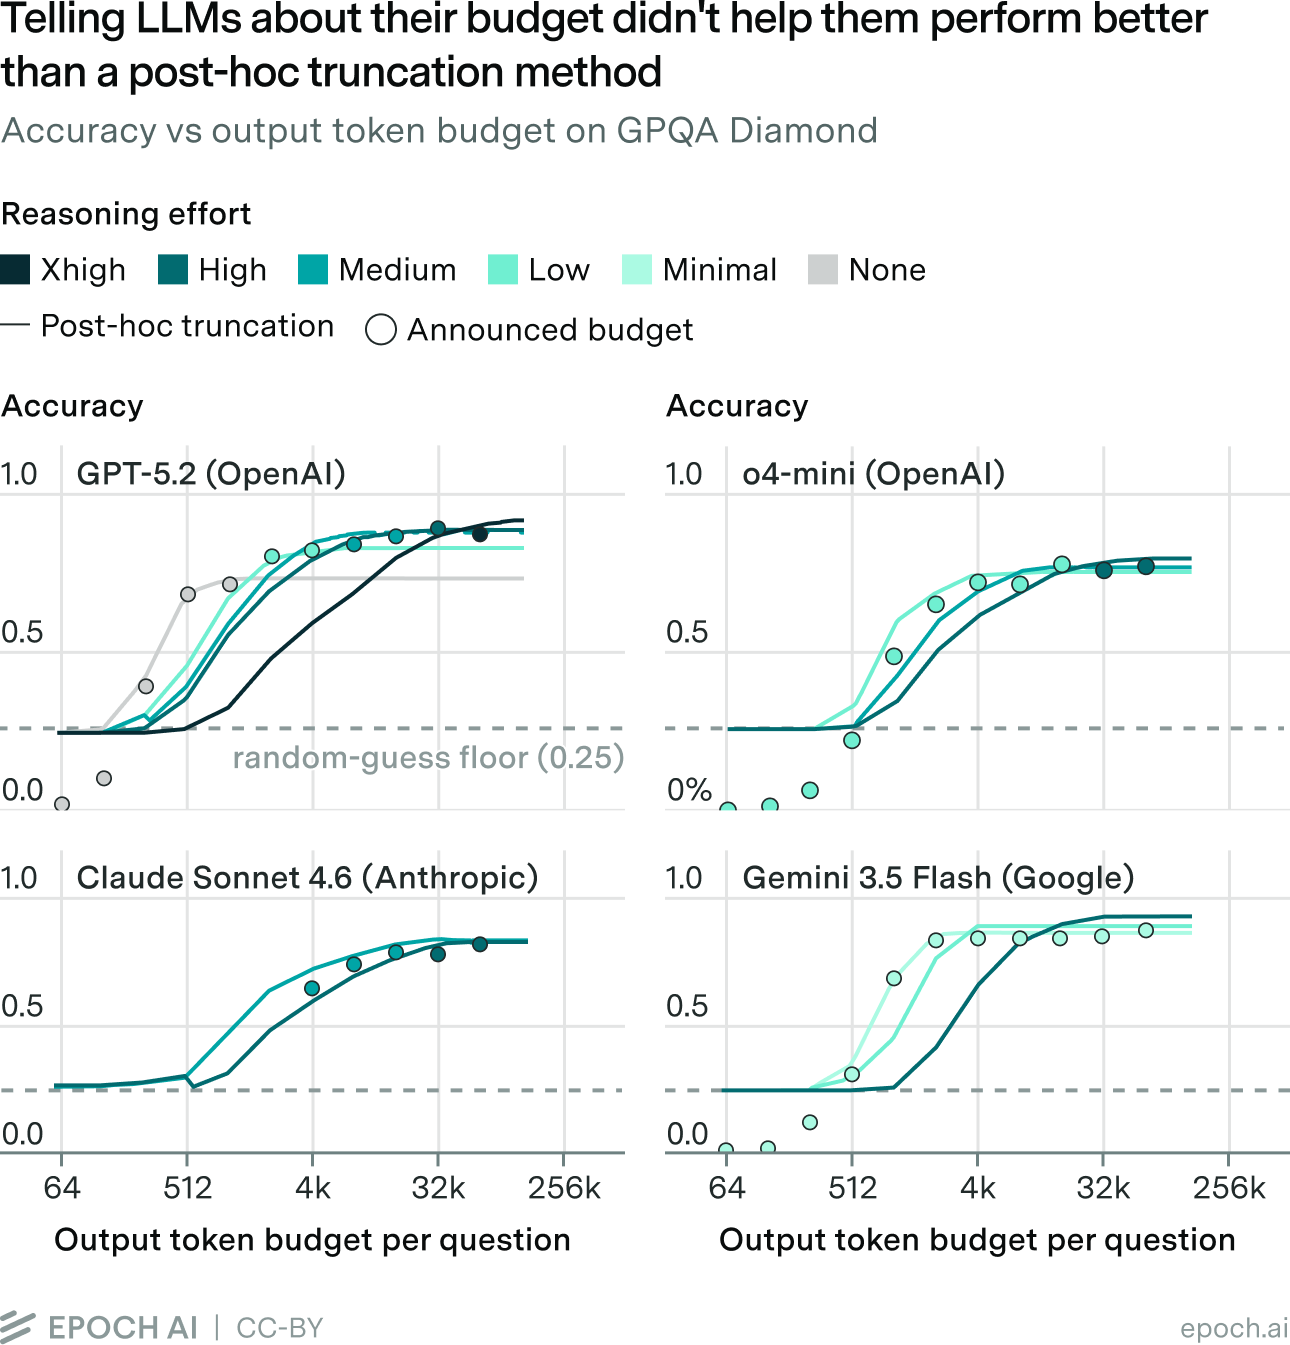
図3. 予算の上限をモデルに告知しても、単に予算を制限した場合とほぼ同じコストと性能の関係が描かれる
これまで私たちのベンチマーク評価は、費用効率をほとんど考慮せずに性能の上限をとらえることに重点を置く傾向があったため、低い推論設定での評価や、効率重視の小型モデルの評価がデータから系統的に抜け落ちていた。 結果に偏りが生じないよう、私たちは FrontierMath Tiers 1-3 (v2)、OTIS Mock AIME 2024-2025、GPQA Diamond、Chess Puzzles、Mystery Game Puzzles について、この欠けた部分を埋めるためのデータ収集に集中的に取り組んだ。 その中には、いくつかのオープンウェイトモデルを自分たちで直接動かすことも含まれる。これらのモデルはコストと性能のパレートフロンティア上にある可能性があったが、推論実行専用のAPIからは利用できなかったからである。 これらのモデルでの評価の価格には、レンタルしたハードウェアのコストを使った。その際、妥当な応答時間を保ったうえで費用効率が最大になるよう、ハードウェアの選択と評価の設定の両方を最適化するよう努めた。 この方法の妥当性を確かめるため、推論実行APIからも利用できる5つのオープンウェイトモデルをこの方法で動かした。 いずれの場合も、私たちが直接かけたコストとAPI価格の差は30%未満だった。
モデル化
課題
各ベンチマークについて、3つ組 の集合がある。これは、ある実行でのモデルの回答の正答率、モデルの公開日、その実行にかかったドル建てのコストを表す。 先に説明したとおり、CAISI の方法では仮想的なトークン上限を変えていくので、モデル・思考レベル・ベンチマークの組み合わせごとに多数の3つ組ができる。
私たちが明らかにしたいのは、一定水準の性能にかかる価格の下落率である。それも平均的なモデルについてではなく、「フロンティア」、つまりあるベンチマークで必要な性能を出せる、利用可能なうちで最も安いモデルについての下落率である。
具体的には、正答率とコストについて2つの経験的パレートフロンティアを定義する。 経験的な正答率フロンティアは、ある日付までに利用可能になったモデルを使って、ある予算内で達成された最高の性能である。
経験的なコストフロンティアは、利用可能なモデルのうち少なくとも1つが、ある正答率の目標を満たすか上回ることのできる最低のコストである。
これらの曲面は、どちらの次元でも常に同じ向きに不連続に跳ぶため、2次元の階段のような形になる。
動いていくこれらのフロンティアを統計モデルで表すことは、いくつかの点で難しい。
- 正答率は100%を超えられないので、産出には上限がある。 生産フロンティアやコストフロンティアを扱う経済モデルの多くでは、産出はいくらでも大きくなりうる。
- フロンティアは各点での最大値または最小値として構成される。 そのため不安定である。 ベンチマークの結果が一つあるだけで、あるいは一つ欠けるだけで、フロンティアが何か月にもわたって大きく動くことがある。 統計的な研究の多くは平均に注目する。 平均を扱う場合、推定値が収束していくにつれて、データ点が1つ増えるごとの影響は前のデータ点より小さくなっていく。 極値を扱う場合、こうした極限的な振る舞いが現れるのはもっと遅い。 したがって、経験的なフロンティアは「真の」フロンティアをノイズ混じりに表したものだと考えるべきである。
- 2番の理由から、標本抽出の仕方がより大きく効いてくる。 たとえば、新しいモデルほど高い割合でベンチマーク評価されていれば、フロンティアの後のほうの領域が膨らみやすくなる。 モデルの評価には時間とお金がかかるので、私たちは主に、公開日の時点でフロンティアの近くにあると思われるモデルを評価してきた。 そのため、標本抽出はやや場当たり的である。 つまり、データ生成過程について、信頼できるすっきりしたモデルを私たちは持っていない。
- モデルの公開は時間的にまばらである。 フロンティアを動かす公開はさらにまばらだ。 それでも、データ点のない日にもフロンティアは存在し、その正確な位置は情報を含んでいる。 ただしその情報は限られている。昨日のフロンティアは今日のフロンティアをよく予測するからである。 言い換えれば、空間的自己相関がある。 ここで行うようにフロンティアを格子状の点での値で表す場合、空間的自己相関を適切に補正しない限り、格子の解像度を上げると標本数と見かけ上の推定精度が増してしまう。
- 調べた期間内では、変化がきわめて速い。 生産フロンティアの研究の多くは、製造業や農業のような変化の緩やかな産業を対象としており、そこでは各時点で多数の生産者がフロンティアを形づくっている様子を想像しやすい。
2〜4番の項目があるため、フロンティアをモデル化するとき、信頼できる標準誤差を、したがって統計的有意性の推定値を出すのは難しい。 標準誤差は常に、ノイズの成分の定式化も含めておおむね現実的に見えるデータ生成過程のモデルの上に成り立つものだからである。
解析的な方法で標準誤差を推定できない場合によく使われる手段の一つは、ブートストラップで推定することである。 しかし後で説明するように、私たちはこの対処法にさえ懐疑的である。
こうした理由から、私たちは統計的推測の形式的な枠組みを放棄する。 ロジスティック回帰や確率的フロンティア分析など、計量経済学の手法は借りる。 しかし、標準誤差は報告せず、データ生成過程のモデルのパラメータの値について形式的な仮説検定も行わない。 結果は、疑いようなく存在する現象を、入手できる最良のデータに基づいて測った、妥当だが大まかな測定値として受け取るべきだと考えている。
モデル
私たちはデータに5つの主なモデルを当てはめた。2つは経験的フロンティアに、3つはベンチマーク結果の全体に当てはめたものである。 後者のうち2つは確率的フロンティア分析を応用したものだ。 その結果は信頼できない(フロンティアが後退したことを示す場合が多い)ため、付録に回した。
このモデル群は、短い探索的な過程から生まれた。 その過程で、いくつかの問いが浮かんだ。
- 経験的フロンティアそのものをモデル化すべきか。それとも、データセット全体にモデルを当てはめ、動いていくフロンティアの最良の表し方を当てはめの過程に見つけさせるべきか。
- 平滑化されたモデル予測上のフロンティアは、経験的フロンティアの完全に外側にあるべきか。それとも、最適な当てはめ直線が点の集まりの中を通るように、経験的フロンティアを近似するだけでよいのか。
さまざまなモデルは、これらの問いに対する異なる答えを表している。
このモデル化の問題には、公開日、支出額、ベンチマーク性能という3つの変数が関わる。 3つ目をほかの2つの関数としてモデル化するのが自然である。支出は生産への投入であり、時間は生産技術に影響し、性能は産出だからだ。 しかし、ここでの最終的な関心は性能ではなく、コストを決める要因にある。 そして経済学には、生産関数とコスト関数を互いに双対なものとみなし、両方を似た方法でモデル化する長い伝統がある。 双対の見方では、コストは時間とベンチマーク正答率の関数として位置づけられる。
理想的には、コストの下落率の推定値は、性能を時間とコストの関数としてモデル化するか、コストを時間と性能の関数としてモデル化するかに左右されないはずである。 どちらの場合も、同じ変数間の同じ関係を推定しているからだ。 また、一方のフロンティアにモデルを当てはめれば、もう一方への含意を逆算できる。 実際には、同じモデル化の手法を2種類のフロンティアに適用するやり方には、いくらか非対称性(あるいは反対称性)がある。 たとえば、平面上の点に直線を当てはめるとき、点と直線の垂直方向の距離を最小化することも、水平方向の距離を最小化することもでき、それぞれ異なる答えが得られる。
ここでの方針は、両方の見方からモデル化し、そのどちらからも、性能とコストという両方の従属変数についての含意を引き出すことである。 ウェブ上のインターフェースで結果を見て回れる。
モデル1:パレート・ロジスティック/最小二乗
考え方は、上で定義した経験的フロンティアに滑らかな曲面を当てはめることである。 点の雲を通る最適な当てはめ直線と同じく、最適な当てはめの両側に実際のデータ点がある。 したがって、当てはめたフロンティアは、厳密には経験的フロンティアをつくるすべての点を包み込むわけではないが、その全体的な形を要約したものになる。
正答率のモデルでは、各時点でフロンティアのモデルの正答率が、対数コストと公開日の両方と次の関係にあると仮定する。
ここで はロジスティックS字曲線の関数、 は統制変数のベクトル(少なくとも対数コスト()、公開日()、定数を含む)、 は対応する係数のベクトル、 はそれらの統制変数を条件としたモデルの期待正答率である。
パラメータは分数ロジット回帰(Papke and Wooldridge 1996)で推定する。この回帰で最大化する目的関数は、二値の結果に対するロジットモデルと数学的に同じ式だが、結果の値として0以上1以下の値をとれるように解釈し直したものである。
コストフロンティアについては、上限のない対数コストを、予測変数の線形関数としてモデル化する。
は少なくとも、 のロジット(ロジスティック関数の逆関数)、記号では と、 と定数を含む。 これは通常の最小二乗法(OLS)で当てはめる。 ロジット変換は0と1を±∞に写すので、前のモデルと違って、スコアが0または1のデータは標本から除く。
これらの正答率モデルとコストモデルは、それぞれ2次元の定義域全体にわたって1回ずつ当てはめる。 当てはめでは、フロンティアの曲面を、本レポートの2番目の図で強調したような記録更新のデータ点だけでなく、格子点上での または の値で表す。 格子点は、1) 公開日と、2) 対数コストまたは正答率の、等間隔の値である。 時間の次元では、格子の解像度は13日ごとに1点とした。これは、データが最も早く始まるベンチマーク(GPT-4 に適用した AIME OTIS Mock。GPT-4 は2023年3月14日公開)でおよそ100点になるように選んだ値である。 また、各ベンチマークで観測された正答率の範囲に100点の格子を置いた。
パレート曲面全体をモデル化しているので、最適な当てはめ曲面のある断面、たとえば2026年1月1日時点のコスト対正答率の断面は、一般に、経験的フロンティアの対応する断面だけに対する最適な当てはめにはならない。 どの断面での当てはまりの良さも、モデルの構造のもとで、すべての断面にわたる全体として最適な当てはめを求めるという目標によって制約されている。
モデル2:包絡
このモデル化の手法は、前の手法に制約を加えたものである。
- 理論上のフロンティアが、経験的フロンティアの完全に外側にあるよう強制する。正答率をモデル化するときは上側、コストをモデル化するときは下側である。
- 正答率モデルでは、一部のベンチマークテストで満点の1が出る。 しかし、ロジスティック関数に基づく包絡は決して1に届かないので、このような満点の点を包み込むことはできない。 そこで当てはめの前に、1を で置き換える。ここで は、そのデータ点をつくる際にモデルが解答を求められた問題数、つまり実行回数×1回あたりの問題数である(cost_truncated_curves.csv の「n_samples」列)。 言い換えれば、満点を、半分の確率で全問正解し、残り半分の確率で1問を除いて全問正解することに相当する数値で置き換える。
包絡が経験的フロンティアの階段のすべての角の外側にとどまる(あるいはちょうど接する)という要件は、パラメータに対する多数の非線形制約となる。 制約付きの最適な当てはめを求めるには、逐次最小二乗計画法(SLSQP)を使う。
モデル3:全データ・ロジスティック/最小二乗
このモデルはモデル1と同じだが、経験的フロンティアを表す格子点ではなく、データセット中のすべてのテスト結果に当てはめる。 このモデルは構造上フロンティアを対象にしたものではないが、いくつかの理由で含めている。 データ点が極値ではないので、当てはめが本質的に不安定になりにくい。 手法が単純である。 そして、フロンティアのモデルとほぼ同じ答えを出すと期待できるかもしれない。 たとえて言えば、過去50年間のコンピュータ用メモリの価格の下落率は、平均的なメモリモジュールでも、各時点で最も安いものでも、ほぼ同じだろうと予想される。
非線形モデル
ここまで定義したモデルは、 ベクトルが2つの予測変数(時間と、正答率または対数コスト)だけから成るという意味で線形である。 正答率モデルでいえば、四半期が1つ過ぎるごと、支出が1回倍増するごとに、ベンチマーク正答率のロジット が同じだけ改善すると仮定することになる。 コストモデルでいえば、四半期が1つ過ぎるごと、正答率のロジットが1単位増えるごとに、コストに同じ比率の影響が及ぶと仮定することになる。
これらの仮定が正しいかどうかは明らかではない。 コストの下落は暦の上の時間につれて加速するかもしれないし、減速するかもしれない。 ある時点での支出に対して収穫逓減があるかもしれない。
(より多くの)非線形性を許容するため、すべてのモデルを2次の版でも実行する。 正答率モデルでは、ベクトル に を加える。 コストモデルでは、 に を加える。
2次モデルは数学的には自然だが、放物線状の傾向を、したがって向きの反転を含意するという特異な点がある。 そうなると、ある時期やあるコスト水準では、LLMが時間とともに悪くなると予測されてしまう。 通常、こうしたありえない予測はデータの範囲の外側か端のほうに現れる。 それでも、説明しにくいモデルの当てはめを生むことがある。
別の方法は、各 変数に Box-Cox 変換を施すことである。 この変換は、向きの反転を避けながら、さまざまな曲がり具合を表現できる。 つまり、各変数について単調性を保つ。 たとえば、正答率モデルの予測変数 を次の式で置き換える。
これにより、推定すべき追加のパラメータとして指数 が入る。 Box-Cox 変換は、べき変換を平行移動・拡大縮小して、いくつかの都合のよい性質を持たせたものである。 のときは単に となるので、線形を特殊な場合として含む。 のときは下に凸、 のときは上に凸になる。 の極限では に等しくなるので、もとの対数線形の関係を厳密に一般化している。
Box-Cox 変換を使うモデルでは、予測変数のそれぞれが独自の指数 を持てる。 正答率の変数に適用するときは、オッズ比 に変換を施す。 そうすれば、変換は を特殊な場合として含む。これは「線形」モデルで使っているものと同じである。 さらに、2次モデルと同じく、Box-Cox 変換した2つの項の積も、それぞれの項と同じ指数 で回帰変数として加える。
Box-Cox 変換のもとでは、 がとりうる値は「時間ゼロ」をどこに置くかに依存する。 私たちはそれを2021年11月18日と定める。 この日、OpenAI はGPT-3 の API を商用利用向けに全面開放し、商用LLMの推論実行の時代を開いたといえる。 別の日を選べば、結果はいくらか変わるだろう。
用語について一つ厄介な点がある。Box and Cox (1964) は「Box-Cox 変換」を従属変数に適用し、その分布を正規分布に近づけた。 ここでは Box and Tidwell (1962) にならって、独立変数に適用している。 したがって、これらの回帰は Box-Tidwell と呼ぶのが最も適切である。
当てはめのコードは、2段階の過程で最適な当てはめを探す。 上の段階では、ありうる の組の空間で探索を行う。 試行値の組ごとに、指数 を固定したまま、ほかのモデルパラメータを線形モデルと同じ方法で推定する。
時間の指数 は推定が難しいことがあった。特に、評価の履歴が短いベンチマークのコストモデルで難しかった。 許容した(広い)範囲 [–8, 8] の中にピークが見つからないのである。 各ベンチマークのデータセットがカバーする期間は短く、時間についての2次の効果を確実に測るのは難しいので、これは意外ではない。 このように推定がうまくいかない場合、コードは を課して線形に戻す。
どのモデルを採るか
私たちの関心はフロンティアでのコスト下落にあるので、データセット全体ではなくフロンティアに当てはめたモデル、とりわけコストフロンティアに当てはめたモデルを優先する。 付録で説明する確率的フロンティアモデルは、(動いていく)フロンティアを信頼できる形で特定できない。 データセット全体に対する単純な回帰(上のモデル3)は、そもそもフロンティアを特定するようには設計されていない。
フロンティアだけに当てはめた2つのモデルのうちでは、経験的パレート曲面を包絡するよう制約されていないモデル1を選ぶ。 私たちの関心は、理論上のフロンティアがどこにあるかではなく、現実のコストと性能のトレードオフにある。 私たちのデータは、重要なモデルを実質的にすべて含んでいるので、利用可能な性能を代表している。 経験的フロンティア曲面を滑らかに近似すれば、そのごつごつした輪郭をいくつかの数値に凝縮できる。 加えて、包絡の制約は、正答率が1に近い観測値に過大な影響力を与えかねない。そうした観測値では、測定の小さな誤差が、モデルのパラメータの許容範囲に大きく影響しうるからである。
モデルの次数については、Box-Tidwell を選ぶ。 3次元曲面のグラフでは、線形の当てはめの多くが非現実的に見える。 2次モデルはそれよりよいが、データ範囲の端で非現実的な反転を起こすことが多い。 Box-Tidwell の当てはめは、単調性のおかげで、より現実的に見えながらデータにより近く沿う。
図4と図5は、選んだモデルの当てはめをグラフで示したものの一例である。 図4では、5つの主要ベンチマークのうち4つのデータ点を、LLMの公開日で色分けして描いている。 その上に、半年ごとの経験的な正答率フロンティアと、モデルの当てはめから導かれる対応する滑らかな曲線を重ねている。 図5ではコストのモデル化に切り替え、パレート曲面全体を Box-Tidwell の当てはめと比べている。 (時間軸の向きに注意してほしい。) 動く3次元グラフは操作できる。 拡大したり回転させたりして、さまざまな角度から見られる。
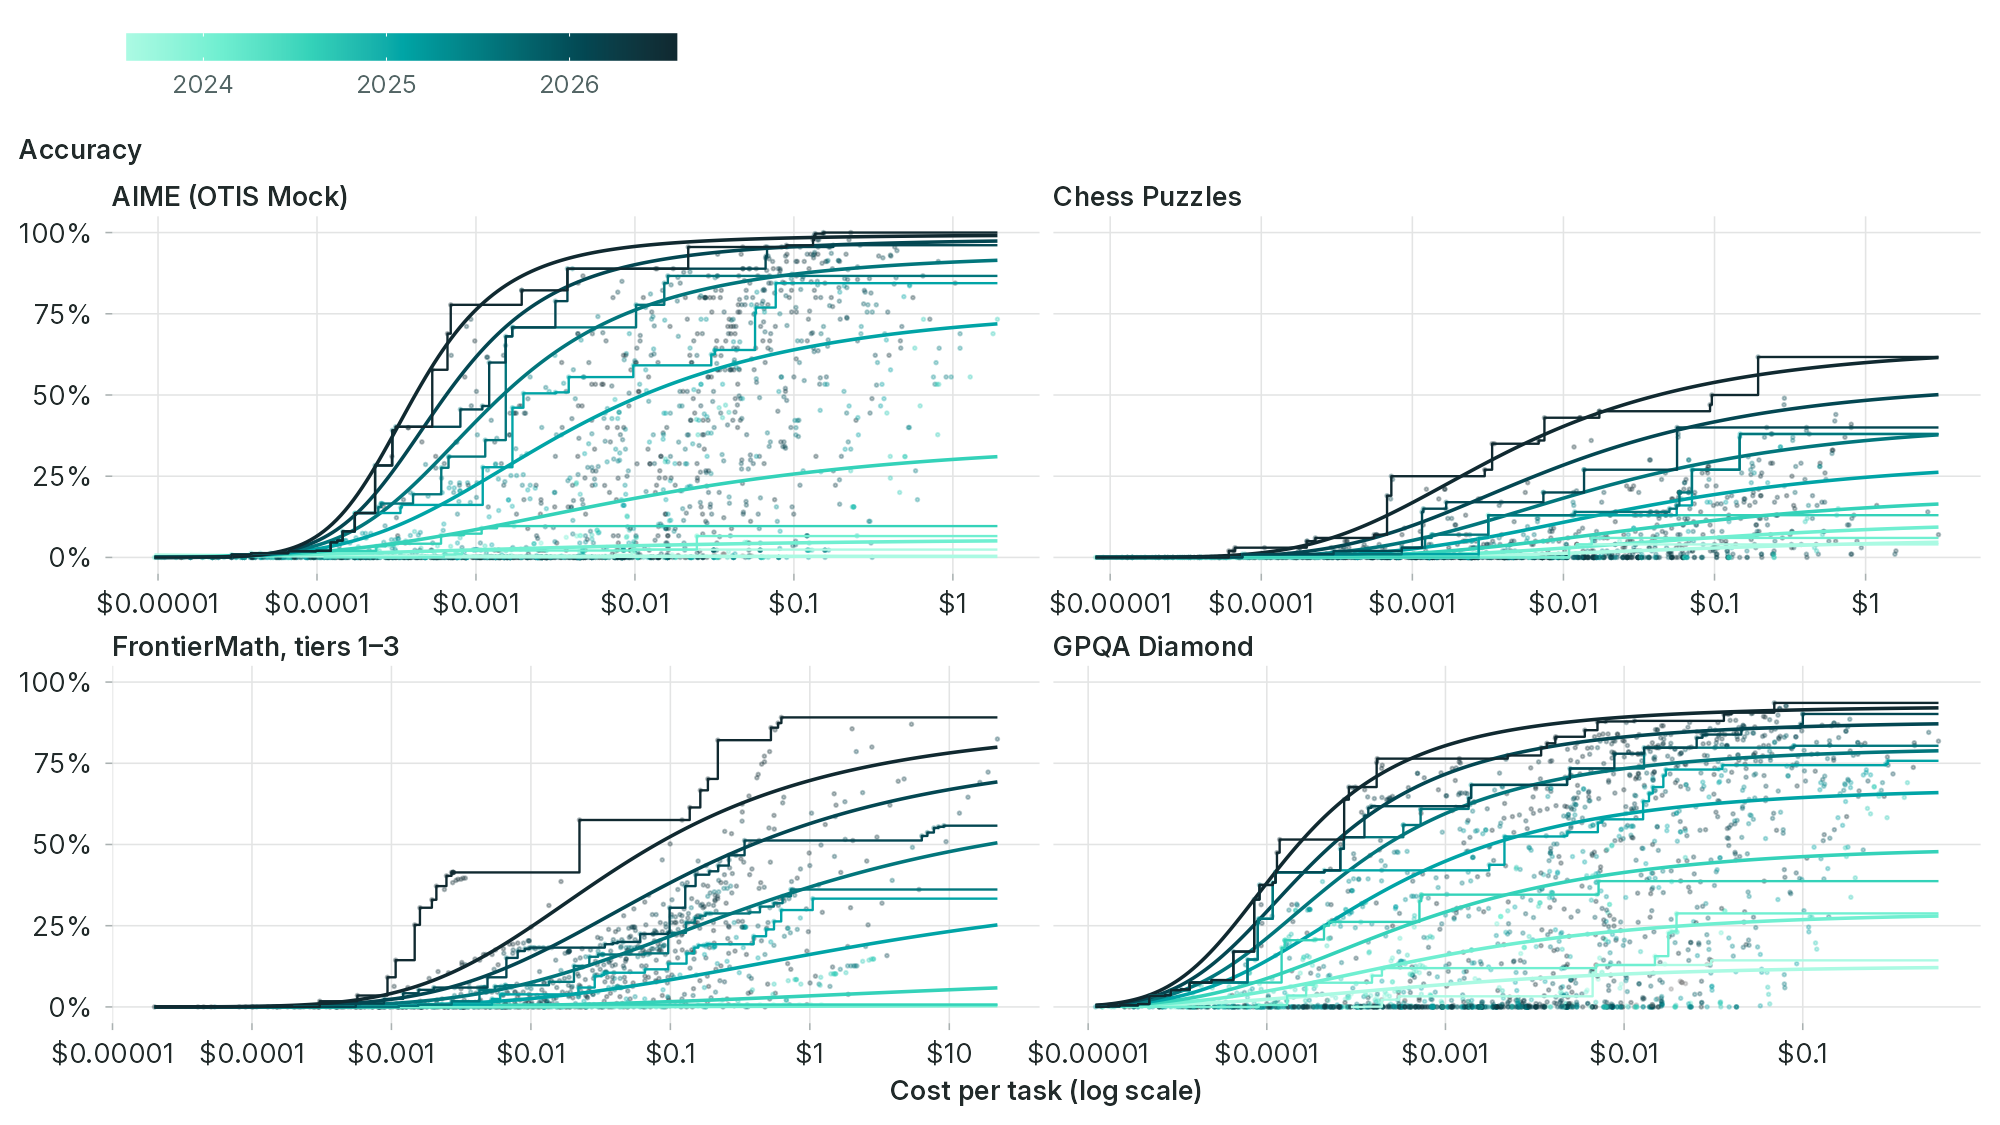
図4. 4つの主要ベンチマークにおける、ベンチマーク結果、半年ごとのパレート正答率フロンティア、それに対する滑らかな当てはめの推移
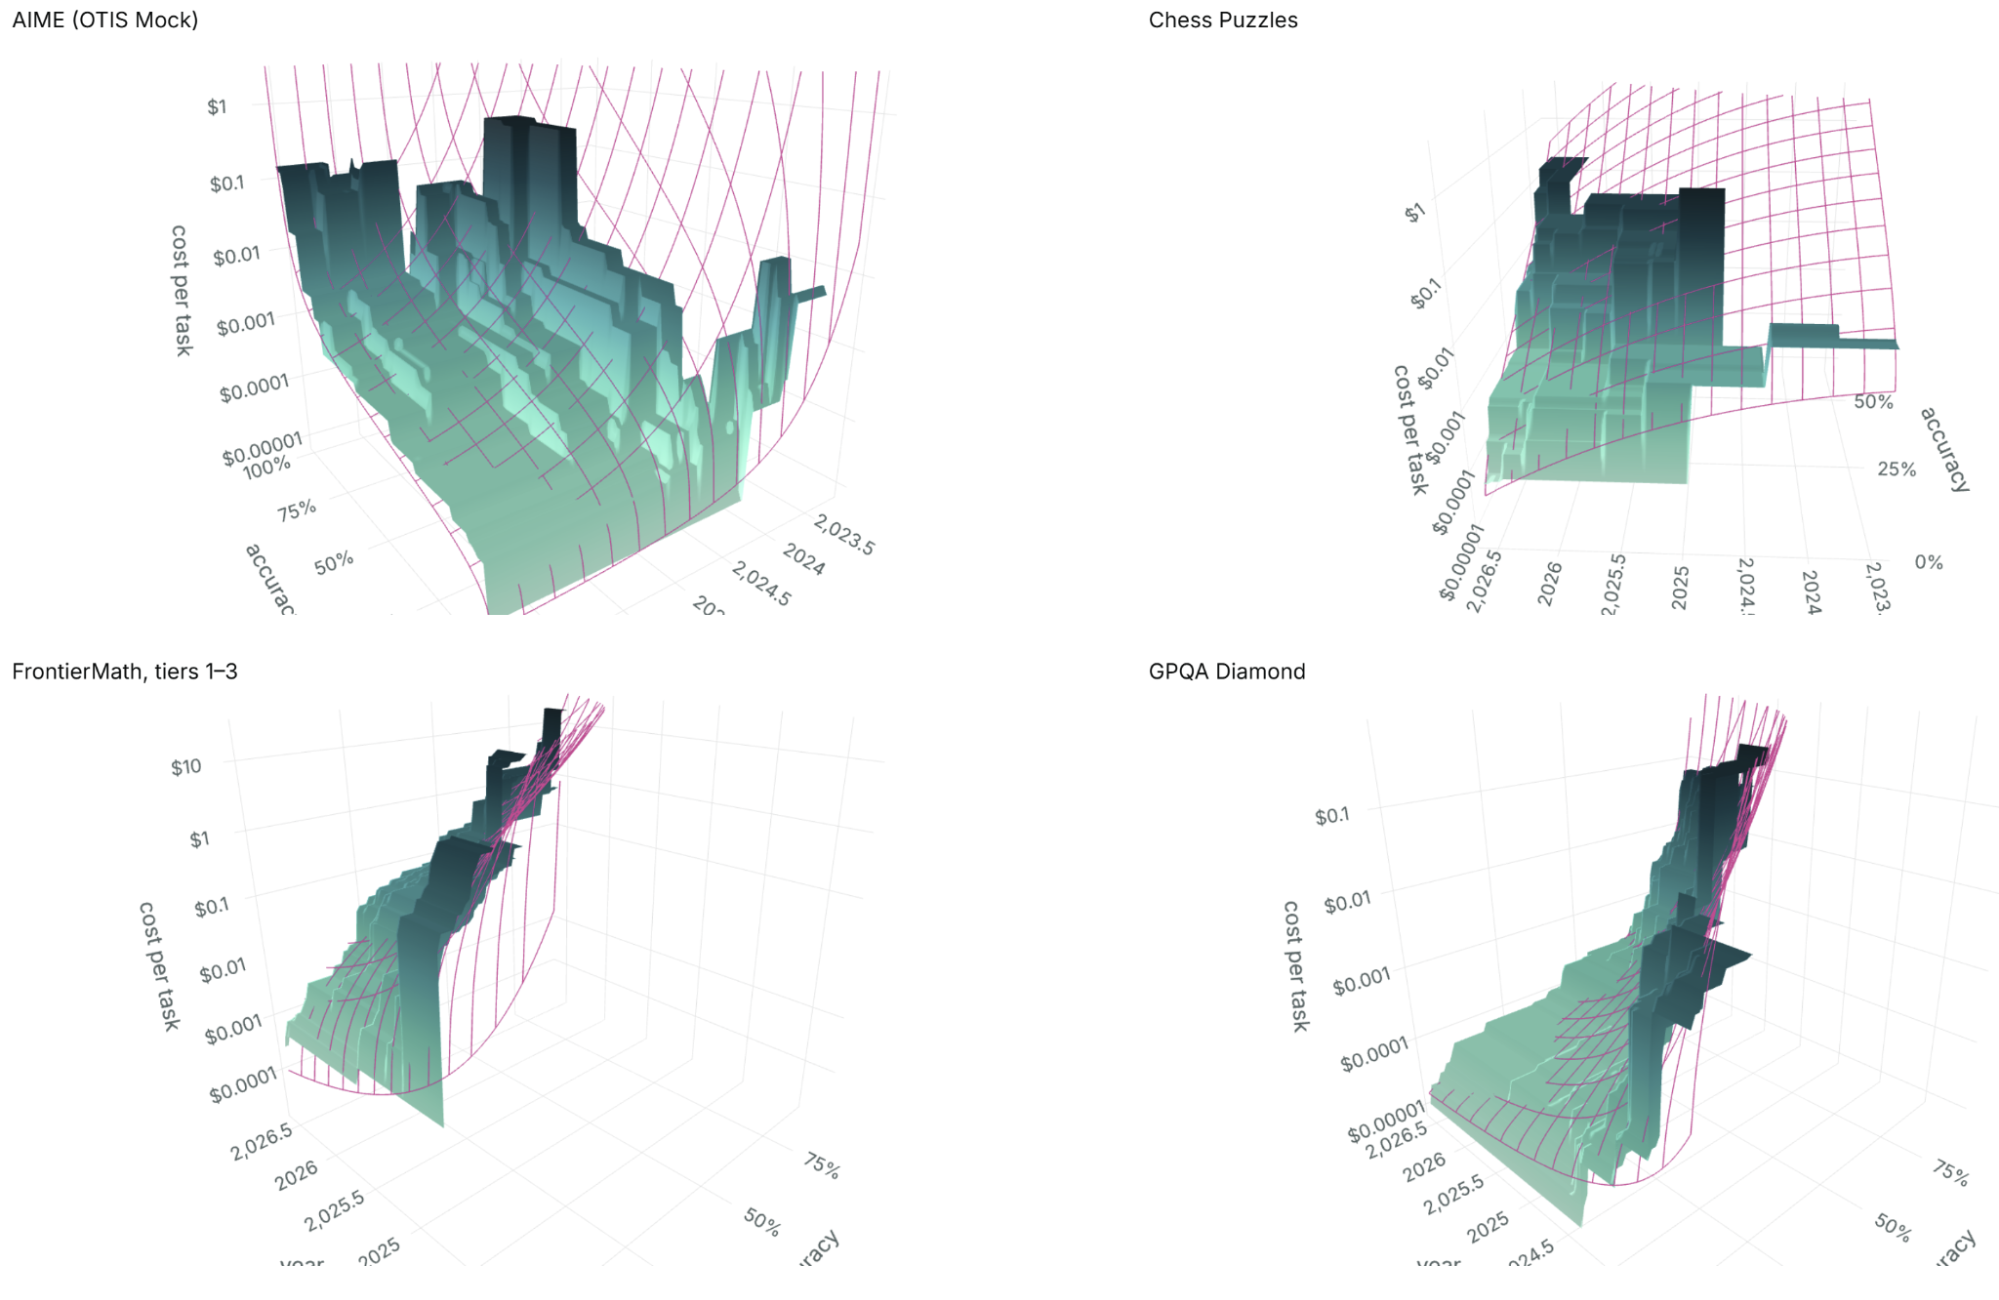
図5. 4つの主要ベンチマークにおける、さまざまな正答率水準でのコスト、パレートフロンティア曲面、フロンティアに対する滑らかな当てはめ
ブートストラップについて
フロンティアをモデル化する私たちの戦略(モデル1と2)は、ある意味で多段階である。まず経験的パレートフロンティアを計算し、次にそれにパラメトリックなモデルを当てはめる。 こうした場合には、両方の段階のノイズを反映した信頼区間をつくるため、推定の過程全体をブートストラップするのが一般的である。 しかし、ここでのブートストラップが、その複雑さに見合うほど信頼できるとは私たちは考えていない。
問題は、標準的な再標本化ブートストラップでは、各反復で一部の観測値が全データセットから2回以上抽出され、ほかの観測値はまったく抽出されないことである。 その結果、ブートストラップで得られる経験的フロンティアは、全標本のフロンティアの外側に出ることはありえず、内側にしか来ない。 この意味で、ブートストラップのデータ生成過程が実際のデータ生成過程をうまくまねているとは考えにくい。
確率的フロンティア分析の文脈でこの問題に直面した Simar and Wilson (1998) は、別のブートストラップを提案している。全データセットにモデルを当てはめたあと、モデルで推定したフロンティアに対する各生産者の非効率性を計算する。 次に、推定した非効率性の集合から復元抽出で再標本化し、新たにシミュレートした非効率性の水準を使ってブートストラップ用のデータセットを生成する。 たとえば、ある生産者の効率が90%と推定されたが、ブートストラップのある反復で80%が割り当てられた場合、一定の投入量に対するその生産者の産出は 倍に調整される。
この手法の私たちの文脈での欠点は、非効率性の分布が均一である(Simar and Wilson 2007, p. 278)、たとえば2023年と2026年でほぼ同じであると仮定している点である。 新しいLLMを市場に送り出し、ベンチマーク評価の対象に選ぶ過程がこの期間ずっと安定していると考えられるなら、この仮定にもっと自信が持てただろう。 しかし、非効率性を定義する基準となるフロンティアがこれほど速く動き、LLMの開発企業の数が急速に増え、私たち自身の標本抽出もより網羅的になりつつある状況では、均一性の仮定は大きく間違っているかもしれない。 もしそうなら、ブートストラップから導いた標準誤差は、見かけだけの精度を与えかねない。
コスト下落の推定値の取り出し方
線形のコストモデルは、時間(公開日)が対数コストに与える影響の推定値を、係数 の形で直接与える。
正答率モデルから同等のものを取り出すには、もう少し手間がかかる。 モデルの当てはめから等量曲線、つまりコストと時間の平面上で予測正答率が一定となる曲線が得られる。 この等正答率曲線に沿った動きは次の式で表される。
について解くと、各瞬間における価格変化率は次のようになる。
ここで は正答率モデルの当てはめで得た係数である。
結果
平均下落率
まず、コストの全体的な下落率の推定値に注目する。 この1次モーメントに関心が向くのは当然である。 加えて、これを推定すれば、モデルの結果をモデルを使わない平均値と照らし合わせて検証できる。
表1は、四半期あたりの平均コスト下落率の推定値を多数示している。 結果の最初の列は、上で述べたモデルをどれも使わない推定値である。 ここでは、データ空間内の点の集合について経験的なコスト下落を平均することで、モデルを使わない推定値を出している。 具体的には、コードは時間と正答率について、先にモデルの当てはめ用として説明したのと同じ格子をつくる。 各格子点 で、ベンチマークごとに、次の四半期にかけての経験的フロンティアのコスト下落比 を計算する。 次に、ベンチマークごとにこの比を幾何平均し、100%から差し引く。
5つの主要ベンチマークの下落率はかなり近く、Chess Puzzles の四半期あたり43%から FrontierMath tiers 1–3 の四半期あたり53%までの範囲にある。 その単純平均は四半期あたり47%である。
その次の列は、上で説明したコストモデルの結果を、線形版と Box-Tidwell 版について示している。 モデルにはモデルである以上、ある数学的構造を課してしまうという欠点があり、その構造が厳密に正しいことは決してない。 一方で、モデルが正しい限りにおいて、その結果はより精度が高くなる。3
2列目を見ると、経験的な対数コストフロンティアに線形モデル( と について線形)を当てはめた結果は、モデルを使わない結果とかなり近い。 最も大きな食い違いは、科学のベンチマーク GPQA Diamond での約11ポイントである。
モデルにより大きな柔軟性を与えると(時間と正答率のオッズ比に Box-Cox 変換を施し、その積も加える)、5つの主要ベンチマークでは、モデルを使わない推定値とのずれがおおむね小さくなる(表の次の列)。 このモデルは非線形なので、コストの下落率は時間と正答率に依存し、どれか一つのパラメータがコスト下落率の全体的な結論になるわけではない。 モデルの全体的な含意を凝縮するため、先ほどと同じコストと正答率の値の格子で平均をとる。 今回平均するのは、各格子点におけるコストの瞬間的な下落率についてのモデルの予測である。 Mystery Game Puzzles を除けば、全体の下落率はモデルを使わない数値に近づく。 (Mystery Game Puzzles はチェスの問題に似ているが、別のゲームを使う。AI企業がテストに向けて意図的に学習させるのを防ぐため、そのゲームが何であるかは非公開にしている。) 5つの主要ベンチマークでは、平均下落率は四半期あたり47%であり、モデルを使わない平均とぴったり一致する。
ほかのモデルの当てはめは、いま述べたものから大きく外れる。 予測されたコストフロンティアが経験的フロンティアを完全に包絡するよう要求すると、ありそうにない値が出る。たとえば、コーディング能力の指標である SWE-bench Verified では、四半期あたり2.7%(線形)や7.6%(Box-Tidwell)となる。 経験的コストフロンティア上の点だけでなく、すべてのデータをモデル化した場合(最後の2列)も、ありそうにない結果が出る。コストの上昇を意味する負の符号も多い。
表1. 正答率を固定したときの、四半期あたりの平均コスト下落率
| ベンチマーク | データ開始 | モデルなし | フロンティアをモデル化 | フロンティアをモデル化(包絡を要求) | 全データをモデル化 | |||
|---|---|---|---|---|---|---|---|---|
| モデルの次数 | 線形 | Box-Tidwell | 線形 | Box-Tidwell | 線形 | Box-Tidwell | ||
| 主要ベンチマーク | ||||||||
| AIME (OTIS Mock) | 2023-03 | 47.1% | 43.3% | 50.0% | 28.6% | 26.1% | −1.2% | 3.2% |
| Chess Puzzles | 2023-06 | 43.0% | 35.2% | 43.4% | 27.9% | 46.3% | 3.9% | 5.9% |
| FrontierMath, tiers 1-3 | 2023-11 | 53.1% | 50.5% | 52.4% | 56.6% | 60.5% | 24.0% | 24.8% |
| GPQA Diamond | 2023-03 | 47.0% | 35.8% | 49.3% | 4.4% | 26.5% | −8.4% | 9.0% |
| Mystery Game Puzzles | 2023-06 | 44.0% | 39.0% | 38.7% | 4.3% | 21.3% | 5.0% | 6.5% |
| 主要ベンチマークの平均 | 47.0% | 41.0% | 47.0% | 27.2% | 38.1% | 5.3% | 10.2% | |
| 副次ベンチマーク | ||||||||
| FrontierMath 2025-02 | 2024-05 | 43.3% | 42.5% | 48.9% | 8.7% | 19.6% | −8.0% | −6.4% |
| FrontierMath, tier 4 2025-07 | 2024-06 | 26.0% | 27.8% | 27.2% | 0.0% | 4.4% | −33.3% | −36.3% |
| FrontierMath, tier 4 v2 | 2025-01 | 65.1% | 54.4% | 76.7% | 54.4% | 73.4% | 30.3% | 49.5% |
| MATH, level 5 | 2023-06 | 51.8% | 49.2% | 57.3% | 15.0% | 37.8% | −12.0% | −7.3% |
| SimpleQA Verified | 2024-10 | 40.5% | 39.8% | 46.0% | 14.2% | 12.3% | −5.3% | −5.3% |
| SWE-bench Verified | 2024-05 | 27.5% | 25.1% | 28.4% | 2.7% | 7.6% | 1.5% | 1.7% |
パーセント値はすべて、利用できるデータの期間にわたる、あるベンチマークで一定の正答率を達成するコストの四半期あたり平均下落率の推定値である。 上段の最下行は単純平均を示す。 モデルなしの値は、ベンチマークの公開日の範囲と正答率の範囲にまたがる格子上での対数空間の平均である。正答率の範囲は、各時点でのそのベンチマークの最高水準(SOTA)以下に切り詰めている。 各格子点で、1四半期後に同等以上の性能を出せる最低コストを求め、最初のコストで割る。 これらの比の幾何平均をとり、1から差し引く。 線形のパラメトリックな結果はすべて、対数コストを説明する変数としての公開年の係数を、やはり四半期あたりに換算し直したものである。 Box-Tidwell 回帰については、格子点でのモデルが示す瞬間的な下落率を使い、ノンパラメトリックな列と同じ方法で統計量を計算している。 「フロンティアをモデル化」は、格子点上で実現した経験的フロンティアをモデル化することを意味する。 「フロンティアをモデル化(包絡を要求)」は同じことを、当てはめた曲面がどのデータ点よりも上に来ないという制約付きで行うことを意味する。 「全データをモデル化」は、フロンティアだけでなくすべての実行を OLS でモデル化することを意味する。
コスト下落率のばらつき
図4と図5、そして GitHub のページにあるより多くのグラフからは、コストと時間・正答率の関係がベンチマークによってさまざまであることがわかる。 見かけ上の多様性の一部は、柔軟なモデルを、2次のパターンを確実に特定するには時間や正答率の次元で狭すぎる標本に過剰適合させたことによる見かけの産物にすぎないかもしれない。 しかし、一部はおそらく本物である。コストの下がり方は、測っている能力によって異なるのかもしれない。
図6を見てほしい。これは4つのベンチマークについて、モデルが予測するコスト下落率をヒートマップで示したものである。 色の明るいところほど下落が速い。 モデルがデータを超えて外挿している場所がわかるよう、データ中のどのモデルがこれまでに記録した最も高い性能と最も低い性能を示す階段をグラフに重ねている。 3つのベンチマーク(AIME (OTIS Mock)、FrontierMath tiers 1–3、GPQA Diamond)では、最高水準の性能の近くでコストが最も速く下がっているように見える。 このパターンを説明しうる一つのシナリオはこうだ。SOTAを塗り替える新しいモデルが登場すると、その開発企業は短い間だけその性能に割増価格をつけられる。 しかし、オープンモデルとクローズドモデルの競合がすぐに追いつき、その性能の価格は急落する。 やがてこの動きは弱まり、下落は、割合で見ても遅くなる。
表2は、このパターンを数値で示している。 各ベンチマークについて、Box-Tidwell のコストフロンティアモデルのパラメータ推定値を示す。 その右には、ある性能水準がSOTAとして登場した時点でのモデルが示す瞬間的なコスト下落率と、その1、2、3…8四半期後の同じ値を並べている。 SOTAとして登場した時点は、フロンティアの正答率を公開日に回帰する補助的なロジスティック回帰から推定する。 また、繰り返しになるが、モデルは非線形なので、瞬間的な下落率は正答率の水準に依存する。 そこで表示している統計量は、そのベンチマークで観測された正答率の範囲に切り詰めた、等間隔の正答率の格子上での平均である。
5つの主要ベンチマークのうち3つと、副次ベンチマークのすべてで、SOTAとしての登場後にコストの下落率が下がる。 例外の Chess Puzzles と Mystery Game Puzzles では、加速はわずか数パーセントポイントにとどまる。 主要ベンチマークの平均では、下落率は、SOTA時点の四半期あたり66%から、2年後には32%へと下がる。
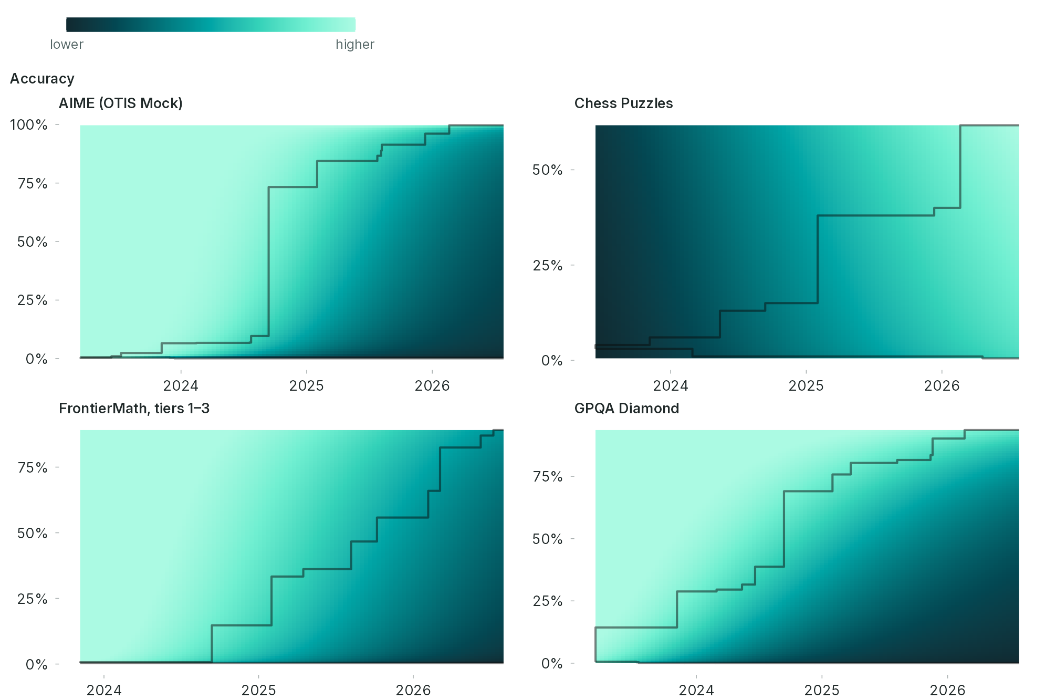
図6. 4つのベンチマークにおける、公開日と正答率に対するコスト下落率のヒートマップ(コストフロンティアの Box-Tidwell モデル)
注:黒い階段は、観測された性能の上限を時間の関数として示す。いくつかの場合には下限も示している。
表2. コストフロンティアの Box-Tidwell モデル
| ベンチマーク | 四半期あたりのコスト低下率(SOTA到達後の経過四半期別) | モデルのパラメータ | N | |||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| SOTA時点 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 切片 | BC 正答率オッズ | BC 時間 | BC 正答率オッズ × BC 時間 | λ正答率 | λ時間 | ||
| 主要ベンチマーク | ||||||||||||||||
| AIME (OTIS Mock) | 83.3% | 71.1% | 59.3% | 48.7% | 40.0% | 32.8% | 27.0% | 22.3% | 18.3% | 154 | 43.9 | −496 | −132 | 0.237 | −3.03 | 4882 |
| Chess Puzzles | 41.8% | 43.9% | 44.2% | 44.3% | 44.5% | 44.7% | 45.1% | 45.4% | 45.6% | 3.44 | 4.61 | −0.258 | −0.039 | 0.456 | 2.73 | 3735 |
| FrontierMath, tiers 1-3 | 63.6% | 57.1% | 51.5% | 46.6% | 42.3% | 38.6% | 35.5% | 32.5% | 29.8% | 86.5 | 16.7 | −173 | −28.6 | 0.216 | −1.84 | 2904 |
| GPQA Diamond | 80.7% | 71.5% | 62.5% | 54.1% | 46.5% | 39.9% | 34.0% | 28.9% | 24.6% | 37.4 | 26.3 | −88.1 | −47.7 | 0.640 | −1.77 | 5758 |
| Mystery Game Puzzles | 35.9% | 36.4% | 37.0% | 37.6% | 38.2% | 38.7% | 39.1% | 39.5% | 40.0% | 9.65 | 5.08 | −0.950 | 0.597 | 0.415 | 1.04 | 4164 |
| 主要ベンチマークの平均 | 66.3% | 58.3% | 51.8% | 46.6% | 42.4% | 39.1% | 36.4% | 34.2% | 32.4% | |||||||
| 副次ベンチマーク | ||||||||||||||||
| FrontierMath 2025-02 | 77.7% | 54.2% | 38.7% | 28.9% | 21.6% | 16.3% | 12.1% | 9.2% | 51340 | 19082 | −390252 | −145024 | 0.398 | −7.60 | 2716 | |
| FrontierMath, tier 4 2025-07 | 28.4% | 27.8% | 27.0% | 26.2% | 25.2% | 24.2% | 23.2% | 7.06 | 0.808 | −1.56 | −0.044 | −0.445 | 0.957 | 1343 | ||
| FrontierMath, tier 4 v2 | 85.3% | 79.6% | 68.6% | 51.1% | 29.6% | 30.1 | 11.5 | −8.22 | −2.80 | 0.159 | 1287 | |||||
| MATH, level 5 | 84.0% | 73.0% | 62.4% | 52.8% | 44.7% | 37.9% | 32.2% | 27.6% | 23.7% | 39.4 | 16.5 | −116 | −36.5 | 0.423 | −2.27 | 4256 |
| SimpleQA Verified | 83.6% | 62.9% | 46.1% | 33.4% | 24.5% | 18.1% | 13.3% | 31299 | 14609 | −229944 | −107297 | 0.477 | −7.34 | 3452 | ||
| SWE-bench Verified | 32.9% | 29.4% | 27.1% | 25.2% | 23.5% | 22.1% | 20.8% | 19.6% | 18.6% | 11.8 | 2.26 | −18.9 | −0.972 | 0.280 | −1.05 | 4121 |
注:推定値はすべて、時間と正答率の値の格子上でのパレートコストフロンティアについて、対数コストを、Box-Cox 変換した時間と正答率のオッズ比の変数、およびその積に回帰したものである。 ある性能水準が最高水準(SOTA)になってからの経過時間の関数として下落率を推定するため、ベンチマークごとにSOTAを時間に回帰する補助的なロジスティック回帰を行い、ある性能水準がSOTAだった時期を推定している。 SOTAとしての登場以降の各時点で、モデルが示す四半期あたりの下落率(対数ポイント)を、観測された正答率の範囲内の正答率の格子上で平均している。
限界
価格が急速に下がっているという根本的な発見は疑いようがないが、私たちの個々の推定値には大きな注意点がある。
第一に、「ベンチマーク狙い」、つまり既知のベンチマークで好成績を出すようにAIモデルを意図的に学習させることが起きている可能性がある。 主要ベンチマークの一つである Mystery Game Puzzles は、使うゲームを秘密にすることで、ベンチマーク狙いを抑えるよう設計されている。 表1では、このベンチマークの四半期あたりの下落率は44.0%(モデルなし)または38.7%(フロンティアの Box-Tidwell モデル)で、5つの平均の47.0%をやや下回る。 この結果は、ベンチマーク狙いに対する批判は妥当だが致命的ではない、という見方と整合する。
第二に、ベンチマークは役に立つ仕事の不完全な代理指標である。 したがって、私たちのコストの数値は、サービスとしてのLLMの推論実行の市場価値を不完全にしか表さない。 このすぐ後で、思考の価格の傾向を、電力などほかの変革的技術の傾向と比べる。 ただし、それらの技術については市場価格を直接観測できる。
同様に、第三に、私たちの結果は現実の経済主体の経験をそのまま表しているわけではない。 コストフロンティアにずっととどまり、明確に定めた性能水準までの各作業を最も安く実行できるモデルを探して利用可能なモデルをすべて確かめる利用者は、実質的に一人もいない。
第四に、傾向とその加速・減速を高い精度で測るには、3年分のデータは短すぎるかもしれない。
第五に、近年の実績を平均する方法は多数あり、そのどれも明らかに最適というわけではない。 図7は、向き合わなければならない選択の一つだけを示したものである。正答率の次元で平均をとるとき、とりうる範囲のどの点について平均すべきか、という選択である。4 点は、ある正答率の範囲内で等間隔にとるべきか。 それとも、正答率のロジットで等間隔にとるべきか。 そして、一般にコストフロンティアはSOTA以下でしか定義されないので、点の集合はこの上限で切り詰めるべきか、それともその範囲内に収まるよう拡大縮小すべきか。 図は、GPQA Diamond ベンチマークの場合について、この2×2通りの選択肢を示している。 ロジット空間で等間隔にとると、正答率が0や1に近いときの実績を多く抽出し、したがって重く重みづけすることになる。 SOTAで切り詰めるとSOTAが低い時期の比重が下がり、SOTAの範囲内に拡大縮小すると各時点が等しく重みづけされる。
先に述べたとおり、私たちは現在、左上の選択肢、つまり正答率空間での等間隔と切り詰めを採っている。 こうすると、正答率の次元で実績の幅が広かった時期により大きな重みがかかり、性能の両極端は強調されない。 また、格子点全体で(下落率の1に対する補数の)幾何平均をとる。 図に示すとおり、その結果、最終的な数値は四半期あたり47.0%となる。 ほかの選択肢では42.9〜58.0%となる。
最後の注意点は、一つ前のものと関連している。5 概念として、「思考の価格」は、たとえば「電力の価格」よりもあいまいである。 LLMの推論実行というカテゴリーは、大きく、しかも変化し続けるサービスの束を含んでいる。 統計家は長期のインフレを連鎖ドルで測り、物価指数の変化を計算する対象となる財とサービスのバスケットを定期的に更新している。 同じように、本レポートでは、時点・ベンチマーク・性能水準にわたって瞬間的な価格下落率を平均することで、実質的にさまざまなサービスの価格下落を連鎖させている。 概念として単一の「思考の価格」を追跡しているわけではない。
価格系列のあるほかの変革的技術は、より均質で、おそらく変化も緩やかである。 売り物のサービスとしてのヒトゲノムの解読は、おそらく、20年前と今とで違いより共通点のほうが多い。 1キロワット時の電力や電池の蓄電についても同様である。 したがって、こうした技術的な製品やサービスの価格の傾向についての記述は、より字義どおりに読める。 その限りで、AIの価格下落を、価格系列のあるほかの技術の価格下落と比べるとき、私たちは性質の異なるものを比べていることになる。
それでも、電力や電池のような技術のカテゴリーでさえ、同じ種類の概念的な複雑さを抱えている。製品には多くの種類があり、電力の価格設定は少なくとも1冊の本の主題になっている(Sen, Sengupta, and Chakrabarti 2015)。 総合的に見て、根本的に性質の異なる変革的技術であっても、その価格を推定して比べることには意味があり、有用だと私たちは考えている。 それをどう行うのが最善かは、今後も取り組むべき課題である。
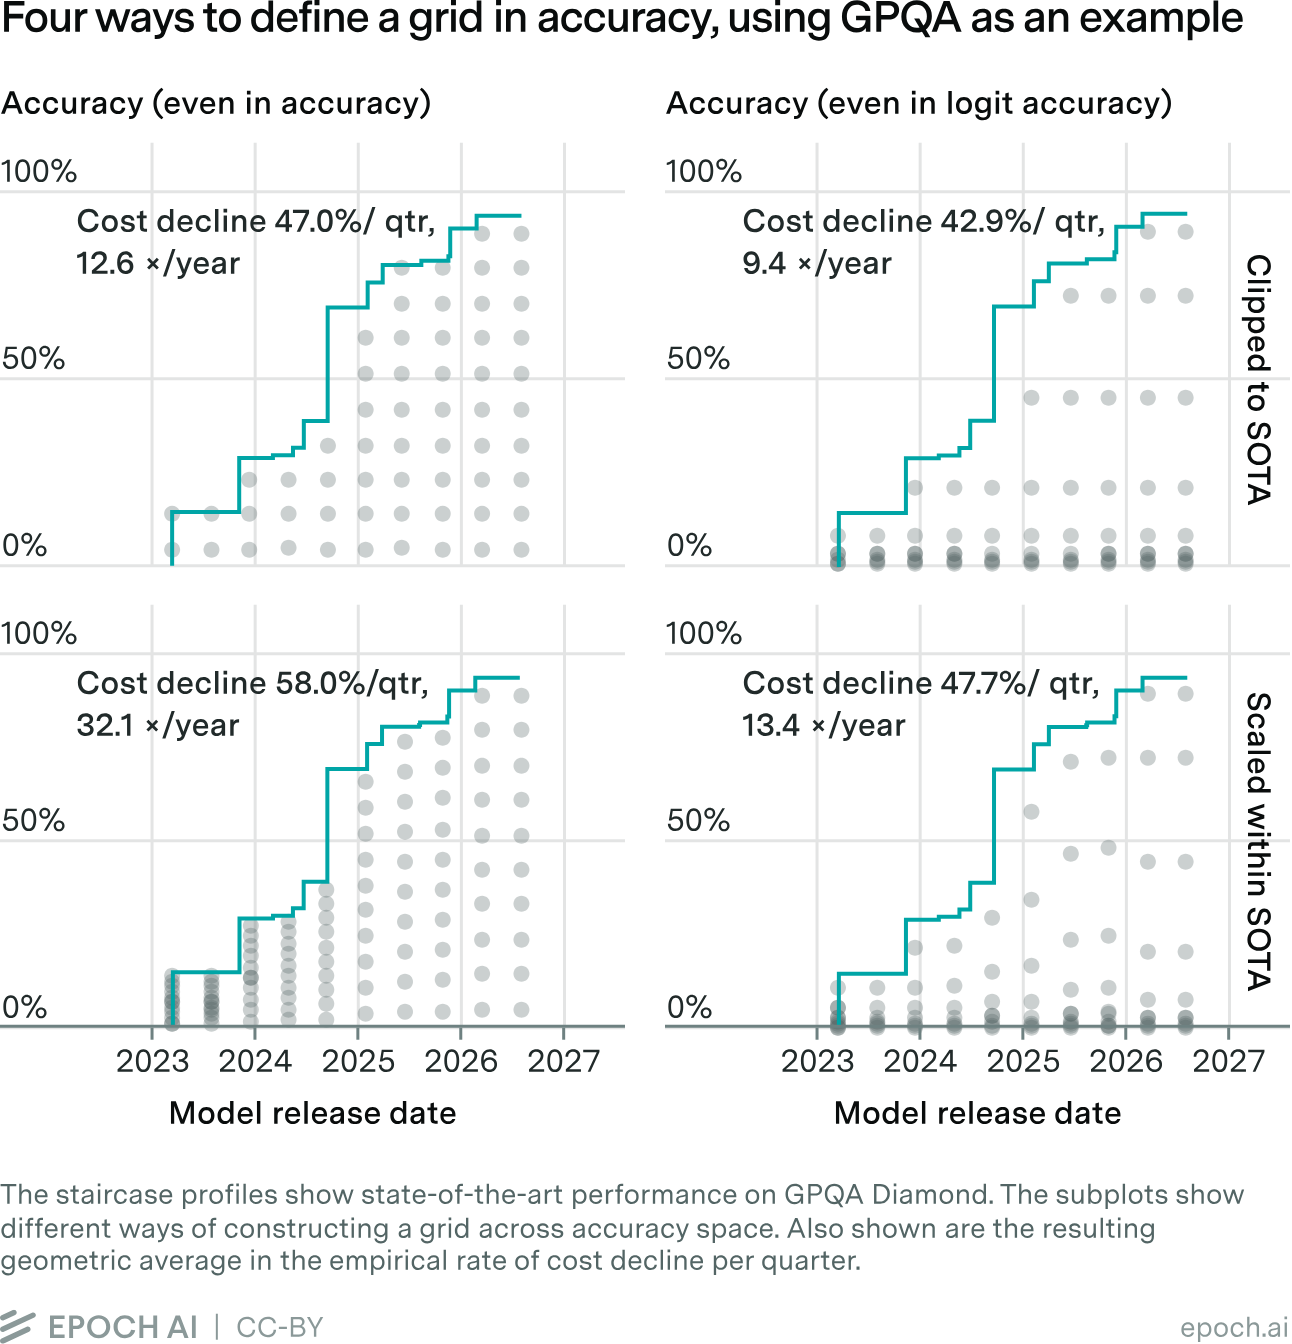
図7. 正答率の格子を定義する4つの方法(GPQA を例として)
注:階段状の輪郭は GPQA Diamond での最高水準の性能を示す。 各小図は、正答率の空間に格子をつくるさまざまな方法を示している。 それぞれの方法で得られる、四半期あたりの経験的なコスト下落率の幾何平均も示している。
考察と結論
5つの主要ベンチマークのデータは、いずれも2023年に始まる(表1を参照)。 それ以降の約3年間で、思考の価格は四半期あたり47%、つまり年13倍のペースで下がったと私たちは推定している。
さらに、商用LLMの推論実行が始まった2021年11月以来、コストがこのペースで下がってきたというのはありうることだと考えている。 「先行研究」の節で触れたように、初期の分析は、あるベンチマークで閾値を超えるスコアを取ったモデルのトークンあたり価格を調べていた。 Epoch AI が集めたデータによれば、GPT-3 は MMLU で43.9のスコアを取り、価格は100万トークンあたり60ドルだった。 2023年7月18日に公開された Meta のオープンウェイトモデル Llama 2-7B は45.3のスコアを取り、価格は100万トークンあたり0.20ドルだった。複利での価格下落率にすると年31倍である。 どちらも推論モデルではないので、この課題をこなすのに使ったトークン数は同程度だったと考える理由がある程度はある。 このことから、MMLU で43.9を取る実際のコストが少なくとも年13倍のペースで下がったという考えにも、ある程度の妥当性がある。
5年間にわたって年およそ13倍で下がったというのは、変革的技術としては史上最速である可能性が十分にある。 米国の家庭向け電力の平均価格は、1892年から1973年にかけて、複利で年1.05倍に相当する分だけ下がった。 対応する数値は、リチウムイオン電池が1991〜2024年に年1.16倍、計算資源が1940〜2001年に年1.51倍、DNA解読が2001〜25年に年1.84倍である。 (出典は本レポートの最初の図の注を、独立した分析としては Demirer, Fradkin, and Tadelis (2026) を参照。) 下落率を対数ポイントで表すと、LLMの推論実行の価格は、DNA解読の4倍、計算資源の6倍、リチウム電池の18倍、電力の54倍の速さで下がってきた。
また、多くのベンチマークで、そして5つの主要ベンチマークの平均でも、SOTAに近い性能ほど価格が特に速く下がることが観察される。SOTA時点では四半期あたり66%(年75倍)、2年後には四半期あたり32%(年4.7倍)である。
このパターンを生む業界の力学は、本レポートの範囲を超える。 それでも、LLMサービスの提供で得られる超過利潤は、どのモデルにとってもつかの間のものかもしれない、という含意は指摘しておく価値がある。 このことは、今日のAI業界における競争の力学の結果であると同時に、その原因でもあるに違いない。
興味深いことに、本レポートの2番目の図の軌跡からは、SOTA付近で最も激しい価格競争が行われてきたのはクローズドウェイトモデルどうしであることがうかがえる。 図の8本の軌跡のうち、2番目の点に当たるモデルがオープンウェイトであるのは1本だけである(AIME で25%の性能を出した QwQ-32B)。 もちろん、クローズドモデルどうしのSOTA付近での競争が、それでもオープンモデルからの圧力に後押しされている可能性はある。クローズドモデルの開発企業は、先頭にとどまろうと競い合っているからである。
付録
確率的フロンティア分析のモデル
この節では、試したが最終的に採用しなかった、密接に関連する2つのモデルについて説明する。
経済学で生産フロンティアやコストフロンティアをモデル化する確立した手法の一つが、確率的フロンティア分析(SFA)である。 私たちの場合、生産への投入はお金の一つだけだが、SFAモデルでは通常、資本と労働のように複数の投入があり、その供給はまとめて予算制約に縛られる。 ある予算のもとで、生産フロンティアは、購入可能な投入の組み合わせ全体にわたって、ありうる産出水準の範囲の外側の境界である。 現実の農場や企業の多くは、各時点の技術的な限界に対する非効率性のため、境界の内側に位置する。 しかし、測定の不正確さ(たとえば、大口の注文がある月に製造され、翌月に出荷される場合)のために、フロンティアの外側にあるように見えるものもありうる。
SFAの統計モデルでは、産出は投入の関数に、2つの誤差項を加えたものになる。 一つは従来どおりの対称な誤差項で、産出変数に入る偶然の要因をとらえる。たとえば、企業の産出がたまたま高かったり低かったりすること、あるいはそのように誤って測定されることである。 もう一つの誤差項は独特で非対称であり、個々の生産者の非効率性を表す。 この項は生産関数には負の符号で(コスト関数には正の符号で)入るので、それ自体は常に非負である。 たとえば、ある企業の非効率性が10%、別の企業が20%ということはありうるが、非効率性が–20%の企業はない。
SFAの生産モデルは次のような形になる。
対称な誤差項 は、平均0、分散 の正規分布に従うと仮定する。 非対称な非効率性の項 はいくつかの形をとりうる。ここでは、分散 の正規分布の正の半分に独立に従うと仮定する。
SFAの生産モデルの背後にあるイメージはこうだ。可能なことの限界を表すフロンティアがあり、測定上の偶然によってその外側に位置する企業もいるが、はるかに多くの企業は内側にいる。 そして企業は効率を追求しているので、内側からフロンティアに近づくにつれて企業の密度が高まる。 このイメージからすると、データには、はっきりしているが急に途切れる尾根があることになる。 それがはっきり現れていれば、モデルの当てはめによって2つの誤差項、つまり理論上のフロンティアから外れる2つの原因を検出し、分離できる。
産出(ベンチマークでの性能)に上限があるので、私たちのモデル化の状況はSFAの伝統の中では珍しい。 そこで、上限のあるSFAの変種を推定する。
これを最大化すべき目的関数(対数尤度)として表すには、 を積分消去する必要がある。 もし各企業の非効率性 が不確かな確率変数ではなく既知であれば、モデルの当てはめの間 を一定に保つことができ、これは標準的なロジスティックモデルになる。 すべての観測値の対数尤度の和を最大化する を求めることで当てはめられる。 つまり、次の式を最大化することになる。
ここで は、すべての を所与としたときの対数尤度を意味する。6 実際には は分散 の半正規分布に独立に従うと仮定しているので、それを条件としない対数尤度は、上の式の のとりうる値にわたる期待値になる。
ここで は半正規分布のもとでの確率密度である。
実は、最大化しているのはこの目的関数そのものではない。 モデルの当てはめを安定させるため、 は各実行で同じだと仮定している。ここで実行とは、CAISI の方法に従ってさまざまな予算上限をシミュレートすることで、1回の完全な実行から合成したデータ点の集合を指す。 つまり、 は実行レベルの変量効果である。 そこで、実行を 、個々の観測値を で添え字づけると、正確な対数尤度は次のようになる。
積分は(非適応型の)数値求積で推定する。 最適なパラメータを探す反復探索の精度と速度を上げるため、私たちは Claude にコードを書かせ、パラメータの各試行値において、すべてのパラメータについての の勾配を計算できるようにした。
おそらく意外ではないだろうが、この工夫は結局、説得力のある結果を生まなかった。表A-1のモデル化結果の最初の2列を参照してほしい。モデルの当てはめは理論上は動くフロンティアを検出できるかもしれないが、実際には、フロンティアの動きが速すぎ、その後ろに残るベンチマークテストの分布がまばらすぎて、モデルが2つの誤差成分を確実に区別できないようだ。 たとえば、チェスパズルのベンチマークでは、モデルは時間がたってもほとんど進歩がないという結果を出す。これは数学的に退化した結果のように見える。 ほかの推定値は負である。
基本のSFAモデルの変種も一つ試した。 これは、生産フロンティアが時間とコストの空間を猛スピードで進むにつれて、古いモデルをすべて含む利用可能なモデルの分布がその後ろにますます広く散らばっていく、というイメージから着想を得たものである。 そこでこのモデルでは、 が公開日に依存することを許す。 具体的には、 を定数と の線形関数とする。 この変更でも事態は改善しない。同じ表の該当する列を参照してほしい。
正答率モデル
本文で述べたように、コストと時間のどちらもモデルの従属変数でない場合でも、両者の関係についての含意を取り出すことはできる。 表A-1の最後の2組の列は、正答率フロンティアのロジスティックモデルに基づく結果を、包絡の制約なしと制約ありで示している。 結果は妥当に見える。 しかし、特に線形モデルの結果は、モデルを使わない平均値や、コストモデルからの対応する推定値よりも高い。
表A-1. 正答率を固定したときの、四半期あたりの平均コスト下落率(採用しなかったモデル)
| ベンチマーク | データ開始 | モデルなし | コストモデル:確率的フロンティア分析 | 正答率モデル | |||||||
|---|---|---|---|---|---|---|---|---|---|---|---|
| 基本形 | 非効率性の散らばりが時間とともに変化 | フロンティアをモデル化 | フロンティアをモデル化(包絡を要求) | ||||||||
| モデルの次数 | 線形 | Box-Tidwell | 線形 | Box-Tidwell | 線形 | Box-Tidwell | 線形 | Box-Tidwell | |||
| 主要ベンチマーク | |||||||||||
| AIME (OTIS Mock) | 2023-03 | 47.1% | −9.6% | −9.8% | −9.9% | −10.4% | 68.4% | 51.7% | 75.8% | 70.1% | |
| Chess Puzzles | 2023-06 | 43.0% | 6.7% | 5.8% | 8.1% | 6.7% | 57.4% | 32.5% | 52.0% | 30.2% | |
| FrontierMath, tiers 1-3 | 2023-11 | 53.1% | 26.8% | 25.4% | 27.0% | 34.5% | 71.5% | 71.5% | 71.1% | 61.5% | |
| GPQA Diamond | 2023-03 | 47.0% | −10.2% | −10.6% | −10.4% | −10.7% | 61.0% | 45.2% | 79.9% | 63.7% | |
| Mystery Game Puzzles | 2023-06 | 44.0% | −8.9% | −10.9% | −9.3% | −11.0% | 55.3% | 55.9% | 48.5% | 45.8% | |
| 主要ベンチマークの平均 | 47.0% | 2.1% | 1.1% | 2.3% | 3.7% | 63.3% | 53.2% | 67.8% | 56.4% | ||
| 副次ベンチマーク | |||||||||||
| FrontierMath 2025-02 | 2024-05 | 43.3% | −54.4% | −95.3% | −143.0% | −10.0% | 57.2% | 53.2% | 60.5% | 48.6% | |
| FrontierMath, tier 4 (2025-07) | 2024-06 | 26.0% | −231.4% | −30.6% | −361.4% | −317.8% | 64.8% | 59.4% | 50.3% | 78.2% | |
| FrontierMath, tier 4 v2 | 2025-01 | 65.1% | 26.6% | 32.0% | 26.7% | 32.2% | 78.7% | 21.0% | 84.3% | 49.1% | |
| MATH, level 5 | 2023-06 | 51.8% | −22.1% | −3.8% | −108.7% | −79.2% | 70.3% | 59.0% | 81.8% | 56.0% | |
| SimpleQA Verified | 2024-10 | 40.5% | −30.2% | −5.1% | −40.1% | −5.1% | 60.6% | 17.3% | 99.0% | 17.6% | |
| SWE-bench Verified | 2024-05 | 27.5% | −3.1% | −3.7% | −3.7% | 35.9% | 21.0% | 40.3% | 16.5% | ||
表1の注を参照。確率的フロンティア分析は、フロンティアと、その周りの実行の分布を、非効率性の半正規分布でモデル化する。 正答率モデルの列では、正答率が従属変数で対数コストが説明変数なので、下落率は として取り出す。ここで と は、モデルの当てはめが示す傾きを格子全体で平均したものである。
注
-
問題は4択なので、当て推量だけで4分の1は正解すると期待できる。 ここで75%というのは、その期待される最低点から満点までの75%の位置にあるスコアを指す。 実際の数値は81.25%である。↩
-
Artificial Analysis はベンチマーク評価のトランスクリプトを提供していないので、Gundlach et al. と違って、私たちはこのデータ源を使えない。↩
-
2次元のデータセットが本当に古典的な線形モデル(直線に独立な誤差項を加えたもの)によって生成されているなら、その構造を組み込んだモデルを当てはめて直線の傾きを推定するほうが、さまざまな点の間の傾きを多数計算して平均するよりも精度が高くなる。↩
-
この問題は、微積分の無限小の言葉で定式化し直すこともできる。↩
-
厳密には、これは を正規分布とする仮定から、ロジスティック累積分布関数に従うとする仮定へ移ることを意味する。 正規分布に基づくモデルである分数プロビットのほうが、理論的な基礎は明確である。中心極限定理により、部分的に無相関な確率過程が混ざり合うと自然に正規分布が生じるからである。 しかし、この文脈ではロジスティック分布が広く使われており、実際にはこの違いが問題になることはまれである。↩