
レポート
スケーリング則の文献レビュー
原題:Scaling laws literature review
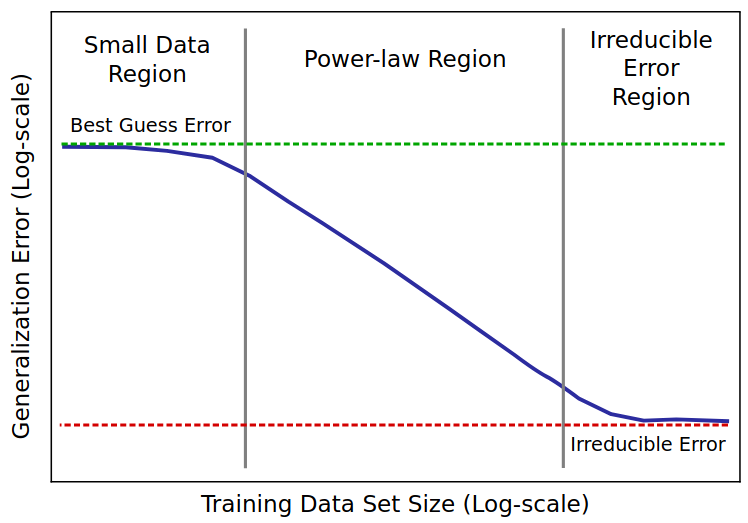
スケーリング則の一般的な形。Hestness et al. (2017) より。
要旨
- スケーリング則とは、モデルの規模と、性能やその他の有用な性質との間にある予測可能な関係である。
- さまざまなタスクとアーキテクチャのスケーリング則を集めたデータベースを作り、スケーリング則に関する数十本の論文をレビューした。
- 主な結論は次のとおりである。
スケーリング則の一覧表の全体はこちら。
はじめに
深層学習における「スケーリング則」という言葉は、関心のある機能的な性質(通常はテスト損失や、ファインチューニングのタスクでの何らかの性能指標)と、アーキテクチャや最適化過程の性質(モデルの大きさ、幅、学習計算量など)との関係を指す。こうした法則は、深層学習モデルの設計と学習の指針となるだけでなく、その根底にある原理についての洞察も与えてくれる。
この文書では、既知のスケーリング則をまとめた詳細な表と、深層学習のスケーリングの理解に各論文が果たした貢献の要約を示す。
この文書の主な目的は、深層学習のスケーリング則に関する情報を網羅し、最新の状態に保った資料となることだ。さまざまなスケーリング則を調べた論文を選んで一覧にし、既知のスケーリング則をまとめた詳細な表と各論文の貢献の要約を示す。それによって、深層学習のスケーリングについての現在の知見に触れやすく、理解しやすくすることを目指している。
論文は次の基準で選んだ。
- 発表時期:最近の論文に絞り、2015年より前の研究は除外する
- 貢献:次のいずれかの形で貢献している論文を含める。
- 実証的なスケーリング則を報告している
- より良い関数形やフィッティング手法を提案している
- スケーリングの振る舞いを説明する理論モデルを提案している
- スケーリングの振る舞いを、モデルのより低レベルな性質と結びつけている
概観
機械学習モデルのスケーリングの振る舞いは長く研究されてきたが(たとえば Statistical Mechanics of Learning from Examples)、深層学習モデルのスケーリングについての実証研究が広く知られ、実践に取り入れられるようになったのは、ごく最近のことだ。
以前の理論的な分析では、テスト損失は学習データのべき乗則 に従って減少し、その指数は または になると予測されることが多かった。しかしこれは実証的な結果と食い違う。実際には、スケーリングの指数は通常 より小さい。
現代のスケーリング則の研究は、Hestness et al. (2017) に始まると言ってよいだろう。この研究は、いくつかの異なる分野で、学習データの量に対してテスト損失がべき乗則に従ってスケールすることを実証的に見いだした。Hestness et al. (2019) では、この結果を使って、重要な性能の節目に到達するのに必要なモデルとデータセットの大きさの増加を予測した。
その直後、Rosenfeld et al. (2020) は、モデルとデータの大きさについての結合誤差関数 を構築し、この形で実証的な誤差の地形を正確に再現できることを示した。
2020年から2021年にかけて、スケーリング則についての理解は大きく広がった。
- Henighan et al. (2020) は、より多くのタスクとアーキテクチャでスケーリング則を見いだした。
- Kaplan et al. (2020) は、はるかに大きな規模でそれを検証した。
- Sharma et al. (2020)、Hutter (2021)、Bahri et al. (2021) は、スケーリングの指数の値の背後にある理論的な仕組みを提案した。
- Hernandez et al. (2021)、Mikami et al. (2021)、Abnar et al. (2021) は、転移学習の設定でのスケーリング則を調べた。
さらに最近では、この分野でいくつか意外な結果が出ている。それらを見ると、特に下流の性能について、以前に見いだされたスケーリング則は予想されていたほど普遍的ではないようだ。
- Hoffmann et al. (2022) は、より良いハイパーパラメータの選び方を見つけ、より大きな規模で検証した結果、Kaplan et al. (2020) が見いだしたスケーリング則が最適ではなかったことを明らかにした。
- Sorscher et al. (2022) は、少なくとも一部のタスクでは、損失がデータセットの大きさに対してべき乗則ではなく指数関数的にスケールしうることを示した。
- Tay et al. (2022) は、別の目的関数で少量の事前学習を追加することで、下流の性能を劇的に向上させた。
- Caballero et al. (2022) は、スケーリング曲線の傾向の折れ目を、より小さい規模のデータから簡単には予測できないことを見いだした。
加えて、グッドハートの法則が働く現象(Gao et al. 2022)など、ほかの性質についてもスケーリング則が見いだされており、高レベルのスケーリングとモデルの低レベルな特徴との結びつきもさらに明らかになってきている。
結論
上流の損失
非常に幅広いアーキテクチャとタスクで、直接学習の場合のテスト損失は予測可能な形でスケールする。初めはランダムな推測と同等の損失から始まり、べき乗則の領域を経て、削減不能な損失で頭打ちになる。これはパラメータ、データ、計算量のいずれのスケーリングにも当てはまり、学習率のスケジュールなど一部の例外を除いて、アーキテクチャとハイパーパラメータの選択にあまり左右されない。
ランダムな推測からべき乗則の領域への最初の移行と、べき乗則の領域から最後の頭打ちへの移行を除けば、損失は関数形 でよく近似できる。こうした移行をモデル化する方法はいくつか考えられるが、実証的には、Alabdulmohsin et al. (2022) の M4 推定量
と、パラメータの数はかなり多いものの、Caballero et al. (2022) の BNSL 推定量が最良のようだ。
転移と下流の正解率
直接学習については「規模さえあればよい」がおおむね正しいように見えるが、転移学習となると、下流の性能は、対象のタスクと、アーキテクチャおよびハイパーパラメータの選択に決定的に左右される(Tay et al., 2022)。上流と下流のタスクが似ていれば、下流の損失は上流の損失からかなりよく予測できるが、二つのタスクが大きく異なる場合はそうではない(Abnar et al., 2021)。
理論的な分析
これまでに見つけた中で最も説得力のある理論的な分析は、Sharma et al. (2020) と Bahri et al. (2021) である。これらの研究では、スケーリングの指数の大きさが、データ多様体の内在次元に反比例することが、実証的にも理論的にも示されている。
付録:論文のレビュー
レビューしたすべての論文の要約はこちらを参照。
参考文献
- Abnar, Samira, et al. Exploring the Limits of Large Scale Pre-Training. arXiv, 5 Oct. 2021. arXiv.org, https://doi.org/10.48550/arXiv.2110.02095.
- Alabdulmohsin, Ibrahim, et al. Revisiting Neural Scaling Laws in Language and Vision. 2, arXiv, 1 Nov. 2022. arXiv.org, https://doi.org/10.48550/arXiv.2209.06640.
- Ardalani, Newsha, et al. Understanding Scaling Laws for Recommendation Models. arXiv, 17 Aug. 2022. arXiv.org, https://doi.org/10.48550/arXiv.2208.08489.
- Bahri, Yasaman, et al. Explaining Neural Scaling Laws. arXiv, 12 Feb. 2021. arXiv.org, https://doi.org/10.48550/arXiv.2102.06701.
- Bansal, Yamini, et al. Data Scaling Laws in NMT: The Effect of Noise and Architecture. arXiv, 4 Feb. 2022. arXiv.org, https://doi.org/10.48550/arXiv.2202.01994. 6 Caballero, Ethan, et al. Broken Neural Scaling Laws. arXiv, 10 Nov. 2022. arXiv.org, https://doi.org/10.48550/arXiv.2210.14891.
- Droppo, Jasha, and Oguz Elibol. Scaling Laws for Acoustic Models. arXiv, 11 June 2021. arXiv.org, https://doi.org/10.48550/arXiv.2106.09488.
- Gao, Leo, et al. Scaling Laws for Reward Model Overoptimization. arXiv, 19 Oct. 2022. arXiv.org, https://doi.org/10.48550/arXiv.2210.10760.
- Ghorbani, Behrooz, et al. Scaling Laws for Neural Machine Translation. 1, arXiv, 16 Sept. 2021. arXiv.org, https://doi.org/10.48550/arXiv.2109.07740.
- Gordon, Mitchell A., et al. “Data and Parameter Scaling Laws for Neural Machine Translation.” Proceedings of the 2021 Conference on Empirical Methods in Natural Language Processing, Association for Computational Linguistics, 2021, pp. 5915–22. ACLWeb, https://doi.org/10.18653/v1/2021.emnlp-main.478.
- Henighan, Tom, et al. Scaling Laws for Autoregressive Generative Modeling. arXiv, 5 Nov. 2020. arXiv.org, https://doi.org/10.48550/arXiv.2010.14701.
- Hernandez, Danny, et al. Scaling Laws for Transfer. arXiv, 1 Feb. 2021. arXiv.org, https://doi.org/10.48550/arXiv.2102.01293.
- Hestness, Joel, et al. Deep Learning Scaling Is Predictable, Empirically. arXiv, 1 Dec. 2017. arXiv.org, https://doi.org/10.48550/arXiv.1712.00409.
- Hoffmann, Jordan, et al. Training Compute-Optimal Large Language Models. arXiv, 29 Mar. 2022. arXiv.org, https://doi.org/10.48550/arXiv.2203.15556.
- Hutter, Marcus. Learning Curve Theory. arXiv, 8 Feb. 2021. arXiv.org, https://doi.org/10.48550/arXiv.2102.04074.
- Jones, Andy L. Scaling Scaling Laws with Board Games. arXiv, 15 Apr. 2021. arXiv.org, https://doi.org/10.48550/arXiv.2104.03113.
- Kaplan, Jared, et al. Scaling Laws for Neural Language Models. arXiv, 22 Jan. 2020. arXiv.org, https://doi.org/10.48550/arXiv.2001.08361.
- Mikami, Hiroaki, et al. A Scaling Law for Synthetic-to-Real Transfer: How Much Is Your Pre-Training Effective? arXiv, 8 Oct. 2021. arXiv.org, https://doi.org/10.48550/arXiv.2108.11018.
- Neumann, Oren, and Claudius Gros. Scaling Laws for a Multi-Agent Reinforcement Learning Model. arXiv, 29 Sept. 2022. arXiv.org, https://doi.org/10.48550/arXiv.2210.00849.
- Ramasesh, Vinay Venkatesh, et al. Effect of Scale on Catastrophic Forgetting in Neural Networks. 2022. openreview.net, https://openreview.net/forum?id=GhVS8_yPeEa.
- Rosenfeld, Jonathan S., et al. A Constructive Prediction of the Generalization Error Across Scales. arXiv, 20 Dec. 2019. arXiv.org, https://doi.org/10.48550/arXiv.1909.12673.
- Rosenfeld, Jonathan S. Scaling Laws for Deep Learning. 1, arXiv, 17 Aug. 2021. arXiv.org, https://doi.org/10.48550/arXiv.2108.07686.
- Seung, H. S., et al. “Statistical Mechanics of Learning from Examples.” Physical Review A, vol. 45, no. 8, Apr. 1992, pp. 6056–91. APS, https://doi.org/10.1103/PhysRevA.45.6056.
- Sharma, Utkarsh, and Jared Kaplan. A Neural Scaling Law from the Dimension of the Data Manifold. arXiv, 22 Apr. 2020. arXiv.org, https://doi.org/10.48550/arXiv.2004.10802.
- Sorscher, Ben, et al. Beyond Neural Scaling Laws: Beating Power Law Scaling via Data Pruning. arXiv, 15 Nov. 2022. arXiv.org, https://doi.org/10.48550/arXiv.2206.14486.
- Tay, Yi, Mostafa Dehghani, et al. Scaling Laws vs Model Architectures: How Does Inductive Bias Influence Scaling? arXiv, 21 July 2022. arXiv.org, https://doi.org/10.48550/arXiv.2207.10551.
- Tay, Yi, Jason Wei, et al. Transcending Scaling Laws with 0.1% Extra Compute. arXiv, 16 Nov. 2022. arXiv.org, https://doi.org/10.48550/arXiv.2210.11399.
- Zhai, Xiaohua, et al. Scaling Vision Transformers. arXiv, 20 June 2022. arXiv.org, https://doi.org/10.48550/arXiv.2106.04560.