
レポート
GPU性能の予測
要旨
本稿では、トランジスタがおよそシリコン原子1個の大きさまで縮小したあとはそれ以上微細化できないと仮定し、電界効果トランジスタを用いるGPUの性能の進歩を予測する単純なモデルを作る。このモデルは、性能モデル(GPUの性能がそのGPUの特徴量とどう関係するかのモデル)と特徴量モデル(微細化の物理的限界による制約のもとで、GPUの特徴量が時間とともにどう変化するかのモデル)を組み合わせたものである。どちらのモデルも、2006年から2021年に発売された1948個のGPUのデータセットに当てはめている。その結果、進歩のほぼすべてはトランジスタの大きさとコア数という2つの変数で説明できることが分かった。関連文献をもとに物理的限界を見積もると、モデルは、トランジスタの縮小が止まることによって、GPUの進歩がおよそ2027年から2035年のあいだに止まると予測する。限界に達したとき、現在の電界効果トランジスタによるGPUは、パラダイムを変えるような技術的進歩がなければ、単精度で1e14〜1e15 FLOP/sの理論ピーク性能に達すると見込まれる。
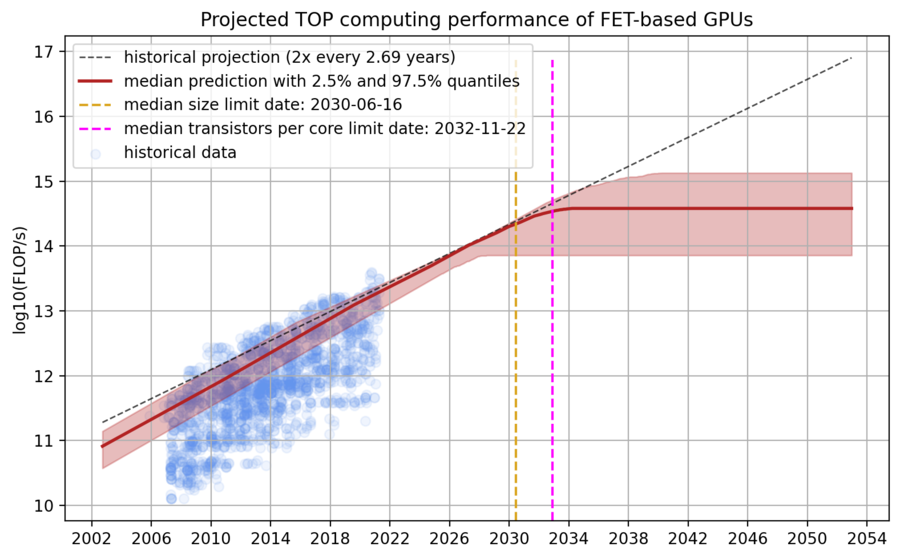
図1:トランジスタが約0.7nmまで縮小したあとはそれ以上微細化できないと仮定した場合の、最上位GPUの理論ピーク性能のモデル予測。左:GPU性能の予測。右上:限界に達したときのGPU性能。右中:トランジスタ微細化の物理的限界についての確率分布。右下:コアあたりのトランジスタ数についての確率分布と、関連する過去の比較値。
GPUの性能と効率の向上には、ほかにも多くの要因(メモリの最適化、利用率の改善など)があるが、これまではトランジスタの縮小が大きな要因であり、おそらく最大の要因であった。したがって本稿の結果は、長く続いてきた電界効果トランジスタのパラダイムのもとでは、2030年代半ばごろにGPUの性能向上が大幅に難しくなることを強く示唆している。
はじめに
電界効果トランジスタ(FET)が1桁ナノメートルの規模に近づくにつれ、トランジスタがそれ以上の微細化を阻む物理的限界に突き当たることはほぼ確実である。文献ではさらなる微細化に対するさまざまな制約が論じられてきた。たとえば熱雑音電圧(Kish, 2001)、フォトレジスト工程の不完全さや光子のランダムなばらつきに起因する信頼性の制約(Neisser, 2021)、量子トンネル効果(Markov et al., 2019、Frank et al., 2001)などである。こうした制約は、微細化による持続的な性能向上がいつ終わるかの見通しの根拠になってきた。たとえば2022年版のIRDSロードマップは「グラウンドルールの縮小は2028年ごろに減速し、飽和すると予想される」としており、同様の予測はほかでも示されている(たとえばDammel, 2021やBurg, 2021)。
一方、トランジスタに対する物理的制約が許す限界で、ハードウェアがどこまで強力になりうるかははっきりしない。Intelは社内の分析にもとづき、2030年ごろにはチップが1e15 FLOP/sを実行できるようになると予測している(Kelleher, 2022)。Veedrac, 2021は、物理面と製造面のさまざまな制約を検討し、トランジスタ密度の20〜100倍の向上はおそらく達成可能だと論じている。どこまで行けるかは、配線と電力のオーバーヘッドを最小限に抑えたダイの積層を3D集積で実現できるかどうかによるという。Cotra (2020)は、トランジスタの縮小、ハードウェアの専用化、そのほかの経済的な効率改善など、ハードウェアの価格性能比を高める複数の要因を検討したうえで、計算資源の価格(具体的には計算の償却コスト)の改善は、2020年比でおよそ6桁に達したところで頭打ちになると論じている。
本稿では、トランジスタの縮小に対する物理的制約を組み込んだ、ハードウェア性能の形式的なモデルを示す。構成は次のとおりである。まず、性能モデル(GPUの性能がそのGPUの特徴量とどう関係するかのモデル)と特徴量モデル(微細化の物理的限界による制約のもとで、GPUの特徴量が時間とともにどう変化するかのモデル)からなる、GPU性能の単純なモデルを示す。次に、トランジスタ微細化の物理的限界を論じ、トランジスタの主要な寸法が0.7nmまで縮んだ時点か、それより前に、微細化はおそらく止まると論じる。そのうえで推定値を説明し、今後30年間についてモデルが予測するGPU性能(FLOP/s)を示す。最後に、本研究の限界を論じる。
GPU性能の単純なモデル
GPU性能の予測には、2つの単純なモデルを組み合わせて用いる。1つ目は、GPUの性能をその特徴量(トランジスタの大きさ、コア数など)と結びつけるモデルである。2つ目は、これらの特徴量の過去のトレンドを延長し、トランジスタの縮小に対する物理的限界を考慮に入れるモデルである。
を、時点 における、特徴量がベクトル で与えられるチップの性能(ピークFLOP/sの対数。FP32、テンソルコアを除く)とする。 は次のようにモデル化する。
ここで は、特徴量では説明できない性能のばらつきを捉える誤差項である。さらに、チップの特徴量が時間とともにどう変化するかについて、物理的限界を組み込んだ2つ目のモデルを定める。
ここで は、トランジスタの縮小に対する物理的限界から導かれる の限界値のベクトル、 は時間とは無関係に生じる特徴量のばらつきを捉える誤差項である。この2つのモデルを別々に推定し、組み合わせて予測値 を得る。これは単に次の式で与えられる。
こうして、ハードウェア性能の推移を表す単純なモデルができる。このモデルは、チップの特徴量とハードウェア性能の関係を考慮し、物理的限界から導かれる特徴量の限界の情報も組み込んでいる。以下の節でモデルの設定を説明し、付録でより詳しく述べる。
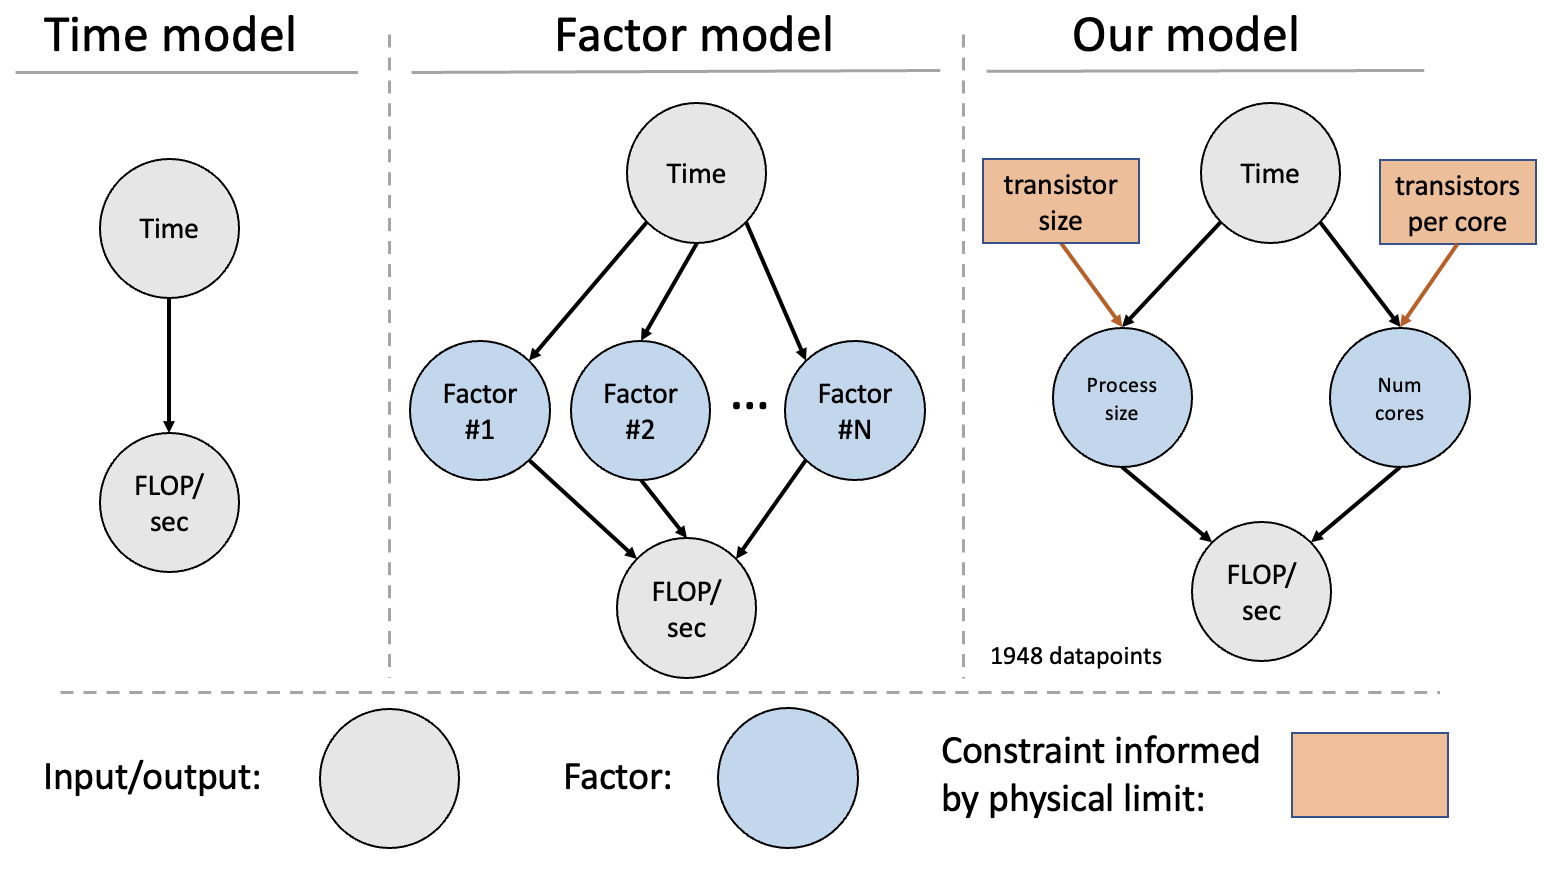
図2:GPU性能をモデル化するさまざまな手法の概観。本稿では、2つの変数(プロセスサイズとコア数)による因子モデルを選び、微細化の限界を組み込む。
特徴量とモデルの選択
選びたいのは、FLOP/sに因果的な効果をもち、その要因の変化が実際にFLOP/sの変化につながる特徴量である。そこで21の候補から出発し、次の要件で絞り込む。
- 特徴量がGPU性能を予測でき、その特徴量とFLOP/sのあいだに因果関係があること。特徴量の値が増えるとなぜFLOP/sが増えるのかを、よく理解された因果関係で説明できなければならない(FLOP/sの結果であったり、FLOP/sと共通の原因をもっていたりするのではなく)。
- 特徴量そのものが比較的予測しやすいこと。具体的には、時間とともに予測どおり規則的に改善し、かつ各時点でのばらつきが小さい(同時期のGPUがその次元で互いに似ている)特徴量を優先する。そうした特徴量なら、将来のGPUの特性をより確信をもって予測できる。
- 立証責任は、除外ではなく採用の側にある。過学習は分布外での性能を大きく損ないうるので、より単純なモデルを優先する。そのため、モデル選択にはベイズ情報量規準(モデルの複雑さを強く罰する)を用いる。
詳しくは付録A:特徴量の選択を参照してほしい。これらの要件を満たす特徴量は6つあった。コア数、プロセスサイズ(nm)、GPUクロック(MHz)、帯域幅(GB)、メモリクロック(MHz)、メモリ容量(MB)である。CPUとGPUのクロック速度は、もう何年もわずかしか上がっていないか、横ばいである。そのため、進歩の2つの主な要因はトランジスタの大きさとコア数であり、クロック速度はそれほど重要ではないと考える。最初の3つの特徴量は一次変数(特徴量が増えると性能が直接向上する)、残りの3つは二次変数(特徴量が増えても必ずしも性能は向上しないが、一次変数のスケーリングを支える)とみなす。
より単純なモデルを好むのは、解釈しやすく、データに過学習して予測が悪化するおそれも小さいからである。どの特徴量を含めるかは、ベイズ情報量規準(BIC)にもとづいて選ぶ。その結果、性能モデルがデータに最もよく当てはまるのは、トランジスタの大きさ1とコア数の2つの特徴量を使ったときだった。さらに、多くの要因は互いに強く相関しているため、特徴量を追加すると、関連する係数の推定値の誤差範囲も広がった。そこで、3つ以上の成分は加えないことにした。
すべての成分について、対数線形の当てはめ(たとえばlog(feature) ~ time)を基準とし、多項式や線形より緩やかな増加の当てはめと比べた。その結果、どの場合も、より複雑なモデルのいずれも、基本の対数線形モデルに比べて目に見える改善(決定係数の0.01の増加で測る)を示さなかった。そこで、すべての成分について最も素直な対数線形モデルを使うことにした。詳しくは付録Bを参照してほしい。
GPUの大きさ、特にダイサイズは時間とともに大きくなっており、本モデルはそれを明示的には考慮していない、という反論もありうる。しかし私たちは次のように考える。a) コア数はトランジスタの縮小よりも速く増えているので、ダイサイズはすでにコア数の中で暗に考慮されている。b) 仮に考慮されていなかったとしても、ダイサイズが大きくなっても予測される限界性能はあまり上がらない。c) GPUを大きくすれば性能は上がるかもしれないが、価格性能比は上がらない。そして計算資源の進歩にとって最終的に重要なのは、ある意味で価格性能比である。これらの論点の詳しい分析は付録Eに示す。
トランジスタ微細化の物理的限界
電界効果トランジスタの大きさの物理的限界については、これまで複数の推定がある(付録Cの表を参照)。本稿の予測では、FETの微細化の限界について事前分布を置く(図3を参照)。この範囲は、トランジスタの物理的限界に関する既存研究を調べて得た範囲(おおよそ0.7nmから3nm)と一致する。ただし、純粋な概念実証にとどまる結果(たとえば単原子層のFinFET)にはあまり重みを置いていない。そうした結果では、信頼性と性能の問題が量産の大きな障害になると考えられるからである。
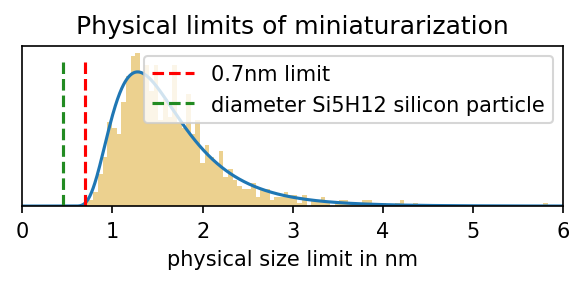
図3:本モデルで用いる微細化の限界についての分布。分布のパラメータは、私たちが0.7nmを越えられない境界とみなしていることを反映し、かつ確率質量の大部分が3nmより小さくなるように選んだ。mu=0、sigma=0.5の対数正規分布を、右に0.5ずらして用いる。
これまでのところ、プロセスサイズとトランジスタの最小寸法は非常に強く相関しており、どちらを外挿しても予測はほとんど変わらなかった(図4と付録Dを参照)。予測の要因としてプロセスサイズを使い続けることにした理由は2つある。第一に、トランジスタの最小寸法がプロセスサイズより良い指標だとは言い切れない。小さいほうの寸法が限界に達したからといって、大きいほうの寸法も限界に達したとは限らない。第二に、FinFETを用いるGPUのデータ点はごくわずかしかない。そのため、それにもとづく予測は誤解を招くか、不正確になるおそれがある。したがって本稿の以降の部分では、「プロセスサイズ」をトランジスタの大きさの近似と考えてよい。
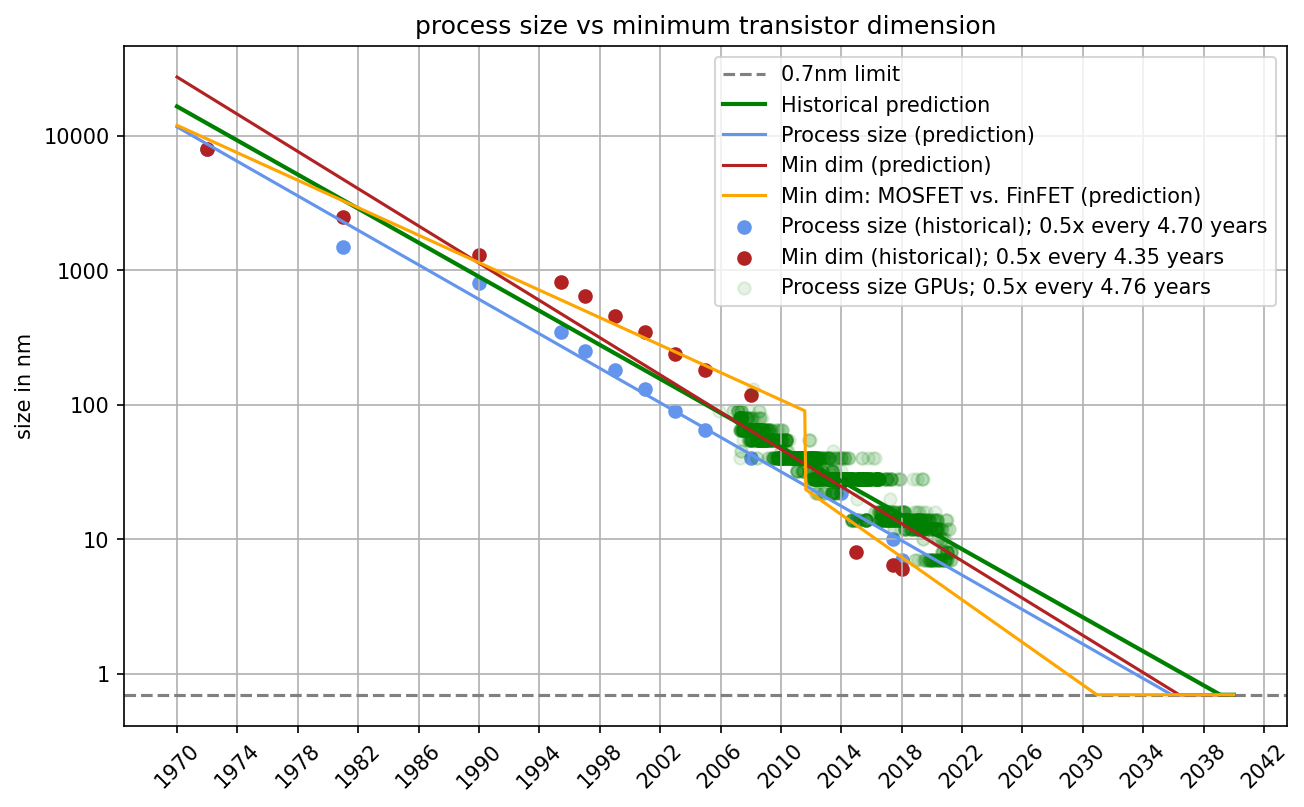
図4:プロセスサイズとトランジスタの最小寸法の比較。MOSFETとFinFETを区別しても、両者はよく似た縮小の仕方をしている。したがって本稿の以降の部分では、プロセスサイズをトランジスタの大きさのまずまずの近似として使えると結論する。
コア数の限界
トランジスタの大きさが物理的限界に達すると、それ以上の微細化はできなくなる。しかし、チップ上のコア数を増やすことはまだ可能であり、並列計算の効果が高まることで性能が上がる。トランジスタ数が増えなくなっても、コア数は、高性能なコアを作るのに必要なトランジスタ数の限界に達するまで増え続けると考えられる。
コアあたりのトランジスタ数については、本データセットをもとに事前分布を置く(図5を参照)。具体的には、コアあたりのトランジスタ数の最小値はこれまで60万個であり、機械学習(ML)に使われるGPU(ワークロードは一般に高度に並列である)でのこの比の最小値は240万個程度である。2
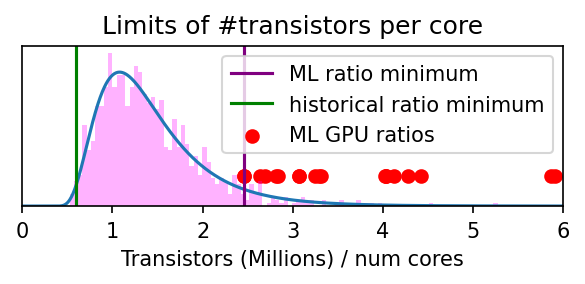
図5:前の図の情報をもとに、コアあたりのトランジスタ数の限界についての最善の見積もりを反映した分布を作った。この限界は、現在の最先端のML向けGPUで実現されている値よりおそらく低く(それらのGPUはおそらくこの比について最適化されていないため)、過去の最小値よりは少し高いと考える。パラメータmu=0.3、sigma=0.5の対数正規分布を用いる。
予測
最上位(TOP)GPUの性能は、2つの限界、すなわちトランジスタの大きさの物理的限界とコアあたりのトランジスタ数を考慮した、過去のデータの分位点回帰から予測する。具体的には、log10(process size) ~ timeモデルには5パーセンタイルの分位点回帰を当てはめ(トランジスタが小さいほど性能が高いため)、log10(number of cores) ~ timeモデルには95・90・85・80パーセンタイルの分位点回帰を当てはめた。そのうえで、この4つの回帰から一様にサンプリングする。コア数のモデルに複数の分位点回帰を当てはめたのは、それらの傾きが(切片だけでなく)異なり、どの傾きを優先すべきかの強い理由がないからである。この2つの回帰による予測値を、性能モデルに入力する。さらに、トランジスタ微細化の限界とコアあたりのトランジスタ数の限界の分布からサンプルを取り、それに応じて予測を調整する。この手順を1000回繰り返すと、次の図に示す予測の分布が得られる。詳しくは付録Bを参照してほしい。
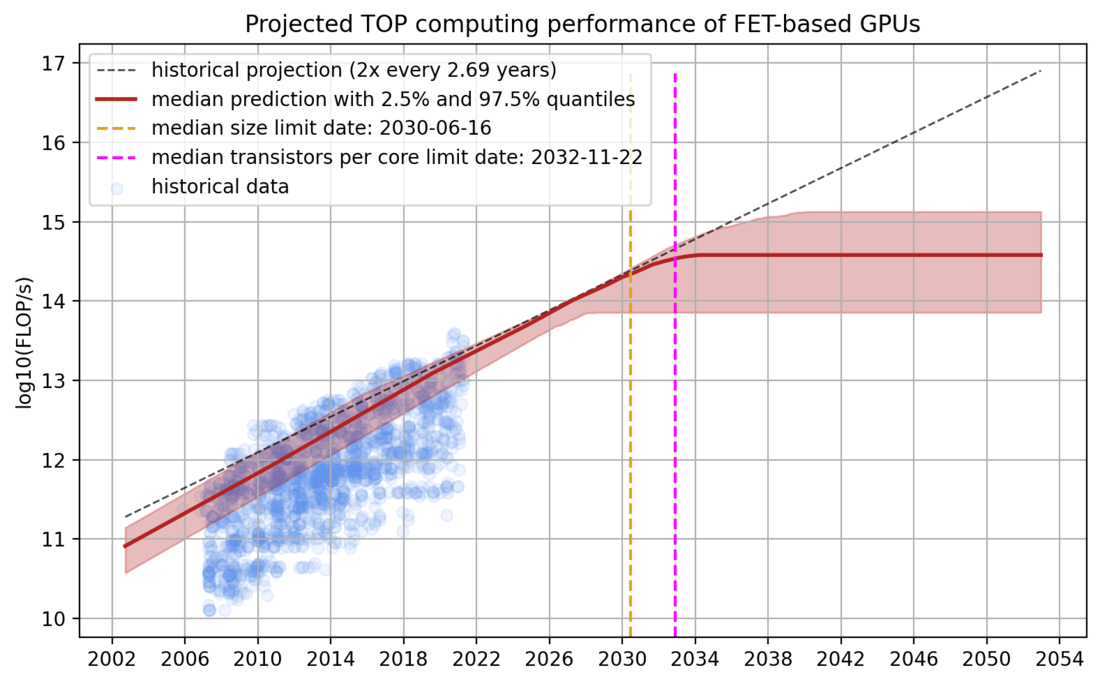
図6:TOP GPUの性能の予測の分布。過去のトレンドの線は、データセットの90パーセンタイル回帰による。モデルの予測では、2つの限界に達する時期の中央値は約2030年と約2033年であり、限界性能は1e14〜1e15 FLOP/sである。
予測される軌道にはどれも2つの折れ目がある。1つ目はトランジスタの大きさが物理的限界に達した時点、2つ目はコアあたりのトランジスタ数をそれ以上減らすと性能が落ちる時点である。2つ目の限界に達したあと、予測される軌道は平らになる。本モデルが考慮する2つの要因からは、それ以上進歩する道がなくなるからである。
本モデルの予測では、2つの限界に達する時期の中央値は2030年と2033年である。さらに、性能の限界には2027年から2035年のあいだに達し、そのときの最大性能は1e14〜1e15 FLOP/sである。価格が一定で償却期間が3年だと仮定すると、電界効果トランジスタによる限界のGPUでは、1ドルあたりのFLOPは1e22 FLOP/$から1e23 FLOP/$のあいだになる。3
限界
本研究は多くの仮定を置いており、それが次のような限界につながっている。
- トランジスタの大きさは、過去15年と同じように推移し続けると仮定している。しかし、この速度が落ちると考える理由もありうる。たとえば、研究開発費が指数関数的に増え続けることはできない、アイデアが見つかりにくくなっている、などである。
- 大きさ以外の限界については何も主張しない。特に熱の放散は明示的には考慮していない。ただし、限界の分布の根拠とした推定の一部には、熱の放散による限界が暗に含まれている。
- この予測は、現在のGPUのパラダイムにしか当てはまらない。量子コンピューティングやニューロモルフィック・コンピューティングのような別のパラダイムについては、何も主張しない。
- 3Dのチップ設計によってGPU性能が向上する可能性は考慮していない。
- コアあたりのトランジスタ数の下限は、これまでに見られたコアあたりトランジスタ数の最小値とおおよそ同じだと仮定している。しかし、微細化ができなくなれば、コンピュータアーキテクトはコアあたりのトランジスタ数を過去の限界より減らすことに力を注ぐかもしれない。
- 性能を落とさずにコア数を少なくとも数桁増やせると仮定している。これは、機械学習のアルゴリズムを大規模に並列化できることを前提としている。現在の機械学習の進歩の大半は並列化にもとづいているものの、これが正しいかどうかは確信がない。
付録
A. 特徴量の選択(詳細)
本データセットには、GPUとCPUの進歩に関する約150の特徴量が含まれる。そのうち、GPUの進歩の予測に関係する見込みが十分にある(と私たちが判断した)21の特徴量を選んだ。さらに、次の方法でこれらを最も重要なものに絞り込む。
FLOP/sとの相関
最初の選択基準として、特徴量とFLOP/sの相関を測る。相関係数が-0.5から0.5のあいだにある特徴量は、すべて候補から外す。強い予測変数なら、予測対象の変数とそれなりに相関しているはずだという考えによるが、この閾値そのものは結局のところ恣意的である。
この相関は、データのさまざまな変換について計算する。すなわち、次の図でnum_shading_unitsを例に示すように、線形とlog10のすべての組み合わせである。
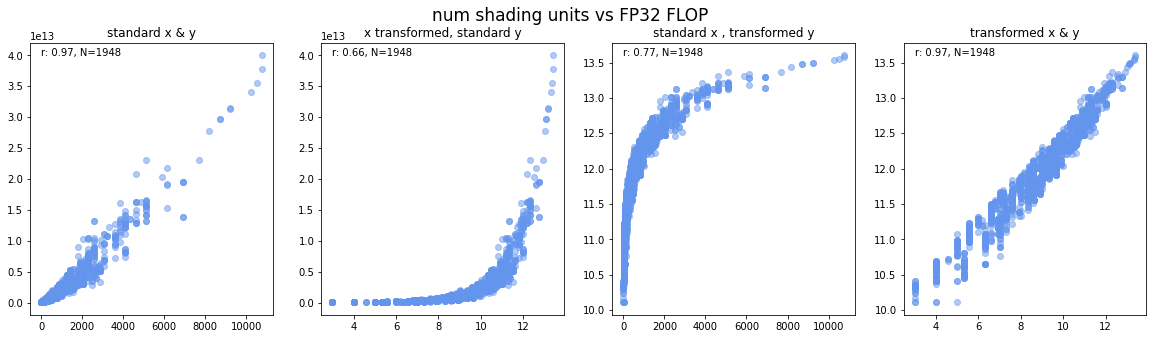
図7:データのさまざまな変換における、特徴量と性能(FLOP/s)の相関。シェーディングユニット数の例では、両方の変数を対数変換したときに最もよく当てはまるようである。
この手順のあと、16の変数が残った。除外したすべての場合について、採用につながる明らかな変換を見落としていないか、データを目でも確認した。
時間との一貫した相関
最終的には遠い将来まで予測したいので、どの変数も時間と一貫して相関していなければならない。たとえば、時期が後になるほど一貫してlog10(num_cores)が増える、といった具合である。これを操作的に定めるため、線形モデルlog(feature) ~ timeを作り、決定係数が0.3未満の変数をすべて除外する。対数線形モデルを使うことで、特徴量のばらつきが特徴量の軸ではなく時間の軸に沿ったものであることも保証される。次の図に、シェーディングユニット数が時間とともにどう変化するかの例を示す。
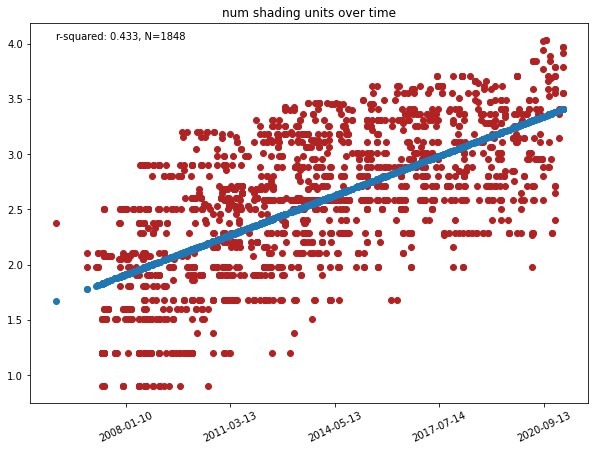
図8:シェーディングユニット数の推移。時間とともに一貫して増えており、望ましい基準の1つを満たしている。
この手順のあと、9つの変数が残った。除外したすべての場合について、採用につながる明らかな変換を見落としていないか、データを目でも確認した。
因果関係の特定
作りたいのは、GPUの今後の進歩を予測するモデルである。そのため、選んだどの特徴量についても、FLOP/sを増やすもっともらしい因果の筋道があることを確かめる必要がある。具体的には、残った9つの変数について次のようになる。
- Num_cores:コアが多いほど並列化が進み、FLOP/sが増える
- GPU_clock_in_MHz:周波数が高いほど、直接FLOP/sが増える
- process_size_in_nm :トランジスタが小さいほどGPUあたりのトランジスタが増え、FLOP/sが増える
- bandwidth_in_GBs:帯域幅のボトルネックはFLOP/sのボトルネックになりうる
- memory_clock_in_MHz:メモリクロックのボトルネックはFLOP/sのボトルネックになりうる
- memory_size_in_MB:メモリ容量のボトルネックはFLOP/sのボトルネックになりうる
- Transistors_in_millions(除外):トランジスタが多いほどFLOP/sは増えるが、トランジスタ数はトランジスタが小さくなったことの下流の結果である。そのためprocess_sizeと強く相関するので、この変数は除外する。
- Num_shading_units(除外):シェーディングユニットは、ビデオゲームなどでシェーディングの性能を高めるための専用ユニットである。num_shading_units → FLOP/sという因果の筋道はないので、除外する。
- Num_compute_units(除外):コンピュートユニットが多いほどおそらくFLOP/sは増えるが、これは実質的にnum_coresの上位分類である。num_coresのほうが重要な変数だと考えるので、num_compute_unitsは除外する。
残った変数
これまでの除外基準をすべて通過した候補変数は6つ残った。これらは2つの区分に分けられると考える。
一次変数:変数が増えると、直接FLOP/sの増加につながる変数である。具体的には、num_cores、process_size_in_nm、GPU_clock_in_MHzである。
二次変数:低すぎるとFLOP/sを制限しうるが、増やしても直接FLOP/sの増加にはつながらない変数である。たとえば、帯域幅が低いと実効FLOP/sは下がるが、ある閾値を超えると、帯域幅を増やしても実効FLOP/sは増えない。具体的には、bandwidth_in_GBs、memory_clock_in_MHz、memory_size_in_MBである。
これらの変数は互いに強く相関している。このことは、最終的なモデルの構築に影響する。
| GPU_clock_in_MHz_log10 | num_cores_log10 | process_size_in_nm_log10 | memory_size_in_MB_log10 | memory_clock_in_MHz_log10 | bandwidth_in_GBs_log10 | |
| GPU_clock_in_MHz_log10 | 1.00 | 0.58 | -0.60 | 0.52 | 0.61 | 0.46 |
| num_cores_log10 | 0.58 | 1.00 | -0.64 | 0.82 | 0.69 | 0.85 |
| process_size_in_nm_log10 | -0.60 | -0.64 | 1.00 | -0.76 | -0.70 | -0.64 |
| memory_size_in_MB_log10 | 0.52 | 0.82 | -0.76 | 1.00 | 0.64 | 0.80 |
| memory_clock_in_MHz_log10 | 0.61 | 0.69 | -0.70 | 0.64 | 1.00 | 0.69 |
| bandwidth_in_GBs_log10 | 0.46 | 0.85 | -0.64 | 0.80 | 0.69 | 1.00 |
B. モデルの選択
この節では、モデルの構築をより詳しく説明する。
非線形の当てはめの検証
残った6つの変数について、対数データへの線形の当てはめが関連するトレンドをすべて捉えているかを確かめたかった。そこで、それぞれのモデルの当てはまりを、線形+2乗、線形+対数、線形+平方根の当てはめと比べた。どの場合も、線形の基準モデルに比べて有意な改善は見られなかった。
さらに、予測モデルに2つ目の項を加えると、たいてい将来についてありえない予測になった。たとえば対数項を加えると、将来、軌道が現在の性能水準を下回って低下していくことになる。これは明らかにありえないので、すべての場合に対数データへの線形の当てはめを使うことにした。
本稿のモデル
残った6つの変数を組み合わせて、複数のモデルを作った。いずれの場合も、変数の組み合わせからFLOPを予測し、決定係数で当てはまりを比べる。まず各変数を単独で使い、次に一次変数の組み合わせと全変数の組み合わせを見た。
モデル:
| 説明変数(X) | 決定係数 | BIC |
|---|---|---|
| GPU_clock | 0.475 | 1343 |
| num_cores | 0.936 | -1281 |
| process_size | 0.508 | 2708 |
| memory_size | 0.729 | 1271 |
| memory_clock | 0.565 | 2051 |
| bandwidth | 0.802 | 755.2 |
| GPU_clock, num_cores, process_size | 0.947 | -1211 |
| GPU_clock, num_cores | 0.947 | -1218 |
| num_cores, process_size | 0.950 | -1753 |
| GPU_clock, process_size | 0.531 | 1224 |
| GPU_clock, num_cores, process_size, memory_size, memory_clock, bandwidth | 0.968 | -1665 |
全変数を使うと全体として最もよく当てはまる(決定係数で測った場合)が、本稿の以降ではnum_cores+process_sizeをモデルとして使うことにする。この選択には次のような理由がある。
- num_cores+process_sizeは、全変数を組み合わせた場合よりわずかに劣るだけであり、BICはより良い。
- 予測変数どうしの相関が非常に高い(前の節を参照)。そのため、変数を多く組み合わせるほど予測の誤差が大きくなる。
- すべてのデータ点にGPU_clockの値があるわけではない。そのため、GPU_clockを含むモデルは、num_cores+process_sizeよりやや劣る。GPU_clockを含めると、使えるデータ点はおよそ半分になる。
- num_coresとprocess_sizeがなぜGPUの進歩の中心的な要因であり、今後もそうであり続けるのかについて、明確な因果の筋道を示せる。
解釈しやすく信頼できるモデルを求めているので、この選択に落ち着いた。したがって本稿のモデルは、次の線形モデルの組み合わせになる。
- 因子モデル:log(num_cores) ~ time と log(process_size) ~ time
- 最終モデル:log(FLOP) ~ log(num_cores) + log(process_size)
トランジスタの大きさの物理的限界のモデル化
トランジスタの大きさは、いずれ物理的限界に達すると考える。本稿の見積もり(次の節を参照)では、この限界はおよそ0.7nmであり、シリコン原子の大きさにごく近いと論じる。熱や量子トンネル効果などのために、それより早く限界に達する可能性もあると考えるが、本稿では越えられない境界をモデル化したい。限界のさまざまな例を、次の図に示す。
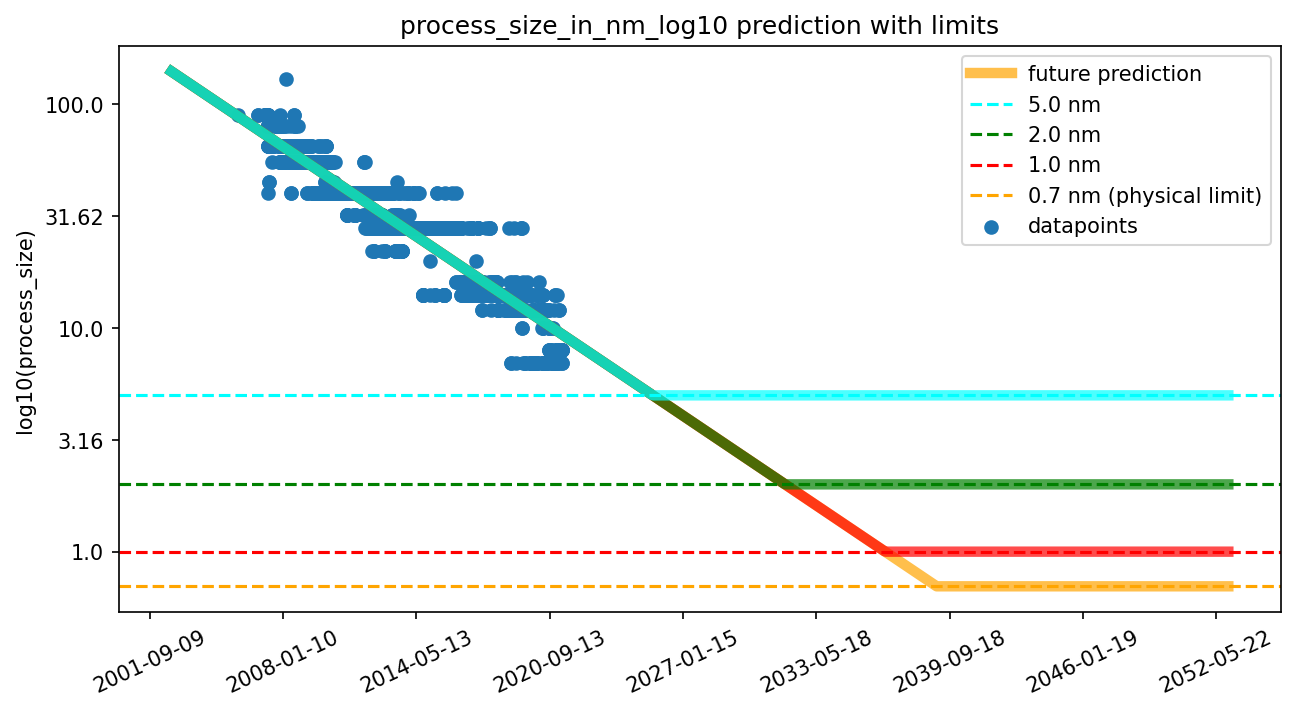
図9:過去のプロセスサイズ(トランジスタの大きさの代理指標)から、さまざまな物理的限界を置いて行った予測。
境界についての不確実性を取り込むため、次の図に示すように、限界がとりうる値の対数正規分布からサンプリングする。分布のパラメータは、限界が現在の水準より小さく、かつ示唆されている物理的限界より大きくなるように選んだ。興味深いことに、この分布は、量子トンネル効果について予測されている限界である1〜3nmとも合致する。
図10:本モデルで用いる、微細化の物理的限界についての分布。分布のパラメータは、私たちが0.7nmを越えられない境界とみなしていることを反映し、かつ確率質量の大部分が3nmより小さくなるように選んだ。
実際には、過去のトレンドからプロセスサイズの今後の軌道を予測し、限界に達する日付を定める。その日付以降の値はすべて限界値に固定する。つまり、トランジスタの微細化はその時点で止まると仮定する。
コアあたりのトランジスタ数の限界のモデル化
微細化の壁に達したあとも、コアを増やすことで性能の進歩の一部を補えると考える。ただし、その時点ではトランジスタの縮小は止まっているので、コア数を増やせば、必然的にコアあたりのトランジスタ数は減る。この過程はやがて、性能を落とさずにはコアあたりのトランジスタ数をそれ以上減らせない、もう一つの限界に達すると考える。
これまで、この比はコアあたり60万個から4000万個のトランジスタの範囲にあった。最先端の機械学習実験に使われてきたGPUでは、コアあたり260万個から1200万個であった(下図を参照)。
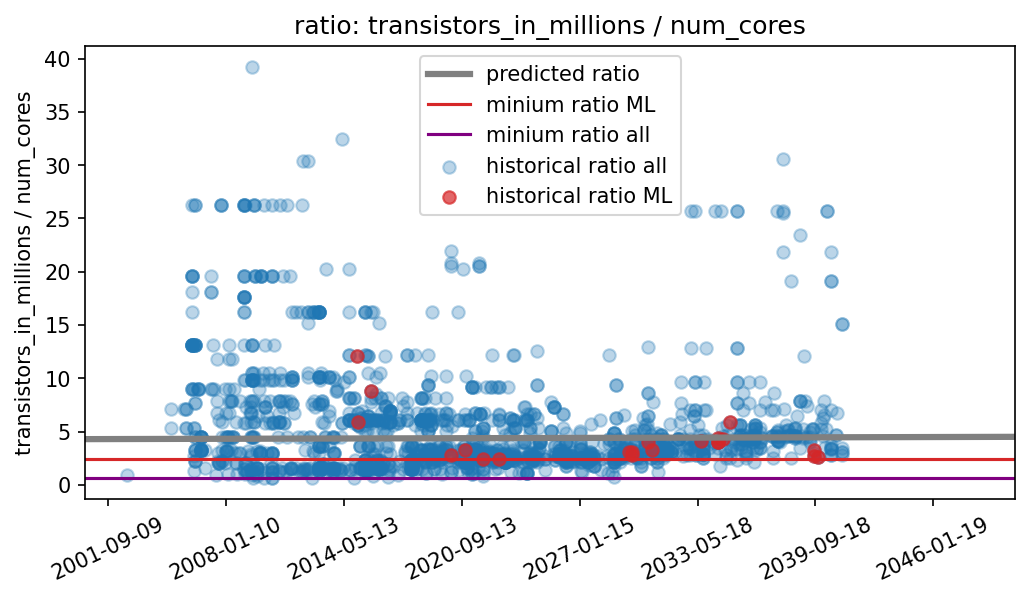
図11:本データセットのすべてのGPUにおける、コアあたりのトランジスタ数の比。過去に大規模な機械学習実験に使われたGPUを強調表示し、特定の点で外れ値になっていないかを確かめたが、基本的には他のすべてのGPUと同様のトレンドに従っていると考える。さらに、全GPUの最小比、ML向けGPUの最小比、線形モデルによる予測比を示す線を加えた。
したがって、この限界は過去の限界と現在のML向けGPUの限界のあいだのどこかにあると考える。ただし、正確な物理的制約は分からないので、本モデルには過去の制約の範囲外の値も含めている(次の図を参照)。
図12:前の図の情報をもとに、コアあたりのトランジスタ数の限界についての最善の見積もりを反映した分布を作った。この限界は、現在の最先端のML向けGPUで実現されている値よりおそらく低く(それらのGPUはおそらくこの比について最適化されていないため)、過去の最小値よりは少し高いと考える。
この制約は、コアあたりのトランジスタ数に下限を設ける2つ目の限界を加えることで、モデルに組み込む。
1つのモデルへの統合
本稿で主にモデル化したいのは、TOP GPU、すなわち性能の最高水準を更新したGPUの性能である。加えて、ほかに考えられる予測についての分析を2つ行う。1つは中央値のGPUについて、もう1つはMOSFETとFinFETを別々にモデル化した場合の中央値のGPUについてである。これらの分析の重要性はずっと低いと考えるが、頑健性の検証として興味深いとみている。
いずれの場合も、モデルには2つの折れ目が見られる。1つ目の折れ目は、予測がそれぞれの物理的限界に達した時点である。1つ目の折れ目のあとは、それ以降の進歩はGPUにコアを加えることだけで決まる。2つ目の折れ目は、コアあたりのトランジスタ数の限界に達した時点である。そのあとは、両方の限界に達しているので、軌道は平らになる。次の図の予測軌道は、2つの折れ目の例を示している。
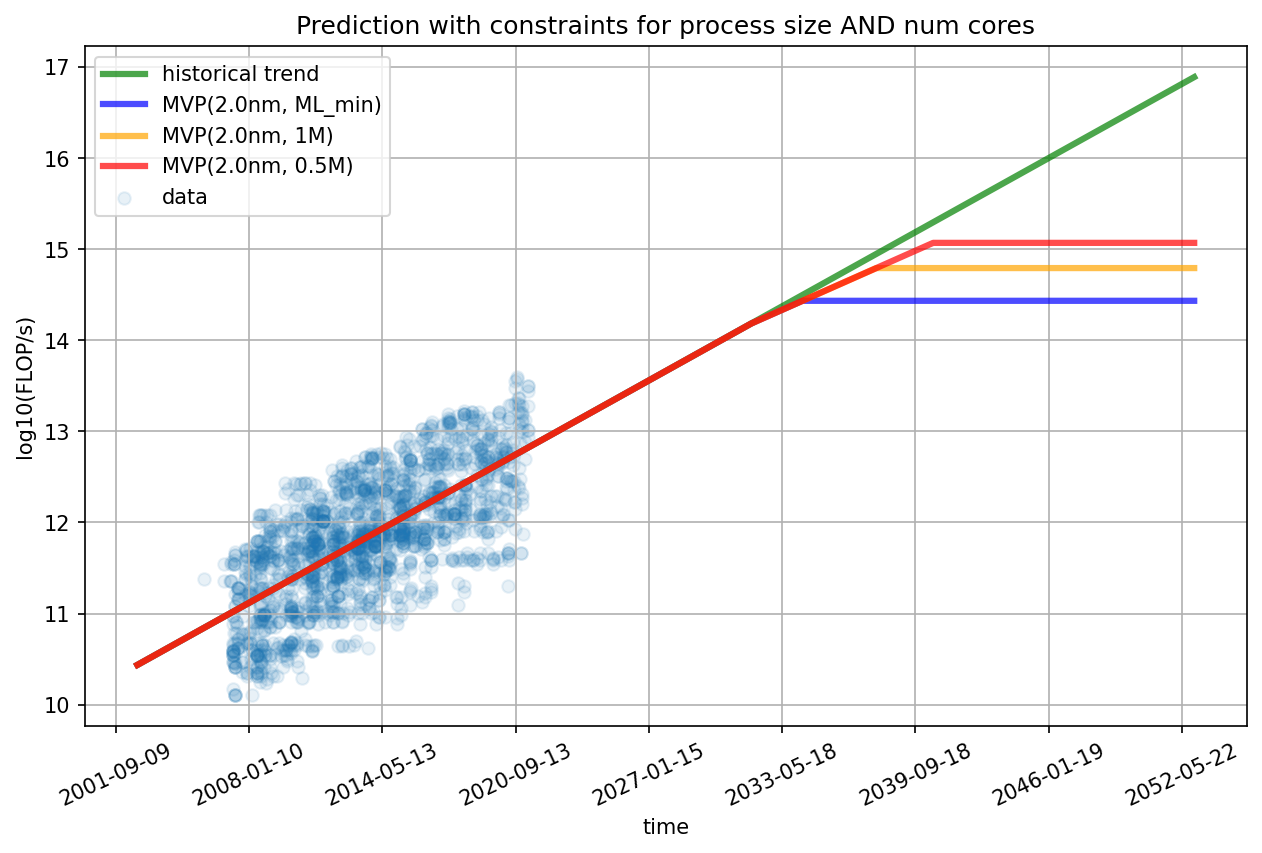
図13:さまざまな制約のもとでの予測の例。どの軌道も微細化の限界を2nmとし、コアあたりのトランジスタ数の限界をそれぞれ260万個(ML_min)、100万個、50万個としている。この図の主な目的は、2つの限界に達したことに対応する2つの折れ目を示すことである。
TOP GPUを予測するため、トランジスタの大きさの限界とコアあたりのトランジスタ数の限界の分布からサンプルを取る。さらに、トランジスタの大きさについては5パーセンタイル回帰を当てはめ(小さいほど速いことに注意)、コア数については95・90・85・80パーセンタイルのいずれかの回帰を行う。次の図から分かるように、分位点回帰にどの値を選ぶかで予測の傾きがはっきり変わり、したがって限界に達すると予測される日付も変わる。どれがTOP性能を最も正確にモデル化しているか分からないので、異なるサンプルを取る。
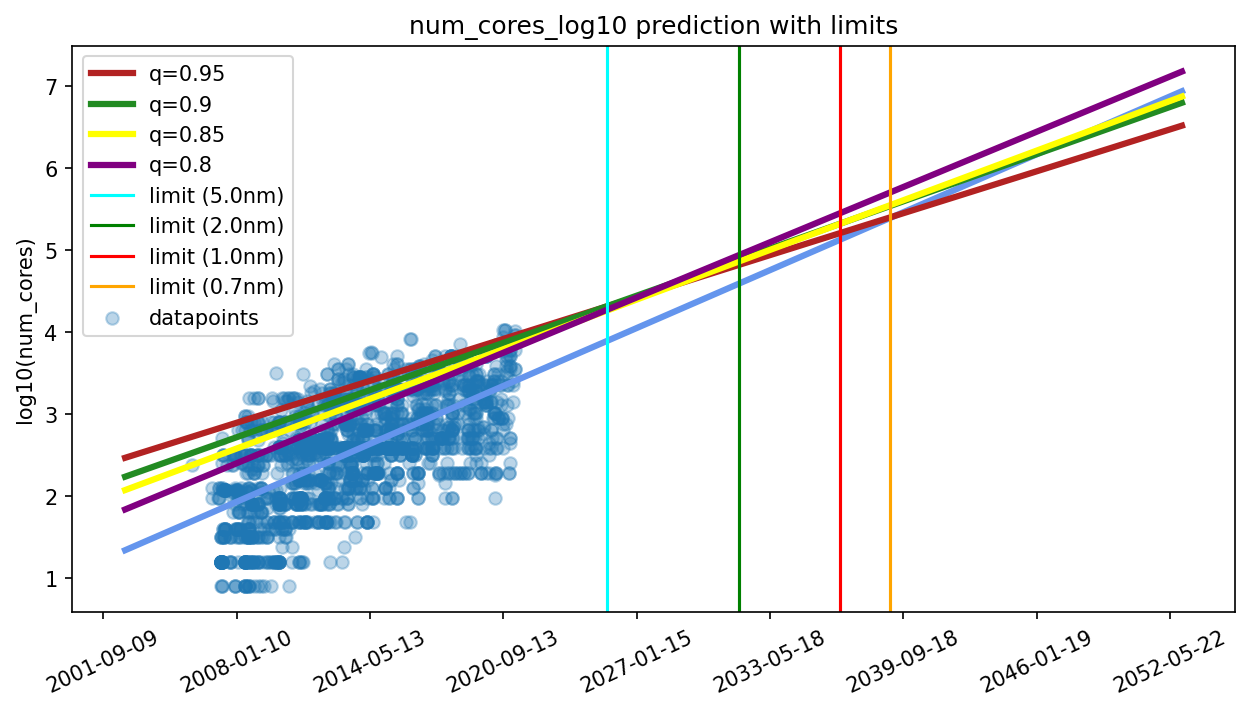
図14:log10(number of cores) ~ timeの95・90・85・80パーセンタイルの分位点回帰。パーセンタイルが違うと、回帰の傾きも違ってくる。どれがより正確な外挿かを決める明確な基準がないので、4つの傾きからランダムにサンプリングする。
これらの検討をすべて組み合わせて、限界を考慮したTOP性能の1つの予測にまとめる。
図15:TOP GPUの性能の予測の分布。過去のトレンドの線は、データセットの90パーセンタイル回帰による。モデルの予測では、2つの限界に達する時期の中央値は約2030年と約2033年であり、限界性能は1e14〜1e15 FLOP/sである。
本モデルの予測では、TOP GPUは2030年ごろに物理的限界に達し、2033年ごろに最終的な限界に達する。TOP GPUの予測(倍増期間2.69年)は、中央値のGPU(倍増期間2.34年)より傾きが緩やかであることに注意してほしい。このトレンドは、現在のTOP GPUを改善することが10年前よりすでに難しくなっている一方で、中央値のGPUはまだ追いつく余地があるためだと考える。
中央値のGPUについても限界を予測した。2つの限界に達する時期の中央値は2034年と2039年であった。さらにモデルの予測では、最大性能は3e14〜5e15であり、2032年から2044年のあいだに達する。最大性能がTOP GPUより高いのは直観に反する。どちらの手法でも限界は同じはずだからである。この違いは、現在の中央値のGPUの傾き(倍増期間2.34年)がTOP GPUの傾き(倍増期間2.69年)より急であることによる。私たちの最善の推測では、TOP GPUの傾きが緩やかなのは、この10年で最先端のGPUの性能を改善することがすでに難しくなっており、中央値のGPUはまだ追いついている途中だからである。そのため、TOP GPUの予測のほうに信頼を置いており、中央値の予測は過大評価だと考えている。
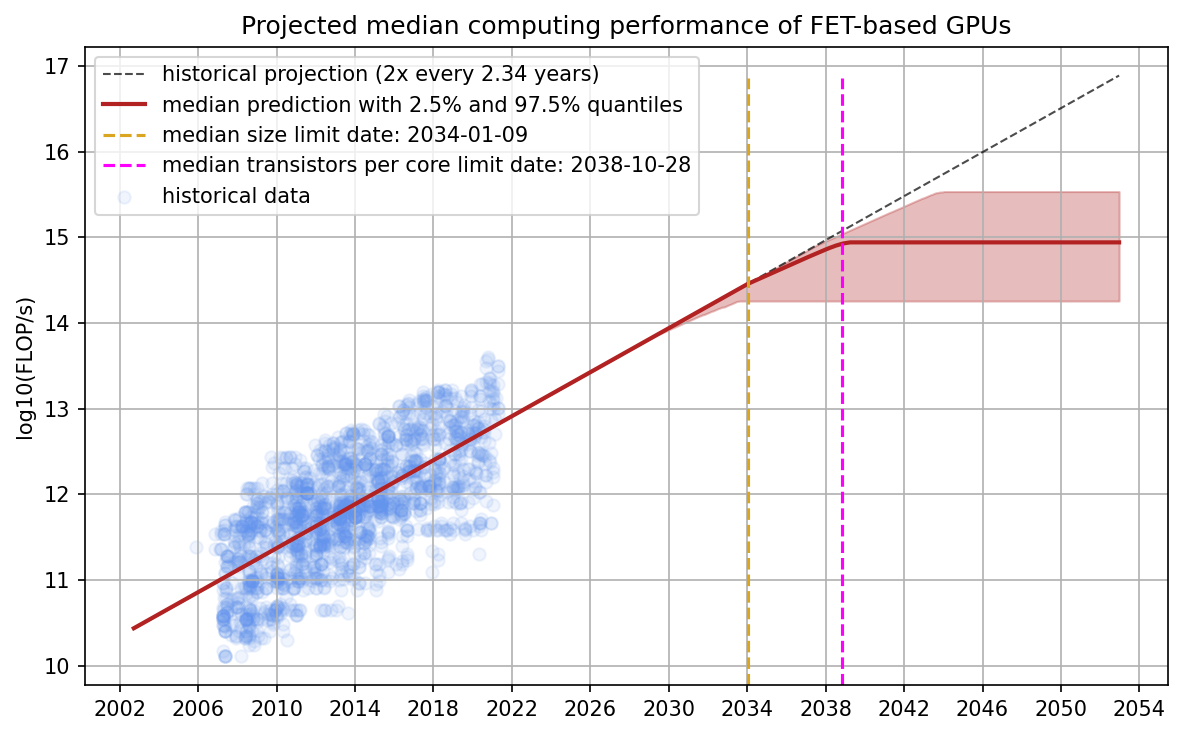
図16:中央値のGPUの性能の予測の分布。過去のトレンドの線は、データセットの線形回帰による。モデルの予測では、2つの限界に達する時期の中央値は約2034年と約2039年であり、限界性能は3e14〜5e15 FLOP/sである。
最後に、MOSFETとFinFETのトランジスタを区別すると計算資源の予測が変わるかどうかを検証する。具体的には、FinFETの微細化はMOSFETの微細化よりやや速かったので、限界にはより早く達するだろう、という見方もありうる。
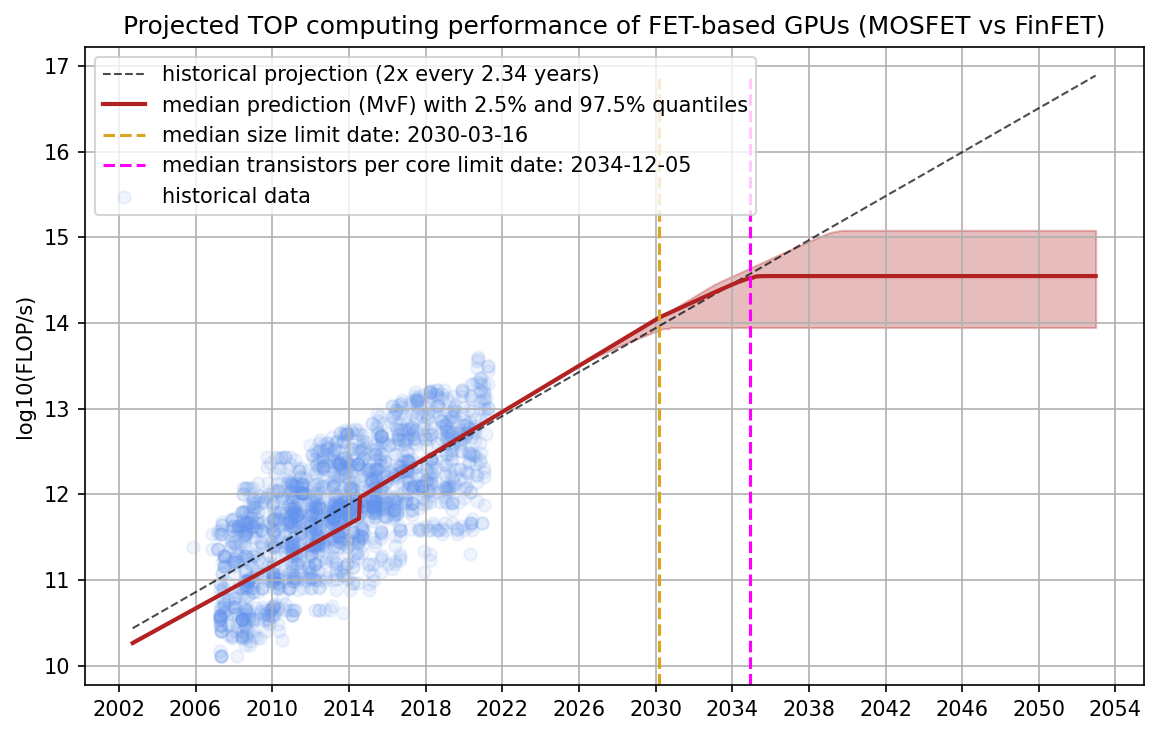
図17:MOSFETとFinFETのトランジスタの区別を考慮したモデルを用いる。2014〜2015年ごろの跳びは、主流のパラダイムがMOSFETからFinFETに切り替わった時期である。本データセットではFinFETの微細化のほうが速く進んだので、大きさの限界にもより早く達した。
MOSFETとFinFETを区別すると、限界により早く達することが分かった。ただし、モデルの当てはめに使えるデータ点がごくわずかしかないため、この予測にはあまり確信がない。FinFETが現在のパラダイムであることを踏まえ、これは、物理的な大きさの限界に本モデルの予測より早く達するかもしれないことの弱い証拠だと、慎重に解釈したい。
C. トランジスタの大きさの物理的限界(詳細)
トランジスタの大きさの物理的限界については、これまで複数の予測がある。次の表にその概要をまとめた。
| 論文 | プロセッサの最小サイズ | 限界の対象 | 年 | 論拠 |
|---|---|---|---|---|
| A single-atom transistor | Nature Nanotechnology | 約0.5 nm(シリコンの格子定数) なお、シリコンの最小の粒子であるSi5H12の直径は0.43 nmである([Wang et al., 2007]) | あらゆるシリコントランジスタのゲート長 | 2012 | シリコンベースのチップの最小の構成要素は、少なくとも原子1個分の大きさが必要である。 |
| The electronic structure at the atomic scale of ultrathin gate oxides | Nature; Scientists shrink fin-width of FinFET to nearly the physical limit | 0.7 nm | FinFETトランジスタのフィン幅 | 2020 | この研究は、単層(ML)のMoS2(厚さ約0.6 nm)をフィンとしてボトムアップで成長させる方法で、フィン幅1 nm未満のFinFETを実現した。これは実際に達成できる物理的限界にほぼ近い |
| Physical limits for scaling of integrated circuits | 3 nm | MOSFETトランジスタのチャネル長/ゲート長4 | 2010 | 現在の技術水準では、シリコン集積回路のMOSFETにおけるゲートの最小長は約3 nmである。 |
| The relentless march of the MOSFET gate oxide thickness to zero | 1.3 nm | MOSFETトランジスタのゲート幅 | 2000 | 理想的な酸化膜障壁の最小の厚さは約0.7 nmである。界面の粗さが少なくともさらに0.6 nm加わるので、実用的なゲート酸化膜の厚さの下限は1.3 nmとなる |
| A FinFET with one atomic layer channel | <1 nm | FinFETトランジスタのフィン幅 | 2020 | このボトムアップの作製方法にもとづき、垂直に自立した2Dの単層をさらに絶縁性の誘電体と金属のゲート電極で均一に被覆し、𝑊finが0.6 nmのML-FinFET構造を形成した |
限界を0.7としたのは、これが2020年の試作品でFinFETトランジスタのフィン幅として実現された大きさだからである。これはシリコン原子の大きさ(直径0.43nm)よりわずかに大きいだけなので、これが下限となるか、少なくとも乗り越えるのが非常に難しい課題になると考える。
さらに、原子の大きさのトランジスタを作れたとしても、熱や干渉などのため、それらをどこまで密に並べられるかには別の限界がある。そのため、本モデルには、ありうる大きさの限界についての分布を含めている。
D. プロセスサイズとトランジスタの大きさ
本データセットが記録しているのは、トランジスタの大きさではなくプロセスサイズである。プロセスサイズは、トランジスタの大きさに関係はするものの厳密には同じではない何かを表す、便宜上の呼び名のようである。トランジスタの正確な大きさ(たとえばゲート長とフィン幅のうち小さいほう)が分かっていれば、予測はもっと正確になったかもしれない。しかし、プロセスサイズはこうした実際の物理量と非常に強く相関していることが分かった。
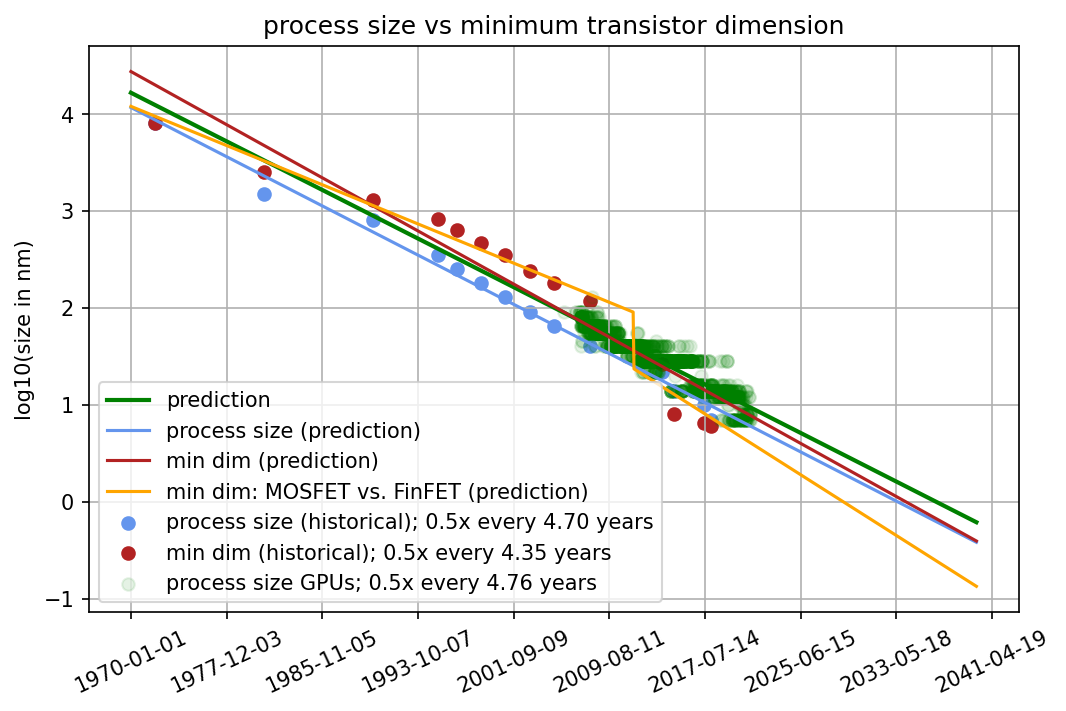
図18:プロセスサイズとトランジスタの最小寸法の比較。MOSFETとFinFETを区別しても、両者はよく似た縮小の仕方をしている。したがって本稿の以降の部分では、プロセスサイズをトランジスタの大きさのまずまずの近似として使えると結論する。
したがって、より正確な換算方法が見つかるまでは、プロセスサイズをこれらの量の代理指標として使う。この仮定によって、モデルにある程度の誤差が入ると考えられる。
E. ダイサイズの拡大
GPUとダイサイズは大きくなる傾向にある。ダイサイズが大きくなれば性能が上がるので、予測した限界はもっと高いはずだ、という反論もありうる。しかし私たちは次のように論じたい。a) ダイサイズの拡大はコア数の増加の結果であり、本モデルですでに考慮されている。b) ダイサイズの拡大が考慮されていなかったとしても、限界はそれほど変わらない。
まず、GPUのさまざまな大きさの伸びについて、いくつか事実を確認しよう。次の図から、平均のダイサイズは時間とともに大きくなり、上限も高くなったことが分かる。さらに、中央値のGPUの高さと幅は変わっていないが、最大値は大きくなった。重さについては、ばらつきは大きくなったが、平均はほぼ変わっていない。ただし、高さ・幅・重さのデータはGPUのごく一部についてしかないので、どの解釈にも慎重であるべきだ。
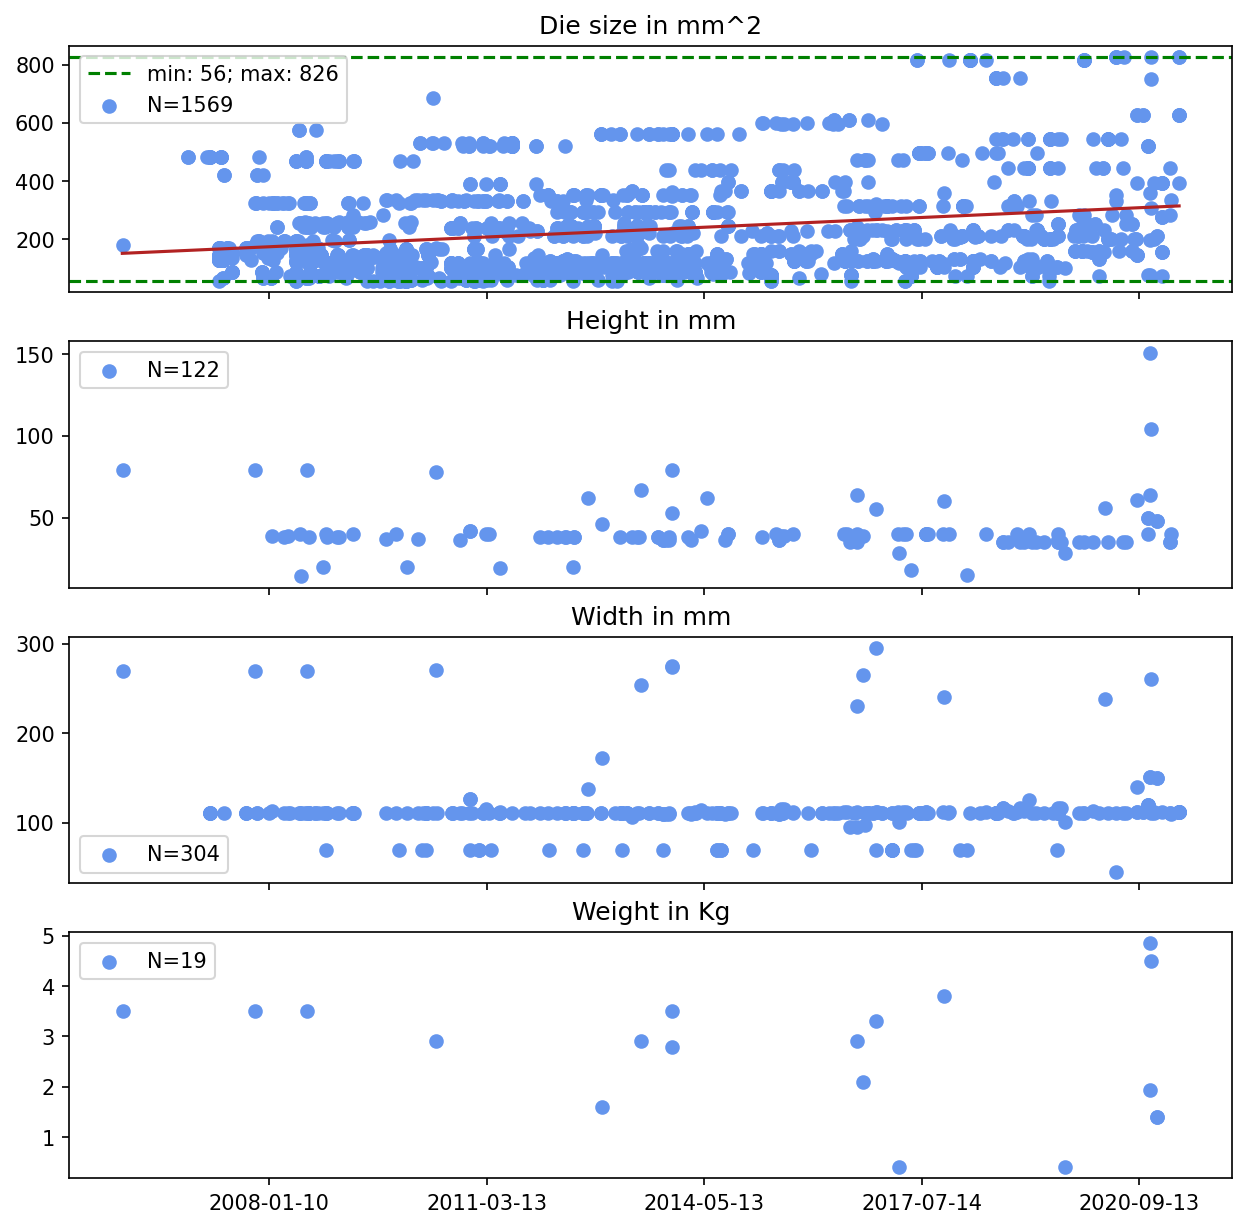
ダイサイズが大きくなる明確なトレンドがあるので、本モデルはダイサイズを明示的に組み込んでいないから限界の値は誤りだ、という反論もありうる。これには3つの重要な答えがあると考える。
- 本モデルの重要な要素はコア数の増加であり、コアには場所が必要である。コア数はトランジスタの縮小よりも速く増えているので、ダイサイズの拡大はコア数の増加ですべて説明できると考える。このトレンドは、トランジスタの大きさの2乗の半減期間(面積は2次元なので)で考えても成り立つ。具体的には、本稿の倍増期間・半減期間(年)は次のとおりである。
- コア数の倍増期間:2.70
- プロセスサイズの半減期間:4.76
- プロセスサイズの2乗の半減期間:3.23
- トランジスタ数の倍増期間:2.68
- GPUを大きくすれば、GPU1個の性能の上限は上がるかもしれないが、価格性能比は上がらない。したがって、1ドルあたりのFLOP/sの限界は変わらず、計算資源の進歩にとって最終的に重要なのは価格性能比である。
- ダイサイズの拡大が考慮されていなかったとしても、それで限界が大きく上がることはない。上の図から、ダイサイズはこの10年で平均約2倍になり、最小から最大までの幅は約16倍であることが分かる。したがって、仮にダイサイズが今後10年でさらに1桁大きくなるとしても、ポラックの法則(Pollack’s rule)により、性能の向上はsqrt(10)倍にとどまると見込まれる。
まとめると、GPUは今後10年で大きくなると予想するが、それは本モデルですでに考慮されていると考える。さらに、仮に考慮されていなかったとしても、性能が大幅に上がることはなく、価格性能比も変わらない。
F. 現在のパラダイムからの逸脱
現在のGPUの作り方から外れるものは数多くある。3Dチップ積層や専用ハードウェアのような既存のパラダイムの改良もあれば、ニューロモルフィック、アナログ、光、量子コンピューティングのように大きく異なるパラダイムもある。本稿では、それらが現在のパラダイムに取って代わるかどうか、またいつ取って代わるかについて、具体的な予測はしない。
Epoch AIは今後、これらの代替パラダイムを調べ、それが現在のFETベースのアーキテクチャを覆しうるかどうかをよりよく理解しようとするかもしれない。
ただし、物理的限界は意味のある境界であり、限界に達したとたんに現在のGPUの作り方が別の何かにあっさり置き換わるわけではない、と考える理由もいくつかある。たとえば次のようなものである。
- 現在のFETベースのパラダイムには、すでに莫大な研究開発費が投じられてきた。そのため、これらのチップを開発・生産するための高度に専門化した工程があり、研究から生産までのパイプライン全体が代替パラダイムよりはるかに進んでいる。代替パラダイムのほうが優れている可能性があったとしても、同等の成熟度に達するには多くの時間と資金が必要である。
- トランジスタの物理的な大きさは、一部の代替の計算方式にとっても限界となる。チップを2Dではなく3Dで作れるようになったとしても、チップの微細化は依然として進歩の中心的な要因の一つであり続ける。
強調しておくが、代替の計算方式やパラダイムについての私たちの専門知識は限られている。したがって、この節は慎重に扱うべきである。
G. 推定値
性能モデルと特徴量モデルの正確な推定値と当てはまりの指標を、次の表に示す。
| モデル | 変数(対数または水準) | 係数 | 標準誤差 | 決定係数 | BIC |
|---|---|---|---|---|---|
| log10(FLOP/s) ~ log10(num_cores) + log10(process_size) | num_cores | 0.9186 | 0.007 | 0.950 | -1753 |
| process_size | -0.3970 | 0.018 | |||
| 切片 | 10.0674 | 0.041 | |||
| log10(num_cores) ~ time | time | 0.1113 | 0.003 | 0.411 | 2679 |
| 切片 | -221.6495 | 6.241 | |||
| log10(process_size) ~ time | time | -0.0633 | 0.001 | 0.879 | -3743 |
| 切片 | 128.8780 | 1.098 |
表1:本モデルの3つの構成要素。1行目が性能モデル、その下の2つが特徴量モデルである。予想どおり、コア数は時間とともに増え、プロセスサイズは小さくなり、性能はコアが多くトランジスタが小さいほど高くなる。さらにこのモデルは、コア数の増加が微細化の進み方より速いこと、性能にはトランジスタの大きさよりコア数のほうが大きく効くことを示唆している。ただし、これらの変数は相関しているので、推定値は真の係数を反映していないかもしれない。また一般に、線形回帰モデルを因果的に解釈してはならない。
時間は小数表記の年で表す。たとえば2012.5は2012年の365/2日目を表す。予想どおり、コア数は時間とともに増え、プロセスサイズは時間とともに小さくなり、性能はコアが多くトランジスタが小さいほど高くなることが分かった。
注
-
近年、チップメーカーは、トランジスタの実際の最小幅(フィン幅やゲート幅など)ではなく、「プロセスサイズ」と呼ばれる量を公表するようになっている。↩
-
将来のGPUの大きさは今日のGPUとほぼ同じだと仮定している。GPUの大きさが10倍になれば、トランジスタの大きさやコアあたりのトランジスタ数を変えなくても、10倍のコアを載せられる。ただし、ダイサイズの拡大を組み込んでも予測はあまり変わらないと考える。付録Eを参照してほしい。↩
-
もちろん、微細化の余地が尽きれば、償却期間は3年より長くなるかもしれない。そうなれば買い替えの周期が長くなると考えられ、最先端のGPUを長く使う動機が生まれるからである。↩