
レポート
機械学習におけるパラメータ数
原題:Parameter counts in machine learning
要点:1952年から2021年までの機械学習システム n=139 件について、開発時期と学習可能なパラメータ数の情報を集めた。私たちの知る限り、この種の公開データセットとしては最大である。データセットはこちらから利用でき、対話型の可視化を作成するコードはこちらで入手できる。
パラメータ数に注目したのは、先行研究からモデルの性能にとって重要な変数だとわかっていること[1]、モデルの複雑さの代理指標として役立つこと、そして通常は容易に入手できるか、モデルのアーキテクチャの記述から簡単に推定できる情報であることによる。
この研究が、モデルが時とともに複雑になってきた一つの側面をAI研究者や予測者が理解し、分野が今後どう進歩するかについての予測に根拠を与える助けになることを願っている。とくに、機械学習の進歩のうちどれだけがアルゴリズムの改善によるもので、どれだけがモデルの複雑さの増大によるものかを解きほぐす助けになることを期待している。
偏りとノイズのある私たちのデータセットから確かな結論を引き出すのは難しい。それでも、この研究は次の2つの仮説を弱く支持しているようである。
- 2011〜2012年に、どの領域でもモデルの大きさの伸びのトレンドに不連続は見られなかった。これは、深層学習の革命がアルゴリズムの改善によるものではなく、改善を続けてきた機械学習の手法が他の手法の性能に追いついた時点だったことを示している可能性がある。
- 対照的に、言語モデルについては、2016〜2018年のどこかでモデルの複雑さに不連続があったようである。規模に対する収穫が増大し、伸びの軌道が倍増期間約1.5年から4〜8か月へと移ったに違いない。
本稿の構成は次のとおりである。まずデータセットを説明する。次にデータセットの弱点を指摘する。続いて、これらの点やその他の知見を詳しく述べる。さらに未解決の問いを挙げる。最後に今後の取り組みを論じ、協力を呼びかける。

1954年から2021年までの、よく知られた新しい機械学習システムのモデルの大きさ。データ点は n=139。このグラフの拡大版・対話型版はこちら。
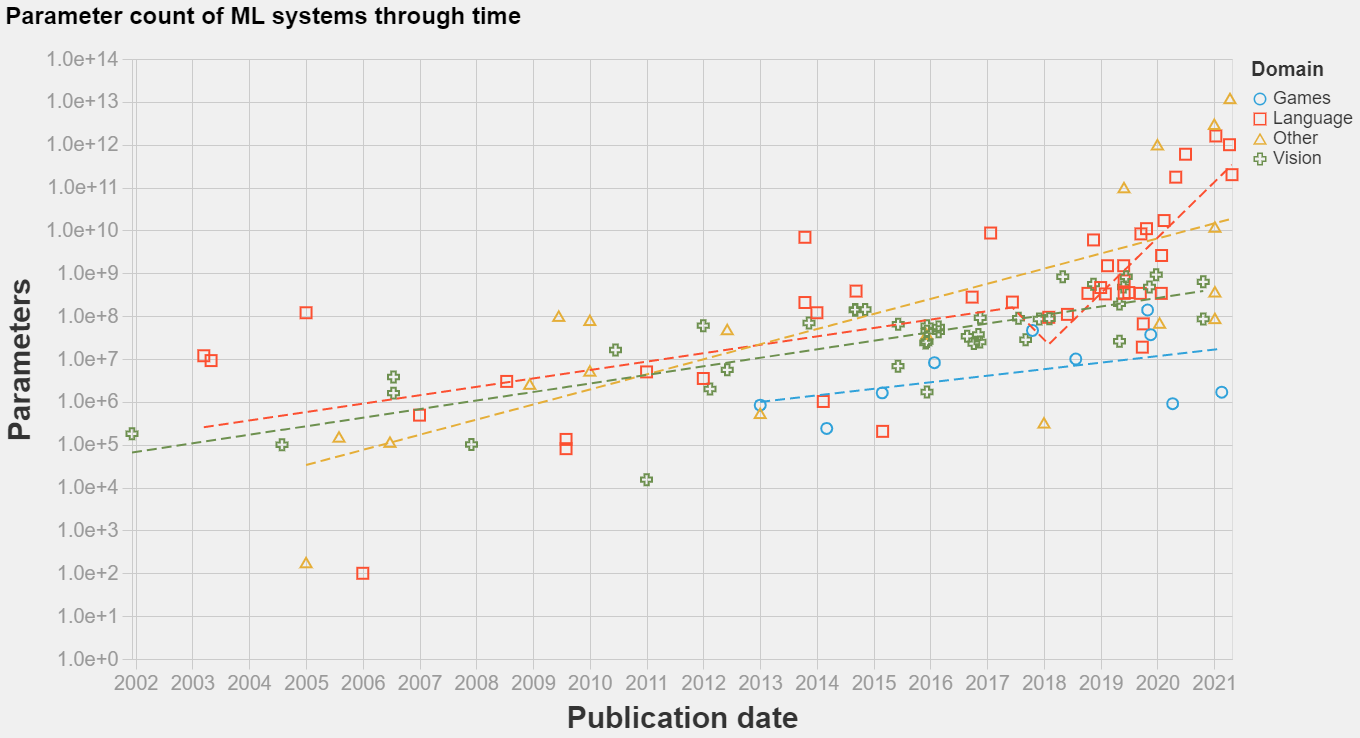
2000年から2021年までの、よく知られた新しい機械学習システムのモデルの大きさ。データ点は n=114。このグラフの拡大版・対話型版はこちら。
データセットの特徴
- データセットは1952年から2020年までのシステムを対象としているが、最近のシステム(2010年以降)についてはるかに多くの情報を収録している。
- 収録したシステムには、ニューラルネットワーク、統計モデル、サポートベクターマシン、ベイジアンネットワーク、その他のより珍しいアーキテクチャなど、多くの種類が含まれる。ただし、収録したのは主にニューラルネットワーク型のシステムである。
- システムは多くの領域にわたり、多くのタスクを解くために学習されている。ただし、主に注目したのは、視覚、言語、ゲームのタスクを解くために学習されたシステムである。
- どのシステムを収録するかは、注目度という主観的な基準で決めた。判断の材料にしたのは、被引用数(被引用数が1000件を超える論文)、外部からの評価(年間最優秀論文賞やそれに類する賞を受けた論文)、歴史的な重要性(他の研究で草分けとして引用されている論文)である。本稿の参考文献には、データセットを選定する出発点として使ったいくつかの概説が含まれている[2-26]。
- 複数の規模の版を持つモデルもある。元の論文でこれに出会った場合は、論文で主要なものとして示された版か、示された最大の版を記録した。異なるタスクを解くために異なる版が複数学習されている場合など、妥当だと考えたときには複数の版を記録したこともある。
注意点
- モデルの大きさは、機械学習システムの進歩を理解するうえで最も重要なパラメータとはとても言えないことに留意すべきである。機械学習システムのアルゴリズム以外の面での進歩を示す指標で、おそらくより重要なものとして、学習計算量や学習データセットの大きさがある[1]。
- モデルの複雑さの指標としてのモデルの大きさは、領域間で、さらにはアーキテクチャ間でさえ、ほとんど比較できない。たとえば混合エキスパートモデルは、パラメータ数を大きくできるが、各パラメータの学習に投じる計算量ははるかに少ない。
- 私たちのシステムの選び方には、多くの重要な点で偏りがある。学術論文に偏っている(商用システムについての情報は入手しにくいため)。最近のシステムについての情報が多い。パラメータ数が容易に入手できる論文、とくにモデルをどこまで大きくできるかの限界を試すために開発された大きなモデルの情報を収録する傾向があった。英語で発表された論文に偏っている。主に視覚、言語、ゲームのタスクのシステムに注目しており、音声認識、推薦システム、自動運転などの論文は比較的少ない。最後に、私たち自身が興味深い、あるいは目覚ましいと感じたシステムに偏っている。
- 情報の収集は時間のかかる作業で、パラメータ数を集めるために数百本の技術論文に目を通す必要があった。誤りを犯している可能性はかなり高い。
知見
- 当然ながら、モデルの大きさには上昇トレンドがある。このトレンドは指数関数的なようで、言語モデルでは最近ペースが上がったようである。進歩の傾きを目分量で見積もると、倍増の間隔は、2000年から2016〜2018年まではすべての領域で18〜24か月、2016〜2018年以降は言語の領域で3〜5か月だった。
- 学習可能なパラメータ数で見て最大のモデルは、言語と推薦システムの領域にある。私たちが見つけた最大のモデルは、Facebook の12兆パラメータの深層学習推薦システム(Deep Learning Recommender System)だった。推薦システムが歴史的に学習可能なパラメータ数の点で大きかったかどうかを確かめるには、推薦システムについてのデータが足りない。
- 言語モデルは歴史的に、他の領域のモデルより大きかった。これは、パラメータ化が語彙の大きさに比例する統計モデル(たとえば2005年の Hiero 機械翻訳システム)や、同じく語彙の大きさに比例する単語埋め込み(たとえば2013年の Word2Vec)があったためである。
- 深層学習は言語処理より先にコンピュータビジョンで広まり始めたと言える(どちらも2011〜2013年ごろ)が、今日では後者のパラメータ数が前者をはるかに上回っている。とくに2016〜2018年のどこかで、言語モデルの大きさの伸びのトレンドは大きく加速し、倍増期間が4〜8か月になったようである。
- ゲームの領域のアーキテクチャは学習可能なパラメータ数の点で小さく、視覚のアーキテクチャを下回るが、伸びのリズムは同程度のようである。ゲームをプレイするほうが複雑に思えるので、素朴には逆を予想していた。しかし振り返ってみれば、モデルの大きさを決めるのは規模に対する収穫がどれだけあるかである。より複雑な領域では、モデルが他の面でより制約を受けるので、実質的なモデルの大きさは小さくなると予想すべきだろう。
- 調べたすべての領域で、2011〜2012年に深層学習の時代へ移行する前後を通して、モデルの大きさの伸びのトレンドは比較的安定していた(ただし、データの量からして確かなことは言いにくい)。これは、深層学習の革命がパラダイムの転換というより、既存の傾向が自然に続いた結果であり、その傾向がついに機械学習以外の手法を上回ったのだということを示している可能性がある。
未解決の問い
- たとえば視覚のシステムと言語のシステムとで、学習可能なパラメータ数の大きさと伸びのトレンドに食い違いがあるのはなぜか。考えられる仮説としては、言語のアーキテクチャのほうが大きさに対してうまくスケールする、視覚モデルのほうが学習データによるボトルネックが大きい、視覚モデルのほうがパラメータあたりに多くの計算量を必要とする、言語処理の機械学習コミュニティのほうが大規模モデルの実験で先を行っている(たとえば、より多くの計算資源やリソースを利用できるため)、などがある。
- 2018年以降に言語モデルの大きさが爆発的に伸びた原因は何か。より大きなモデルの利点に人々が気づいたことによる純粋に社会的な現象だったのか、大きさ、計算量、データに対してよりうまくスケールするアーキテクチャ(たとえば Transformer?)の発見によって可能になったのか、それともまったく別の何かが原因だったのか。
- 深層学習以前と以後とで、機械学習のスケーリング則は実際に有意に異なるのか。これまでのところ、モデルの大きさからはそうではないことが示唆されているが、他の指標ではどうか。
- 各領域・各期間の伸び率をどうすればより正確に推定できるか。現在の伸び率はいつまで続くのか。
今後の取り組み
- より代表性の高いデータセットに育て、誤りを正すために、他の研究者と協力したいと考えている。その励みとして、誤りの指摘1件またはシステムの追加1件につき5ドルを支払う(すべての投稿を合わせて上限600ドル。支払いの上限を引き上げるために寄付で協力したい方はご連絡いただきたい)。投稿は jaimesevillamolina at gmail dot com 宛てに、できればスプレッドシート形式で送ってほしい。
- システムについてのほかの情報、とくに計算量と学習データセットの大きさも収録したいと考えている。
- ほかの領域、とくに推薦システムについての情報をもっと収録したい。
- AIシステムについての体系的レビューや、すでに整理された他のデータセットをもっと念入りに探したい。
謝辞
本稿は Jaime Sevilla、Pablo Villalobos、Juan Felipe Cerón が執筆した。Jaime の研究は、NL4XAI Horizon 2020 プログラムのマリー・キュリー助成金の支援を受けている。
プロジェクトの初期に助言をくれた Girish Sastry、このようなプロジェクトを育てる場をつくってくれたスペインの効果的利他主義コミュニティ、議論とシステムの投稿をしてくれた Haydn Belfield、Pablo Moreno、Ehud Reiter に感謝する。
参考文献
- Kaplan et al., “Scaling Laws for Neural Language Models,” 08361.
- 1.6 History of Reinforcement Learning. (n.d.). Retrieved June 19, 2021, from http://incompleteideas.net/book/first/ebook/node12.html
- AI and Compute. (n.d.). Retrieved June 19, 2021, from https://openai.com/blog/ai-and-compute/
- AI and Efficiency. (2020, May 5). OpenAI. https://openai.com/blog/ai-and-efficiency/
- AI Progress Measurement. (2017, June 12). Electronic Frontier Foundation. https://www.eff.org/ai/metrics
- Announcement of the 2020 ACL Test-of-Time Awards (ToT) | ACL Member Portal. (n.d.). Retrieved June 19, 2021, from https://www.aclweb.org/portal/content/announcement-2020-acl-test-time-awards-tot#:~:text=Each%20year%2C%20the%20ACL%20Test,papers%20from%2010%20years%20earlier.&text=The%20winners%20were%20announced%20at%20ACL%202020.
- Bender, E. M., Gebru, T., McMillan-Major, A., & Shmitchell, S. (2021). On the Dangers of Stochastic Parrots: Can Language Models Be Too Big? 🦜. Proceedings of the 2021 ACM Conference on Fairness, Accountability, and Transparency, 610–623. https://doi.org/10.1145/3442188.3445922
- Best paper awards—ACL Wiki. (n.d.). Retrieved June 19, 2021, from https://aclweb.org/aclwiki/Best_paper_awards
- bnlearn—Bayesian Network Repository. (n.d.). Retrieved June 19, 2021, from https://www.bnlearn.com/bnrepository/
- Brian Christian on the alignment problem. (n.d.). 80,000 Hours. Retrieved June 19, 2021, from https://80000hours.org/podcast/episodes/brian-christian-the-alignment-problem/
- Computer Vision Awards – The Computer Vision Foundation. (n.d.). Retrieved June 19, 2021, from https://www.thecvf.com/?page_id=413
- DARPA Grand Challenge. (2021). In Wikipedia. https://en.wikipedia.org/w/index.php?title=DARPA_Grand_Challenge&oldid=1021627196
- Karim, R. (2020, November 28). Illustrated: 10 CNN Architectures. Medium. https://towardsdatascience.com/illustrated-10-cnn-architectures-95d78ace614d
- Mohammad, S. M. (2020). Examining Citations of Natural Language Processing Literature. Proceedings of the 58th Annual Meeting of the Association for Computational Linguistics, 5199–5209. https://doi.org/10.18653/v1/2020.acl-main.464
- Mudigere, D., Hao, Y., Huang, J., Tulloch, A., Sridharan, S., Liu, X., Ozdal, M., Nie, J., Park, J., Luo, L., Yang, J. A., Gao, L., Ivchenko, D., Basant, A., Hu, Y., Yang, J., Ardestani, E. K., Wang, X., Komuravelli, R., … Rao, V. (2021). High-performance, Distributed Training of Large-scale Deep Learning Recommendation Models. ArXiv:2104.05158 [Cs]. http://arxiv.org/abs/2104.05158
- Nilsson, N. (1974). Artificial Intelligence. IFIP Congress. https://doi.org/10.7551/mitpress/11723.003.0006
- Posey, L. (2020, April 28). History of AI Research. Medium. https://web.archive.org/web/20191219113724/https://towardsdatascience.com/history-of-ai-research-90a6cc8adc9c?gi=2c235e3cb5bc
- Raschka, S. (2019). A Brief Summary of the History of Neural Networks and Deep Learning. Deep Learning, 29.
- Sanh, V., Debut, L., Chaumond, J., & Wolf, T. (2020). DistilBERT, a distilled version of BERT: Smaller, faster, cheaper and lighter. ArXiv:1910.01108 [Cs]. http://arxiv.org/abs/1910.01108
- Thompson, N. C., Greenewald, K., Lee, K., & Manso, G. F. (2020). The Computational Limits of Deep Learning. ArXiv:2007.05558 [Cs, Stat]. http://arxiv.org/abs/2007.05558
- Vidal, R. (n.d.). Computer Vision: History, the Rise of Deep Networks, and Future Vistas. 60.
- Wang, B. (2021). Kingoflolz/mesh-transformer-jax [Jupyter Notebook]. https://github.com/kingoflolz/mesh-transformer-jax (Original work published 2021)
- Who Invented Backpropagation? (n.d.). Retrieved June 19, 2021, from https://people.idsia.ch//~juergen/who-invented-backpropagation.html
- Xie, Q., Luong, M.-T., Hovy, E., & Le, Q. V. (2020). Self-training with Noisy Student improves ImageNet classification. ArXiv:1911.04252 [Cs, Stat]. http://arxiv.org/abs/1911.04252
- Young, T., Hazarika, D., Poria, S., & Cambria, E. (2018). Recent Trends in Deep Learning Based Natural Language Processing. ArXiv:1708.02709 [Cs]. http://arxiv.org/abs/1708.02709
- Zhang, B., Xiong, D., Su, J., Lin, Q., & Zhang, H. (2018). Simplifying Neural Machine Translation with Addition-Subtraction Twin-Gated Recurrent Networks. ArXiv:1810.12546 [Cs]. http://arxiv.org/abs/1810.12546
- Zoph, B., & Le, Q. V. (2016). Neural Architecture Search with Reinforcement Learning. https://arxiv.org/abs/1611.01578v2