
レポート
研究開発が自動化されても、並列化の制約が技術的特異点を遅らせうる
原題:Even after R&D is automated, parallelization constraints could delay a technological singularity
競合的な財を生産するのに使う労働、資本、土地、その他の競合的な投入をすべて2倍にしたとしよう。少なくとも2倍の量は生産できる。同じことを2回繰り返せばよいからだ。
しかし研究への投入をすべて2倍にしても、技術の進歩が2倍の速さで進むという、これに類する保証はない。二つの研究チームが同じ仕事を2回行うことはできるが、アイデアは非競合的なので、繰り返された仕事はほとんど無価値になる。同じ新しいアルゴリズムや間取りを記した同じ論文や設計図が2部あっても、1部あるより価値が高いわけではない。したがって、研究への投入を増やして進歩が加速するのは、研究を異なる有用なタスクに分割し、同時に実行し、有用な形で統合し直せる範囲に限られる。言い換えれば、研究者を増やすことの収穫は、研究開発がどれだけ並列化可能かにかかっている。
これが重要なのは、研究開発、特にAI研究開発を自動化すれば、「研究者」の数が爆発的に増えるからである。AIの離陸をめぐる非公式な議論では並列化可能性の制約はおなじみのものだが、自動化された[AI]研究開発の影響を調べるのに使われる標準的な成長モデルは、研究が際限なく並列化できると仮定している。実質的な研究者がどれだけ得られても、その数を2倍にすれば技術の進歩は一定の割合で速まる、と仮定されているのだ。新しい論文で私は、この外挿は妥当でないと論じ、そうだとしたら何が変わるのかを問う。
研究開発の自動化はそれでもおそらく技術の爆発をもたらすだろう。しかし、それを予想する通常の実証的な論拠、とりわけその時期を予測する論拠は不完全である。技術によって「研究努力」をどれだけ速く増やせるかだけでなく、増え続ける研究努力を一度に使う能力が技術によってどれだけ速く向上するかも知る必要がある。
並列化技術
従来のモデルでは、技術の進歩は二つの力で決まる。(1)技術のフロンティアが進むにつれてアイデアは見つけにくくなるが、(2)社会はそれを見つけるためにより多くの資源を投じる。2番目の力が1番目の力を相殺するとき、技術の進歩は持続する。
これらのモデルでも、研究への投入に対して研究開発の収穫が逓減することは認められている。研究者の数を2倍にしても、進歩の速さが2倍になるとは限らない。それでもこれらのモデルは、どの時点でも十分な研究開発への投入を使えば、技術はいくらでも速く進歩できると仮定している。
これは妥当ではない。生産性を上げたい、つまりロボット1台をより速く、あるいはより安く生産したいと考えるロボット工場を想像してほしい。今日の道具を使う今日のエンジニアを、どれだけ大勢チームに投入しても、10分後に工場の生産性が2倍になっていることはない。改善点を見つけ、実装し、試験しなければならず、改善によって工場の生産性が上がるまでには、おそらくこの工程を何度か繰り返す必要がある。その仕事を分割する技術、たとえば並列に試験できるほど精度の高い生産ラインのシミュレーターがなければ、どれだけ人数を増やしても、こうした順を追った手順に要する時間はなくせない。
これは必ずしも、進歩に物理的な絶対の限界があることを意味しない。 より良い道具(より良いロボットを含む)がいったん開発されれば、工場をずっと速く設計し直し、建て直せるかもしれない。しかし今日の道具は、今日どれだけの研究努力を生産的に吸収できるかに上限を課している。
そこで私は、技術の進歩へのもう一つの投入として並列化技術を提案する。「実効的な研究投入」は、次のうち少ないほうに制約される。
(2a)生の研究投入
(2b)その仕事を分割し、実行し、調整し、統合するのに必要な「並列化技術」
並列化技術の例として、Anthropic によるエージェントチームの開発を考えてみよう。多数のAIエージェントの仕事を調整することで、うまく機能するエージェントチームは、ある研究プロジェクトがより多くの計算資源を一度に生産的に使えるようにする。
歴史的には、並列化技術は十分速く進化してきたので、技術開発にとってより重要なボトルネックは、たいてい単純に研究投入が足りないことだったと私は考えている。しかし研究開発の自動化によって、ある分野の研究投入が極めて速く増えるようになれば、それを並列化するのに必要な技術がはるかに重要になるかもしれない。
これが知能爆発にとって重要な理由
AIの再帰的な自己改善を表す最も単純なモデルは次のようなものだ。AIがAI研究を完全に自動化できるようになると、より良いアルゴリズムによって、同じ計算資源の保有量でより多くの「AI研究者」を動かせるようになる。その研究者たちがさらに良いアルゴリズムを生み出し、それがさらに実効的な研究者を生み出し、という具合に続いていく。
従来のモデルでは、このフィードバックループが爆発するかどうかは、過去の成長率から推し量れる。知能、より正確には該当する意味での「アルゴリズムの質」が、それを生み出すのに使われた研究投入よりも速く伸びてきたのなら、研究投入を追加することの収穫は、イノベーションの難しさの増大に打ち勝つほど大きいことが示唆される。したがって、アルゴリズムの質そのものが実効的な研究投入を何倍にも増やすようになれば、アルゴリズムの質はますます速く進歩し、知能爆発が進行することになる。
並列化可能性に限界があると、もう一つのパラメータが加わる。再帰的な自己改善を左右するのは、いまや
- アイデアがどれだけ速く見つけにくくなるか
- 研究投入の増加に進歩がどれだけ強く反応するか
だけでなく、
- 技術の進歩が、研究投入をどれだけうまく並列に働かせられるかの上限をどれだけ速く引き上げるか
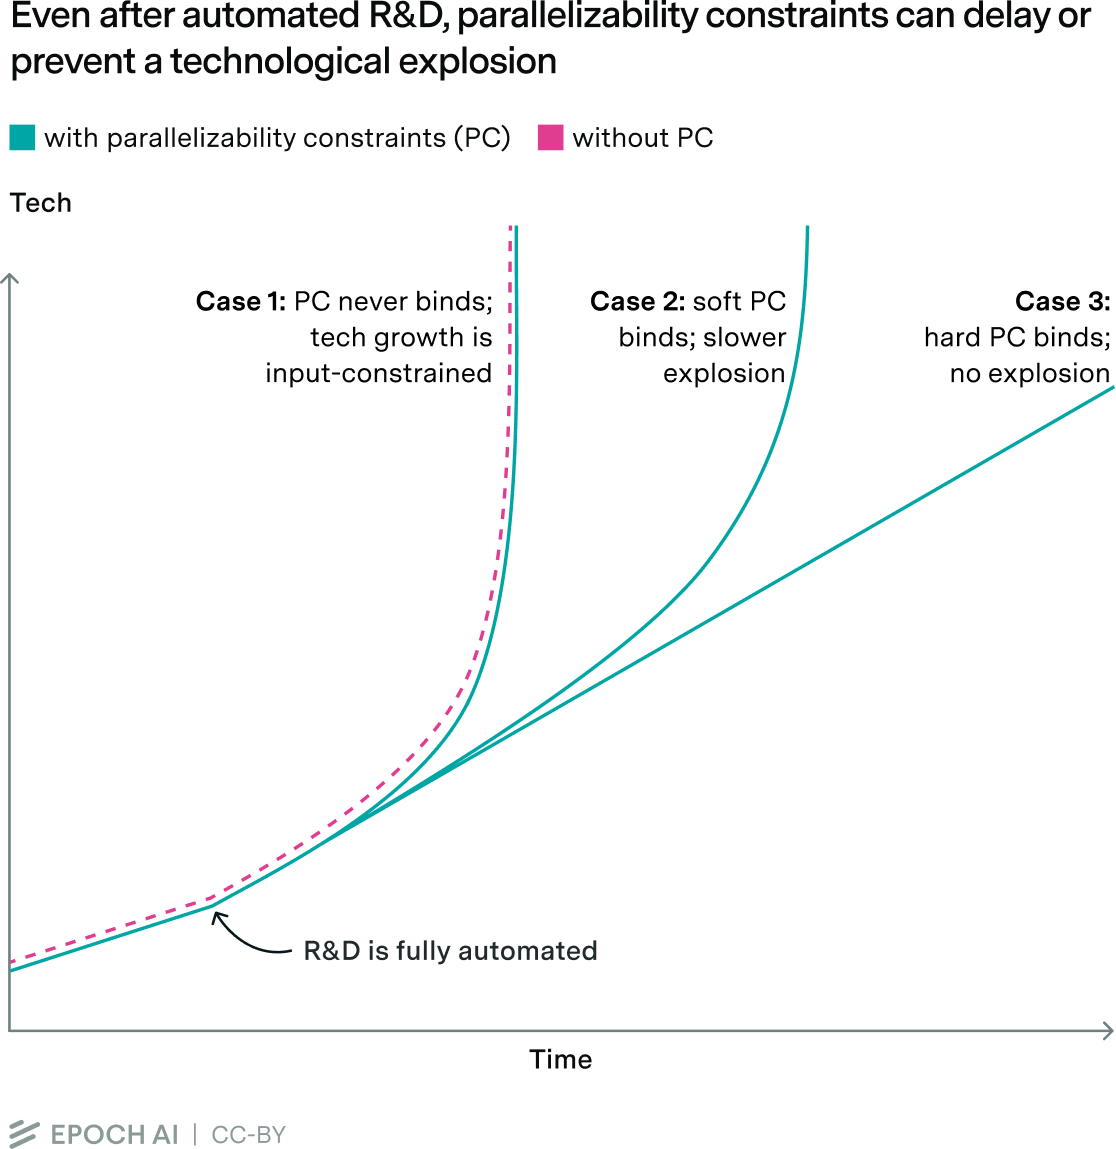
でもある。ありうるケースは三つある。
ケース1:並列化技術が実効的な研究投入と少なくとも同じ速さで向上するなら、従来の結論はそのまま成り立つ。
ケース2:並列化技術が技術のフロンティアよりは速く、研究投入よりは遅く向上するなら、爆発はやはり起こるが、より緩やかになる。
ケース3:並列化技術が通常の指数的成長を維持できる程度の速さでしか向上しないなら、研究開発の自動化は成長率を引き上げるかもしれないが、成長を際限なく加速させはしない。
したがって、AIのアルゴリズムの質がAI研究への投入よりも速く伸びてきたことを示す推定は、依然として有益である。アルゴリズムの質の伸びのほうが遅かったのなら、このモデルでも、投入を固定した再帰的な自己改善は爆発しない。しかし性能の伸びのほうが速かったのなら、結論はもはや定まらない。AI研究をより並列化しやすくする技術に投資することの収穫も推定しなければならない。
強調しておきたいのは、AI研究開発の自動化は、「シミュレートされた研究者」の数を増やす以外の経路でも、AI研究を含む研究を加速させうるということだ。たとえば次のようなものがある。
-
AIシステムの各インスタンスは、人間よりはるかに速く、時とともに賢くなれる。AI Futures Model の用語で言えば、より良い「研究のセンス」を養える。
-
人間の研究者と違って、AIモデルはおそらく、フロンティア研究所を辞めて競合企業を立ち上げたいという誘惑に駆られない。経済成長モデルの中には、これが技術開発を大いに促進することを示唆するものがある。私の以前の論文(こちら)の第4.2節を参照してほしい。
-
一定数のAIモデルのインスタンスを、同じ人数の人間の研究チームよりはるかに認知的に多様になるよう設計することもできる。確かに今日では、その多様性はずっと乏しく、これは深刻な制約である。仮に Claude Fable 5 のすべてのインスタンスがあらゆる意味でアインシュタインと同じくらい賢かったとしても、その偏りはインスタンス間で強く相関している。100人のアインシュタインは、アインシュタインとボーアの2人よりも、量子力学を進めるのに時間がかかったかもしれない。しかし人工ニューラルネットワークは人間の脳よりはるかに作り替えやすいので、ファインチューニングや継続学習への投資によって、いずれはAIのチームを人間のチームより認知的に多様にできるはずだ。
それでも、AI研究開発の自動化が研究を加速させる重要な経路の一つは、単純に、研究者の人口を実質的に大きく増やせるようになることであり、これまでの再帰的な自己改善のモデルのほとんどでは、これが主要な経路になっている。並列化可能性の制約は、長期的にはこの経路の有効性を大きく制限しうる。
なぜAI研究開発は完全には並列化できないのか
AI研究はすでに完全に並列化できると考える人もいるかもしれない。チップが十分にあれば、ありうる実験をすべて同時に走らせて、最良の結果を選べばよいのではないか。
そうはいかない。仮に各パラメータが1ビットだとしても、10兆パラメータのモデルには2(10 trillion)通りの重みの組み合わせがある。今日の記憶技術では、それらをすべて保存するだけでも、光が端から端まで横切るのに宇宙の年齢よりはるかに長い時間がかかるほど巨大な構造物が必要になる。1
より現実的なAI研究開発には、少なくとも二つの異なるボトルネックがある。
第一に、実験には逐次的な深さがある。学習実行や実験の一部は、先行する計算の完了を待たなければならない計算で成り立っている。計算資源が増えれば同時に走らせられる実験の流れは増えるが、それぞれの流れを短縮できるのは、より高速に動くチップのような技術の進歩だけだ。
第二に、認知的な仕事は調整されなければならない。100万人のAI研究者が役に立つのは、重複しない計画を立て、互いの結果から学び、有望な方向に自分たちを割り振り、仕事を統合できる範囲に限られる。並列化技術は、一度に生産的に使える研究者の数を決める。そしてどの時点でも、その数は有限である。それを引き上げること自体が研究課題であり、ほかの研究課題と同じ制約を受ける。
自動化された研究者は、人間よりはるかに調整しやすいかもしれない。新しいインスタンスは同一の重みとコンテキストから始められ、何年もの教育や新人研修なしに、コード、実験記録、機械可読な出力を共有できる。したがって、人間による研究から機械による研究への移行は、私が「エージェントの並列化可能性」と呼ぶものに、一度限りの大きな飛躍をもたらしうる。しかし大きな飛躍は上限が無限であることと同じではない。仮想研究者の人口が十分速く増えるなら、進歩はいずれ、並列化技術を改善し続けられる速さに制約されるかもしれない。
結論
ここから言えるのは、並列化のボトルネックが知能爆発を必ず防ぐということでも、必ず遅らせるということでさえない。爆発が起こるかどうか、いつ起こるかを決めるパラメータの一つになっている、ということにすぎない。このパラメータの値は重要な実証的問題であり、ほとんど研究されていない。
実験によってこれを明らかにできるかもしれないが、その実験は、(i)並列の研究努力に対する収穫の逓減と、(ii)時間をかけて進歩を続けることの難しさが増すことで生じる収穫の逓減とを切り分けられるよう、慎重に設計しなければならない。一つの方法は、NanoGPT の学習効率の改善のような明確に定義された研究課題を、ますます大きなAIエージェントの集団に与え、一定期間で進歩がどう伸びるかを測ることだ。そうすれば、エージェントを追加してもほとんど仕事が重複するだけになったり、調整のコストが生じたりするのがどの時点なのかを観察できる。その時点が、スキャフォールディング(モデルを動かす周辺の仕組み)や調整ツールへの投資によってどう動くのかも分かる。
要するに、研究開発の自動化によって「研究者」の数は急速に増えうる。これによってAIを含む多くの分野でイノベーションが大きく加速することは疑いない。しかしイノベーションが加速するのは、研究開発の仕事を並列化する能力が、増え続ける研究者の人口に追いつく範囲に限られる。並列化技術は、経済学者やAI予測者がこれまで使ってきた技術開発のモデルにまったく登場してこなかったが、今後数年間は中心的な役割を果たすかもしれない。
注
-
それぞれの重みを保存するだけで1TBを超え、今日の技術ではそれに0.01cm3をゆうに超える体積が要る。したがって、ありうる10兆パラメータのモデルをすべて今日の記憶装置で保存するには、一辺が10(1 trillion) kmを超える立方体が必要になり、光がそれを横切るには10(1 trillion)年以上かかる。 ↩