
論文
機械学習モデルのサイズとパラメータの空白
原題:Machine learning model sizes and the parameter gap
要約:注目すべき機械学習システムのモデルサイズは、2018年以降、それ以前の10倍の速さで大きくなっている。2020年以降の伸びは完全に連続的ではなかった。1桁分の跳躍があり、それが今日まで続いている。これは、モデルサイズ、ひいてはAIの能力を予測するうえで重要である。
モデルサイズの傾向
現在の機械学習システムでは、モデルサイズ(パラメータ数)は既知のスケーリング則によって性能と結びついている。私たちのデータセットを使って、237の画期的な機械学習システムについてモデルサイズの傾向を分析した。システムは、解くタスクに応じて言語、視覚、ゲーム、その他に分類している。
モデルサイズは、1950年代から2018年ごろまでに、ゆっくりと7桁大きくなった。2018年以降、言語モデルでは伸びが加速し、2018年から2022年までの4年間でモデルサイズがさらに4桁大きくなった(図1を参照)。視覚などのほかの分野の伸びはより緩やかだが、それでも2018年以前よりは速い。
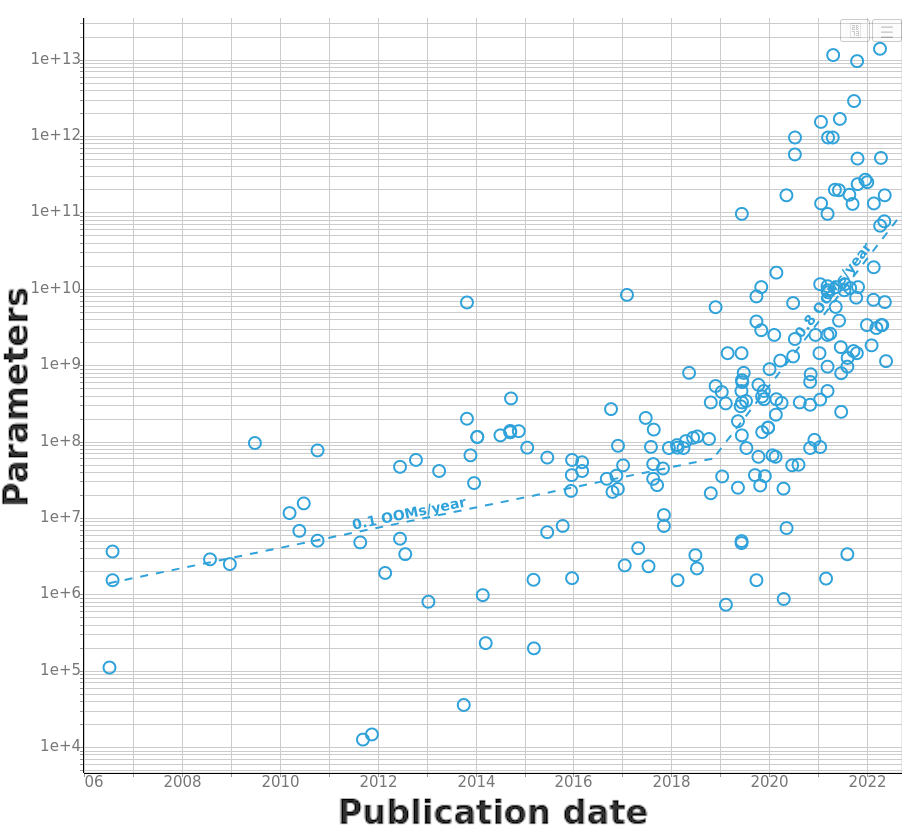
図1. 左:2018年ごろの移行期。2018年以降の傾向を一つと仮定した場合。右:同じ期間。2018年以降に二つの別々の傾向があると仮定した場合。
| 期間 | データ | 規模(開始〜終了) | 傾き | 倍増期間 | |
| 1952〜2018年 | 1e+01〜3e+7 パラメータ | 年0.1桁 [0.1; 0.1; 0.1] | 39.7か月 [36.4; 39.7; 40.7] | 0.62 | |
| 2018〜2022年 (単一の傾向) | 3e+7〜2e+12 パラメータ | 年0.9桁 [0.9; 0.9; 1.0] | 4.0か月 [3.5; 4.0; 4.3] | 0.31 | |
| 2018〜2022年 (空白より上) | 7e+10〜2e+12 パラメータ | 年-0.1桁 [-0.4; -0.1; 0.2] | -14.2か月 [-52.5; -14.2; 52.0] | 0.00 | |
| 2018〜2022年 (空白より下) | 3e+7〜2e+10 パラメータ | 年0.5桁 [0.4; 0.5; 0.5] | 8.0か月 [7.0; 8.0; 9.8] | 0.25 |
表1. 主な結果のまとめ。2018年ごろに全体として伸びが加速した。これは、それまでの傾向の伸び率が上がったことと、それとは別に非常に大きなモデルの集団がその上に現れたことに分けられる。
パラメータの空白
2020年以降、パラメータ数が200億未満のモデルと700億を超えるモデルは多く見られるが、200億〜700億の範囲のモデルはごくわずかである。私たちはこの少なさをパラメータの空白と呼んでいる(図2を参照)。

図2:分野別に見たモデルサイズの推移。赤い線はパラメータの空白を示す。空白より上のシステムの大半は、言語モデルかマルチモーダルモデルである。
パラメータの空白を説明する仮説をいくつか考えた。そのうち、証拠と最もよく整合するのは次の二つである。
- モデルサイズを200億パラメータより大きくするには、別の並列化手法を採用する必要があるため、限界費用が高くなる。そのため、中規模のモデルは、より大きなモデルや小さなモデルよりも費用対効果が低い。
- GPT-3が、それまでのシステムからサイズを1桁「跳躍」させたことで空白が始まった。研究者には、それまでのモデルを上回れる最も安いモデルを作る動機があるため、この空白が保たれた。GPT-3と競うモデルは空白より上にあり、残りは下にある。
パラメータの空白は、モデルサイズに何らかの根本的な制約があり、それが将来、不連続な変化を引き起こすかもしれないことを示唆している。