
レポート
長いコンテキストでのレイテンシは、GPT-5.6では二次関数的に増えるが、Claude 5ではほぼ線形にとどまる
原題:Long-context latency scales quadratically for GPT-5.6 but nearly linearly for Claude 5
はじめに
OpenAI と Anthropic は、長いプロンプトの料金設定が大きく異なる。コンテキストウィンドウはどちらも同程度で、GPT-5.6 のモデルは最大105万トークン、Claude のモデルは最大100万トークンである。しかし、OpenAI のモデルへのリクエストで入力が27万2,000トークンを超えると、入力とキャッシュ済み入力の料金は通常の2倍、出力の料金は通常の1.5倍になる。一方、Claude のモデルは入力の長さにかかわらず料金が一定である。料金は必ずしも実際の推論実行のコストを反映しているわけではないが、この料金の違いをきっかけに、2つのモデル系列でコンテキスト長に応じたレイテンシの伸び方も違うのかを調べることにした。
OpenAI の GPT-5.6 Terra と Sol、Anthropic の Claude Sonnet 5 と Opus 5 について、最初のトークンが返るまでの時間(TTFT)がコンテキスト長に応じてどう伸びるかを測定した。その結果、2つのモデル系列はまったく異なる振る舞いを示した。Terra と Sol では、プロンプトが長くなるにつれてはっきりと上に反る曲線が見られ、大きな二次の成分があることと整合した。Sonnet 5 は曲がりが観察されず、ほぼ線形の伸びにとどまった。Opus はノイズが多かったが、それでも線形の伸びと整合した。測定ノイズの影響を調べるため、レイテンシのノイズについて異なる仮定を置いた3つの推定量で当てはめを行った。その結果、3つとも GPT-5.6 では同程度の曲がりを再現し、Claude の当てはめはずっと線形に近いままだった。
この結果は、OpenAI と Anthropic が、それぞれのモデルで長いコンテキストのプロンプトを処理する方法について、大きく異なるアーキテクチャ上の選択をしてきたことを示唆している。フルアテンションでは、各トークンがコンテキスト全体にわたって注意を向け、計算量はコンテキスト長の二乗で増える。Claude の伸びがほぼ線形であることから、長いコンテキストの処理でフルアテンションが占める割合は、GPT の場合よりずっと小さいと考えられる。
GPT と Claude では長いコンテキストでのレイテンシの伸び方が異なる
4つのモデル、GPT-5.6 Terra、GPT-5.6 Sol、Claude Sonnet 5、Claude Opus 5 について、推論(reasoning)を無効にした状態でコンテキスト長ごとのTTFTを測定した。測定の設定の詳細は付録に示す。
スチューデントのt推定量を用いて、各モデルに二次曲線を当てはめた。4つのデータセットすべての分析で、同じ二次式を使っている。
Terra と Sol でははっきりした曲がりが見られる。Sonnet は見た目には線形である。Opus は Sonnet よりデータのノイズが多いが、同じく線形に近い。言い換えると、GPT-5.6 では、同じ数のトークンを追加したときのTTFTの増え方が、コンテキストが長くなるほど大きくなっていく。一方 Claude では、追加されるレイテンシはずっと一定に近いままである。
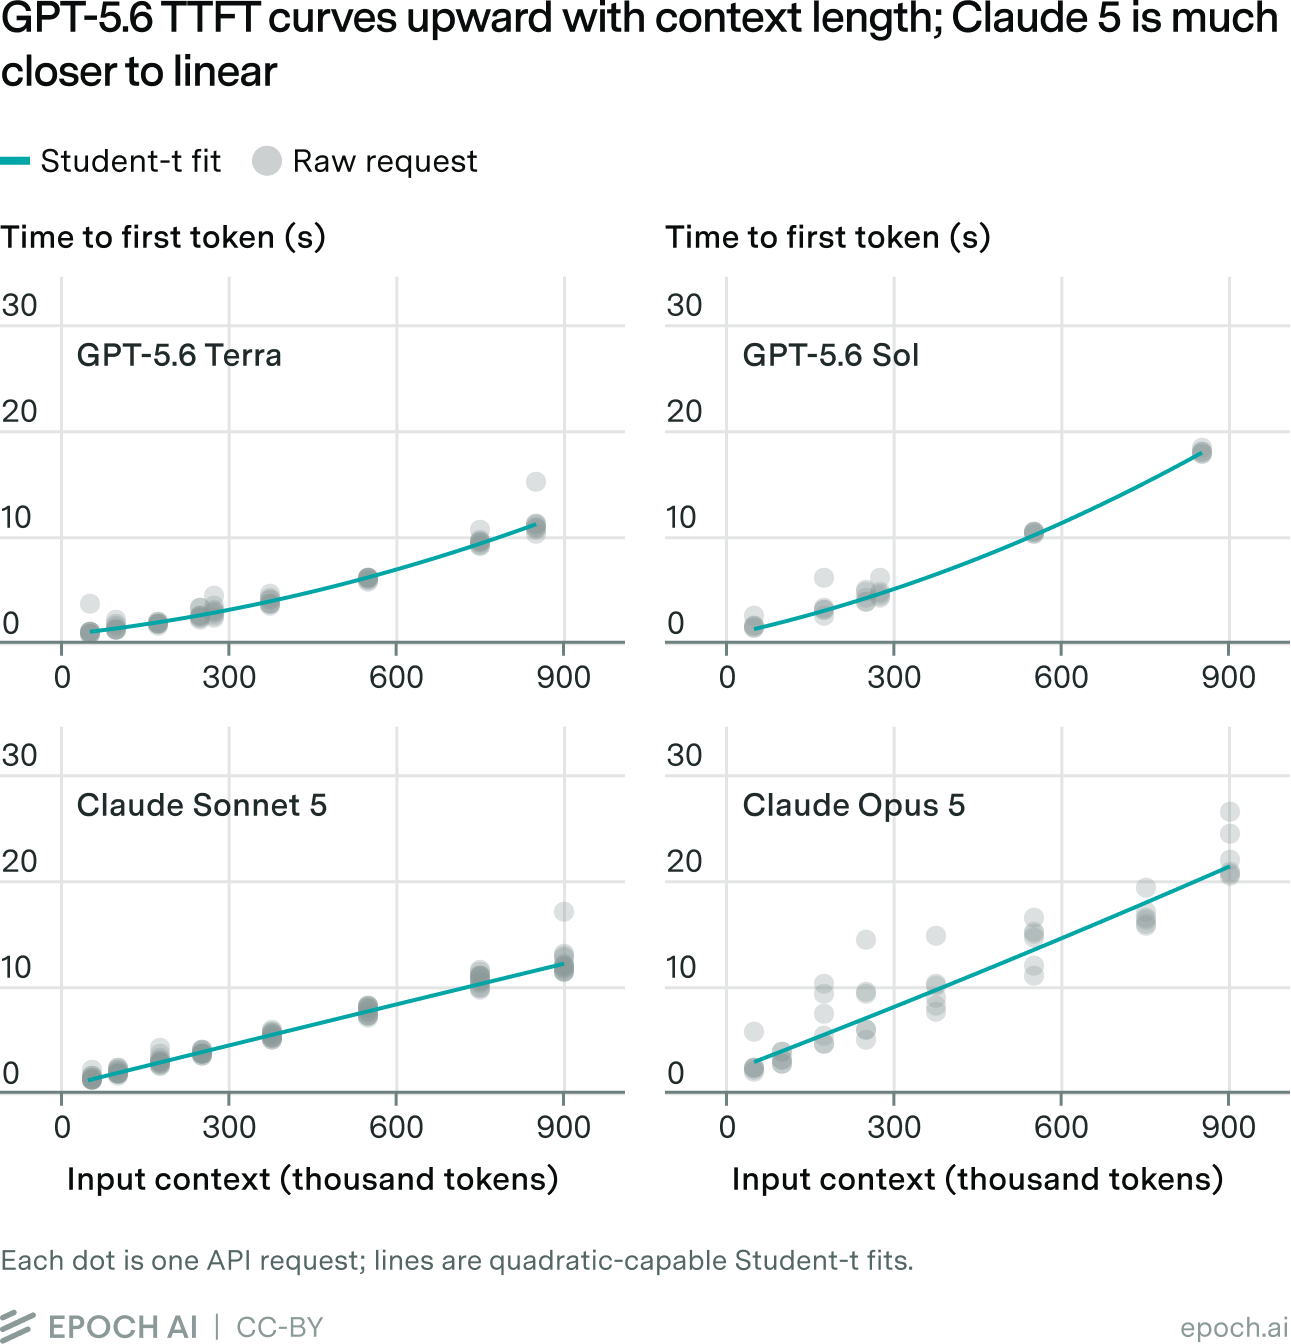
この違いは、APIのレイテンシのノイズの扱い方を変えても揺らがない
TTFTのベンチマークはノイズが多くなりがちである。実験はノイズを最小限に抑えるよう設計したが、結果には、特に Opus で、明らかにまだ大きなノイズがある。TTFTのばらつきの一部はおそらくモデルの実行そのものに由来するが、その多くはキューイングやルーティングといった、より上位の配信処理での遅延から生じる、というのが私たちの作業仮説である。そのため、レイテンシのノイズの大部分を、左右対称の測定誤差ではなく、正の値をとる加算的な遅延として扱う推定量を使うことにした。
このノイズに対する頑健性を確かめるため、レイテンシのノイズの扱い方が異なる2つの新しい推定量、確率的フロンティア回帰と「スパイク+競合」モデルを使って分析をやり直した。どちらも、リソースの競合による正の追加レイテンシを明示的にモデル化している。一方、スチューデントのt回帰は極端な観測値の影響を小さくする。これらの推定量は、基礎となるレイテンシについてやや異なる概念を対象にしているので、当てはめた水準が一致する必要はない。ここで重要な検定は、コンテキスト長との関係の形について推定量どうしが一致するかどうかである。モデルの完全な定式化は付録に示す。
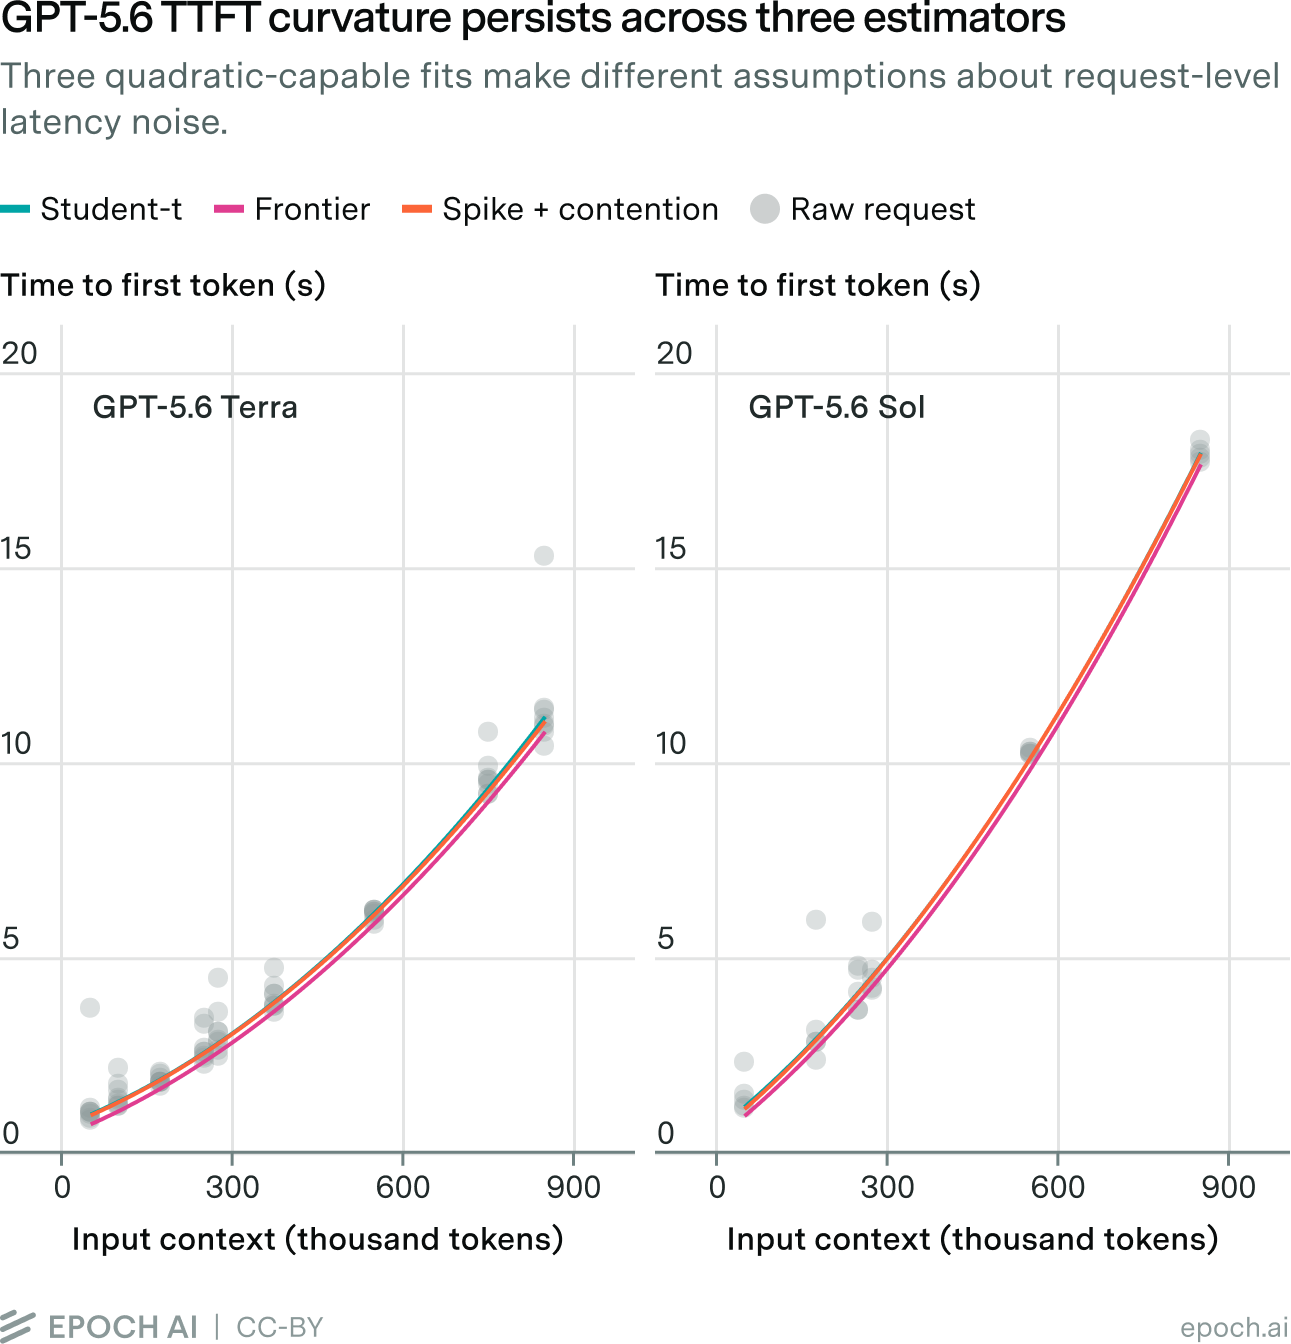
予想どおり、推定量ごとに当てはめた曲線はやや異なるが、3つとも曲がりについては一致している。したがって、二次関数的な伸び方が、外れ値に曲線を引き上げられた結果である可能性は低いと言える。
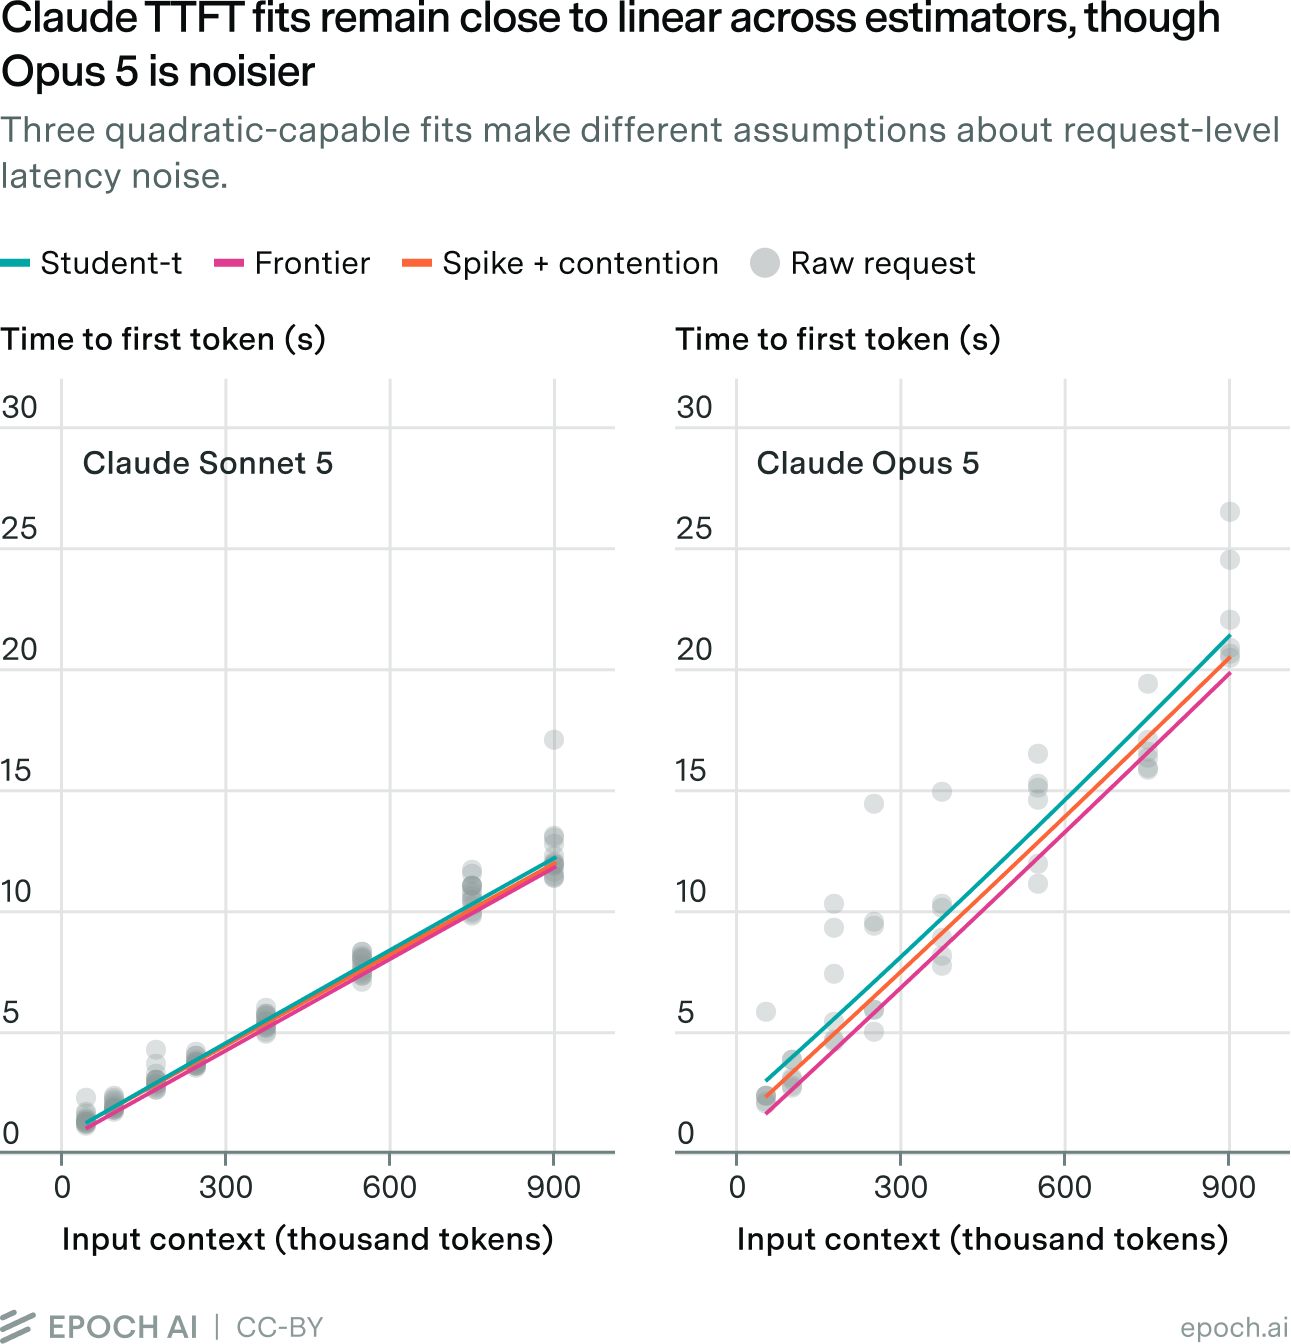
最もきれいな結果が得られたのは Sonnet である。データからは、3つの推定量のすべてで当てはめが線形に非常に近いことがわかる。Opus はずっとノイズが多いが、3つの推定量はいずれも曲がりがごくわずかな当てはめを示す。図1〜3を合わせると、検証した GPT と Claude のモデルは明らかに異なる伸び方の曲線をもつことがわかる。
長いコンテキストの効率は設計上の選択になった
従来、Transformer ベースのLLMはフルアテンション層を使ってきた。フルアテンション層では、各トークンが先行するすべてのトークンに注意を向ける。そのため、プロンプトの処理に必要なアテンションの計算量の合計は、プロンプト長の二乗で増える。多くのオープンなモデル系列は、長いコンテキストでもより効率よく伸びる方向へ移ってきた。Kimi K3 や Qwen3.5 のようなハイブリッドモデルは、線形アテンション層と、それよりずっと少ない数のフルアテンション層を、具体的には3対1の比率で組み合わせている。これによりフルアテンション層の数は4分の1になり、二次の項も同じ割合で小さくなる。Qwen3.8-Flash-Next と GLM-5.3-Flash は、フルアテンション層をスパースアテンションに置き換えることで、この方向をさらに推し進めた。スパースアテンション層は、コンテキスト全体に注意を向けられる一方で、二次の成分はフルアテンションより小さい。スライディングウィンドウ・アテンションもよく知られた手法で、OpenAI のオープンソースモデル gpt-oss にも使われていた。ウィンドウの大きさが固定されていれば、スライディングウィンドウ・アテンションのトークンあたりのアテンションのコストはほぼ一定で、総コストは系列長に対して線形になる。これらのモデルすべてに共通する方向性は、長いコンテキストで必要になる二次関数的な計算の量を減らすことである。
私たちの結果は、少なくとも評価したモデルについては、Anthropic もこのようにレイテンシの伸び方に取り組んできたことを示唆している。Sonnet と Opus はどちらも、GPT のモデルより二次の曲がりがずっと小さいように見える。これは、Claude Code では Claude 5 世代のすべてのモデルが標準で100万トークンのコンテキストウィンドウに対応していることとも合致する。対照的に、OpenAI は別のトレードオフを選んでいるように見える。GPT-5.6 系列のモデルは105万トークンのコンテキストウィンドウに対応しているが、Codex は標準で27万2,000トークンに達する前に自動圧縮を行う。OpenAI は、コンテキストの肥大化を避けることを Codex の重要な設計目標の一つとして説明している。最大105万トークンまで公式に対応しているのに、OpenAI の幹部は、Codex の標準の27万2,000トークンのコンテキストウィンドウを広げることは勧めないと公に述べている。
アーキテクチャの違いがコストに与える影響
例として、Anthropic の Opus 5 のAPI料金で、10万トークンのリクエストを考えてみる。
| 項目 | 計算 | コスト |
|---|---|---|
| キャッシュ済み入力 | 10万トークン × 0.50ドル/100万トークン | 0.05ドル |
| 入力(5分間のキャッシュ書き込み) | 1,000トークン × 6.25ドル/100万トークン | 0.00625ドル |
| 出力 | 1,000トークン × 25.00ドル/100万トークン | 0.025ドル |
| 合計 | 0.08125ドル |
表1. キャッシュ済みコンテキスト10万トークン、新規入力1,000トークン、出力1,000トークンの Opus 5 リクエストにかかる、仮のAPIコスト。
コンテキストが90万トークンなら、キャッシュ済み入力だけで0.45ドルかかる。GPT-5.6 のモデルのようにキャッシュ済み入力の料金が2倍になるとすると、コンテキストを10万トークンから90万トークンに増やしたときのキャッシュ済み入力のコストは、9倍ではなく18倍に増える。
つまり、Claude の料金は一定でも、コンテキストが増えればコストは大きく増える。対照的に、Codex は標準で27万2,000トークンの境目に達する前に自動圧縮を行うので、コンテキストの大きさが抑えられ、コストも低く保たれる。OpenAI は、100万トークンのコンテキストは多くの場合不要だ、あるいはコンテキストを短くすることによる性能の低下はコストの節約で埋め合わせられる、と見込んでいるのかもしれない。
数百万トークンのコンテキストへの外挿
対応しているコンテキストウィンドウ(最大でおよそ100万トークン)の範囲内では、この違いは GPT を不経済にするほど大きくはない。長いコンテキストの用途の多くでは、料金が2倍になっても許容できるかもしれない。しかし、仮に両方のモデル系列がもっと長いコンテキストウィンドウをもっていたら、これがどう変わりうるかも考えることができる。
これを示すため、当てはめた伸び方の関係を、最大1,000万トークンのコンテキストまで外挿した。GPT のモデルには既存の二次の当てはめを、Claude のモデルには線形の当てはめを使った。はっきりさせておくと、Claude のモデルの伸び方が完全に線形だと主張しているわけではない。二次の係数が線形の当てはめで近似できるほど小さい、ということである。これはレイテンシの予測ではなく、ストレステストとして扱う。測定自体はおよそ100万トークンまでしかなく、その範囲の外ではモデルや配信システムが異なる振る舞いをする可能性がある。
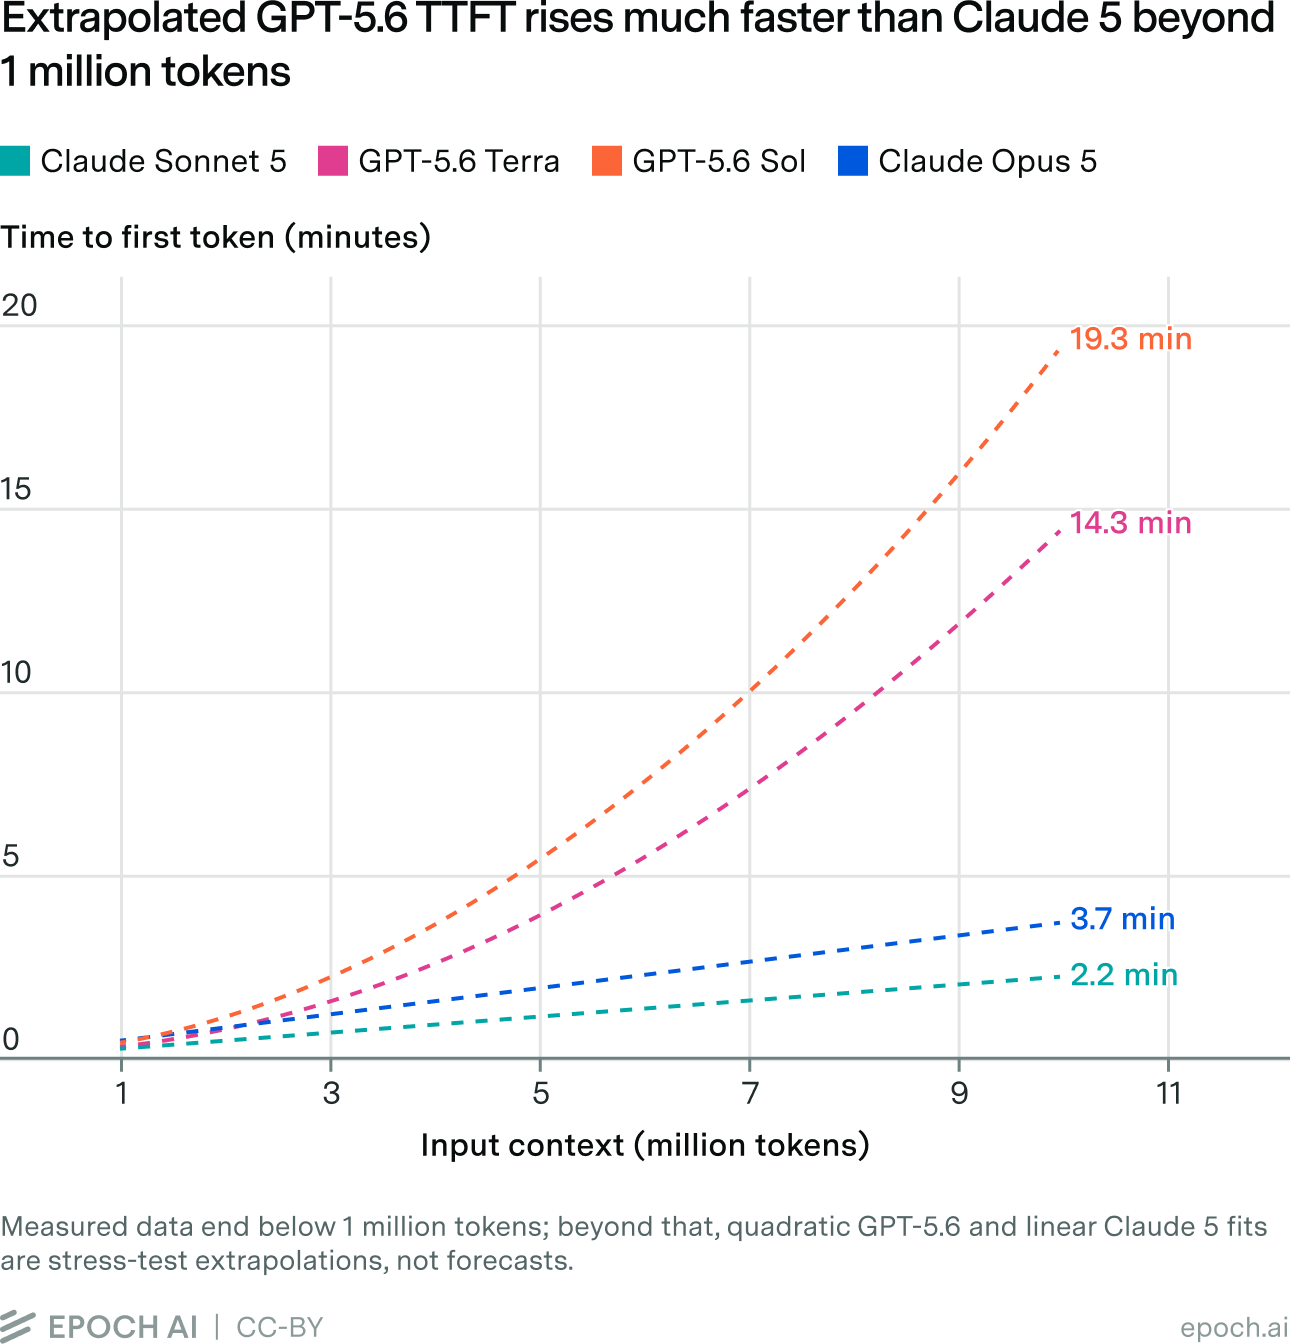
この開きを見るもう一つの方法は、さまざまなコンテキスト長で、さらに1万トークンを追加したときのTTFTの限界的な増分を見ることである。
| モデル | コンテキスト10万トークン時 | コンテキスト100万トークン時 | コンテキスト1,000万トークン時 |
|---|---|---|---|
| GPT-5.6 Terra | 0.071秒 | 0.216秒 | 1.66秒 |
| GPT-5.6 Sol | 0.136秒 | 0.324秒 | 2.20秒 |
| Claude Sonnet 5 | 0.129秒 | 0.129秒 | 0.129秒 |
| Claude Opus 5 | 0.218秒 | 0.218秒 | 0.218秒 |
表2. さまざまなコンテキスト長で、入力トークンを1万追加したときに増えるTTFT。1,000万トークンの値は測定範囲を超えて外挿したもの。Claude のモデルは線形に外挿しているので、増分の時間は一定である。
このように長いコンテキストまで外挿すると、伸び方の違いがもつ意味がよりはっきりする。1,000万トークンでは、GPT のモデルの二次曲線は、追加トークンあたりのTTFTの増分が100万トークン時のおよそ7〜8倍になることを示している。そうなれば、これらのモデルの配信はずっと難しくなるだろう。
これは、長い期間にわたって動くエージェントシステムにとって、別のトレードオフを生む。トークン数の上限がこのように大きくなっても配信コストがコンテキストに対して線形に伸び続けるなら、より多くの履歴を記憶としてエージェントのコンテキストに残しておくことが経済的になりうる。そうすれば、記憶をモデルの水準で扱えるようになる。逆に配信コストがコンテキストの二乗で伸びるなら、外部の記憶システムと積極的な圧縮を使うほうがよいかもしれない。
付録
A. 測定の設定
A.1 リクエストの構成と、共通プレフィックスのキャッシュ
各モデルについて、プロンプトは次のように作成した。
{fixed cached prefix}{16-digit nonce}{target-length-specific text}{fixed task instruction}16桁のノンスは、リクエストごとに変わる一意の数である。目標の長さに応じたテキストは、Project Gutenberg のテキストをつなげたものから切り出した部分である。ノンスがそのままキャッシュの区切りになるよう、区切りはノンスの直前に置いた。ノンスが毎回変わるので、それより先でプレフィックスのキャッシュがヒットすることはない。タスクの指示は固定で、「考えたり分析したりしないこと。ちょうど1語、OK とだけすぐに答えること」(“Do not think or analyze. Respond immediately with exactly one word: OK”)とした。同じモデルに同じコンテキスト長でリクエストを送る場合、プロンプトのうち変わるのはノンスの部分だけである。
OpenAI へのリクエストでは、明示的なプロンプトキャッシュの区切り、明示的なキャッシュモード、セッション固有の prompt_cache_key を1つ使った。Anthropic へのリクエストでは、有効期限(TTL)5分の明示的なキャッシュの区切りを使った。GPT のモデルどうしではプロンプトは同一だった(リクエストごとに変わるノンスを除く)。Claude のモデルどうしでも同様である。検証したモデルでは、同じ系列ならプロンプトのトークン数が同じだったためである。
キャッシュするプレフィックスの大きさは2048を目標とした。実際の大きさは GPT のモデルで2051、Claude のモデルで2052だった。残りのテキストはおよそ4万8,000トークンから89万8,000トークンまでの範囲だった。まず、安定したプレフィックスとキャッシュされていないノンスだけを含むキャッシュのウォームアップ用リクエストを送った。測定したすべてのリクエストで、キャッシュ済みトークン数がちょうど期待どおり(GPT のモデルで2051、Claude のモデルで2052)報告されたことを確認した。
回帰では名目上のコンテキスト長を使った。これは、仮のノンスと、末尾がわずかに異なるテキストを使って事前に計算したものである。提供元が報告した実際の入力長は、名目上の値と比べて、OpenAI ではちょうど2トークン、Anthropic では6トークン短かった。
A.2 長いコンテキストでTTFTが手がかりになる理由
推論実行は、プリフィル(prefill)とデコード(decode)という別々の段階に分かれる。プリフィルは入力トークンの処理であり、デコードは出力トークンの処理である。入力トークンはプリフィルの間に並列に処理できるが、デコードのトークンは自己回帰的に1つずつ生成しなければならない。コンテキストが十分に長く、利用できる計算資源を使い切るだけの入力トークンがあると、プリフィルは計算律速になりうる。TTFTには、プリフィル、最初の出力トークンの生成、その他の配信やネットワークのオーバーヘッドが含まれる。コンテキストが長いとプリフィルに何秒もかかることがあり、測定したTTFTに占めるプリフィル時間の割合は大きくなるはずである。そのため、TTFTには配信システムのオーバーヘッドも含まれることを踏まえつつ、TTFTはプリフィルにかかる時間と、それがコンテキスト長に応じてどう伸びるかについての手がかりになると考える。
A.3 TTFTの計時とリクエストの実行
リクエストは順番に送った。各モデルで、持続的なHTTP接続を1本使った。各リクエストが終わるのを待ってから次を送った。推論(reasoning)と思考(thinking)は無効にし、応答で推論トークンが使われていないことを確認した。
TTFTは単調増加する時計で測定し、HTTPリクエストを送る直前から、ストリーミングで最初の空でないテキスト差分が届くまでの時間とした。プロンプトの組み立て、トークン数の計算、シリアライズ、リクエストの構築は計時を始める前に行った。測定したTTFTには、リクエストのアップロード、ネットワークの時間、ルーティングとキューイング、キャッシュの参照、プリフィル、最初のトークンの生成、そして返送の経路が含まれる。
A.4 ランダム化した時系列のブロック
リクエストはブロック単位で送り、各ブロックには検証するコンテキスト長ごとに1件ずつリクエストを含めた。ループは、リクエストの送出間隔を4秒にすることを目標とした。記録されたリクエスト開始間隔の中央値は、Terra で4.01秒、Sol で4.75秒、Sonnet で4.39秒、Opus で9.00秒だった。長いリクエストがあると、間隔は4秒を超えた。
表A1.
| モデル | 検証したコンテキスト長 | 繰り返し回数 | リクエストの総数 |
|---|---|---|---|
| Terra | 50k, 100k, 175k, 250k, 275k, 375k, 550k, 750k, 850k | 8 | 72 |
| Sol | 50k, 175k, 250k, 275k, 550k, 850k | 5 | 30 |
| Sonnet | 50k, 100k, 175k, 250k, 375k, 550k, 750k, 900k | 14 | 112 |
| Opus | 50k, 100k, 175k, 250k, 375k, 550k, 750k, 900k | 6 | 48 |
各ブロックの中でコンテキストの順序をシャッフルし、短いプロンプトと長いプロンプトが時間的に入り混じるようにして、コンテキスト長と、変化する配信状況とが交絡するのを減らした。
各回帰には、ブロックごとに、合計がゼロになる固定効果も含めた。これは、ネットワークや配信状況の変化など、ブロック間で基準となるレイテンシが変わることを考慮するためである。ブロック効果を取り除いても、Terra、Sol、Sonnet の曲がりの推定値はほとんど変わらない。Opus の点推定値はブロックの定式化により敏感だが、線形か二次かという結論は変わらない。
A.5 なぜ共通プレフィックスを使うのか
共通プレフィックスの方法を採用したのは、キャッシュを無効にした初期の Claude の測定で、各コンテキスト長でのTTFTのばらつきが非常に大きかったためである。共通プレフィックスを採用すると、ばらつきは大幅に小さくなった。特に Sonnet 5 では、中央絶対偏差がコンテキスト10万トークンで0.318秒から0.136秒に、25万トークンで0.352秒から0.107秒に下がった。ただし、こうして改善しても、Opus は依然として他のモデルよりかなりノイズが多かった。
キャッシュありとなしを比べる詳しい調査は行っていない。共通プレフィックスの目的は、キャッシュの同一性を固定しておくことである。ノイズが減ったのは、配信を担う範囲が狭まったか、ルーティングが安定したことを反映しているのではないかと推測している。たとえば、キャッシュとの結びつき(キャッシュアフィニティ)によって、すべてのリクエストが同じデータセンターや同じワーカーエンジンに振り分けられているのかもしれない。キャッシュに応じてルーティングがどう変わりうるかについての資料はいくつかあるが、それについて具体的なことを述べられるほどの情報はない。
B. 共通の伸び方のモデル
リクエスト (ブロック に属する)について、 を観測されたTTFT、 を入力長(単位は100万トークン)とする。次の式を当てはめる。
ここで は当てはめたレイテンシ、 はブロック効果であり、次を満たす。
線形の当てはめでは = 0 とする。
以下の3つの推定量のすべてで、同じレイテンシ曲線を使う。異なるのは、TTFTの残りの変動の扱い方である。
C. スチューデントのt回帰
主な当てはめでは、自由度4のスチューデントのt尤度を使う。
裾の重い尤度によって、異常に遅いリクエストの影響を抑えられる。 には制約を課さないので、当てはめた曲線は正・ゼロ・負のいずれの曲がりもとりうる。
D. 確率的フロンティア回帰
頑健性の確認として、測定されたレイテンシの一部が正の追加遅延から生じうるモデルも当てはめる。
ここで は左右対称な残差項である。 の項は、TTFTを増やす方向にしか働かない追加のレイテンシを表す。たとえばキューイングなど、配信処理での競合から生じるものである。
この当てはめでは ≥ 0、 ≥ 0 という制約を課す。得られる の曲線は、モデル化した正の遅延を取り除いたレイテンシの推定値と解釈できる。
指数分布の項は連続なので、ごく小さい場合でも、すべてのリクエストに何らかの正の遅延が割り当てられる。
E. 「スパイク+競合」回帰
確率的フロンティアのモデルでは、リクエストの競合遅延がちょうどゼロになることを許さない。そこで、それを許す混合モデルも当てはめる。
= 0 なら、そのリクエストにはモデル化した競合遅延がない。 = 1 なら、指数分布から引いた正の遅延が追加される。
したがって、当てはめた は競合が生じる成分の混合確率の推定値であり、 は競合が生じたときに加わる遅延の平均である。
フロンティアの当てはめと同様に、 ≥ 0、 ≥ 0 という制約を課す。競合のない成分の幅がゼロに向かってつぶれるのを防ぐため、 は二次の Huber 予備当てはめの負の残差を使って定め、フロンティアとスパイクの各当てはめでは固定した。報告した Huber の区間は、二次の Huber 再当てはめについて5,000回のブロック単位ブートストラップを行ったものである。一方、フロンティアと「スパイク+競合」の区間は、ブロック単位ブートストラップを200回行い、各回で を推定し直したものである。同じ時系列のブロックに属するリクエストは、まとめて再標本化した。
F. 最終的な当てはめの結果
表A2. スチューデントのt分布による二次の当てはめ(xは入力トークン数で、単位は100万)。
| モデル | α | β | γ | σ |
|---|---|---|---|---|
| Terra | 0.6509 | 5.5426 | 8.0265 | 0.2329 |
| Sol | 0.5939 | 11.5657 | 10.4159 | 0.2828 |
| Sonnet | 0.4665 | 13.1185 | -0.2058 | 0.3039 |
| Opus | 1.7975 | 20.3596 | 1.5754 | 1.4844 |
表A3. スチューデントのt分布による線形の当てはめ(xは入力トークン数で、単位は100万)。
| モデル | α | β | σ |
|---|---|---|---|
| Terra | -0.2774 | 12.6392 | 0.5100 |
| Sol | -0.7775 | 21.2691 | 0.6930 |
| Sonnet | 0.4890 | 12.9376 | 0.3044 |
| Opus | 1.6023 | 21.7917 | 1.4935 |
表A4. スチューデントのt当てはめにおけるブロック効果の感度。
| モデル | ブロック効果なしのγ | ブロック効果ありのγ |
|---|---|---|
| Terra | 7.7728 | 8.0265 |
| Sol | 10.4687 | 10.4159 |
| Sonnet | -0.1932 | -0.2058 |
| Opus | -0.2177 | 1.5754 |
表A5. 二次か線形かについての証拠。
ΔAICc は AICc_linear − AICc_quadratic と定義する。したがって正の値は二次モデルを支持する。
| モデル | 2Δlog L | 尤度比検定のp値 | ΔAICc | Huber によるγの95%区間 | Huber でγ > 0 となる割合 |
|---|---|---|---|---|---|
| Terra | 78.30 | 8.87 × 10⁻¹⁹ | 75.50 | [6.82, 9.12] | 100% |
| Sol | 41.05 | 1.48 × 10⁻¹⁰ | 37.29 | [8.97, 13.04] | 100% |
| Sonnet | 0.138 | 0.711 | -2.65 | [-1.22, 1.29] | 51.3% |
| Opus | 0.147 | 0.701 | -2.90 | [-6.30, 9.70] | 55.5% |
表A6. 非対称な推定量についての、ブロック単位ブートストラップによるγの区間。
| モデル | フロンティアによるγの95%区間 | スパイクによるγの95%区間 |
|---|---|---|
| Terra | [6.65, 8.55] | [6.27, 8.85] |
| Sol | [9.34, 12.64] | [9.31, 11.03] |
| Sonnet | [0, 0.93] | [0, 1.03] |
| Opus | [0, 8.33] | [0, 8.24] |
結果は、Terra と Sol に正の曲がりがあることを強く支持している。Sonnet は、2つの非対称な推定量の点推定値のどちらでも曲がりゼロの境界にある。一方、Opus は決め手を欠いたままである。
G. GPT-6 Astra
Astra のTTFTの伸び方を測定すると、GPT-5.6 のモデルと同様に、依然として大きな二次の成分があることがわかる。
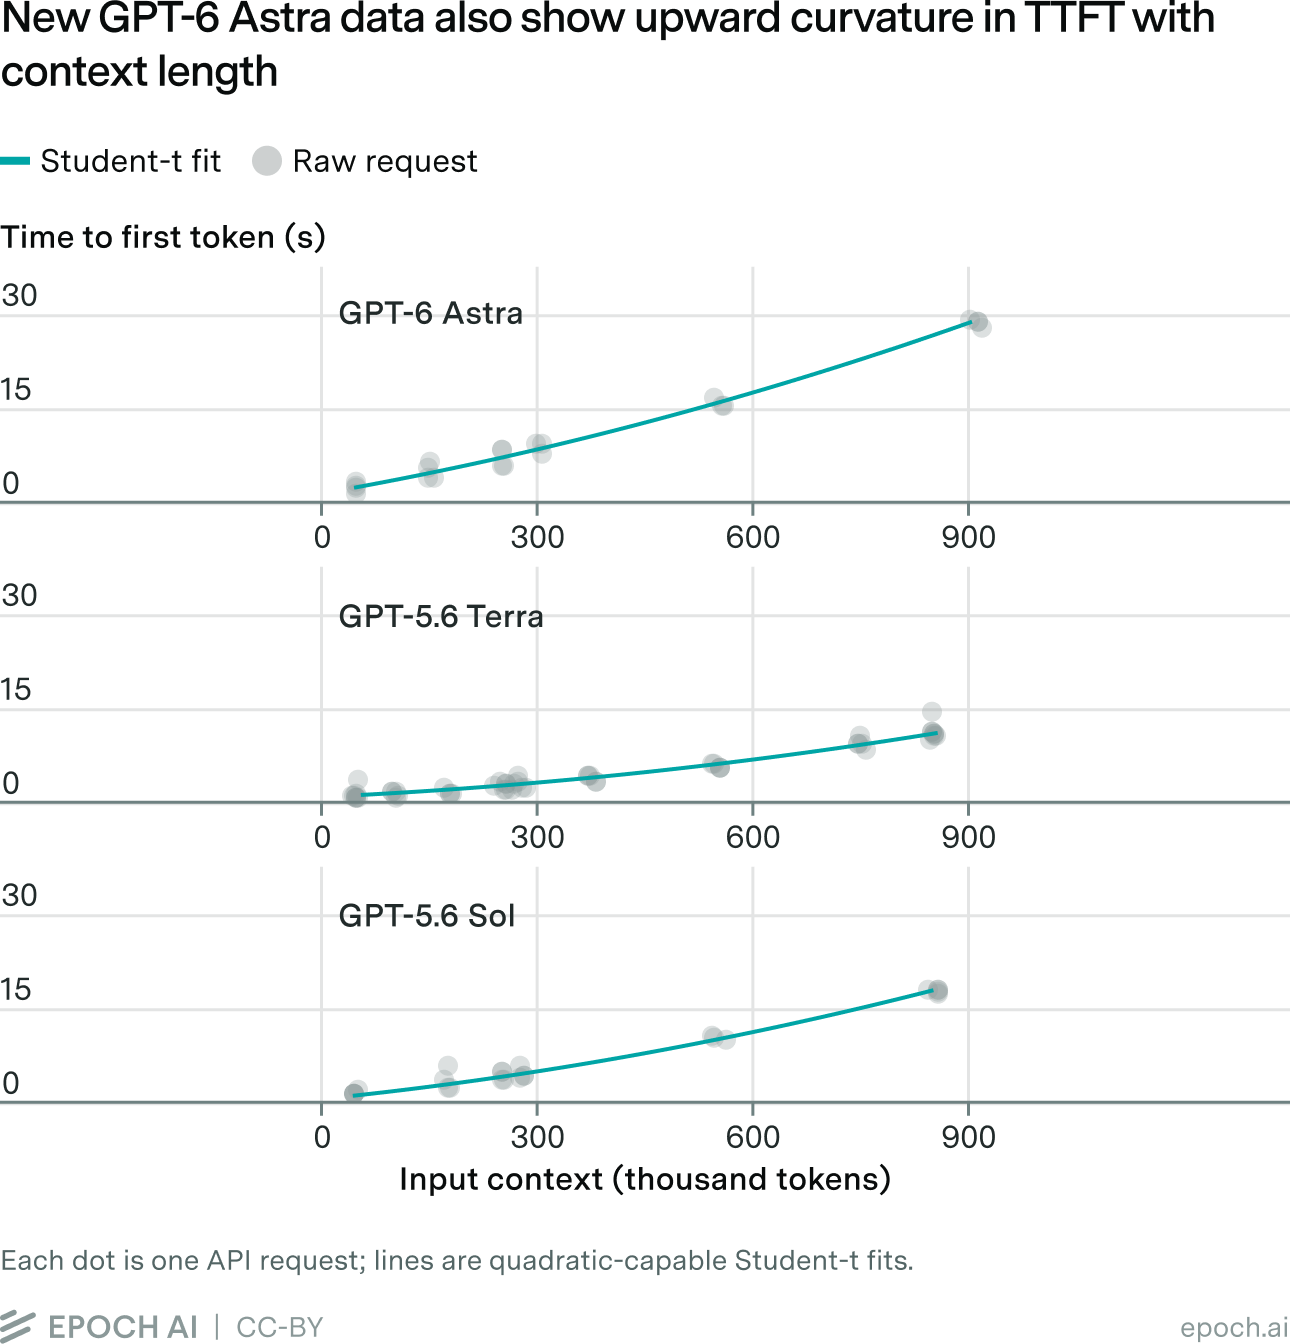
表A7. GPT-6 Astra についての、二次か線形かの証拠。
| モデル | 2Δlog L | 尤度比検定のp値 | ΔAICc | Huber によるγの95%区間 | Huber でγ > 0 となる割合 |
|---|---|---|---|---|---|
| GPT-6 Astra | 26.73 | 2.34 × 10⁻⁷ | 22.67 | [8.62, 16.24] | 100% |
表A8. GPT-6 Astra についての、スチューデントのt分布による二次の当てはめ(xは入力トークン数で、単位は100万)。
| モデル | α | β | γ | σ |
|---|---|---|---|---|
| GPT-6 Astra | 1.4814 | 20.4760 | 11.6319 | 0.4858 |
H. コード
ベンチマーク、モデルの当てはめ、図の再現のためのコードは、次のリポジトリで公開している。