
レポート
Huaweiは2030年までにNvidiaに追いつくのか?
原題:Will Huawei catch up to Nvidia by 2030?
要点
- Huaweiは現在、チップ1個あたりの性能でもAIチップの生産量でもNvidiaに後れをとっている。 Huaweiで最も強力なチップであるAscend 950の性能は、2022年に出荷が始まったNvidiaのH100のおよそ半分であり、今年のHuaweiの計算資源の生産量はNvidiaの4%に満たない。
- Huaweiが公表したロードマップは野心的だが、Nvidia自身のチップ1個あたりの性能向上を考えると不十分である。 Huaweiのチップは、少なくとも2030年まではNvidiaに3〜4年遅れたままだろう。
- HBMはHuaweiの生産における最大のボトルネックであり、中国国内の製造能力の拡大だけでは、2030年までにNvidiaに追いつくには足りない。 中国製のHBMだけを使う場合、Huaweiの計算資源の生産量は2028年までNvidiaの1%程度にとどまる可能性がある。
- HBMをさらに密輸すればHuaweiの生産量は増えるが、Nvidiaと競えるほどにはならない。 2028年にHuaweiが国内供給全体の10倍の使用可能なHBMを密輸したとしても、その生産量はNvidiaの約16%にとどまる。
- 2028年までに、Huaweiの制約はHBMの供給からチップ1個あたりの性能へと移り始める。 中国国内のHBM生産が拡大するにつれて、使用可能なHBMの差は2026年の73倍から2028年には11倍へと縮まる。一方、メモリ1 GBあたりの計算能力で見たNvidiaの優位は、3倍近くから6倍へと広がる。
- LogicFoldingは、チップ1個あたりの性能の劣位を克服するためのHuaweiの長期的な賭けである。 ロジックを垂直に積み重ねることで、5〜7 nm級のプロセスにとどまりながらも平面換算のトランジスタ密度を高めることを狙っているが、LogicFoldingを使う最初のAscendチップは2030年まで登場しない。
概要
米中のAI競争は、アプリケーションやモデルから、データセンターのインフラ、チップ、半導体製造装置に至るまで、技術スタック全体に及んでいる。チップと製造装置はこのスタックの土台であり、それぞれがどれだけの計算資源を投入できるかを決める。このことは、今後何年にもわたって競争に大きな影響を与えるだろう。
だからこそ半導体の輸出規制は米国のAI政策の柱となってきたのであり、中国国産のチップ産業が米国のそれとどう比べられるかに多くがかかっているのである。中国を代表するAIチップ設計企業であるHuaweiは、AI計算資源の生産を国産化しようとする中国の進捗を測るうえで有用な指標になる。1
Huaweiは、IEEE ISCAS 2026の基調講演でチップのロードマップを示し、2026年の年次カンファレンスではその前倒し版を披露した。このロードマップは野心的である。各チップにより多くの計算能力を詰め込み、はるかに多くのチップを単一の高速システムにつなぎ、さらにそのハードウェアのうち実際にどれだけが使われるかを左右するソフトウェアを成熟させる計画だ。しかしNvidiaも最先端を押し広げ続けている。新しいRubinアーキテクチャは前世代のBlackwellと比べてメガワットあたり5.4倍の性能を実現するとNvidiaは主張しており、次のFeynman世代は2028年にそれをさらに押し上げる見込みである。Nvidiaが大きく前進するなかで、Huaweiは差を縮められるのだろうか。
計算資源の総量は、チップ1個あたりの性能とチップの生産数の両方で決まる。Huaweiは現在そのどちらでもNvidiaに後れをとっており、米国の輸出規制がそのいずれの改善も妨げている。
短期的には、広帯域メモリ(HBM)の供給不足がHuaweiの生産を縛る制約となっている。国内のHBMを、外国製HBMの備蓄、より帯域幅の低い代替メモリ、密輸したHBMで補ったとしても、2026年にHuaweiが生産するAI計算資源はNvidiaの4%未満にとどまると私たちは推定している。中国製のHBMだけを使う場合、その生産量は2028年までNvidiaの1%程度にとどまる可能性がある。
2030年にかけて中国のHBM生産が拡大するにつれて、メモリ供給の差は縮まるが、Huaweiのチップ1個あたりの性能の低さが同程度の制約になってくる。Huaweiのチップは2030年まで、Nvidiaにおよそ3〜4年遅れ続けるだろう。Nvidiaもチップ性能を高めるために同じ手段を追求しており、しかもHuaweiが利用できない、より微細なプロセスノードによってその進歩を積み増している。たとえHuaweiがロードマップを実現し、中国のメモリメーカーが増産目標を達成したとしても、この10年のうちに差を埋めるには足りないだろう。
チップ性能を高めるためのHuaweiの長期的な賭けはLogicFoldingである。これは能動的なロジック層を垂直に積み重ね、はるかに先進的なプロセスノードに匹敵するトランジスタ密度を実現する技術だ。しかし、これを使う最初のAscendチップが登場するのは2030年の予定であり、1.6 nm級プロセスでロジックを積層したNvidiaのFeynmanの出荷が見込まれる時期の2年後になる。
本レポートの以下の部分では、これらを順に検討する。2026年時点でHuaweiはどこに立っているのか、なぜそのロードマップでは性能差を埋められないのか、なぜ国内のメモリ生産を増やしてもチップの数量の差を埋めるには足りないのか、そしてLogicFoldingへのHuaweiの賭けが2030年以降にどんな意味を持ちうるのか、である。
本レポートは、AIチップの用語をある程度知っていることを前提にしている。必要な読者のために、関係するチップの構造を以下で簡単に説明する。詳しく読む:AIチップの構造
「チップ」という言葉はゆるやかに使われている。ダイと呼ばれる個々のシリコン片を指すこともあれば、パッケージ化された完成品全体を指すこともある。
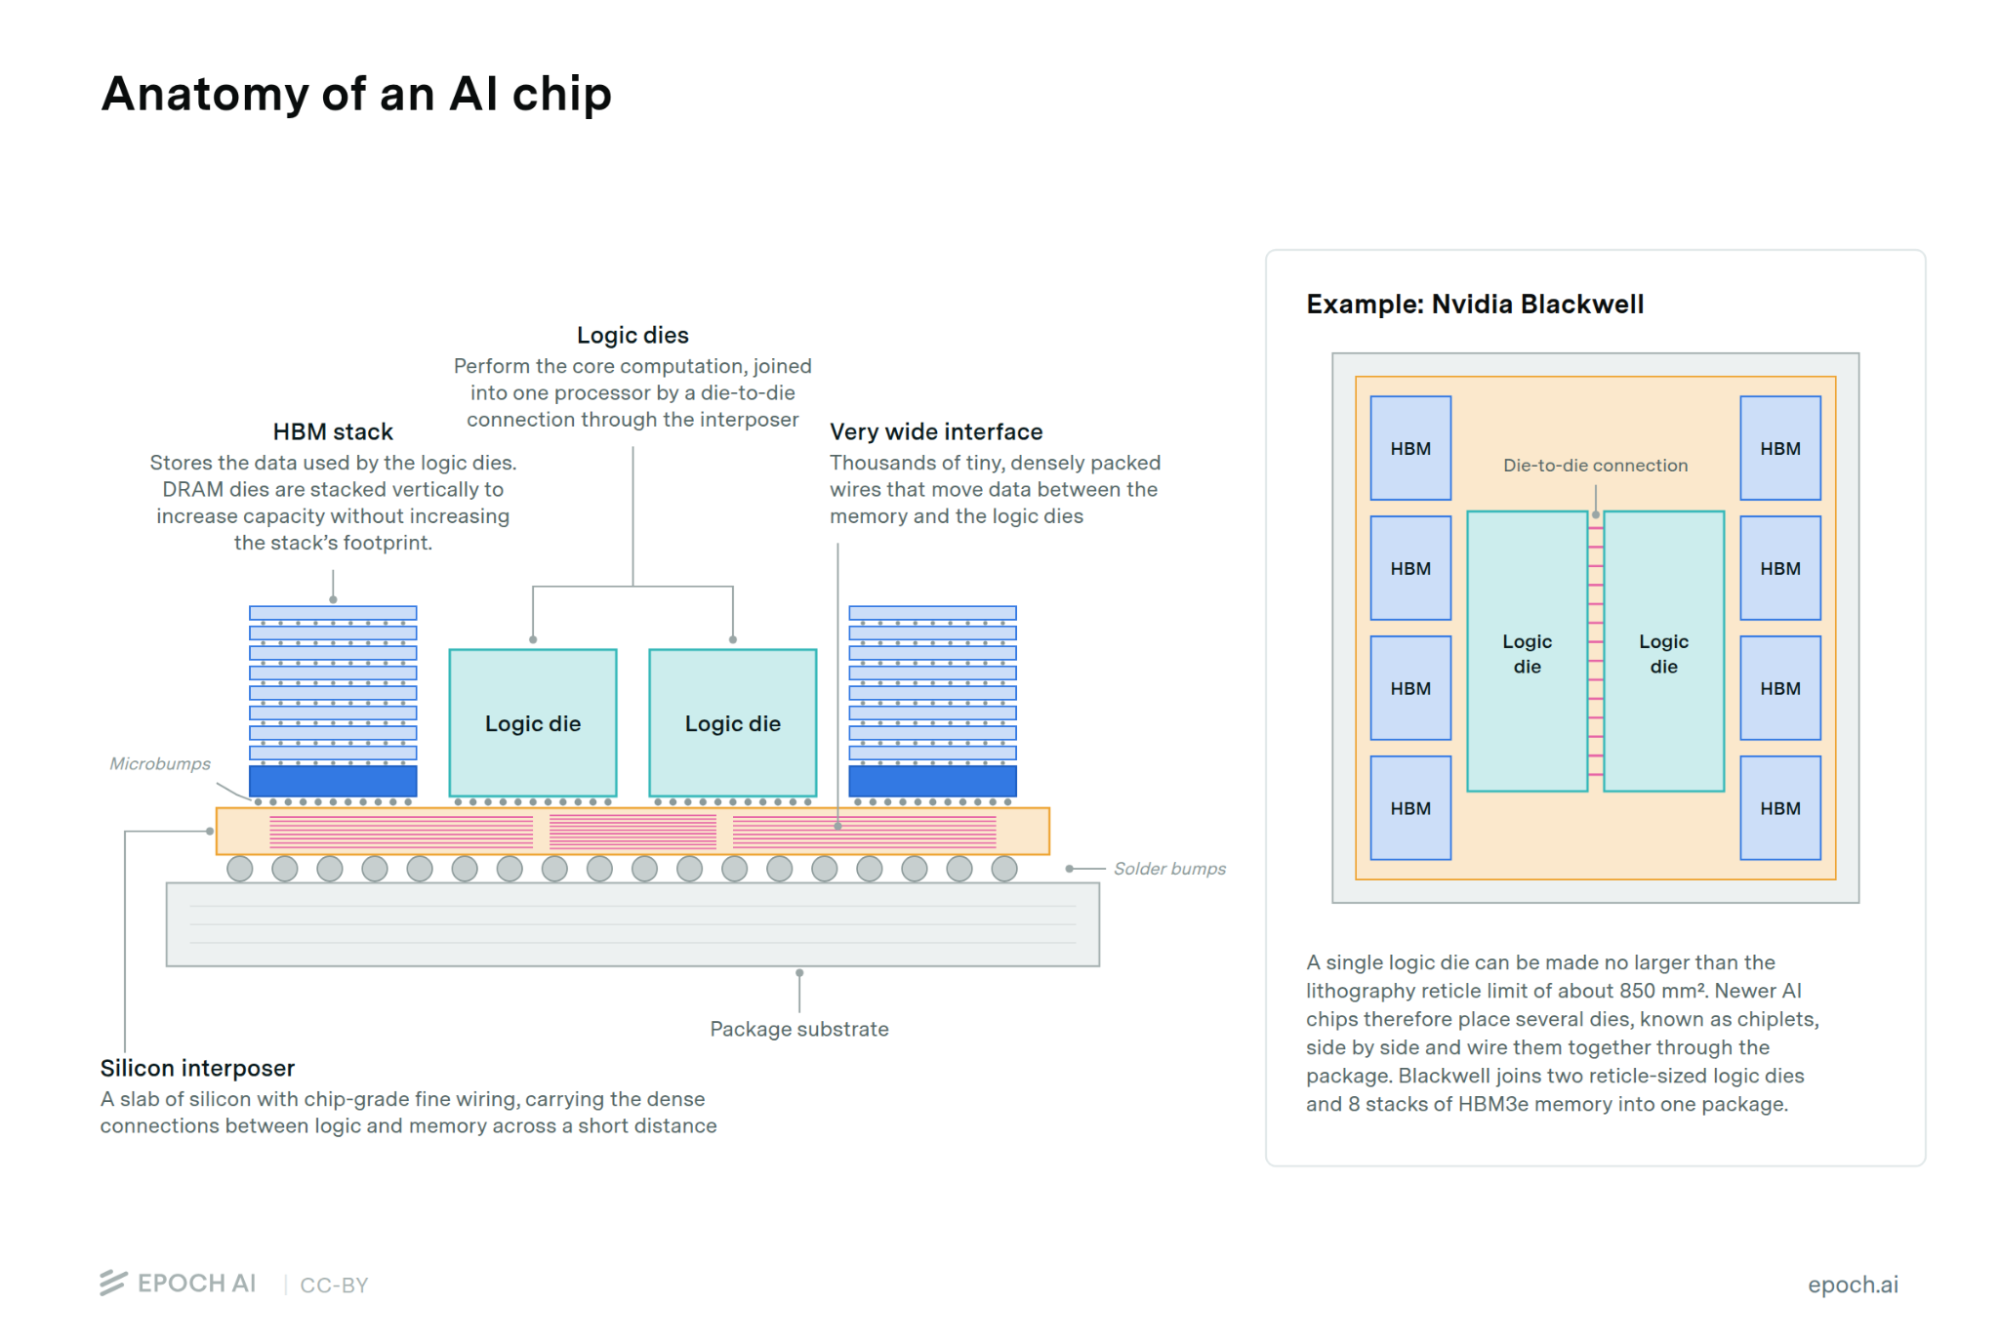
チップの中核となる2つの構成要素は、ロジックとメモリである。ロジックダイが中核となる計算を行い、広帯域メモリ(HBM)がデータを保存して、ロジックダイとの間でデータを出し入れする。ロジックダイの性能は、演算ユニットをいくつ持つか、それらがどれだけ速く動くか、そしてチップがそれらにどれだけ効率よくデータを供給し続けられるかで決まる。これらの要因は、ロジックダイの大きさと数、チップのアーキテクチャ、クロック速度、メモリとインターコネクトの帯域幅、電力の上限、そしてトランジスタをどれだけ高密度に詰め込めるかを決めるプロセスノードに左右される。
HBMは、DRAMダイを積み重ねて作られるメモリである。ダイを垂直に積み重ねるのは複雑な後工程だが、積層によってパッケージの占有面積あたりの容量が大幅に増えるため、最先端のAIチップはこれに頼っている。HBMはロジックダイの横に置かれ、両者は非常に幅の広いインターフェースでつながれて、膨大な帯域幅でデータをやりとりする。そのためには、細く高密度に詰め込まれた何千本もの配線が必要になる。これを収めるために、ロジックダイとHBMはインターポーザの上に載せられる。インターポーザは通常、高密度の銅配線を持つ受動的なシリコンダイである。接続が短く、データ経路が何千本もあるため、回路基板を介して接続する従来のDDRよりはるかに広い帯域幅が得られる。
1つのパッケージにどれだけのシリコンを載せられるかは、インターポーザで決まる。ロジックダイ1枚の大きさには限界がある(約850 mm²)ので、1つのパッケージにより多くの計算能力を詰め込むために、新しいAIチップは複数のダイ、つまりチップレットを並べて置き、インターポーザを介してつないでいる。たとえばNvidiaのBlackwellは、2枚の大きなロジックダイと8スタックのHBMを1つのGPUにまとめている。
2026年時点のHuaweiの出発点
HuaweiとNvidiaを比べる主な指標は、それぞれが生産する実効的な計算資源の量である。以下では、この指標の2つの構成要素である性能と生産量を見たうえで、両者を組み合わせる。
ハードウェアの性能
Huaweiが2026年に生産する主力AIチップはAscend 950である。950には950PRと950DTの2つの派生型がある。
950PRは、推論実行のうち計算負荷の高い段階であるプリフィル向けに最適化されており、FP4で2 PFLOPSの性能を持ち、Huawei独自のメモリを128 GB、メモリ帯域幅1.6 TB/sを備える。
950DTは2026年第4四半期に予定されており、950PRと同じ計算ダイを使うが、メモリ容量と帯域幅が大きく、144 GBと4 TB/sである。詳しく読む:950におけるHuaweiの設計上の選択
Ascend 950でのHuaweiの設計上の選択は注目に値する。
第一に、Huaweiは2025年時点で最も高性能なAIチップだった910Cと比べて、ロジックの面積を縮小した。約665 mm²のロジックダイ2枚から、約400 mm²のダイ2枚にしたのである。考えられる理由は歩留まりである。報道によれば910Cのロジックダイの多くはTSMC製だったが、950は中国最大の半導体ファウンドリであるSMICの製造にはるかに大きく依存すると見込まれている。欠陥密度は一様なので、ダイの面積が大きくなるほど歩留まりは指数関数的に下がる。成熟度の低いプロセスでは、大きなダイはとりわけ高くつく。そのためHuaweiは、歩留まりを高めて量産の採算をよくするために、より小さなチップレットを選んだ可能性が高い。
第二は、950のメモリの選択である。HuaweiはHBMを入手しにくい。中国最大のメモリメーカーであるCXMTはHBMの生産を拡大しているが、2026年初めの時点ではそのHBM生産量は少なすぎて、数十万個のAscendチップをまかなえなかった。しかしCXMTは、より低コストで帯域幅の低い代替メモリであるLPDDRを相当量生産していた。
2026年第1四半期に量産に入っていた950PRは、おそらくLPDDRに近い特性を持つ、HBM以外のDRAMを使っている。これは、950PRのものとされる画像によっても裏づけられる。この画像では、中央に2枚の計算ダイがあり、その両脇にI/Oダイとみられるものが並んでいる。計算ダイの上下にある大きなモジュールはメモリと思われるが、HBMにしては計算ダイから離れすぎているので、むしろLPDDRだと考えられる。また、CXMTがJEDECのDDRやLPDDRの標準仕様に従うのではなく、Huawei向けに独自のDRAM/ハイブリッドHBMを設計した可能性もある。HuaweiがCXMTのような単一の供給元のメモリを前提に950PRを設計したのであれば、業界標準のインターフェースに合わせる理由は薄くなる。HBM以外のメモリを使う代償は帯域幅の低下である。910Cと950PRはどちらもメモリ容量が128 GBだが、910Cのメモリ帯域幅は2倍ある。
こうしたメモリの制約を考えると、Huaweiが950PRをわざわざプリフィル向けに設計した理由がわかる。プリフィルは推論実行のうち計算負荷の高い段階であり、デコードほどメモリ帯域幅に制約されない。通信1バイトあたりの計算量が多いので、帯域幅の低いチップでも性能の低下は小さくて済む。推論実行のデコード段階は、モデルの重みとKVキャッシュを繰り返し読み出すため、より帯域幅を必要とする。
Huaweiは、入手しやすいが帯域幅の低いメモリをプリフィルに使い、希少なHBMは、追加の帯域幅が性能に最も効くワークロード向けに特化した950DTに回している。950の生産スケジュールもこの見方に合う。950PRは、CXMTのHBM生産量がきわめて限られていた2026年初めに量産に入っており、950DTの量産は、CXMTがHBM生産を拡大する2026年後半に始まる可能性が高い。
性能面では、950はNvidiaのB300に及ばない。2 B300の理論ピーク性能はFP4で13.5 PFLOPSであるのに対し、950は2 PFLOPSで、6.75倍の差がある。この差は、ロジックダイの面積、トランジスタ密度、そしてテンソルコアの設計、クロック速度、電力の上限、データパスといったその他の要因の違いによる。詳しく読む:性能の比較
1ドルあたりの性能で見ると、差は縮まる。13.5 PFLOPSで約40,000ドルのB300は1ドルあたり0.34 TFLOPSであるのに対し、2 PFLOPSで37,000ドルの950DTは0.05である。
1ドルあたりの性能の差は約6.2倍で、カタログ上の計算性能の差である7倍より小さい。ただし、帯域幅に律速されるワークロードでは、(FP4の性能よりも)メモリ帯域幅のほうが適切な尺度かもしれない。1ドルあたりの帯域幅では、B300が1ドルあたり0.2 GB/sであるのに対し、950DTは1ドルあたり0.11 GB/sである。
これらすべての指標について、実際の運用での性能差は、カタログ上の仕様が示すより大きい可能性が高い。Nvidiaのソフトウェアのほうが成熟しており、高い利用率を引き出せるからである。3
Ascendチップは、演算性能でもメモリ帯域幅でも大きく後れをとっている。Ascend 950DTのFP8性能は1 PFLOP/sで、Nvidia H100のおよそ半分であり、メモリ帯域幅はH100と同程度である。言い換えれば、Huaweiの最新で最も強力なGPUの演算性能は、2022年に出荷が始まった2世代前のNvidiaチップの半分にすぎない。つまり、Huaweiのチップ性能は現在Nvidiaに4年遅れていると考えられる。
Huaweiのチップは性能が低いが、スケールアップシステムは大きい。昨年HuaweiはCloudMatrix 384を発表した。これは16ラックにわたる384個のAscendチップを単一の高帯域ドメインにつなぐスケールアップシステムであり、NvidiaのNVL72ラックのGPU 72個と比べて大きい。これはHuaweiのより広い戦略を反映している。チップ1個ずつでは及ばないところを、より多くのチップをつなぐことで全体として補うのである。これはおそらく、Huaweiが現在Nvidiaと最も競り合えている分野だと言える。
生産量
Huaweiは現在、チップの生産量でもNvidiaに後れをとっている。私たちの推定では、2025年にHuaweiが生産したAscendは80万個で、Nvidiaが販売した450万個と比べて少ない。2026年について、私たちの中央推定では、Huaweiの生産は150万個、Nvidiaは590万個である。
これまでのAscendの生産の多くは、外国製の部品にも頼ってきた。ある分解調査によれば、昨年のHuaweiの主力チップであるAscend 910Cは、TSMCが製造したロジックダイと、Samsung/SK HynixのHBMを使っていた。2024年から2025年にかけて、Huaweiは大量のロジックウェハーとHBMを備蓄し、また密輸した。4 その備蓄の多くは2025年のAscendの生産に使われ、私たちのモデルでは2026年に使い切られる。
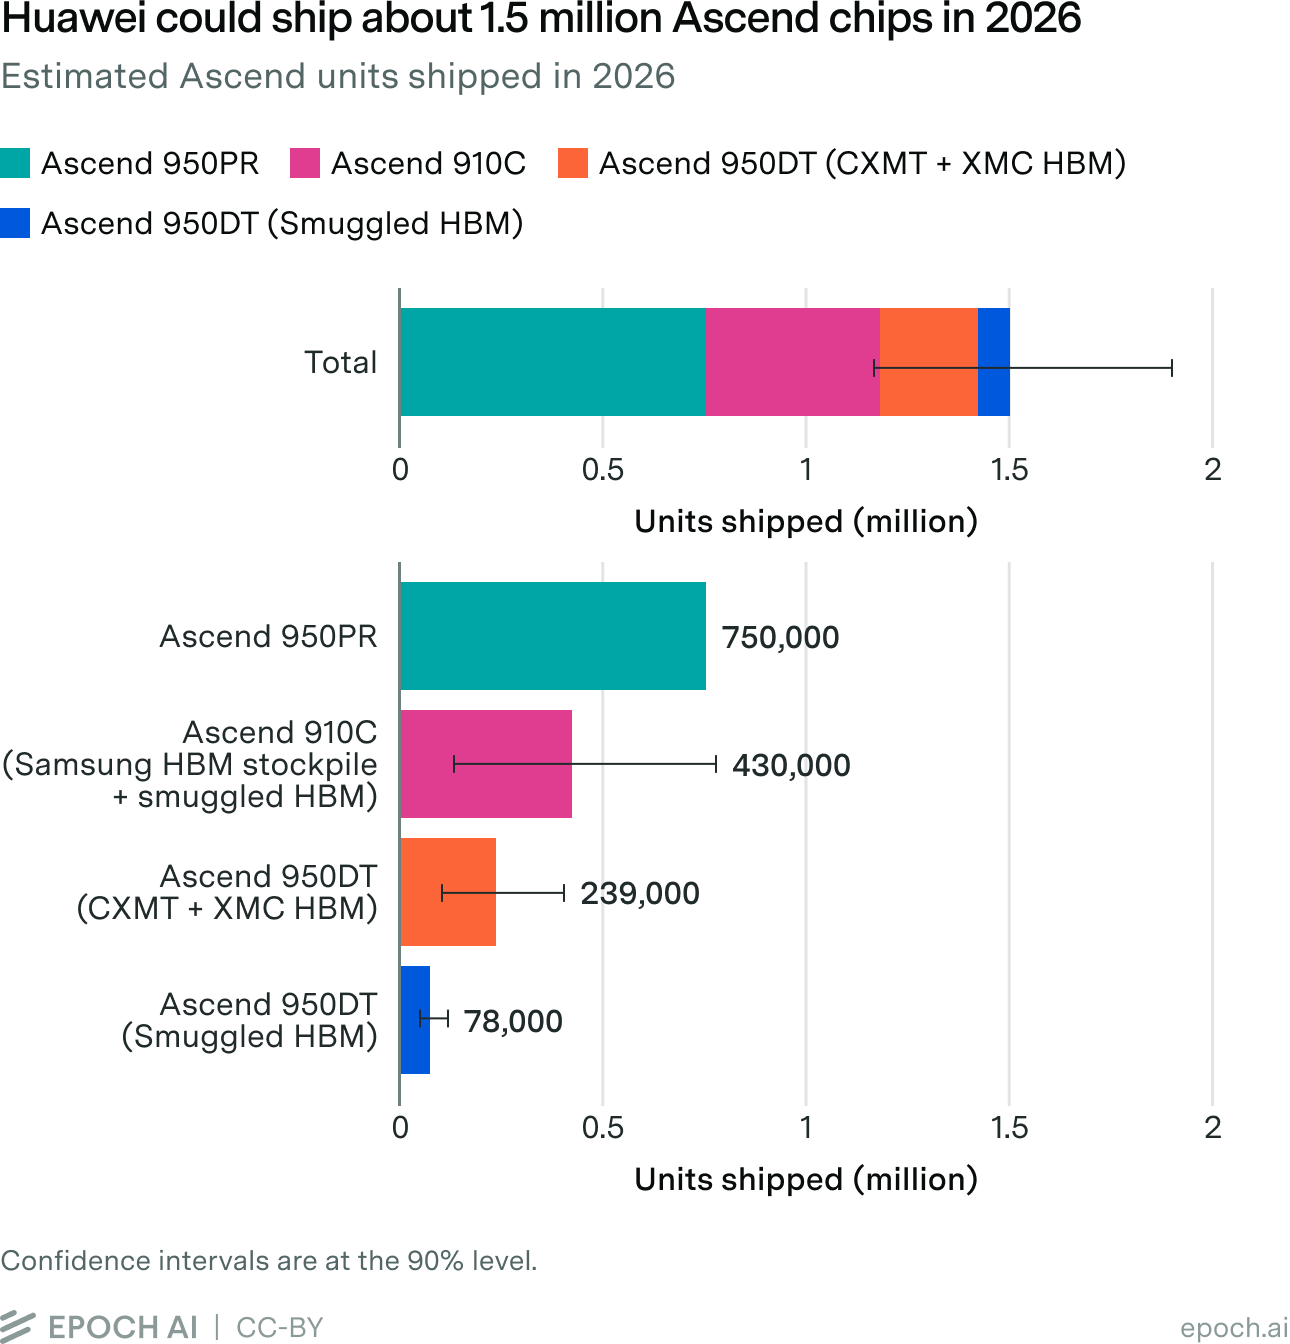
私たちの2026年の推定は、メモリの供給経路ごとのモデル化から得たものである。150万個は950PR、950DT、910Cの組み合わせから成り、国内のHBM生産だけでまかなえる量をはるかに上回る。私たちの中央推定は、Huaweiが2026年に150万個のAscendを出荷する見込みだというWall Street Journalの報道とよく一致している。詳しく読む:2026年のHuaweiの生産とメモリ供給の内訳
Ascendのチップの種類ごとに、メモリの供給源は異なる。Tom's Hardwareは、Huaweiが2026年に950PRを75万個出荷する計画だと報じた。950PRのメモリは従来のHBMではなくLPDDRであり、CXMTから調達できる可能性がある。CXMTは2026年初めまでに、950PRを数十万個まかなえるだけのLPDDRの生産量を確保していた。加えて私たちは、2024年末時点で残っていたHuaweiのSamsung製HBMの備蓄と、2025年に密輸されたHBMとを合わせると、さらに約43万個のAscend 910Cをまかなえると推定している。5 備蓄されたSamsung製HBMは大半が8段積みのHBM2Eであり、950DTのチップアーキテクチャ、メモリ容量、帯域幅の仕様には合わない。しかし、2025年のAscend 910CがSamsung製HBMを使っていたことはわかっているので、Huaweiは残りの備蓄を使って910Cを追加生産する可能性が高い。
残るのは950DTであり、これにはCXMT製または密輸のHBMが使われうる。6 私たちの中央推定では、CXMTとXMCを合わせると、950DTの96GB版約24万個分のHBMを供給できる。7
3種類のチップの推定を合計すると、Ascendの中央推定は150万個になる。内訳は、HBM以外のメモリを使う950PRが75万個、残りの備蓄と2025年に密輸されたHBMを使う910Cが43万個、CXMTとXMCのHBMを使う950DTが24万個、密輸されたHBMを使う950DTが8万個である。この正確な内訳は不確かだが、私たちの中央推定は、Huaweiが入手できた製品とメモリ供給の組み合わせに基づいている。
計算資源の生産量
上記のチップの個数は、そのまま計算資源の量にはならない。チップの種類によって性能が大きく異なるからである。各社が生産する実効的な計算資源を測るために、各チップの総処理能力(TPP)をNvidia H100 GPUの何個分にあたるかで表し、その比にチップの個数を掛ける。H100換算(H100e)は、チップと生産量を共通の尺度で測る方法である。
Huaweiの2026年の推定生産量150万個は、計算資源にして88万H100換算(H100e)にあたる。Nvidiaの590万個は、主にBlackwell UltraとRubinのGPUで、チップ1個あたりの性能がはるかに高いため、2,300万H100eにあたる。Huaweiの出荷数は2025年の80万個からほぼ倍増するが、その生産量は、私たちが推定する2026年のNvidiaの出荷計算資源の4%に満たない。私たちの信頼区間の両端をとっても、Huaweiのシェアは6%にしか達しない。
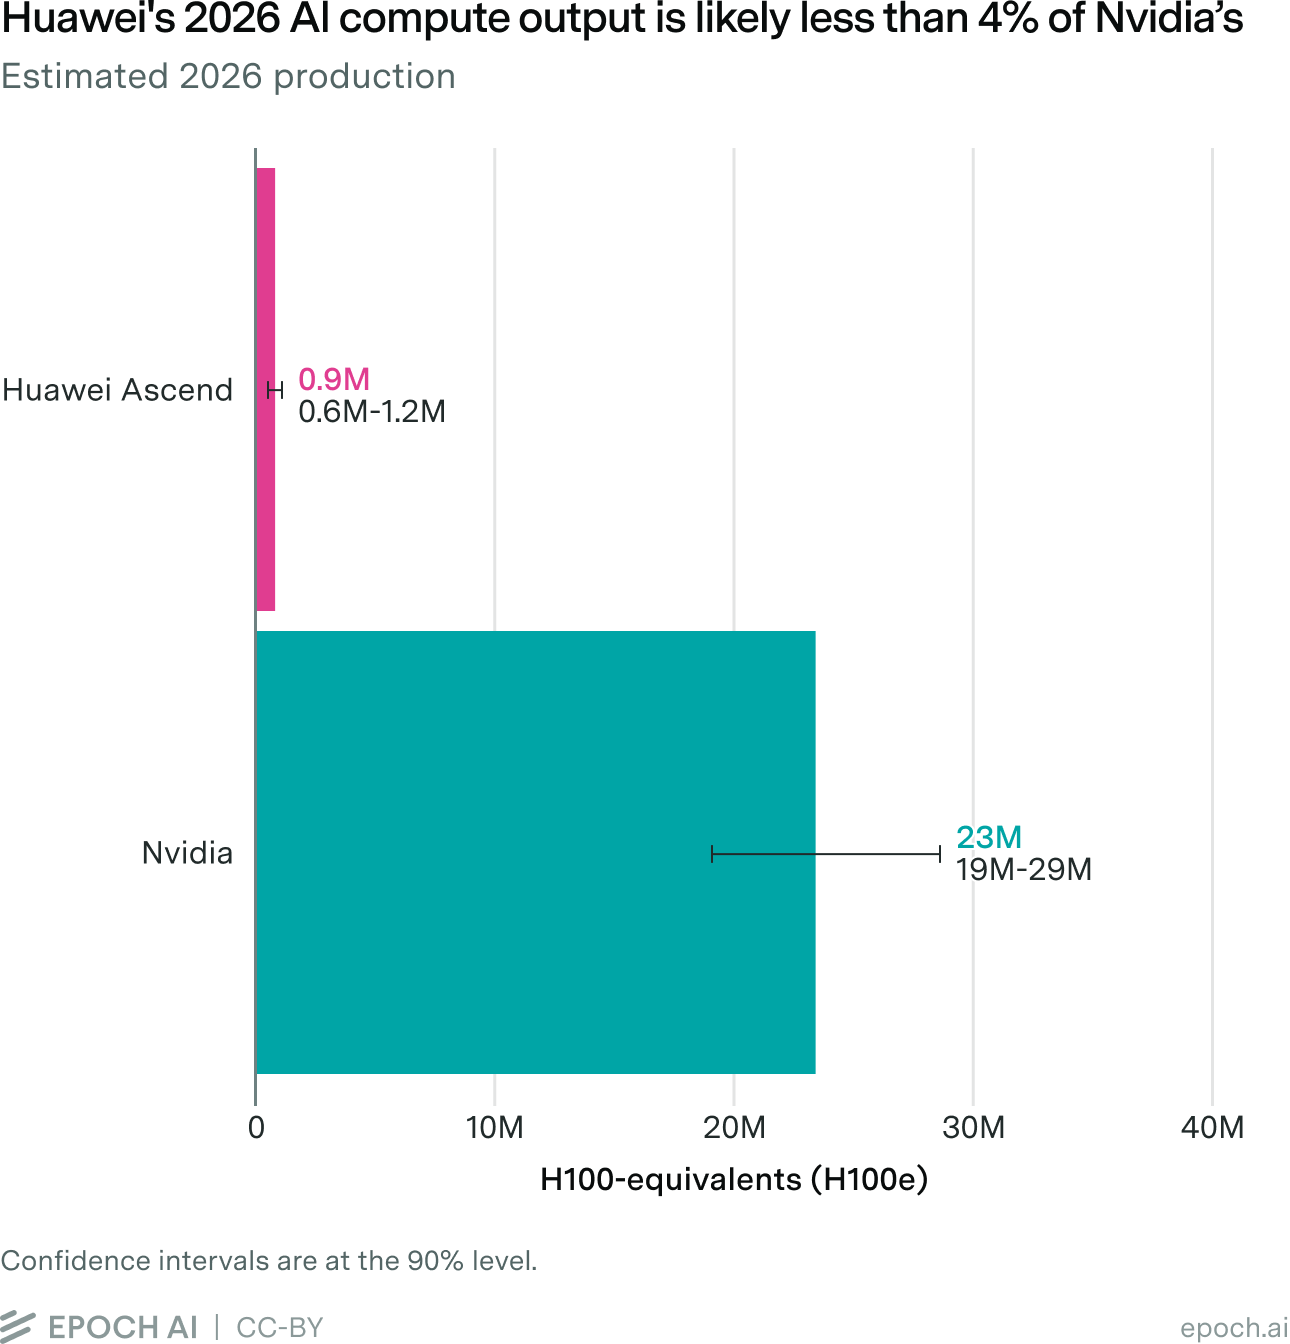
私たちの推定では、HuaweiのAscendチップの生産量はNvidiaの4分の1であり、そのチップのカタログ上の計算性能は約7分の1である。これらの効果が掛け合わさり、2026年にHuaweiが生産する計算資源はNvidiaの約25分の1にとどまる。
ただし、H100換算はカタログ上の比較である。メモリ、スケールアップドメイン、ワークロードの形、応答性、ソフトウェアなどの要因は考慮しておらず、そのいずれもが実際の運用で実現される性能を左右しうる。現時点では、HuaweiのCANNソフトウェアスタックがNvidiaのCUDAよりはるかに未成熟であるため、Huaweiが実際に実現している性能はH100換算の値が示すより低い可能性が高い。Huaweiがソフトウェアとスケールアップドメインでどう競争しうるかは、後で詳しく見る。
2030年までに性能を高めるHuaweiのロードマップ
Huaweiは性能を高めるための野心的なロードマップを示している。すべての主要チップ設計企業と同じく、Huaweiも個々のチップだけでなく、計算システム全体の最適化に力を入れている。Huaweiはこれを「Tau Scaling」と呼んでいる。tauは、データの移動と計算にかかる時間コストを指す。
AIのワークロードを終えるのにかかる時間は、チップがどれだけ速くデータを処理できるかと、その計算ユニットがどれだけ効率よく使われるかの両方で決まる。フロンティアモデルの学習には数万個のAIチップが必要になる。その規模になると通信のオーバーヘッドが大きくなり、チップ内の計算エンジンがデータを待って遊ぶ時間が生じるため、ピーク性能のうち実際に引き出せる割合が下がる。
そのためチップ設計者が時間コストを減らす方法は2つある。各チップの計算性能を高めることと、チップが十分に使われていない時間を減らすことである。前者はシステム全体の計算性能を高め、後者は理論上の計算能力のうち実際に使われる割合を高める。
Huaweiの短期のロードマップは、この両面での向上を見込んでいる。チップ1個あたりの性能を高めるために、各チップの計算性能とメモリ性能を改善する計画である。利用率を高めるためには、より多くのチップをより高速なファブリックで単一のドメインにつなぎ、よりよいソフトウェアを設計する計画である。以下、それぞれを順に見ていく。
チップ1個あたりの性能向上
Huaweiのチップはすでに大きくNvidiaに後れをとっているので、チップ1個あたりの差を縮めることは、Huaweiの計算資源の総生産量を増やすためにも、システムレベルでの拡大への依存度を下げるためにも必要である。
チップの計算性能を高める標準的な方法は4つある。(1)トランジスタ密度を高める、(2)各ダイを大きくする、(3)1つのパッケージにより多くのダイを並べる、(4)チップのアーキテクチャを最適化する、である。そして重要な点として、4つの効果はすべて掛け合わさる。より先進的なプロセスノードは一定の面積により多くの計算能力を詰め込み、より大きなダイはその密度をより広い面積に広げ、より大きなパッケージはより多くのロジックダイとHBMを載せられるようにし、アーキテクチャの最適化はそのシリコンから引き出す性能を高める。
トランジスタ密度
しかし、Huaweiの製造パートナーであるSMICは、TSMCほど高密度にトランジスタを作ることはとてもできない。米国の輸出規制は先進的な露光装置の中国への販売を制限しており、こうした装置を自国で生産しようとする中国の取り組みは2030年以降まで実を結ばない可能性が高い。そのためSMICは、少なくともこの10年の終わりまで、5 nm相当のプロセスより高密度にトランジスタを形成できない。SMICはDUVでさらに微細化を進めることもできるが、そのためにはますます複雑なマルチパターニングが必要になり、スループットが下がり、コストとプロセス上のリスクが高まる。
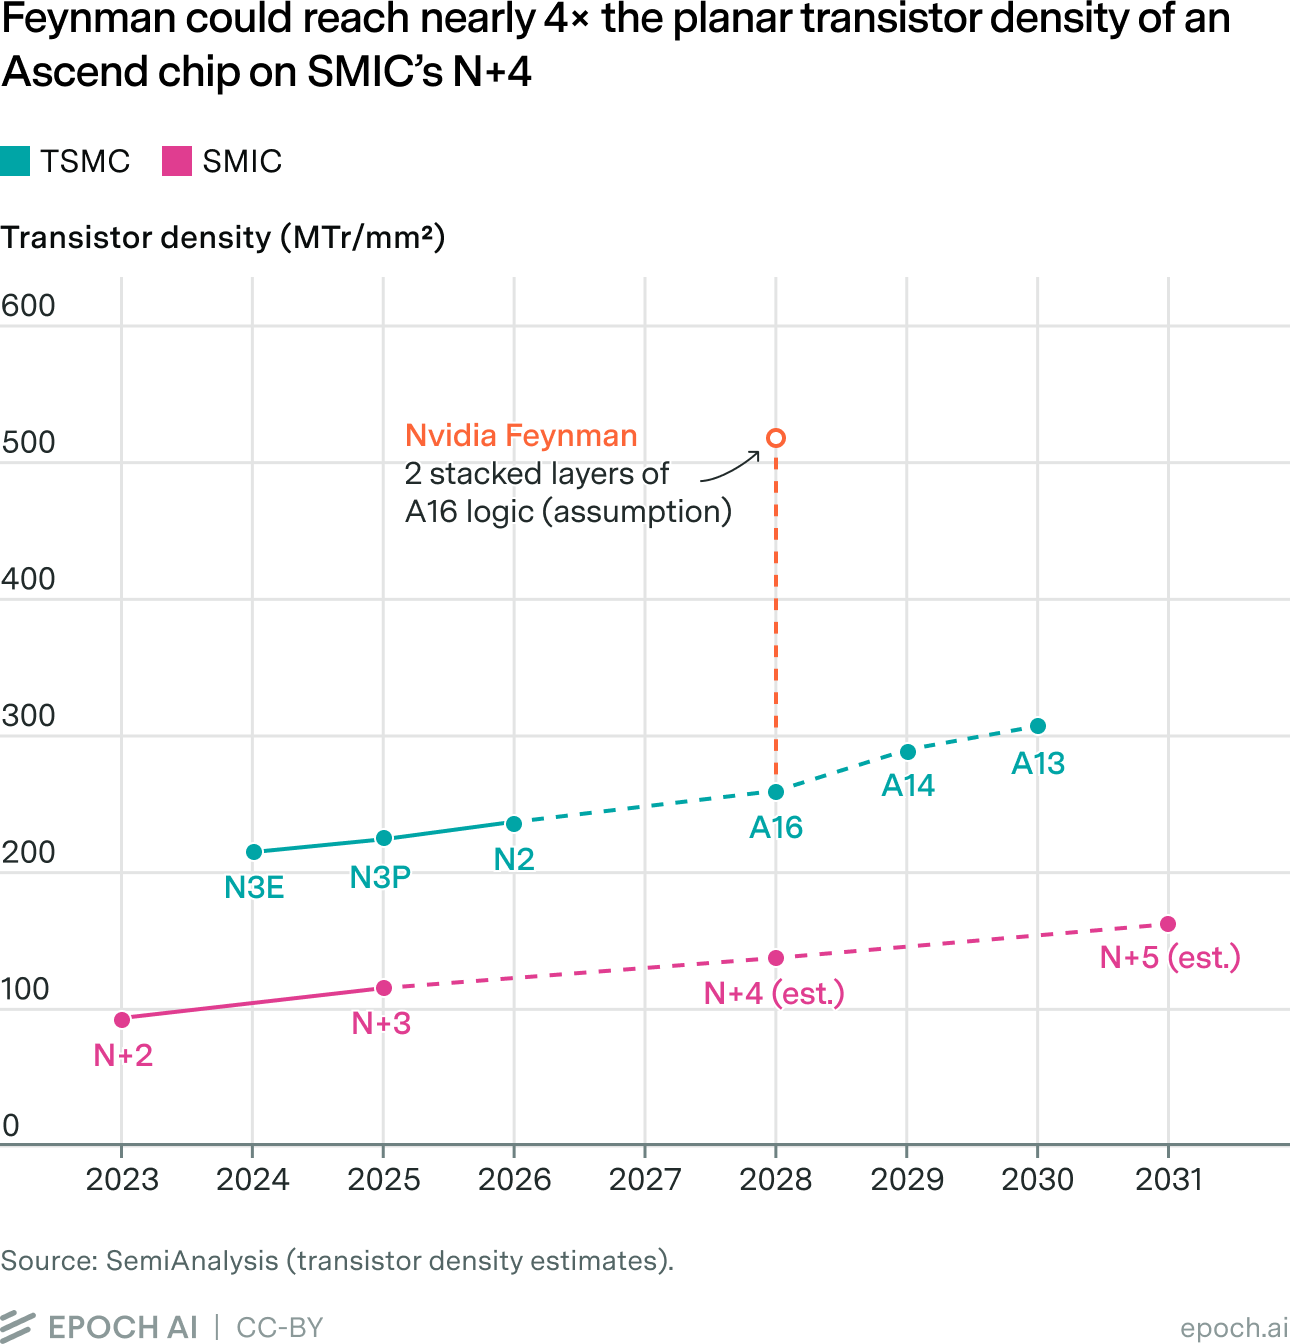
対照的にNvidiaは、トランジスタ密度でおよそ2倍の優位にあり、この差は2030年まで続くだろう。Rubin GPUはTSMCのN3Pプロセスノードで製造される。N3Pのトランジスタ密度は1平方ミリメートルあたり約2億2,400万個(MTr/mm²)に達する。SMICの量産中の最先端プロセスは7 nmのN+3ノードである。その密度は113 MTr/mm²で、TSMCのN3Pの半分にすぎない。
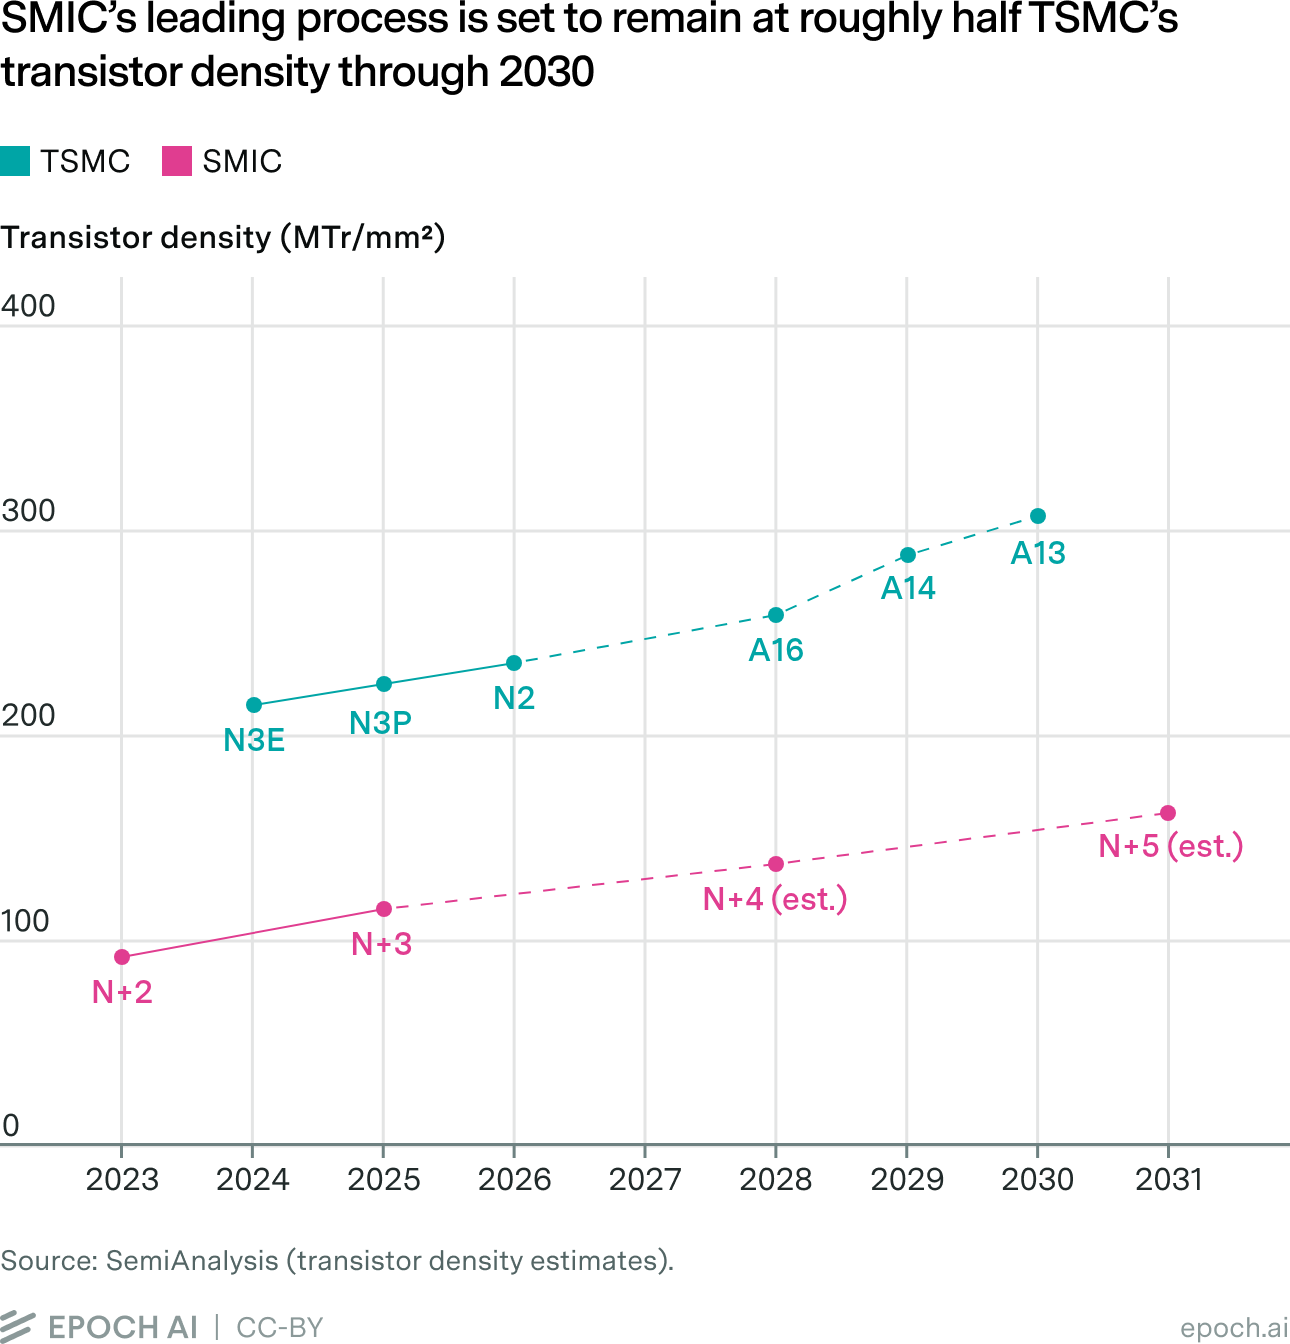
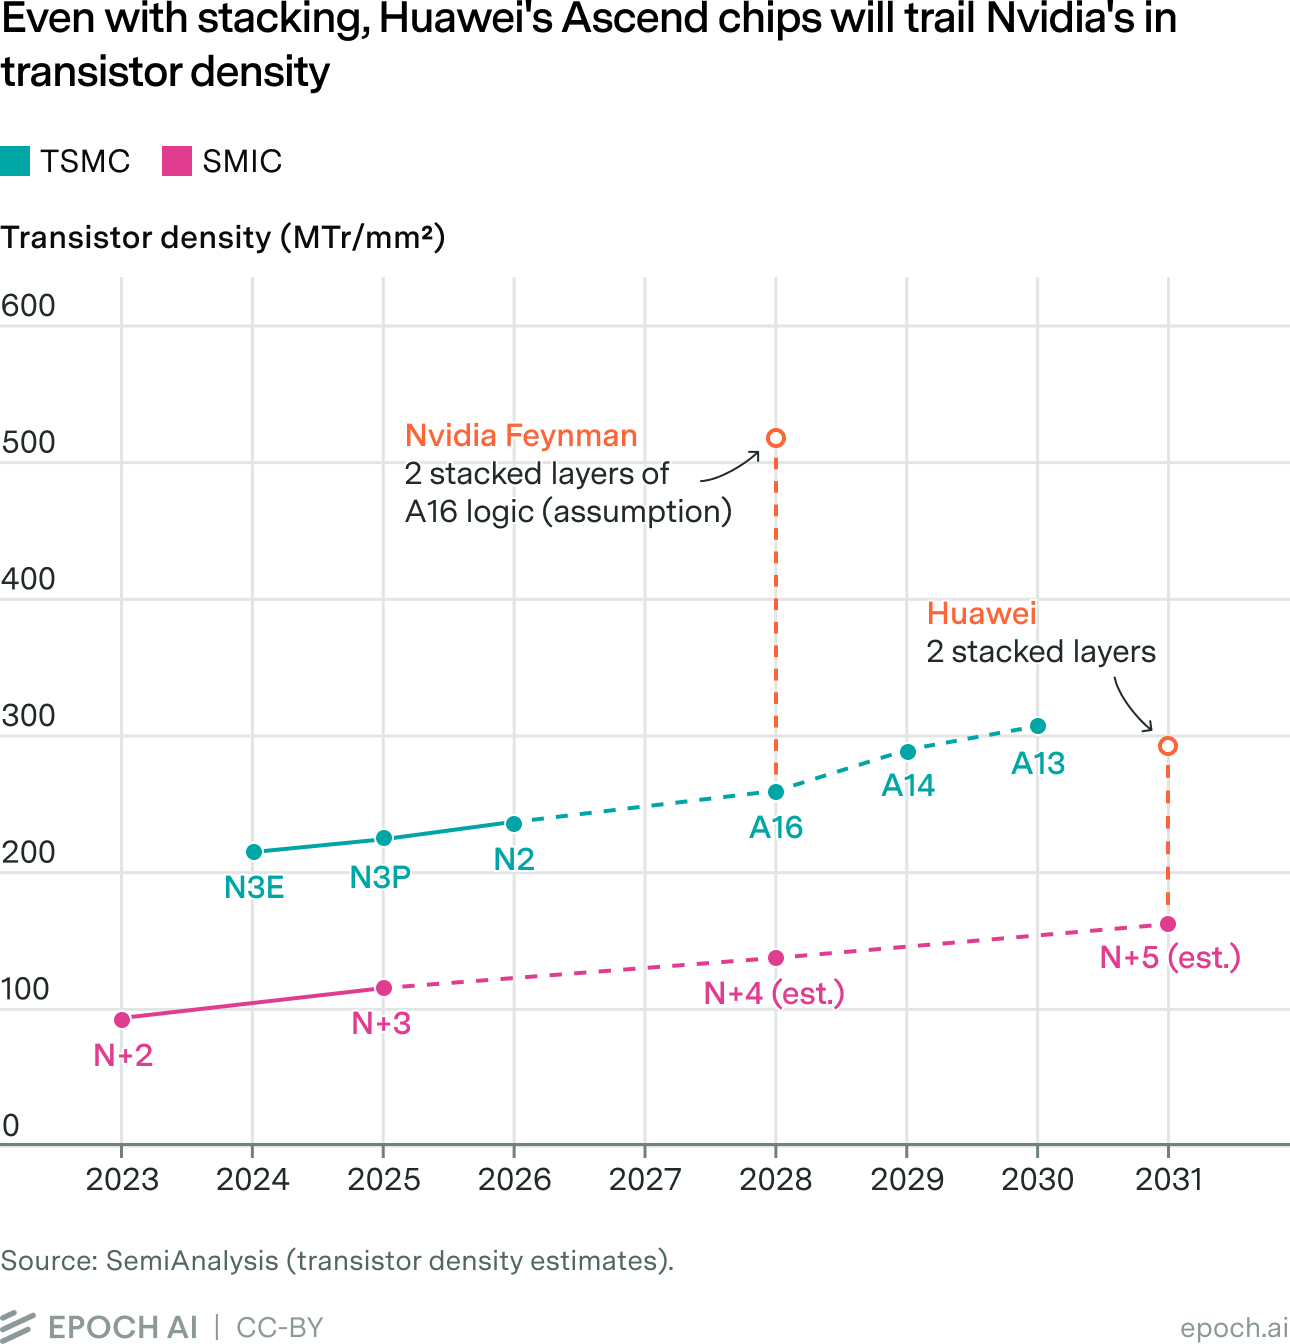
TSMCは、1.6 nm級のA16プロセスを2028年までに量産に移し、続いて1.4 nm級のA14プロセスを2029年までに量産することを目指している。SMICは今後5年でN+4、N+5ノードへと進むが、どの時点をとっても、TSMCの最先端プロセスのトランジスタ密度はSMICのおよそ2倍になるだろう。
Nvidiaの次世代GPUであるFeynmanは、2028年に出荷が始まる見込みで、TSMCのA16プロセスを使う。ほかの条件が同じなら、Feynmanは2028年末に出荷されるAscend 970に対して、基本的に2倍の優位を持つことになる。
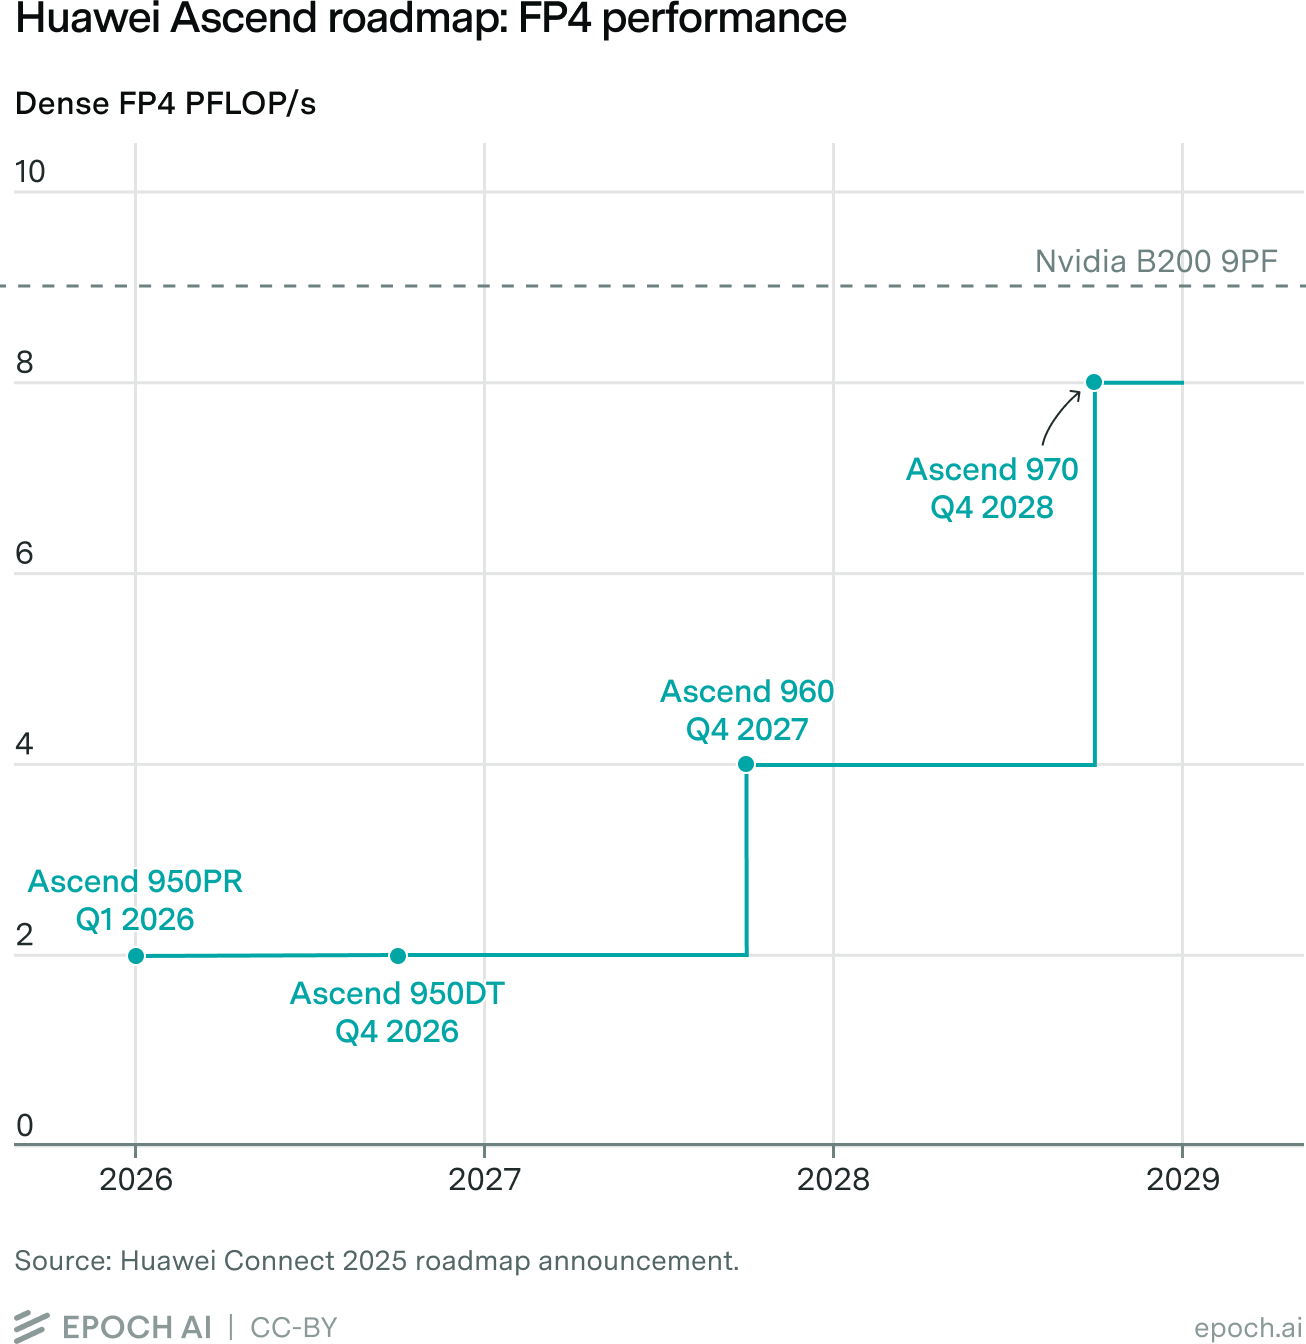
それでもHuaweiのロードマップは、Ascend 950から2028年のAscend 970まで、2世代で計算性能を7倍にすると見込んでいる。この7倍の向上は、より先進的なプロセスノードからは得られない。950と960の計算ダイはSMICのN+3プロセスで製造されており、970はより先進的なN+4プロセスに移る可能性が高い。どちらも5〜7 nm相当のDUVプロセスであり、N+4への移行でトランジスタ密度が高まるのは20%程度と見込まれている。したがってHuaweiは、見込まれる7倍の向上の大半を、残りの3つの方法、すなわちより大きなダイ、パッケージあたりのダイ数の増加、そして4ビット演算への移行のようなアーキテクチャの変更から得なければならない。言い換えれば、Huaweiの短期の性能ロードマップは、プロセスノードのロードマップではなく、パッケージングとアーキテクチャのロードマップなのである。
パッケージング
Huaweiは、前工程のプロセスが遅れている分を、より先進的な後工程で補うことができる。Ascendチップはより大きなダイを使い、各パッケージにより多くのシリコンを統合することもできるが、それには代償が伴う。ダイが大きいほど欠陥を含む可能性が高くなり、ウェハー1枚あたりの使えるダイの数が減る。パッケージが大きくなると、より多くのチップレット、メモリスタック、I/Oをうまく統合しなければならず、製造の複雑さが増し、パッケージングの失敗の機会も増える。パッケージが大きくなってより多くのロジックとメモリを載せるほど、その経済的な価値は高まり、失敗したパッケージ1つあたりの損失も大きくなる。
Huaweiがロードマップの目標を達成できるかどうかは、後工程の製造パートナーの能力に大きく左右される。これらの工程のどれか一つでも歩留まりを維持できなければ、Huaweiの生産量と1個あたりの採算の両方が脅かされる。
Nvidiaもパッケージを大きくし、各チップにより多くのシリコンを詰め込んでいる。Blackwellはレチクルサイズの計算ダイを2枚持ち、RubinはI/Oを別のチップレットに切り出して、計算ダイの面積をより多く演算ユニットに充てられるようにしている。
TSMCのCoWoSのロードマップは、2026年のレチクル5.5倍のパッケージから、2027年に9.5倍、2028年に14倍へと進む。これによりNvidiaは、世代ごとに各パッケージにより多くの計算能力、メモリ、I/Oを載せられる。
チップのアーキテクチャ
Huaweiの更新されたAscendのロードマップは、16ビットのような高精度の形式よりも、4ビットの数値形式での性能を優先している。低精度向けに最適化すると、ハードウェアが1秒間に実行できる演算回数は大幅に増える。より単純な4ビット形式なら、同じ量のシリコンでより多くの計算を行えるからである。Huaweiは、フロンティアの推論実行と学習のワークロードが4ビット精度に向かっていることを認識している。そこで、より多くのシリコンを低精度の演算ユニットに割り当てるようにチップの設計を見直し、フロンティアのAIワークロードを実行するAscendの性能を大きく高めた可能性が高い。その結果、HuaweiはAscend 970のFP4性能を8 PFLOP/sから14 PFLOP/sに引き上げ、2029年のAscend 980については28 PFLOP/sという目覚ましい値を見込んでいる。
垂直積層
しかし、パッケージングの改善は、密度の上限そのものに対する長期的な解決策にはならない。そこでHuaweiは、ロジックダイを垂直に積み重ね始め、SMICのプロセスが1層で形成できるよりはるかに多くのトランジスタを一定の面積に収める計画である。しかし、HuaweiがLogicFoldingと呼ぶこの技術がAscendシリーズに導入されるのは、この10年の終わりになってからである。2030年以降に持つ意味については、本レポートの最後で論じる。
Nvidiaはこの次元をより早く加えようとしている。2028年に見込まれるFeynman世代は、報道によれば、TSMCのA16プロセスノードで製造した3D積層ダイを使う。8 つまりFeynmanは、最初の折り畳み型Ascendより2年早い2028年に、1.6 nm級プロセスで製造したロジックを少なくとも2層積み重ねる。一方、Ascendチップが使える最も先進的なプロセスはSMICのN+4である。
Feynmanが1.6 nmのロジックを2層積み重ねれば、平面換算の密度は500 MTr/mm²を超え、SMICのN+4でのAscendの137 MTr/mm²を大きく上回る。各プロセスが実現する平面の密度の差は2倍にすぎないが、微細化にもう一つの次元を加えることで、NvidiaのFeynmanはトランジスタ密度の優位を掛け合わせ、Ascendとの差を4倍近くに広げる。さらにTSMCのロードマップにあるより大きなパッケージによって、Nvidiaはそうした積層ダイをより多く並べて置くことができ、垂直積層とより高密度なダイに水平方向の拡大を掛け合わせることになる。
メモリ
チップ1個あたりの性能は、ロジックダイにデータを供給するメモリにも左右される。Huaweiのメモリの入手も同様に、国産HBMの生産能力と性能に制約されている。国産HBMは現在、最先端から2世代遅れている。しかしHuaweiは、チップ1個あたりのメモリ帯域幅が950DTの4 TB/sから、2028年第4四半期に出荷されるAscend 970では14.4 TB/sに増えると見込んでいる。ここから、2028年末までにメモリの供給元がHBM3EとHBM4の中間の性能を持つHBMを開発するとHuaweiは考えているとみられる。9

Nvidiaのメモリも進歩している。メモリ帯域幅は、Blackwellの8 TB/sからRubinでは22 TB/sに増える。Nvidiaは独自のHBMベースダイを開発している。これはメモリ制御ロジックの一部を計算ダイからメモリスタックに移すもので、計算ダイの面積を空け、データ移動を最小限に抑える。Nvidiaは、独自のHBMベースダイによって、HBM4Eよりメモリ帯域幅が30%増え、HBMの消費電力が15%減り、使える計算ダイの面積が25%増えると主張している。HBMスタックも高くなっており、20層のスタックがロードマップに載っているほか、より長期的には、メモリをロジックの真上に直接積み重ねる計画もある。TSMCのA16ノードは2027年に裏面電源供給も導入し、ダイの表面に信号配線のための空間をより多く残せるようになる。
技術と主要部品の入手が限られているため、Huaweiはより厳しい制約の下で最適化せざるをえない。Huaweiは、5〜6 nmプロセスの密度に届かせるだけでも複雑なマルチパターニングを使っている。一方Nvidiaは、プロセスノードだけでより高いトランジスタ密度を得たうえで、さらにその高密度のダイを垂直に積み重ね、1つのパッケージにより多く載せることで、その優位を掛け合わせている。これこそ、Huaweiが追いつけない掛け算の効果である。
Huaweiはチップ性能で3〜4年遅れたままだろう
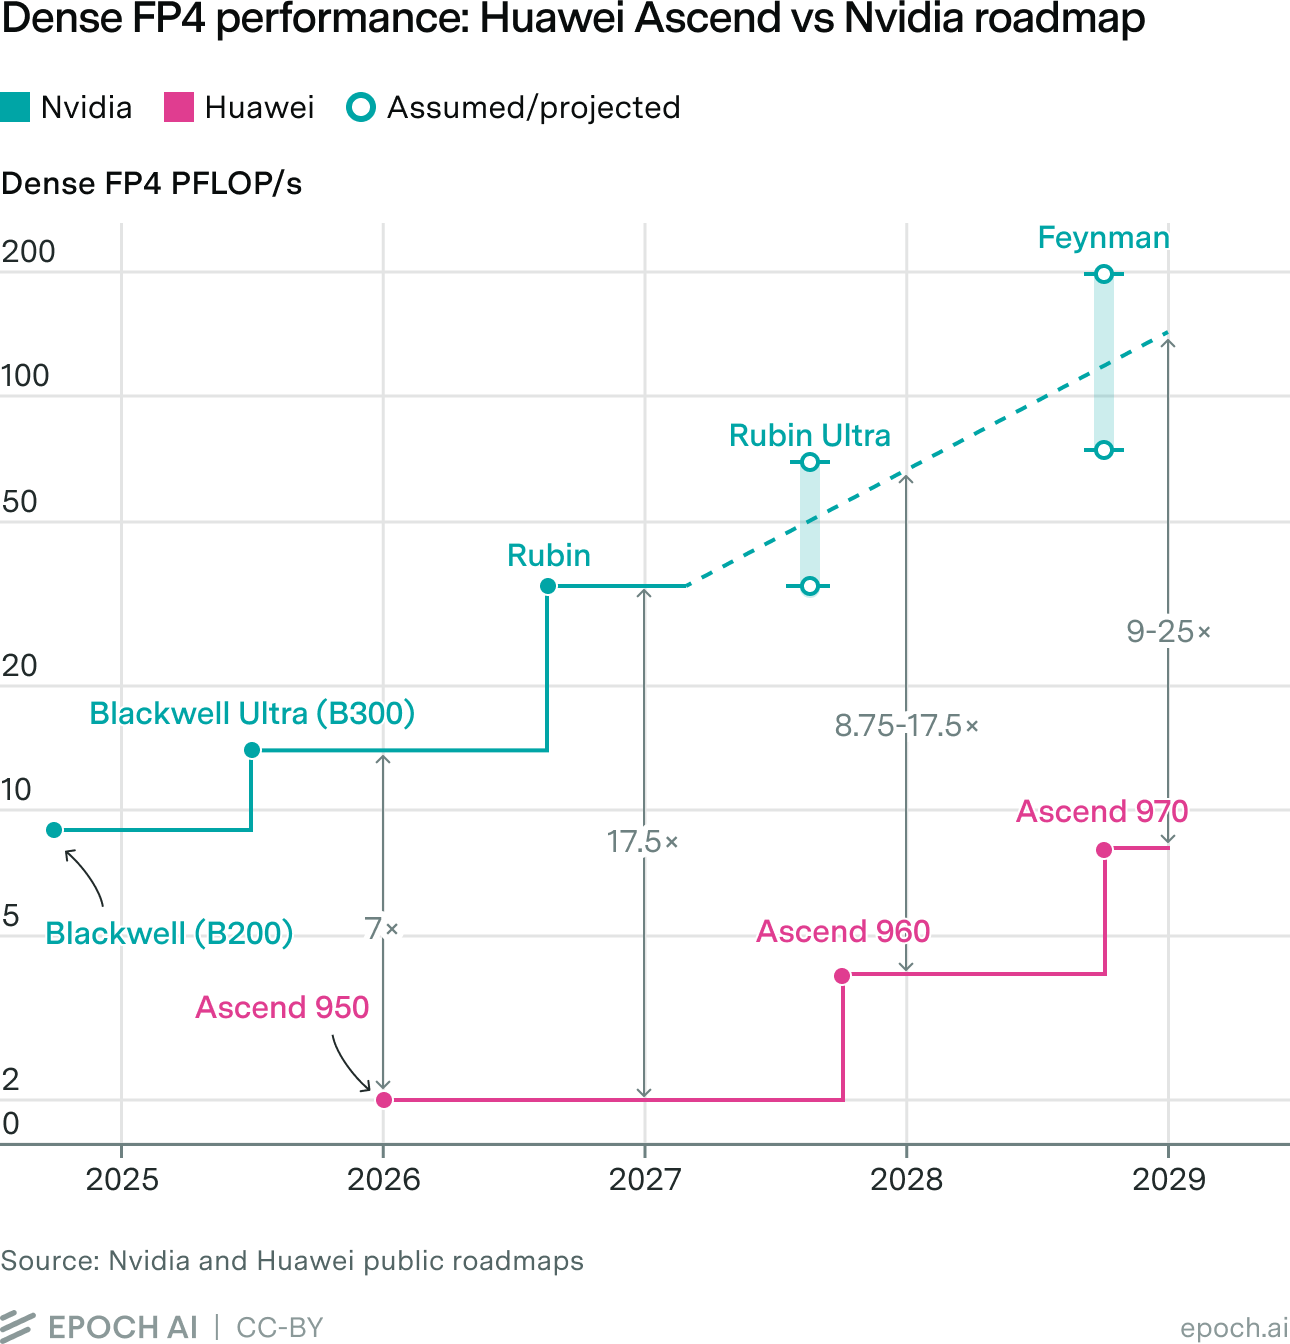
カタログ上では、NvidiaのB300はすでに、HuaweiのAscend 950シリーズのおよそ7倍の素の演算性能を持つ。NvidiaがBlackwellからRubin、Rubin Ultraへと進んでも、各時点でのこの差は維持されるだろう。ピーク性能でB300に近づくと見込まれる最初のAscendチップは、2028年末に出荷予定の970である。B300が2025年に登場したことを考えると、Huaweiはチップのレベルで、2029年になってもNvidiaにおよそ3〜4年遅れていることになる。
より大きなシステム
Huaweiが最も競争力を持つのは、おそらく大規模なシステムとネットワークである。チップの周りに十分に優れたシステムを構築できれば、チップ1個あたりでNvidiaと肩を並べる必要はないかもしれない。
両社ともスケールアップドメインを構築している。これは、最も高速なネットワークで一定数のチップをつないだものである。Nvidiaは、比較的小さく均一な72 GPUのドメインの中に膨大な帯域幅を集中させ、通信負荷の高い処理をラック内にとどめることをソフトウェアに頼っている。10 Huaweiの戦略は、チップ1個あたりの性能の低さを、ドメインのスケールアップの範囲をはるかに広げることで補うことであり、最大8,192個のチップをつなぐ「SuperPoD」を今年出荷する計画である。
| スケールアップドメイン | ドメインあたりのチップ数 | チップあたりのリンク帯域幅 | ファブリック | 時期 |
|---|---|---|---|---|
| Huawei CloudMatrix 384 | 384 | 0.4 TB/s11 | 光 | 出荷中 |
| Huawei Atlas 950 SuperPoD | 8,192 | 1.0 TB/s12 | 光 | 2026年第4四半期 |
| Huawei Atlas 960E SuperPoD | 4,096 | 1.1 TB/s13 | 光 | 2027年第1四半期 |
| Nvidia NVL72 (Blackwell) | 72 | 0.9 TB/s14 | 銅 | 出荷中 |
| Nvidia NVL72 (Rubin)15 | 72 | 1.8 TB/s | 銅 | 2026年下半期 |
| Nvidia NVL576 (Rubin Ultra) | 576 | 1.8 TB/s | 銅+光 | 2028 |
しかし、72と8,192は直接には比べられない。Nvidiaは、どのチップも他のどのチップとも最大帯域幅で通信できるファブリックを構築している。一方Huaweiは、数千個のチップからの同時通信をさばけるノンブロッキングのファブリックを構築できないため、通信の階層構造を導入せざるをえない。そうなると、性能はネットワーク内でのチップの位置、ワークロードの形、ソフトウェアの質により大きく左右される。総帯域幅と総計算能力が大きいことは、広範なエキスパート並列化(wide expert parallelism)のようなワークロードには有利だが、ワークロードの通信パターンによっては通信のオーバーヘッドが大きくなりうる。Huaweiは、優れたソフトウェア、革新的なネットワークトポロジー、的確な設計上の選択によってこうした代償に対処できる。その場合、SuperPodの総合性能を活用し、競争力のある性能を発揮できるだろう。しかしHuaweiは現在、この野心的なスケールアップの仕組みがどれほど競争力を持つかを評価するのに必要な主要性能指標、たとえば二分割帯域幅やチップ対チップの帯域幅を公表していない。
Nvidiaも、数千個のGPUに広がるスケールアップのファブリックを構築することはできる。しかし、Huaweiのような階層構造を導入すれば、位置によって性能が変わることを受け入れ、ノンブロッキングのファブリックを手放し、ソフトウェアの複雑さが増すことになる。ハードウェアの複雑さも増す。多数のチップをつなぐには、より多くのスイッチ、ポート、光モジュールが必要になり、それらは72チップのラックより多くの電力と床面積を使い、故障もより頻繁に起きるからである。Nvidiaの強力なGPUは通信負荷の高い処理の多くを72 GPUのドメイン内にとどめられるので、Nvidiaにはそうした代償を払う理由が少ない。
それでもNvidiaはラックのレベルで拡大を進めている。ラック全体の帯域幅は世代ごとに倍増し、Blackwellの130 TB/sからRubinの260 TB/s、Rubin Ultraの520 TB/sへと増える。スケールアップドメインの規模も大きくなっている。Rubin Ultraのスケールアップシステムは、複数のラックをつないで144 GPUと576 GPUの構成に拡大し、ラック内は銅、ラック間は光で接続する。しかし最近の報道によれば、より高密度なRubin Ultraのラックは2028年にずれ込んだようである。Feynmanでは、スケールアップドメインは、それぞれ144 GPUを収めた8つのラックにわたってつながれた1,152 GPUにまで拡大する可能性がある。
数千個のチップを含む巨大なポッドシステムを製造・組み立てることは、過小評価されがちな課題である。Nvidiaは、より小さな72 GPUのBlackwellラックでさえ製造上の問題を経験した。チップ数が100倍のポッドを扱えば、こうした問題はさらに深刻になるだけである。詳しく読む:NvidiaとHuaweiのスケールアップドメインの設計
Nvidiaは帯域幅をラック内に集中させる
Nvidiaの戦略は、比較的小さいがきわめて強力なスケールアップドメインを構築し、ワークロードをできる限りラック内にとどめるように調整することである。GB300 NVL72ラックの中では、各GPUは他のすべてのGPUに合計900 GB/sを送信でき、さらに900 GB/sを受信できる。ラック内の共有ネットワークは、72個のGPUすべてが同時に最大帯域幅でデータを送れるだけの規模がある。これにより、通信が共有ネットワークでボトルネックになることはなく、各GPUはラック内の他のGPUに一定で予測可能なかたちでアクセスできる。16
トラフィックがラックの外に出ると、チップあたり100 GB/sの別のネットワークを通ることになり、帯域幅は9分の1に落ちる。17 Nvidiaはラック間でも帯域幅を維持しようとすることはできるが、そうすればスイッチ、配線、消費電力、ラックの複雑さ、コストが増えるなど、大きな代償を伴う。18 そこでNvidiaは、この帯域幅の急落を受け入れ、通信負荷の高い処理をラック内にとどめることをソフトウェアに頼っている。
Huaweiはスケールアップの範囲をさらに広げる
昨年Huaweiは、16ラックにわたる384個のチップに広がるスケールアップの仕組みであるCloudMatrix 384を発表した。19 Huaweiは、ラック内では銅、ラック間の通信には光接続を使うことで、チップあたり400 GB/sのノンブロッキングのファブリックを実現した。データのトラフィックがCloudMatrix 384のドメインを出ると、別のRDMAスケールアウトネットワークを流れる。
Huaweiは近く、8,192個のチップをつなぐSuperPoDを出荷する。しかしこの規模ではノンブロッキングのファブリックを維持できず、通信の階層構造を導入しなければならない。HuaweiのUB-Meshの設計は、ラック内で64チップを、1,024チップのポッド内で16ラックをつなぎ、さらにもう一層のスイッチを介して1,024チップのポッドを8つつなぐことで、8,192チップに達する。隣り合う2つのチップ間のトラフィックは、SuperPoDの端から端へ流れるトラフィックとは大きく異なる。隣り合うチップどうしは最も短く強力な接続を持つが、遠く離れたチップ間のトラフィックは、ネットワークの共有された、混雑しているかもしれない部分を通る。
通信の階層構造は、HuaweiのGPUあたり片方向1 TB/sという帯域幅の数字が何を測っているかも変える。Nvidiaのノンブロッキングのファブリックとは違い、Huaweiの1 TB/sという数字は、各チップが共有ネットワークに送り込めるデータ量を表すものであり、ポッド内の1つのチップから他のすべてのチップへの帯域幅を保証するものではない。遠く離れたチップとの通信は複数のホップを経由し、そのどれもが狭く混雑している可能性がある。ワークロードがポッド全体に分散されている場合、送出帯域幅(インジェクション帯域幅)だけでは性能についてほとんど何もわからない。
大きなスケールアップドメインはいつ役に立つのか
チップを増やすことが役に立つのは、最も重い通信が局所にとどまるようにワークロードを編成できる場合だけである。ソフトウェアがうまく機能すれば、システムは性能の低いプロセッサを組み合わせてまとまった全体にできる。しかし、処理の調整(オーケストレーション)やワークロードとの適合性が不十分だと、データはネットワークの共有部分を繰り返し横断し、混雑が増して、計算能力を束ねる利点が損なわれる。
広範なエキスパート並列化(wide EP)は、Huaweiの大きなポッドの恩恵を受けうるワークロードの形の一つである。疎な混合エキスパートモデルは多数のエキスパートを持つが、各トークンをそのうち少数にしか振り分けない。それらのエキスパートをより多くのチップに分散させれば、モデルはより多くのメモリを使えるようになり、各チップが保持・実行するエキスパートの数は少なくて済む。これはAscendチップ1個ずつの性能の低さを補うのに役立つ。SuperPodのチップ間帯域幅の低さも、wide EPでは問題になりにくいかもしれない。wide EPは通信負荷が高いが、個々のメッセージのサイズはごく小さく、Huaweiによればメッセージの96%は2バイトである。メッセージが小さいため、トラフィックは1本のリンクの太さよりも、チップがどれだけ速くメッセージを送受信できるかに制約される。これはSuperPodの仕様によく合っている。
代償は通信のオーバーヘッドの増大であり、これを適切に管理する必要がある。ワークロードを効率よく調整し、エキスパート間のトラフィックを局所にとどめるソフトウェアをHuaweiが開発できれば、wideEPはHuaweiが抱えるチップ1個あたりの不利を和らげ、SuperPodのより大きな総計算能力と総帯域幅を活用できるだろう。
スケールアップは、Huaweiが性能の低いチップの影響を和らげるための有意義な方法だが、チップ1個あたりの性能差を埋めることの代わりにはならない。より大きなスケールアップドメインは膨大な計算能力とメモリを束ねられるが、通信、ソフトウェアの複雑さ、消費電力、信頼性の問題も大きくなる。Huaweiのシステムレベルの技術力によって、実際に実現される性能の差が縮まることは十分に考えられるが、それが根本にあるハードウェアの不利を消し去ると想定できるだけの証拠や、本番のワークロードでの結果はない。
よりよいソフトウェア
ソフトウェアは、ワークロードをどう並列化するか、通信を計算とどう重ね合わせるか、メモリをどう管理するか、そして最終的にハードウェアをどれだけ効率よく使うかを決める。カタログ上の仕様が似た2つのチップでも、ソフトウェアの質によって、実際に観測される性能は大きく異なりうる。まったく同じハードウェアでも、推論実行フレームワークの違いだけで、実際の性能が1桁以上変わることがある。20
したがってソフトウェアは、ハードウェアの性能を決めるそれ自体独立した手段であり、Nvidiaの最大の強みの一つである。NvidiaのCUDAに相当するHuaweiのソフトウェアはCANNと呼ばれる。2018年に初めて公開されたが、はるかに未成熟で、Ascend GPUを扱いにくくしている。DeepSeekがR2モデルをAscendで学習させようとしたとき、Huaweiは自社のエンジニアを送り込んだが、それでも学習を完了できず、DeepSeekはNvidiaに戻った。
CANNは現在CUDAより未成熟だが、競争力を持つに至る現実的な道筋はある。Nvidiaのソフトウェアの優位の多くは、フロンティアAI企業とのフィードバックループから来ている。フロンティアAI企業はハードウェアを限界まで使い込み、カーネル、コンパイラ、メモリ管理、モデルのシャーディング、集団通信のボトルネックを明らかにする。Nvidiaはそうしたボトルネックをソフトウェアで解消し、それに応じて次世代チップのアーキテクチャも最適化できる。
中国のAIラボも、Huaweiのために同様の好循環を生み出しうる。計算資源の不足は、ハードウェアに近いレベルで最適化する強い動機を与え、輸出規制はより多くのワークロードをAscendに向かわせる。そうしたワークロードはボトルネックを明らかにし、CANNを改善しうるフィードバックを生み、Huaweiがフロンティアモデルのアーキテクチャをより早く把握する助けになる。そしてよりよいハードウェアとソフトウェアが中国のラボの最先端の開拓を助け、さらに有用なフィードバックを生んで、好循環が生まれる。21 また中国のラボは、オープンソース化を好むうえに、中国国内の計算資源のスタックを強化することにも関心があるので、クローズドソースの欧米のラボよりも、アーキテクチャの詳細をHuaweiと共有し、エコシステムに貢献することに前向きかもしれない。
この好循環が定着すれば、Huaweiはカタログ上の仕様が示すより速くチップの性能を高められるかもしれない。しかし現時点では、この好循環はまだ始まったばかりである。CANNはいまだCUDAに何年も遅れており、中国のラボは国産チップをますます多く使うようになっているものの、Nvidiaのハードウェアが手に入るときは今でもそちらを選ぶ。
Huaweiは数量で差を埋められるか
仮にHuaweiがこれらすべてを実現したとしよう。Ascendシリーズが2年で7倍の性能向上を達成し、SuperPoDが8,000チップ規模に拡大してもよく機能し、CANNが成熟したとする。それでもHuaweiのチップはNvidiaに何年も遅れたままだろう。Nvidiaはより進んだ出発点から同じ手段を使っており、しかもHuaweiがまだ追随できない微細化の次元を加えているからである。
チップ同士で比べてもシステム同士で比べてもNvidiaの性能に及ばないのなら、Huaweiはより多くのチップを生産することで補えるだろうか。
チップ1個あたりの性能の低さを数量で補えるかどうかは、Huaweiの供給元の拡大能力にかかっている。しかし短期的には、Huaweiにとってより差し迫った制約は、チップ1個あたりの性能よりもむしろ生産量のほうである。中国国内の生産は現在、HBMに制約されている。中国最大のメモリメーカーであるCXMTと、より小規模なXMCは、HBMの増産を始めたばかりであり、国内の供給は中国のチップ設計企業の需要をまかなえない。
2025年には、違法に入手した部品と、2024年12月の輸出規制の発効前に中国企業が積み上げた1,000万スタックを超える外国製HBMの備蓄が、その不足を埋めた。22 この備蓄はおよそ100万〜200万個のAscendチップに足りる量だが、2026年に尽きると見込まれている。そのため2026年は転換点の年になる。備蓄したHBMが尽きれば、中国のAIチップの数量は、CXMTが生産できる量と中国が密輸できる量にまで落ち込む。
この不足はすでに、Huaweiの2026年のチップ設計に表れている。Ascend 950を、プリフィル向けのHBMを使わない派生型と、デコード向けのHBMを使う派生型に分けているのである(前述の「ハードウェアの性能」の節にある設計上の選択についての補足を参照)。
国内のHBM供給から導かれる生産量
Huaweiが持続的に維持できる生産能力を推定するために、まず国内で製造されたHBMだけを使って何を生産できるかを考える。ベースラインには、2024年の備蓄と密輸されたHBMは含めない。密輸は継続的な供給源である可能性が高いが、拡大するのは難しいかもしれない。この依存の度合いは大きい。私たちが2026年について推定する約150万個のAscendのうち、国内のHBMを使うのは約24万個にすぎず、別の75万個は国内で調達できる可能性のある、より性能の低いHBM以外のメモリを使っている。
私たちのモデルでは、CXMTとXMCのHBM生産量をHuaweiのAscendの数量に換算し、NvidiaとHuaweiの生産量の差の大きさを示す。23 SemiAnalysisは、CXMTがHBMに割り当てる月間ウェハー投入数が、2025年末の5,000枚から、2026年に30,000枚、2027年に55,000枚、2028年に100,000枚へと増えると推定している。これらの数字を使い、HuaweiへのCXMTのHBM生産量の割り当てを2026年に75%、2028年には65%に下がるものとしてモデル化して、Huaweiの計算資源の生産量を推定する。XMCのHBM生産量はCXMTの10分の1とし、その全量がHuaweiに割り当てられるとモデル化する。
Nvidiaの計算資源の生産量を推定するために、世界のHBM供給に占めるNvidiaのシェアをGPUの数量に換算する、同様のモデルを使う。世界のHBM生産量は、SemiAnalysisによる業界のウェハー投入数の推定に基づかせ、Nvidiaが世界のHBM生産量の52%を2026年に、44%を2027年と2028年に消費すると仮定する。詳しく読む:私たちの方法論
HBMのウェハー生産能力を完成したAscendの個数に換算するにあたって、時期について2つの重要な調整を行う。第一に、CXMTのHBMへのウェハー割り当てについてのSemiAnalysisの推定を、年末時点の生産ペースとして扱う。第二に、ウェハー投入からチップの完成までに5か月の遅れを見込む。24
国内のHBM供給のうちHuaweiが得る分は、Cambricon、Biren、Baidu、Alibabaなど、それぞれ自社のAIチップの生産を拡大している中国の他のチップ設計企業との間で、ますます奪い合いになるだろう。そこで、CXMTのHBM生産量に占めるHuaweiのシェアを2026年に75%とし、2027年には70%、2028年には65%に下げてモデル化する。国内のHBM供給のうちHuaweiへの割り当ては、この10年の終わりまでにさらに下がる可能性があるが、密輸されたHBMは逆方向に働き、Huaweiの計算資源の生産量を押し上げるだろう。
私たちは、Huaweiの公表されたロードマップに基づいて、チップの種類ごとの生産の内訳をモデル化する。推定では、2026年に出荷される950DTが144 GB版ではなく96 GB版を使うと仮定している。Huaweiの資料では、どちらもメモリ帯域幅は同じ4 TB/sとされている。25 Huaweiの計算資源の生産量のモデル化に使ったパラメータの一覧は、私たちの入力シートを参照してほしい。
2026〜2028年にかけて、Nvidiaは年に数千万H100eを生産でき、2028年までに1億近くに増える可能性があると私たちは推定している。HBMの供給元をCXMTとXMCだけとした場合、Huaweiは2028年までに年約150万H100eまで生産を増やせる可能性があり、これはNvidiaの生産量の約1.5%にあたる。HuaweiとNvidiaの計算資源の生産量の推定には不確実性があり、それは上に示したとおりである。しかし差はきわめて大きく、信頼区間の両端をとっても、HuaweiとNvidiaの差はおよそ20倍になる。
計算スループットではなくメモリ帯域幅で測ると、HuaweiのH100換算の生産量は2倍以上になる。各チップのメモリ帯域幅をH100換算に直し、生産量を掛けると、Huaweiの出荷量はH100帯域幅換算で2026年に30万個分、2028年には310万個分に増えると推定される。これはNvidiaの生産量の2026年で1.4%、2028年で3.5%にあたる。メモリ帯域幅で測ると差が小さくなるのは、メモリ帯域幅がこれまで計算スループットより緩やかにしか向上してこなかったためと考えられる。そのため、チップ性能におけるNvidiaの3〜4年のリードは、メモリ帯域幅で見ると絶対的な優位としてはより小さくなる。
2030年までの中国のHBM増産
上記のモデル化は2028年までだが、中国国内のHBM生産は2030年にかけても大幅に拡大し続けると見込まれている。
アナリストは、CXMTが2030年までにDRAMのウェハー生産能力を3倍にすると予想しており、DRAMのウェハー投入能力のうちHBMに割り当てる割合は、2026年の9%から30%超へと高まる可能性がある。26 DRAMの生産能力の増加とHBMへの割り当ての拡大を合わせると、CXMTは2030年までに、HBMのウェハー生産能力を2026年末と比べて10倍に増やすことも十分に考えられる。中国の他のメモリメーカー、たとえばXMC、JHICC、Swaysureも、相当なHBM生産能力を持つ可能性が高い。中国のDRAMウェハー生産能力の合計は、2030年末までに月140万枚の投入に達するという推定もある。
楽観的に、2030年末にDRAMのウェハー投入が月200万枚に達し、そのうち30%がHBMに割り当てられると仮定しよう。これは、中国のHBM向けウェハー投入数が2026年末から18倍に増えることを意味する。このシナリオでも、概算ではHuaweiの2030年の生産量はおよそ2,100万〜3,200万H100eであり、Nvidiaの2028年の計算資源の生産量について私たちが推定した中央値の約21〜32%にすぎない。27 言い換えれば、Huaweiの2030年の生産量の中心推定である2,400万H100eは、Nvidiaが2026年に生産する量とほぼ同じであり、チップ1個あたりの性能だけでなく数量でも、Huaweiは約4年遅れていることになる。
Huaweiのその他のメモリ調達経路
上記の推定は、CXMTとXMCがHuaweiの唯一のHBM供給経路であると仮定している。実際には、Huaweiは密輸されたHBMや、950PRで使われているLPDDRのようなHBM以外のメモリなど、他の供給源も利用できる。
密輸
Huaweiが大規模な密輸で国内のHBM供給を補ったとしても、Nvidiaにはなお大きく遅れたままだろう。仮に2028年に、Huaweiが国内供給から得られる量の10倍のHBMを密輸したとする。念のために言えば、これは1 GBあたり15ドルというきわめて控えめな単価でも400億ドルを超える、ありそうにないほど大きな流れである。このシナリオの中央推定では、Huaweiの2028年の生産量は150万H100e弱から約1,600万H100eに増えるが、それでも同年のNvidiaの生産量の約16%にすぎない。したがって、HBMの密輸はHuaweiの生産量を大きく増やしうるが、差を埋めるには至らない。
HBM以外のメモリ
HBMの供給による制約を超えて生産を拡大するために、HuaweiはAscend 950PRでそうしたように、一部のチップにLPDDRのようなHBM以外のメモリを組み合わせることができる。2026年9月に更新されたロードマップを見ると、この戦略は続くようだ。2027年末に見込まれる960PRは、おそらくLPDDRを使い、FP4で8 PFLOPSの性能を持つが、メモリ帯域幅は2.4 TB/sにすぎない。NvidiaもHBM以外のメモリを使うAIチップを生産している。2025年のRTX Pro 6000 BlackwellはGDDR7メモリを使い、帯域幅1.8 TB/s、FP4で4 PFLOPSの性能を持つ。
HBM以外のメモリを使うチップの代償は、帯域幅の低さである。960PRやRTX 6000のようなチップは、プリフィルのような、ワークロードのうち計算に律速される部分に限られるだろう。メモリ不足が深刻になるにつれて、ロードマップはさらに変わりうる。世界最大のHBM割り当てを持つNvidiaでさえ、メモリコストの上昇と供給不足のため、来年の主力GPUのメモリ仕様を引き下げようとしている。もう一つの可能性として、新しい推論実行フレームワークやアーキテクチャといったアルゴリズムの進歩によって、メモリ帯域幅への依存が減り、代替のメモリがより実用的になることも考えられる。そうなればHuaweiの生産の制約は緩むが、同じ進歩はNvidiaの制約も緩めるだろう。
密輸も代替メモリも、2030年までにNvidiaとの計算資源の生産量の差を完全に埋める可能性は低い。
計算資源の生産量の差を分解する
密輸であれ国内生産であれ、HBMの供給が増えればHuaweiの生産量は動くが、差は埋まらない。制約をよりはっきり特定するために、この差を3つの構成要素に分解する。それぞれが利用できるHBMのウェハー生産能力、そのウェハーをどれだけ効率よく使用可能なHBMに変換できるか、そして各チップがそのメモリにどれだけの計算能力を組み合わせるか、である。
中央推定によれば、2026年のHuaweiの国内供給で支えられる生産量とNvidiaの生産量との差は、主にNvidiaがはるかに多くのHBMを入手できることによる。HBMに割り当てられるDRAMウェハーの差と、そのDRAMを機能するHBMに変換する際の歩留まりを考慮すると、Nvidiaは73倍の使用可能なHBMを持ちうると私たちは推定している。28 また、主にB300とRubinから成るとモデル化したNvidiaの2026年のチップ生産の内訳は、メモリ1 GBあたり2.7倍の計算能力を詰め込んでいる。これらの要因が合わさって、計算スループットで200倍近い差が生じる。メモリ帯域幅で測ると、Ascendシリーズは実は2026年のNvidiaのチップ生産の内訳よりGBあたりの帯域幅が大きく、出荷される帯域幅の合計の差は71倍になる。
2028年については、中央推定では、計算資源の生産量の差は約200倍から約65倍に縮まる。分解の内訳も変わる。CXMTとXMCはHBMの増産が十分に進み、歩留まりも改善していると見込まれるため、使用可能なHBMの差は73倍から11倍に縮まる。
同時に、Nvidiaが生産の中心をRubin Ultraに移すにつれて、NvidiaとHuaweiのチップ1個あたりの性能差は広がる。メモリ1 GBあたりの計算能力で見たNvidiaの優位は、2026年の2.7倍から2028年には6.1倍に拡大する。これは、Huaweiの不利をもたらす要因の大きな変化である。中国のHBM供給が拡大するにつれてメモリ供給の差は縮まる一方、Huaweiのチップ1個あたりの性能の不利は大きくなり、そのメモリにどれだけの計算能力を組み合わせられるかをますます制限するようになる。29 この変化は、生産量をメモリ帯域幅で測った場合にも当てはまる。GBあたりの帯域幅の差は2026年の1.0倍から2028年の2.6倍へと3倍に広がり、2028年に出荷される帯域幅の合計の差は29倍になる。
2028年についてのモデル化の注意点の一つは、Rubin Ultraの性能とメモリ仕様をめぐる不確実性である。私たちは、Rubin UltraのFP4性能がRubinの1〜2倍、Huaweiの2028年のチップであるAscend 970の2.5〜5倍のどこかになると予想している。メモリについては、Rubin Ultraは当初、容量1 TBと報じられていた。しかし最近の報道によれば、Nvidiaは供給不足に対応して、チップあたり192 GBまで下がるようなメモリの少ない構成を検討しているらしい。
私たちは2028年のRubin Ultraのメモリを256 GBとする中央推定を用い、FP4性能はわずかに向上して38 PFLOPSになるとする。これにより、2028年のNvidiaのチップの内訳とHuaweiとの間で、GBあたりのH100eの差は6.1倍になる。30 メモリ帯域幅については、中央推定を31 TB/s、不確実性の幅を22 TB/sから40 TB/sとする。31 不確実性の多くは、2028年のRubin UltraがHBM4とHBM4Eのどちらを使うのか、そしてNvidiaの独自のHBMベースダイを使うのかどうかにかかっている。
Huaweiは、より無駄のないチップを採用し、計算能力の単位あたりに組み合わせるメモリを減らすこともできる。HBMの供給不足が深刻になるなかで、NvidiaがRubin Ultraでとるかもしれない方向である。しかし、GBあたりにより多くの計算能力を組み合わせるには、チップあたりにより多くのロジックが必要になり、ボトルネックがメモリの供給からSMICのウェハー生産量に移る可能性がある。
中国のメモリ供給が改善するにつれて、Huaweiの競争力に対する制約として、メモリと並んでチップ1個あたりの性能がますます重要になるだろう。これを克服するために、Huaweiは長期的な技術上の賭けに出ている。
2030年以降に向けたHuaweiの賭け:LogicFolding
Huaweiがチップ1個あたりの性能を高める選択肢は限られている。SMICはこの10年の終わりまで5〜7 nm級のプロセスにとどまり、水平方向の拡大は歩留まりとパッケージングの代償に突き当たる。そこでHuaweiの長期的で野心的な賭けは、微細化にもう一つの次元を加えること、つまり上に向かって積み上げることである。
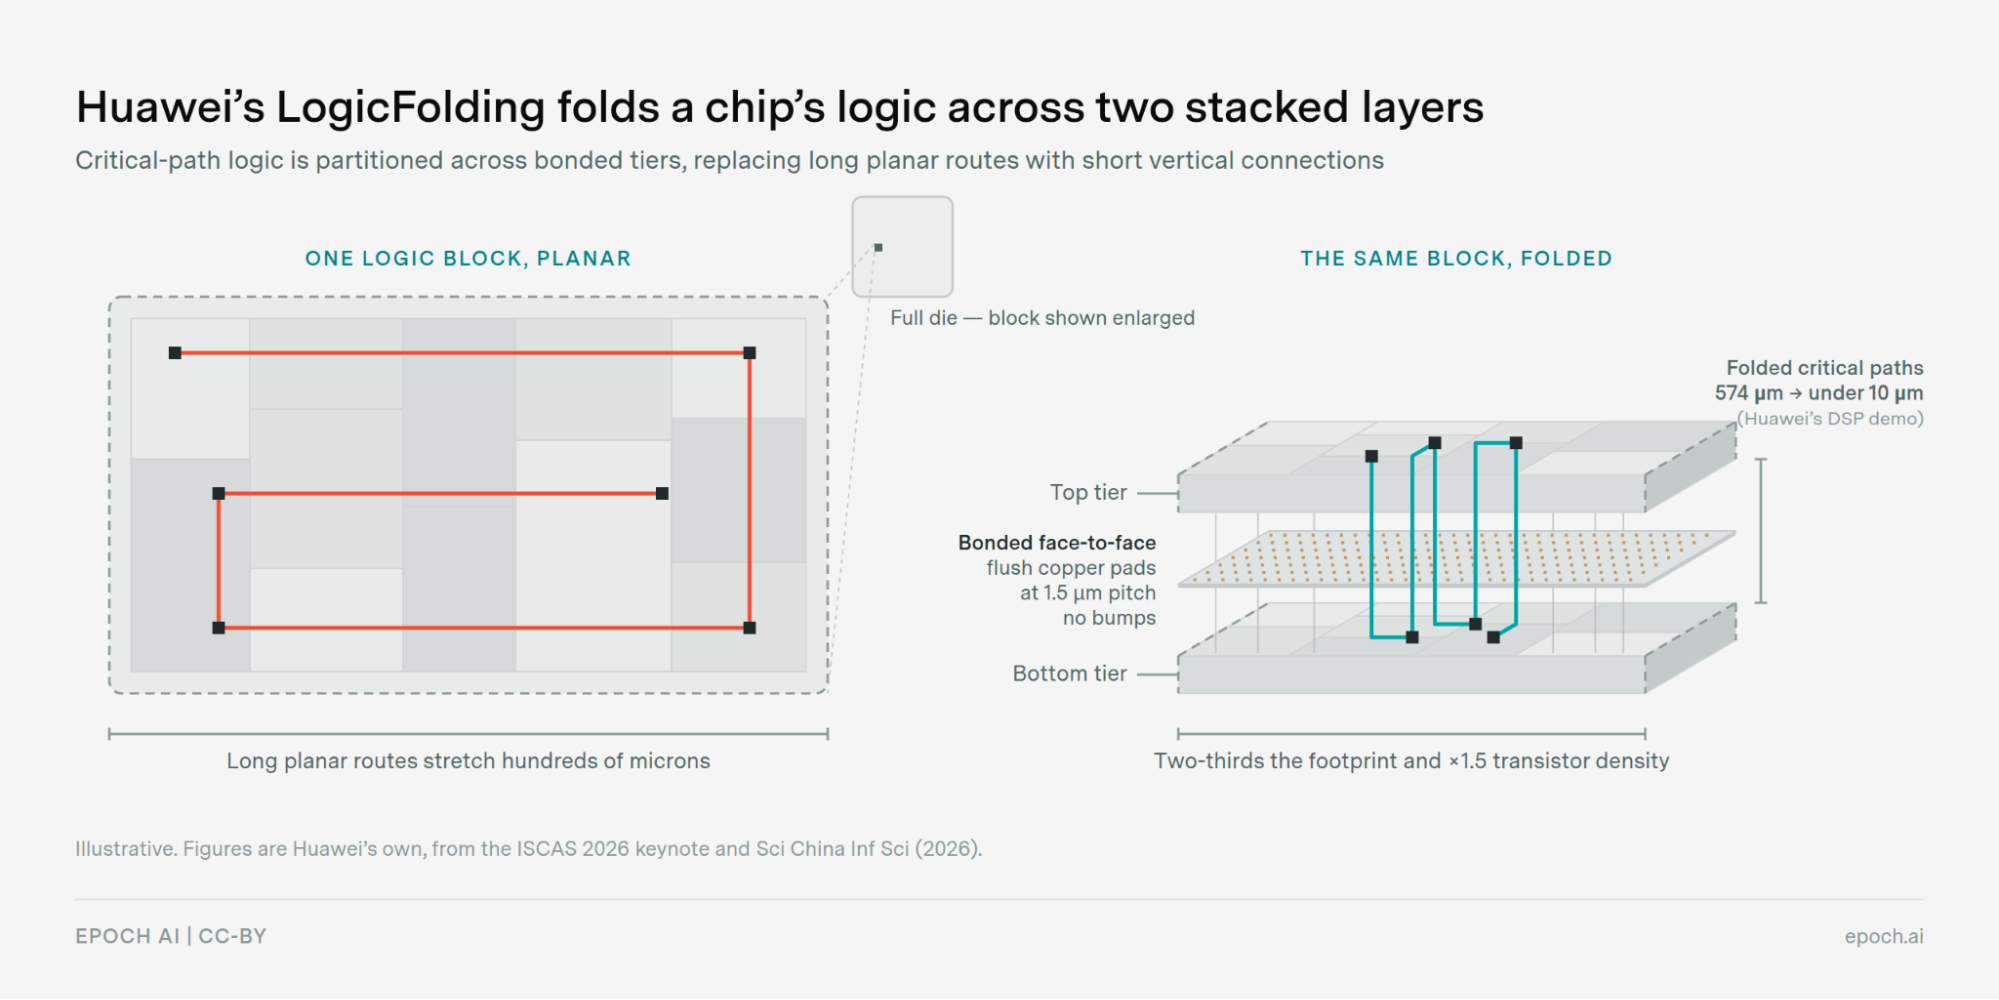
その計画は、ロジックダイを垂直に積み重ねてトランジスタ密度を高め、先進的な露光装置を入手できないことによる限界を超えて微細化を進めるというものだ。トランジスタそのものは5〜7 nm級のままで、それが2層以上のロジック層に分けて配置される。Huaweiはこの3D積層技術を「LogicFolding」と呼んでおり、これをうまく実装し、規模を拡大できるかどうかが、2030年以降のHuaweiの競争力の鍵になる。
3D積層の利点
垂直積層には3つの利点がある。
第一は密度の向上である。Huaweiは2031年までに、5 nm級のロジックダイを2枚積み重ねて、1.4 nmプロセスノードに相当するトランジスタ密度を実現することを目指している。これが実現すればAscendチップの演算性能は大きく高まるが、そうしてできたチップも、電力効率、歩留まり、コストの面では平面の1.4 nmプロセスに及ばないだろう。
第二は、チップ内の接続を短くすることである。チップは最も遅いクリティカルパスの速さでしか動けないので、その経路を短くすればチップ全体を高速化できる。LogicFoldingは、ロジックブロックを垂直に積み重ねた層に分割する。そのため一部の信号は、ダイの表面を長い水平配線で横切るのではなく、接合部を通る短い垂直方向の移動で済む。クリティカルパスが短くなれば、バッファの必要も減る。バッファは、抵抗と容量による遅延を抑えるために、長い配線の途中に置かれるものである。バッファの数を減らせば、ダイの面積と電力を節約でき、信号の遅延も減らせる。
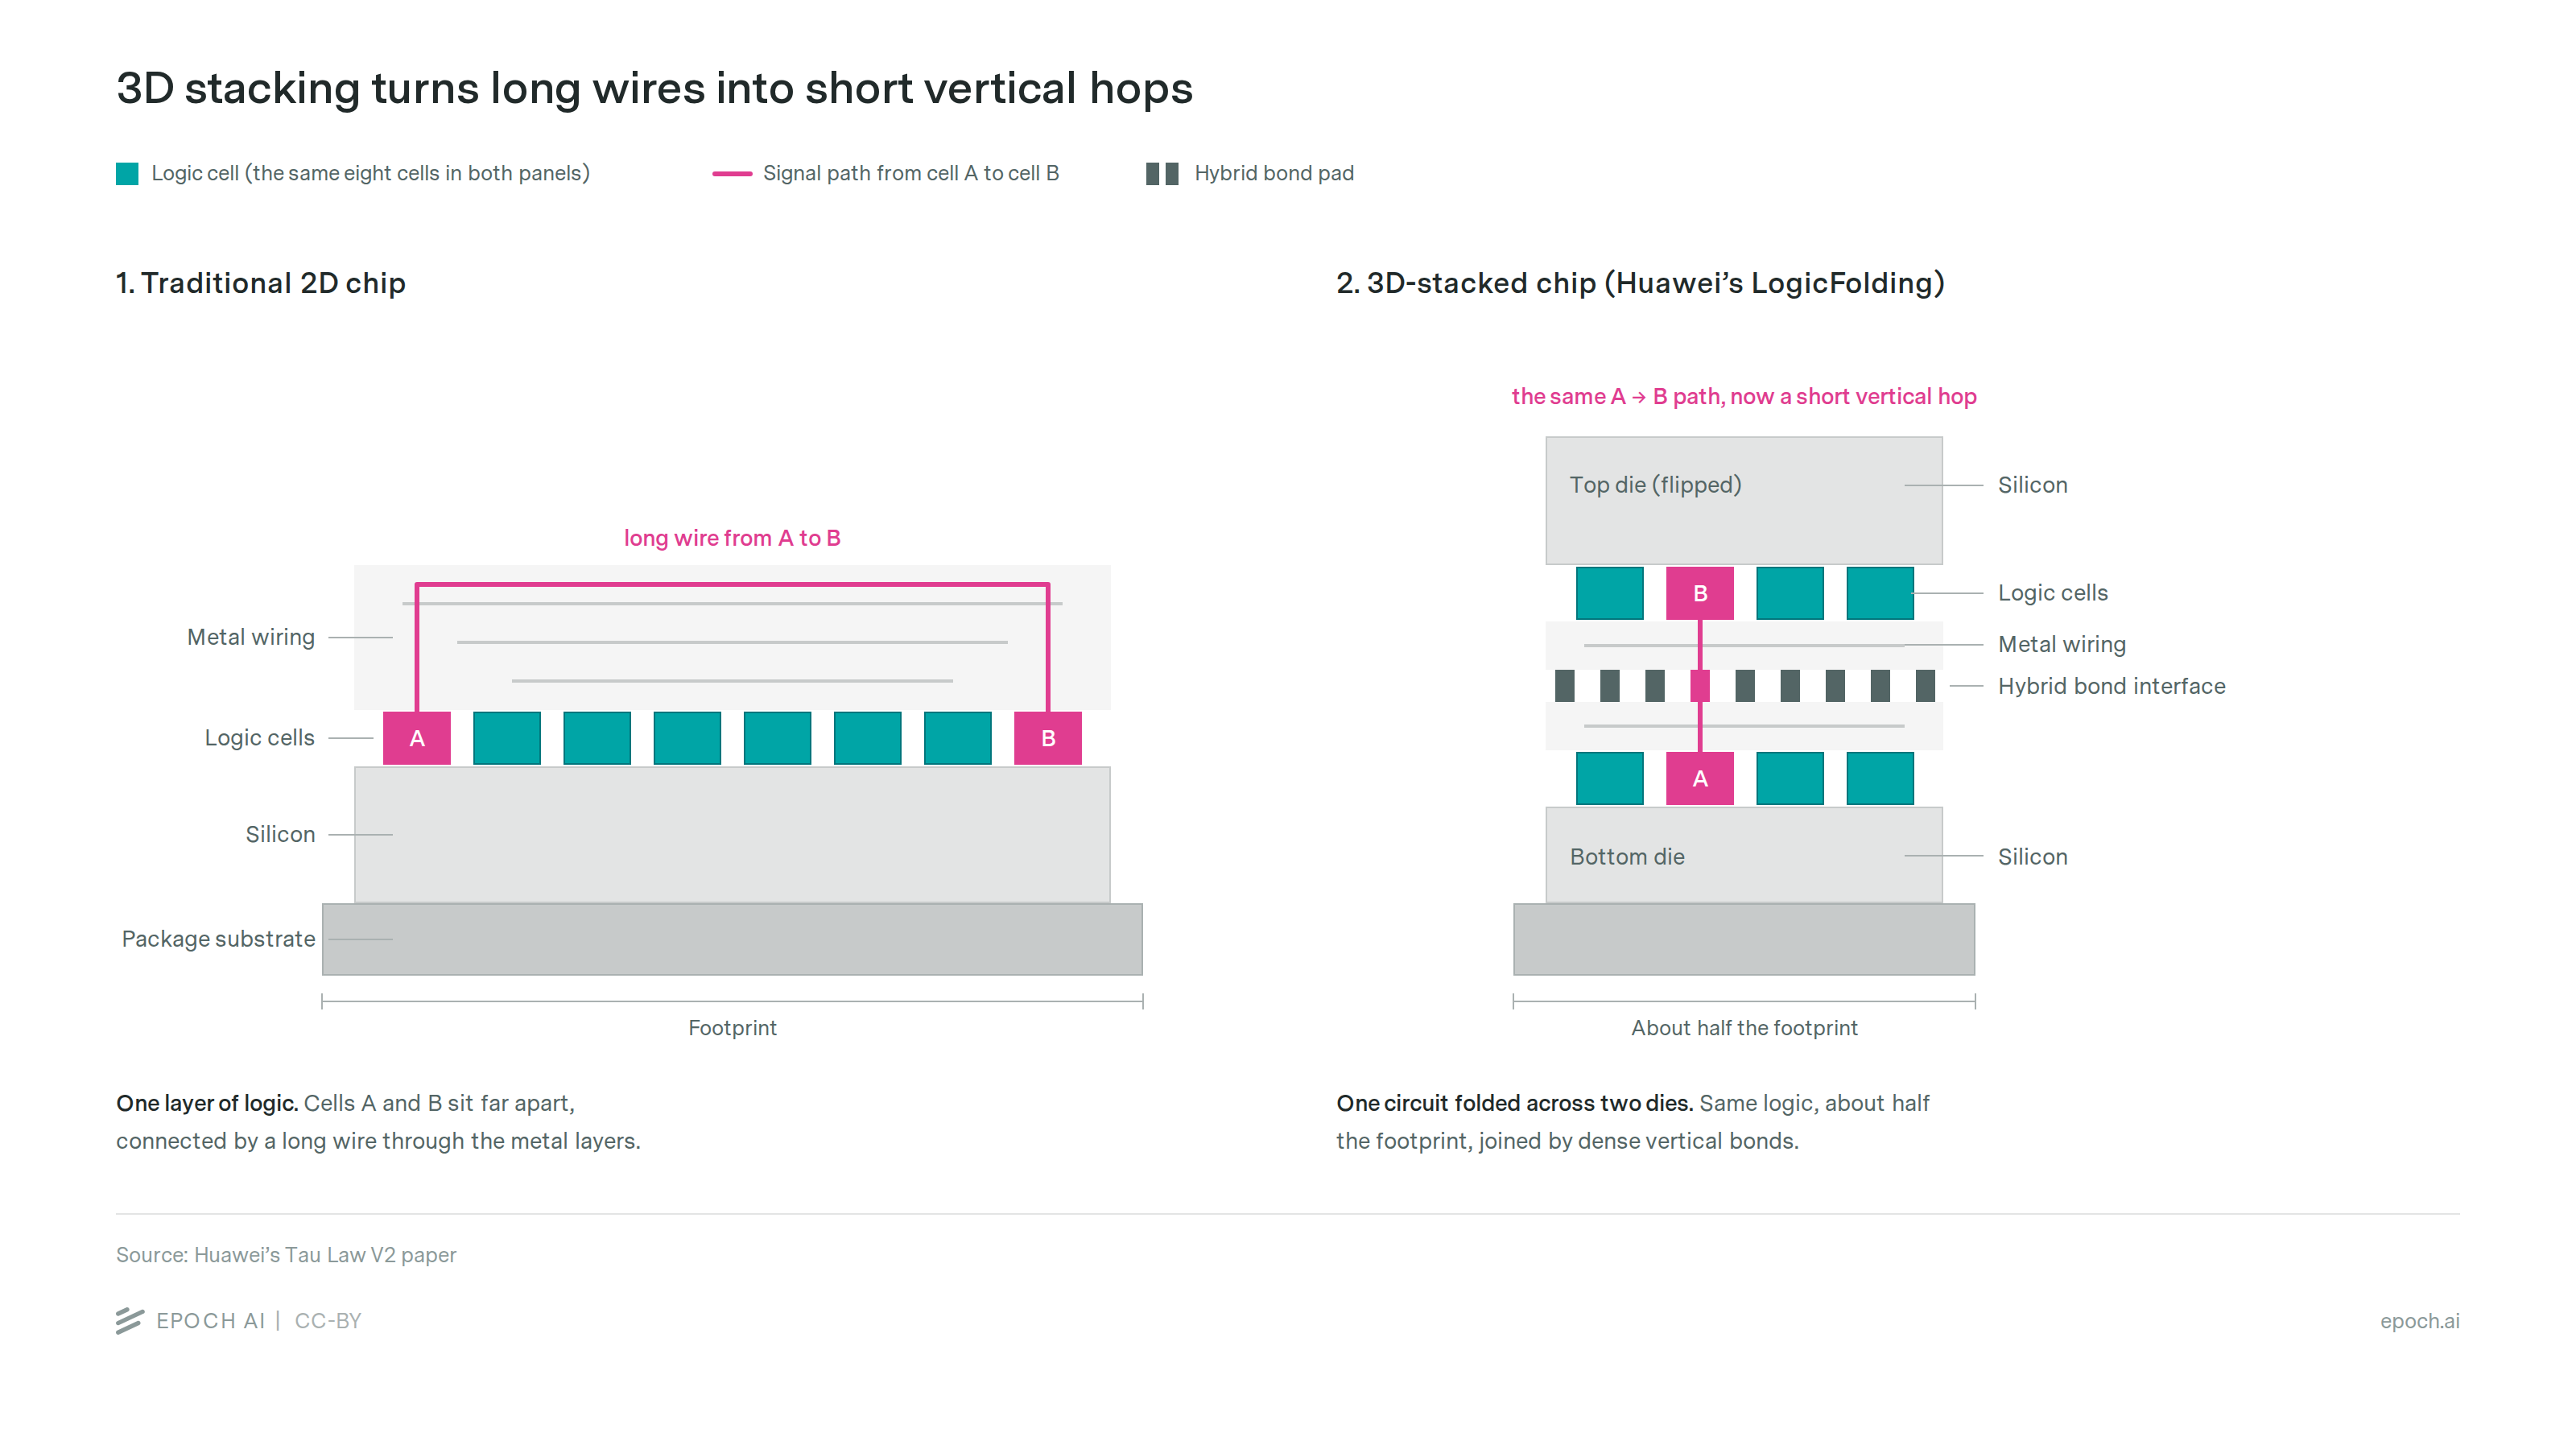
Huaweiは、積層にはパッケージのレベルで第三の効果、すなわちメモリとインターコネクトの帯域幅を高める効果もありうると主張している。従来の2.5DのAIパッケージでは、ロジックダイが中央に置かれ、その周りにHBMスタックと高速インターコネクトが配置される。チップに出入りするデータは、ロジックダイの縁にあるインターフェースを通らなければならない。そのため、ダイとの間でデータを移動できる速さは、ダイの周長に縛られる。
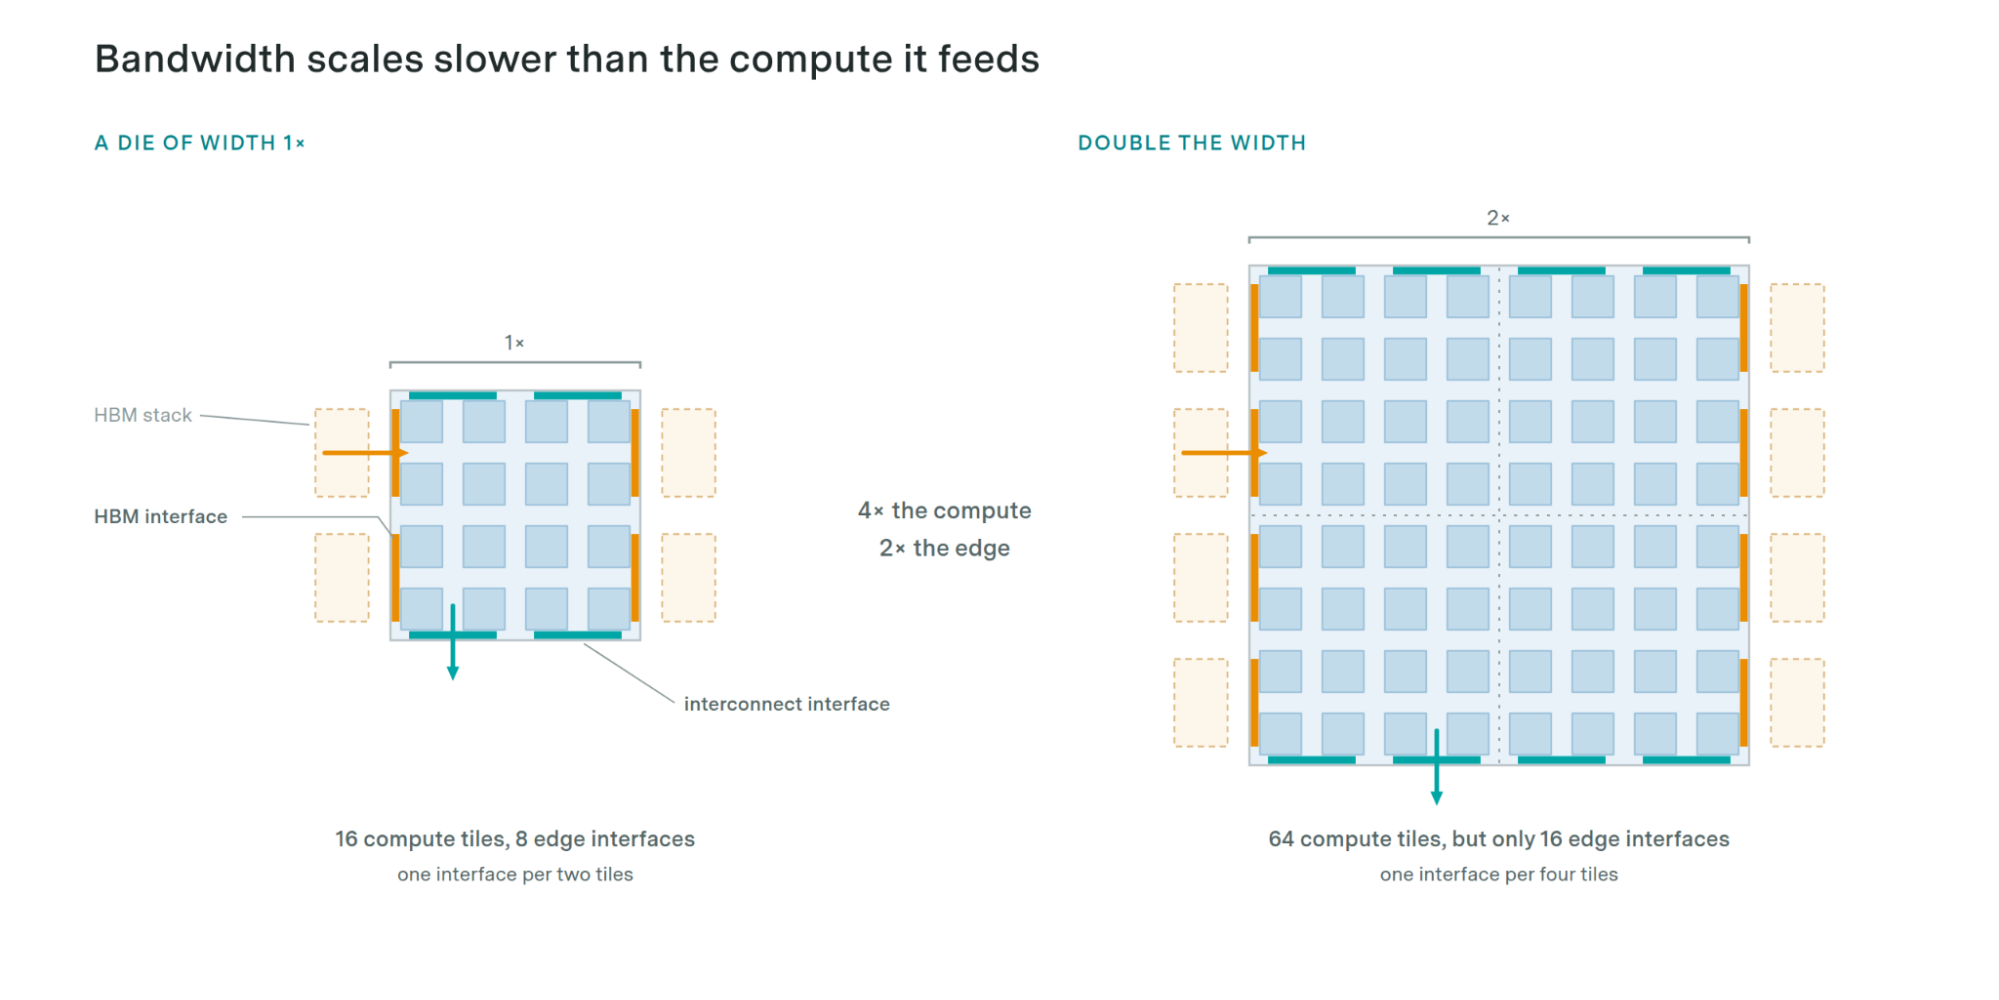
ここから幾何学的な不釣り合いが生じる。計算能力はダイの面積に比例して増えるが、インターコネクトとメモリのインターフェースに使える空間はダイの周長に比例してしか増えない。ダイの幅が2倍になれば、面積は4倍になるが、周長は2倍にしかならない。言い換えれば、計算能力は、それにデータを供給するためのメモリとインターコネクトの帯域幅より速く増える。Huaweiはこれを「N²対Nのファンアウトのジレンマ」と呼んでいる。ロジックを積み重ねるだけでは、この不釣り合いはむしろ大きくなる。メモリのインターフェースに使えるパッケージ上の面積を増やさずに、計算能力だけを増やすからである。
ロジックの上にロジックを積むのではなく、ロジックの上にメモリを積めば、この幾何学的な制約を組み替えられる可能性がある。ロジックダイに縁からだけデータを供給するのではなく、メモリをその真上か真下に直接接合し、高密度のハイブリッド接合でダイの面全体にわたって接続できる。そうすれば、メモリのインターフェースに使える面積がダイの面積に比例して増え、計算能力と同じ割合で増えるようになる。
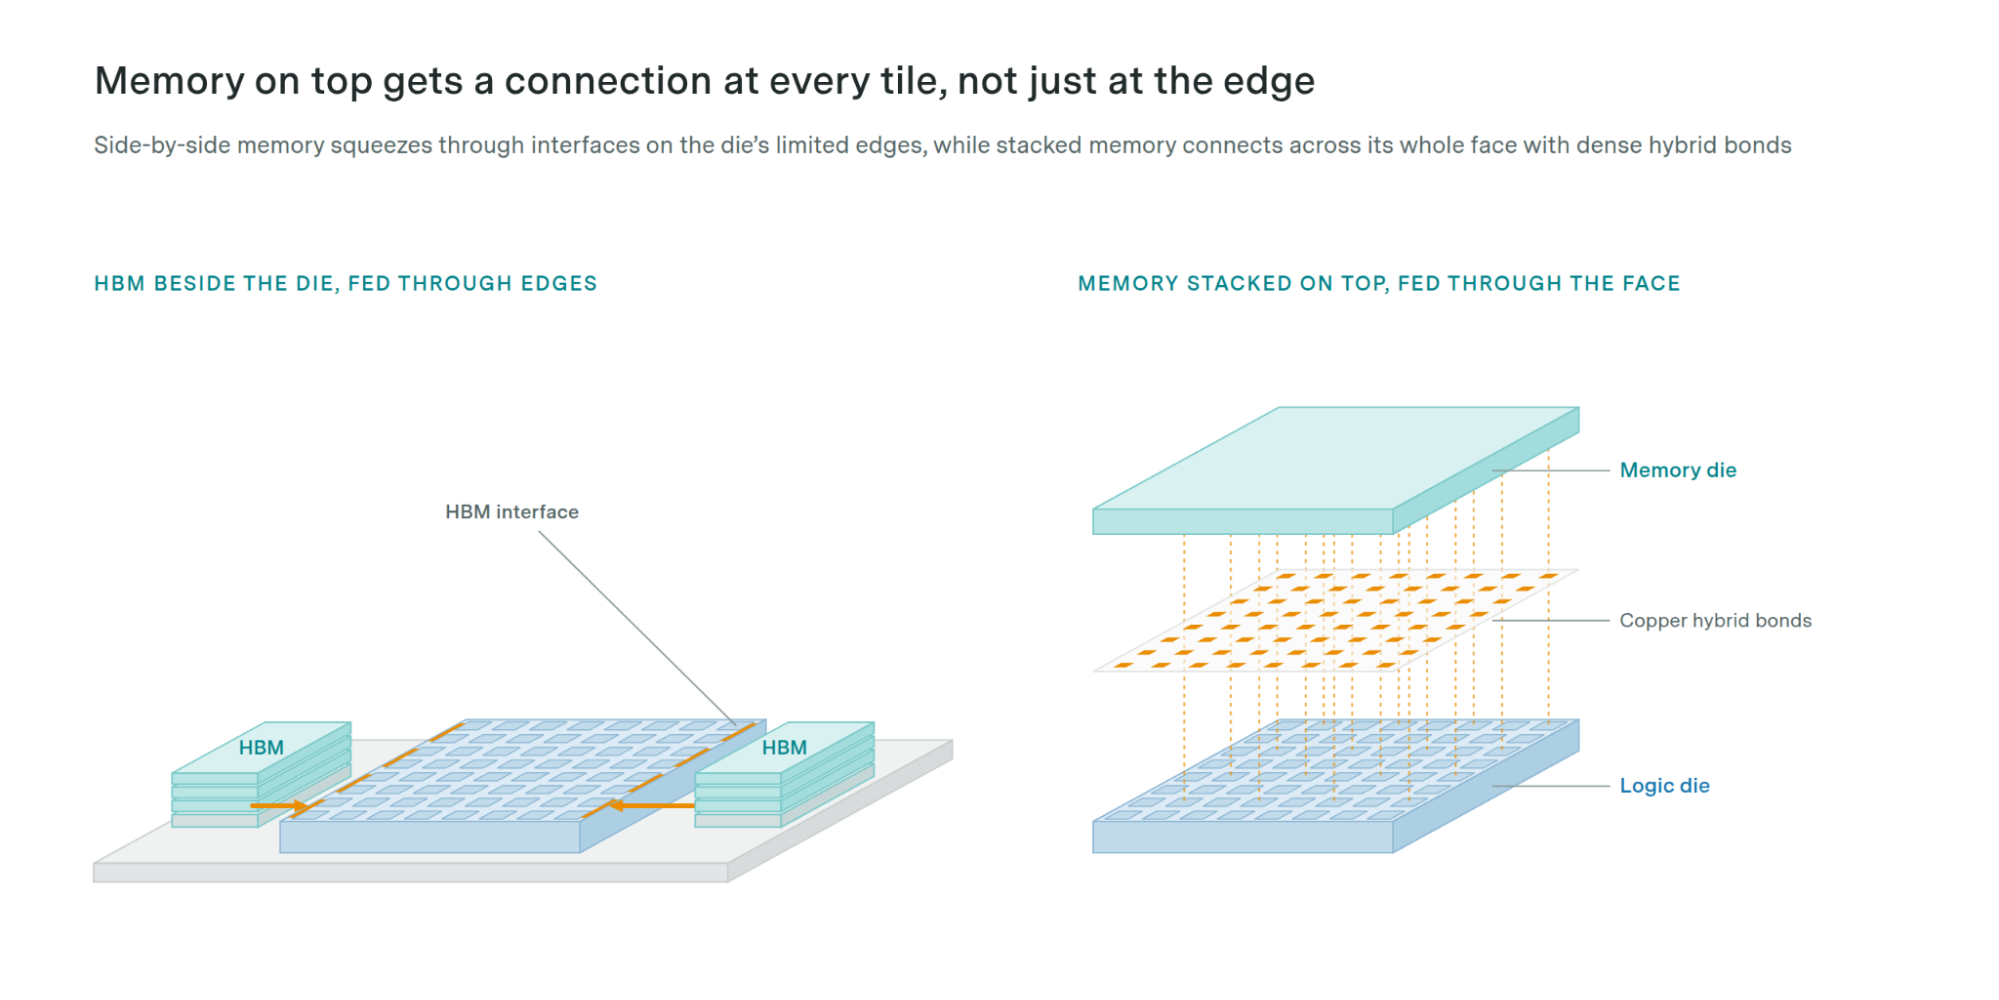
まとめると、3D積層へのHuaweiの賭けは、チップ1個あたりの制約に3つの方向から挑むものである。一定の面積あたりの計算能力を増やし、チップ内で一部の信号が移動する距離を縮め、メモリとインターコネクトの帯域幅を高める。詳しく読む:3D積層の技術的な課題
Huaweiとその製造パートナーは、3D積層の規模を拡大するために多くの技術的課題を解決しなければならない。
垂直に積み重ねるのは難しい製造工程である。2枚のダイを上下に積み重ねると、両者の間を行き来するすべての信号に、両者が接する界面をまたぐ物理的な接続が必要になる。別々のダイを1つのチップとして機能させるには、そうした接続にきわめて高い帯域幅ときわめて低い遅延が求められる。接続がまばらすぎたり遅すぎたりすれば、通信のオーバーヘッドが増え、利用率が下がる。
垂直に積み重ねた層をつなぐ製造工程は、ハイブリッド接合に頼っている。HBMのような従来の3D積層は、はんだのごく小さなマイクロバンプで層をつなぐが、その接続はタイミングが重要なロジックを層に分けるには大きすぎ、まばらすぎる。マイクロバンプと比べて、ハイブリッド接合は銅のパッド同士を直接接合するので、同じ面積にはるかに多くの接続を設けられる。高密度の界面によって層の間で信号を移動させるのにかかる時間とエネルギーが減り、LogicFoldingは、通信が深刻なボトルネックになることなく、ロジックブロックを2枚のダイに分割できる。
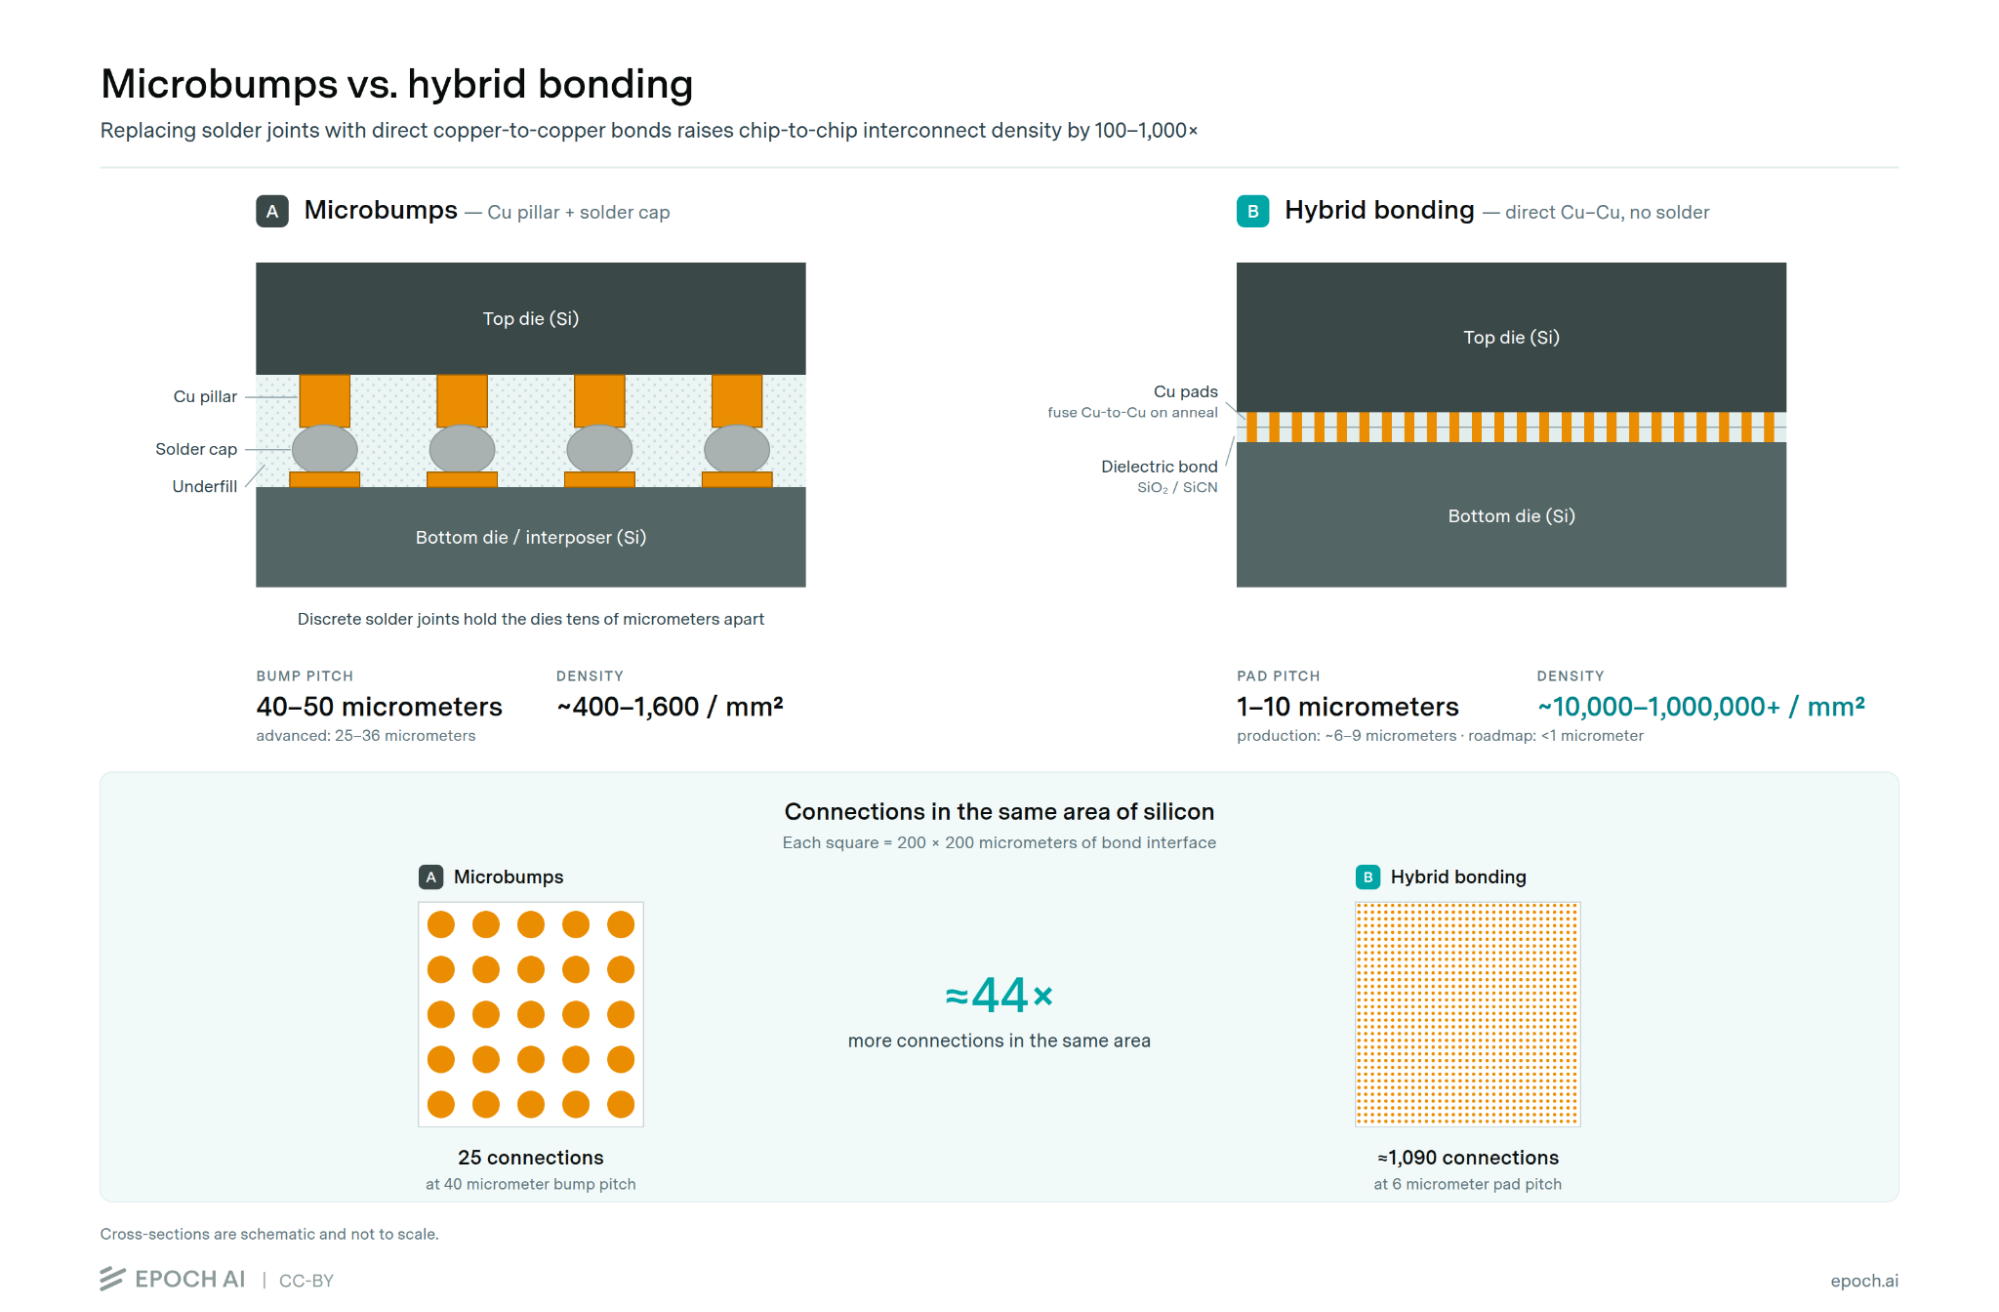
Huaweiにとっての課題は、小さなチップの折り畳みから、大きく電力を食うAIチップの折り畳みへと規模を広げることだろう。歩留まり、位置合わせ、冷却、電力供給、反り、テスト、設計の複雑さといった3D積層の多くの課題は、各層が大きくなり、層の数が増えるほど悪化する。2層を超える積層はとりわけ難しい。歩留まりの低下、熱、電力供給の課題が重なり、シリコン貫通ビア(TSV)の密度をさらに高める必要が出てくる可能性があるからである。
パッケージングでの中国の相対的な強み
垂直に積み重ねた層をつなぐパッケージング工程は、ハイブリッド接合に頼っている。ハイブリッド接合は難しいが、Huaweiの制約には合っている。パッケージングは中国の強みである。何十年にもわたって、半導体の組み立てとパッケージングはJCET、Tongfu、Huatianなどの企業に外注されてきたため、これらの企業は専門知識と規模を築いてきた。ハイブリッド接合についても、中国はゼロからの出発ではない。中国のメモリメーカーであるYMTCは、すでにNAND製品にこれを使っている。しかし、発熱が比較的少なく欠陥に強いメモリを積み重ねるのは、能動的なロジックを積み重ねるよりはるかに容易である。不確かなのは、HuaweiがAscendのダイ2枚を接合できるかどうか、そしてその工程をこの10年の終わりまでに高い歩留まりと大量生産で回せるかどうかである。
中国は、ウェハー接合装置、位置合わせ装置、化学機械研磨(CMP)装置など、ハイブリッド接合に必要な装置もそれなりに入手できる。その多くは米国の輸出規制の明示的な対象になっていない。主要な装置を比較的入手しやすいことが、HuaweiがLogicFoldingを実現可能な賭けと見なした一因である可能性が高い。
LogicFoldingのロードマップ
重要な点として、AscendシリーズでLogicFoldingが使われるのは2030年になってからの見込みである。それまでの間、HuaweiはLogicFoldingを数世代のKirinスマートフォン用チップに適用し、工程を成熟させる。32
| 年 | チップ | 折り畳み |
|---|---|---|
| 2025 | Ascend 910C | なし |
| 2026 | Kirin / Mate 90 | 2層、部分的 |
| 2026 | Ascend 950 | なし |
| 2027 | Ascend 960 | なし |
| 2028 | Ascend 970 | なし |
| 2029 | Ascend 980 | なし |
| 2030 | Ascend 990 | LogicFoldingを使う最初のAscend |
Ascendのダイと比べれば、スマートフォン用チップははるかに穏やかな出発点であり、2026年の折り畳み型KirinチップについてHuaweiが示した結果は、LogicFoldingの利点を示している。Huaweiは、密度が54%向上し、消費電力が41%減り、ピーククロック速度が13%向上したと報告している。33 ここからHuaweiは、スマートフォン用チップでさらに3世代にわたって改良を重ね、LogicFoldingの工程を成熟させる計画である。詳しく読む:LogicFoldingについてのHuaweiの短期のロードマップ
スマートフォン用チップのダイは小さい。小さなダイは欠陥を含みにくいので、2枚を積み重ねても歩留まりの問題は乗り越えられる程度で済む。たとえば、Kirin 9020のダイは137 mm²である。Kirinチップの歩留まりを70%と仮定すると、同じ欠陥密度なら800 mm²のダイの歩留まりは12%になる。積層には少なくとも2枚の良品ダイが必要なので、不利はさらに掛け合わさる。Kirinのダイで作った2枚積層の半分は成功するのに対し、800 mm²のダイで作った積層で成功するのは約1%にとどまる。同じ欠陥密度なら、Kirinチップの生産スループットはレチクルサイズのAscendチップの30倍になる。しかもこれは、接合の失敗を考慮する前の話である。
スマートフォン用チップは発熱が少なく、消費電力はおそらく10 W程度なので、数百ワットを使うAscendチップと比べて放熱ははるかに扱いやすい。またHuaweiのスマートフォンは数千万台規模で出荷されるので、ハイブリッド接合のラインは、歩留まりの学習曲線を上っていくのに必要な数量を確保できる。
HuaweiのKirinの密度ロードマップを見ると、2031年に段階的な飛躍があるようだ。このロードマップは、積み重ねたトランジスタをチップの2次元の占有面積で割って数えており、その値は2025年の1平方ミリメートルあたり1億5,500万個(MTr/mm²)から2026年には2億3,800万個に増える。最初の2層の折り畳みによる54%の飛躍である。その後、曲線は年約5%とゆっくり上がり、2030年には2億9,200万個に達する。Huaweiが見込むトランジスタ密度の伸びが鈍る理由の一つとして考えられるのは、5〜7 nm級のロジックを2層にしても、平面の値の最大2倍、およそ310 MTr/mm²までしか収められないことである。そのため2026年から2031年までの期間は、ダイのより多くの部分を2層に積み重ねることに費やされるのだろう。
2030年から2031年にかけて、密度は292 MTr/mm²から400 MTr/mm²に跳ね上がる。HuaweiはLogicFoldingがいずれ3層以上の能動層に広がると見込んでいるが、ロードマップの各時点で何層を計画しているかは明らかにしていない。とはいえ、2031年の急激な上昇は、層の追加、ダイのより多くの部分への折り畳みの適用、より高密度なセルレイアウトの採用、配線の改善、あるいはこれらの組み合わせによるものかもしれない。
Nvidiaはより高密度なダイをより早く積み重ねる
LogicFoldingによって、Huaweiは2030年まで、TSMCの最先端ノードが実現する平面のトランジスタ密度に遅れずについていける可能性がある。
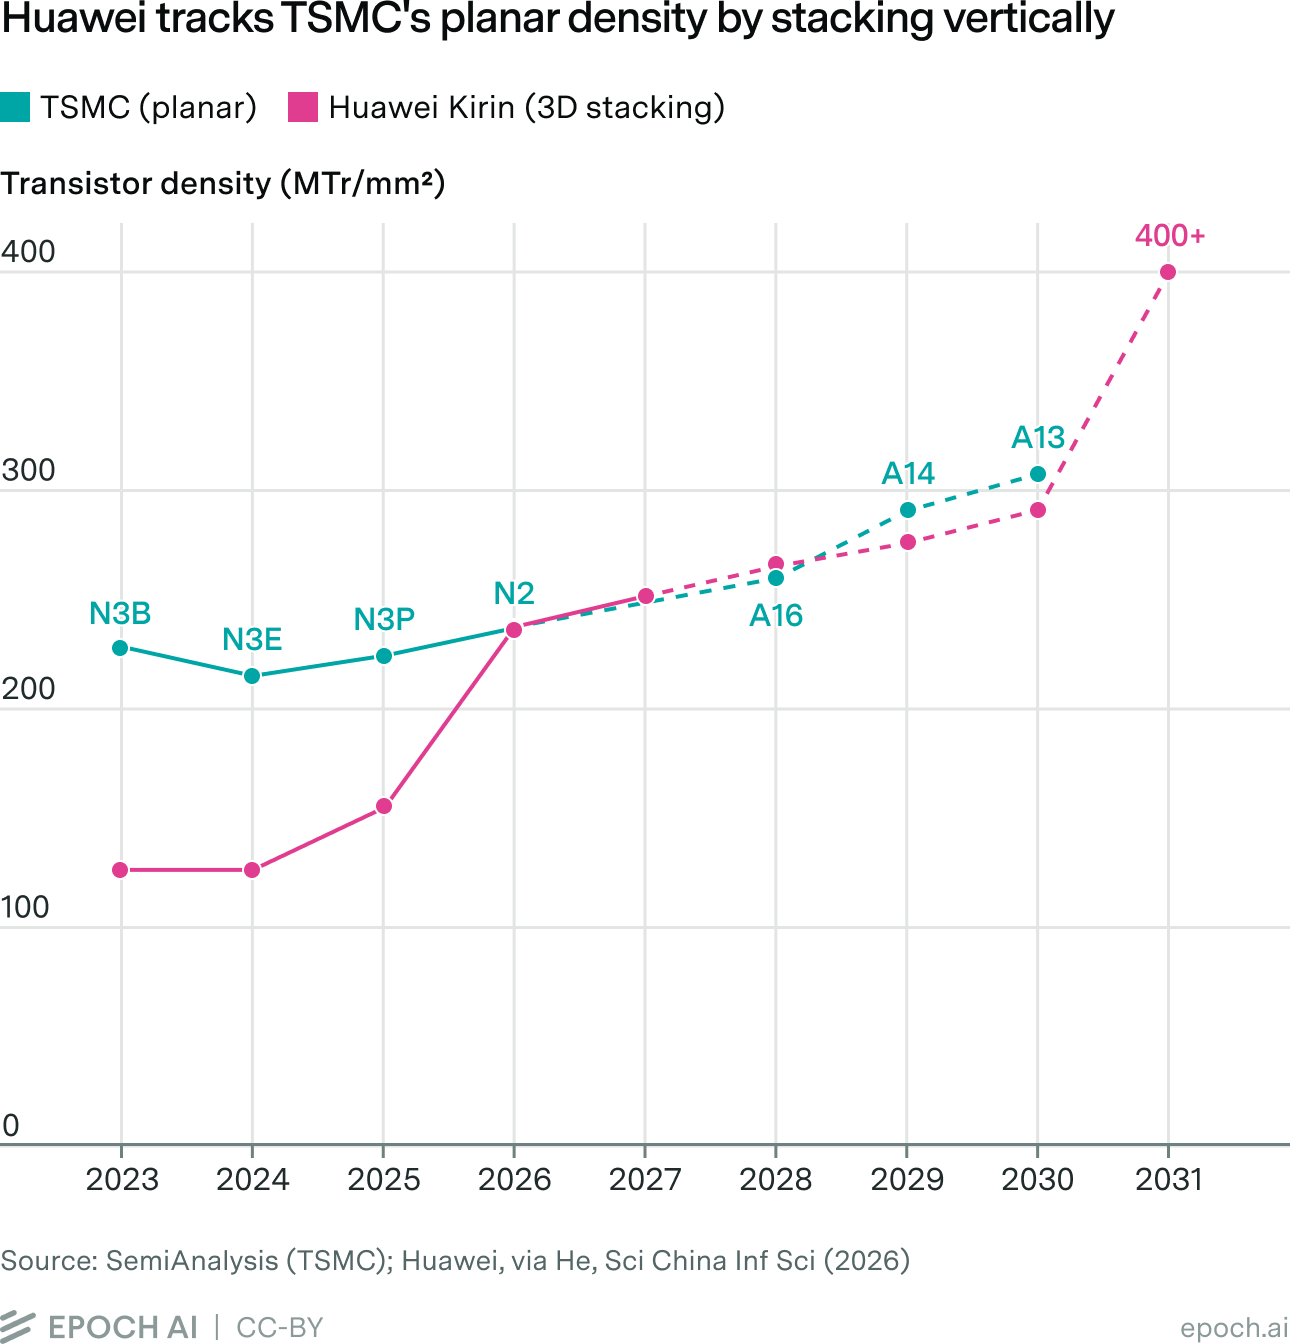
しかし、2030年より前のAscendチップは、950から980まで、どれも3D積層を使わない。また2031年に1.4 nm相当に到達するという目標も、歩留まり、製造装置、EDA、メモリの面での、まだ実現していない大きな進歩にかかっている。それまでの間、HuaweiのAscendの野望は、チップ性能を高めるより従来型の方法で支えなければならない。たとえHuaweiが2031年に3D積層によって1.4 nm相当の密度を実現したとしても、NvidiaのFeynmanは2年早く、1.6 nmプロセスで同様の技術を使っている。
LogicFoldingは、Huaweiの長期的な成功にとって決定的に重要である。5 nm級プロセスの限界を超えて計算性能を高め、メモリを計算ユニットの真上に直接積み重ねてメモリ帯域幅を高めることで、計算の壁とメモリの壁の両方を突破する助けになりうる。しかし、LogicFoldingがAscendシリーズに導入されるのは2030年になってからなので、中国のHBM生産能力が拡大しても、Huaweiのチップ1個あたりの性能の不利は、引き続き計算資源の総生産量を制約するだろう。
Huaweiは後れをとり続ける可能性が高い
Huaweiは、Nvidiaの約25分の1のAI計算資源しか生産できない状態で2026年を迎えた。そのチップは3〜4年遅れており、それを生産するサプライチェーンもNvidiaのものに及ばない。
Huaweiの不利の大部分の背後には輸出規制がある。輸出規制は、競争の2つの次元に同時に作用する。数量にはHBMと露光装置の入手という面から、性能にはHuaweiのチップを製造するプロセスノードという面から作用する。輸出規制はHuaweiの進歩を完全に止めてはいないが、Huaweiが競争することをはるかに難しく、遅く、高くつくものにしてきた。
その一方で、Nvidiaはリードを積み増している。NvidiaのHBM供給元であるSK Hynix、Samsung、Micronは、2030年までに製造工場の建設に数千億ドルを投じる。NvidiaのFeynmanはRubinから大幅な性能向上をもたらす可能性が高く、2030年までにNvidiaはFeynmanの後継の出荷すら始めているかもしれない。
Huaweiは世界で最も有能な技術組織の一つであり、いずれは追いつくかもしれない。垂直積層でNvidiaを上回り、CUDAとの利用率の差を埋めるほどソフトウェアを劇的に改善し、最先端のプロセスノードを利用できるようになり、生産を大幅に拡大すれば、である。しかし、こうした不利を克服するには時間がかかり、入手できる情報からは、それが2030年までに起こる可能性は低いと考えられる。
謝辞
有益なフィードバックをくれたJack Freed、Hamish Low、Saif Khan、JS Denain、Isabel Juniewicz、Josh Youに感謝する。図とビジュアルを作成してくれたIrene Trotta、そして編集を担当してくれたElliot Stewart、Lynette Bye、Sumiko Nearyに特に感謝する。
付録:必要な装置への中国のアクセス
中国は今でも、ハイブリッド接合に必要な主要装置の多くを輸入できる。このことは、Huaweiの戦略の中心にあった可能性が高い。下の表は工程の流れを整理したものである。実際に積層を作り出す工程の大半、すなわちウェハー接合装置、ダイ・ツー・ウェハー接合装置、仮接合と位置合わせ、そして接合面を研磨するCMPは、輸出規制の枠組みの外にある。
規制されていない工程は、Huaweiがいま足を踏み入れている2層の段階をちょうど網羅している。規制されている工程は、Huaweiのロードマップ上の最も難しい2つの問題の前に立ちはだかっている。歩留まりの改善と、1.4 nm相当の目標に必要な3層以上への移行である。つまり道は開かれているが、技術的に難しくなるまさにその地点で狭くなる。
| 工程 | 装置の機能 | 主要企業 | 輸出規制の対象か |
|---|---|---|---|
| TSVエッチング | 薄くしたシリコンを貫通する深い垂直ビアを掘り、層の間で信号と電力を通す | Lam Research, Tokyo Electron | 一部(Lamは対象、Tokyo Electronは対象外) |
| TSVの成膜/充填 | バリア層、シード層、銅層を成膜してTSVを電気的に埋める | Applied Materials, Lam Research, TEL | 対象 |
| ウェハーの薄化/研削 | 積層前にDRAMウェハーを数十ミクロンまで薄くする | DISCO, Tokyo Seimitsu/ Accretech | 限定的な規制 |
| ダイの個片化/ダイシング | 薄化したウェハーを個々のDRAMダイに切り分け、割れ、欠け、その他の損傷を最小限に抑える | DISCO, Panasonic, SPTS/KLA, Mosaic, Plasma-Therm, Synova | 対象外 |
| 仮接合と位置合わせ | デバイスウェハーをキャリアに貼り付けて約50 µmまでの薄化に耐えられるようにし、接合前にウェハーの組の位置を合わせる | SUSS MicroTec, EV Group, 3M, Brewer Science, DISCO | 対象外 |
| ウェハー・ツー・ウェハー接合 | 2枚のウェハー全体の位置を合わせ、銅パッド同士を向かい合わせにして接合する | EV Group | 対象外 |
| ダイ・ツー・ウェハーのハイブリッド接合 | テスト済みの良品ダイを取り上げ、ミクロン単位のピッチでベースウェハーにはんだなしで接合する | Besi, Applied Materials | 対象外 |
| 重ね合わせ計測と検査 | ナノメートル単位の接合の位置合わせを検証し、接合したダイを不良にしうる粒子、空隙、欠陥を検出する | KLA, Onto Innovation, Camtek | 対象外 |
装置メーカーは、ノイズは多いものの市場の動向を示す手がかりになる。Besiはダイ・ツー・ウェハーのハイブリッド接合装置の最大手であり、毎四半期に中国での売上を報告している唯一の専業ベンダーである。2024年の間、Besiは中国の最終市場での需要の弱さを繰り返し指摘していた。しかし2025年には、Besiの売上に占める中国の割合は、2025年上半期の約27%から第4四半期には45%に上昇した。第4四半期の受注額は過去最高の2億5,000万ユーロに達して前年の2倍を超え、2026年第1四半期にはハイブリッド接合装置の受注台数がさらに2倍超に増えた。
残念ながら、LogicFoldingが最も依存する種類の装置であるウェハー・ツー・ウェハー接合装置を作るEV Groupは非上場で、財務情報を公開していない。しかし、EV Groupの中国企業向けの売上は、過去2年で増えている可能性が高い。中国は国産の代替品の開発も急いでおり、Nauraは2026年3月にハイブリッド接合装置を発表し、Hwatsingは中国の国産CMPの旗手として台頭している。
ハイブリッド接合は、中国にまだ開かれている数少ない先進的な微細化の道の一つであり、だからこそHuaweiはこれに力を入れている。しかし、簡単なのは最初の2層の段階である。難しいのは、それを大きなAIダイ上の、高い歩留まりの多層ロジックへと発展させることだ。
注
-
国内のチップ設計企業のなかでは現在Huaweiが中国のAIチップ市場で最大のシェアを持っているが、Cambriconなど、ほかにも有望な中国企業が台頭している。 ↩
-
950PRは、B300よりもNvidiaのRTX Pro 6000 Blackwellに近い。RTX Pro 6000は、FP4性能2 PFLOPS、GDDR7の帯域幅1.6 TB/sと仕様が似ており、計算に律速されるプリフィルに向いている。B300との比較対象としてより適切なのはAscend 950DTである。Huaweiは950の2つの派生型に同じ計算ダイを使っているが、950DTには4 TB/sの帯域幅を持つ独自の「HiZQ 2.0」メモリを144 GB組み合わせている。950DTは帯域幅が高いので、B300とより比べやすい。米国のAIラボが推論実行のワークロードを分割し、プリフィルの部分にRTX Pro 6000を使っていたとしても驚くにはあたらない。 ↩
-
Huaweiは950でプログラミングのしやすさにも力を入れている。以前のAscendチップはSIMDのコードを実行していた。SIMDはシリコンの面では効率的だが、プログラミングが難しく、Nvidia GPU向けに書かれたソフトウェアとの互換性もない。950は、CUDAの基盤となっている実行モデルであるSIMTのハードウェアサポートを追加しており、ダイの総面積を縮小しながらも、そのためにダイの面積を割いている。 ↩
-
2024年、Huaweiは米国の輸出規制をすり抜け、ダミー会社のSophgoを通じてTSMCから約5億ドル分の7 nmウェハーを購入した。また、HBMに対する米国の輸出規制が2025年1月に発効する前の2024年最後の数か月間に、1,300万スタックのHBMを備蓄することもできた。 ↩
-
備蓄の推定は、2024年12月の輸出規制の前に蓄積された約1,300万スタックのHBM(各16 GB)から出発する。その80%がHuaweiに渡ったと仮定し、Huaweiの2024年末と2025年の生産ですでに使われたメモリ、すなわち64 GBの910B約30万個と128 GBの910C約61万個の分を、パッケージング歩留まり80%として差し引く。2026年に持ち越されたHuaweiの残りの備蓄は、910Cを28万個生産できる量と推定される。 ↩
-
私たちの密輸の推定は、きわめて不確かで推測的である。Samsungの販売代理店であるCoAsiaとFaradayの2社が、中国へのHBMの密輸に関与しているとされる。両社はそれぞれ月次の売上を公表しており、アナリストは、CoAsiaとFaradayの売上の急増は規制対象のHBMを中国に販売しているためだと推測している。密輸量を推定するために、ベースラインを超える売上を密輸による売上とみなし、1 GBあたり15ドルと仮定して売上をGBに換算する。密輸されたHBMの80%は、国内のAI計算資源の生産に占めるHuaweiのシェアに合わせて、Huaweiに渡ると仮定する。メモリの各供給経路は、仕様が適合するかどうかに基づいてチップに割り当てる。備蓄はHBM2Eであり、910Cに対応する。16 GB・8段積みの備蓄スタックは、4つのHBM搭載位置それぞれに24 GBのスタックを必要とする96 GBの950DTの仕様に合わない。約4 TB/sのメモリ帯域幅を持つ950DTにはHBM3級以上のメモリが必要なので、それを供給できる経路、すなわち国内のCXMTとXMCの生産分と、2025年・2026年ともにHBM3またはHBM3Eだったと仮定する密輸HBMだけを使う。そこで、2025年に密輸されたHBMは同年の910Cの生産に回ったものとしてモデル化し、約15万個分の備蓄を2026年に残す。これにより910Cの合計は28万個から43万個に増える。2026年の密輸の流れは、950DTの96 GB版7万8,000個分に換算される。私たちの密輸の推定はきわめて推測的なので、点推定ではなくシナリオとして扱うべきである。 ↩
-
Feynmanが、それぞれ異なるプロセスノードを使う2枚のダイを積み重ねる可能性もあり、これは珍しいことではない。AMDのMI450Xは、N3Pのベースダイの上にN2のダイを積み重ねている。しかし本分析では、両方の層が1.6 nmプロセスであると仮定する。 ↩
-
メモリモジュールの数、ピンの転送速度、バス幅などの詳細は不明であるため、Ascend 970がどの世代のHBMに相当するメモリを使うかを確実に言うのは難しい。 ↩
-
Googleも、TPU v7 Ironwoodチップを9,216個つなぐポッド規模の仕組みを構築している。しかしトポロジーは異なる。Googleは、Nvidiaの比較的小さな高帯域のスイッチ型ドメインやHuaweiのより大きな階層型ファブリックではなく、64チップのキューブを再構成可能な光回線スイッチでつないだ3Dトーラストポロジーを使っている。トーラスはきわめて大規模な光システムを経済的にするが、通信のオーバーヘッドは、プロセッサがトポロジーのどこに位置し、ワークロードがそこにどう割り付けられるかにより大きく左右される。 ↩
-
Ascend 910C、NPUパッケージあたりの値。SemiAnalysisは400 GB/sとしており、Huaweiの論文はデュアルダイのパッケージでダイあたり196 GB/s(約392 GB/s)としている。どちらも片方向で、差は約10%である。これはBlackwellの900 GB/sを下回っており、この比較はSemiAnalysis自身によるものである。 ↩
-
Ascend 950。Huaweiは2 TB/sとうたっているが、これはおそらく双方向の値である。Huaweiはこれを「Ascend 910Cの2.5倍」としており、910Cのチップあたりのスケールアウト帯域幅は片方向で400 GB/sである。 ↩
-
Ascend 960DT。Huaweiはチップあたりの双方向のインターコネクトを2.2 TB/sとしている(Tom's Hardware)ので、片方向では約1.1 TB/sとなる。 ↩
-
片方向の帯域幅。NvidiaはGPUあたりのNVLinkの双方向の帯域幅として1.8 TB/s(Blackwell)と3.6 TB/s(Rubin)をうたっているので、その半分は900 GB/sと1.8 TB/sになる。 ↩
-
Rubinのシステムは、GTC 2025では(ダイの数を数えて)「NVL144」として発表され、2026年に(パッケージの数を数えて)「NVL72」に改名された。 ↩
-
ネットワークの用語で言えば、二分割帯域幅(システムを半分に分け、一方の半分がもう一方にできる限り多くのデータを送るときに使えるデータ速度)が、一方の半分のGPUの送出帯域幅の合計以上になっている。 ↩
-
厳密には、ネットワークインターフェースカード1枚あたり100 GB/sである。 ↩
-
いずれにしても、各GPUがPCIeやチップ間リンクを通じてどれだけ速くネットワークにデータを送れるかによって制限されるだろう。 ↩
-
Huaweiは、ハードウェアのレベルで通信を調整するUnifiedBusと呼ばれるプロトコルを使っている。一般的なポッド規模のシステムは、それぞれ異なる階層で動く複数のネットワークを運用しており、ネットワーク間の受け渡しや形式の変換が必要になる。UnifiedBusはこれを置き換えて単一のプロトコルで動かすとうたっているが、この主張を、一様な接続がどこまでも延びるという意味に文字どおり受け取るべきではない。Huaweiは依然として距離に応じて異なるリンク、スイッチ、ネットワーク階層を使っており、現在のシステムでも、トラフィックの種類ごとにUB、RDMA、従来型のEthernetという別々のネットワークを残している。UnifiedBusはドメイン内の資源のアドレス指定と利用の仕方を統一するが、任意の2つのチップ間の距離を同等にするわけではない。 ↩
-
たとえばSemiAnalysisの測定によれば、ユーザーあたり毎秒約35トークンのGB300 NVL72ラックは、Dynamo vLLMではGPUあたり毎秒1,920トークンを出力するのに対し、Dynamo SGLangでは9,228トークンを出力する。トークンのスループットの差は5倍近い。マルチトークン予測など他の推論実行の最適化を加えると、スループットはさらに高まり、場合によっては1桁以上向上する。 ↩
-
HuaweiはAscendの開発者エコシステムの拡大にも取り組んでいる。CANNの構成要素の多くをオープンソース化し、AscendをPyTorch、Triton、vLLMなどのツールと統合しつつあり、数万個のGPUをエコシステムに提供することを約束している。これにより開発者は低レベルのソフトウェアを自ら修正できるようになり、Ascendをより広く使えるようになれば、より多くの人がその弱点を見つけて修正する機会を得る。 ↩
-
これまでのAscendの生産の多くは、外国製の部品に頼ってきた。報道によれば、ある分解調査で、Ascend 910Cの部品は完全な国産シリコンではなく、TSMCのロジックとSamsungまたはSK HynixのHBMを使っていることがわかった。たとえHuaweiが今後のAscendのロードマップで性能目標を達成したとしても、Ascendを数百万個生産するのに必要な規模で、中国国内のサプライチェーンが主要部品を供給できるかどうかは、未解決の問題として残る。 ↩
-
2028年までの推定では、HBMがAscendの生産を縛る制約であり続けると仮定している。ただし、先進パッケージングやロジックの供給が先に制約になったとしても、これらの数字は国内の生産量の上限として引き続き意味を持つ。 ↩
-
この2つの仮定を合わせると、国内のHBMを使うHuaweiの2026年の推定生産量は4分の1になる。 ↩
-
Huaweiの資料によれば、950DTはHBMスタックを4つ搭載している。容量の少ない版が、モジュールの1つが不良であることによって生じている可能性は低い。そうであれば容量は108 GBになり、帯域幅も3 TB/sに下がるからである。むしろ、容量の少なさは同じインターフェース上のより低いスタック、すなわち12段積み4つではなく8段積み4つによるものである可能性が高い。CXMTは12段積みよりも8段積みのHBMスタックを量産している可能性が高いので、このほうがCXMTの現在の能力によく合う。 ↩
-
SemiAnalysisの推定からは、CXMTがDRAMのウェハー生産能力のうちHBMに割り当てる割合は、2026年に8.6%、2027年に13.1%、2028年に20%へと高まることが読み取れる。この軌道を外挿すると、その割合は2029年に約26%、2030年に約32%になる。 ↩
-
Ascendのロードマップは2030年までに大きく変わる可能性があるので、この概算は私たちの他の数量の推定より大まかである。2030年にHuaweiが生産するのは、FP4で28 PFLOPSの性能と384 GBのHBMを目標とするAscend 980だけだと仮定している。 ↩
-
DRAMウェハーをHBMスタックに変換し、それを完成したチップに組み込む際の歩留まり。 ↩
-
この分解からは、結果がAI計算資源の生産量の測り方に大きく左右されることもわかる。H100換算の指標はチップ間のピーク性能の比を見るものであり、メモリ、インターコネクト、ワークロードの形、応答性などの要因は考慮していない。そのいずれもが、観測されるチップ性能を大きく動かしうる。 ↩
-
Rubin UltraはRubinと同じ量のロジックを搭載しつつ、わずかに高いクロック速度で動き、その結果、性能が35 PFLOPSから38 PFLOPSに上がると仮定している。これは推測であり、私たちが示す信頼区間に反映している不確実性の一つである。 ↩
-
2028年のRubin Ultraのメモリ帯域幅を31 TB/sとする推定は、チップがピンあたり15 Gb/sのHBM4Eを8スタック搭載すると仮定している。 ↩
-
比較的扱いやすいKirinのスマートフォン用ダイでさえ、Huaweiはチップ全体ではなく最も重要な部分だけを折り畳んでいる。この工程がいかに難しいかを示すものである。 ↩
-
ただし、これらの向上は2つの異なる条件で測ったものである。41%の電力削減は、折り畳み型チップを2.5 GHz、0.9 Vに落として動かし、2.75 GHz、1.1 Vの従来チップと、Huaweiが同等性能と呼ぶ条件で比べたものである。13%のクロック向上は、最大の1.1 Vで測ったものである。チップはどちらか一方の動作点で動くので、見出しの数字は一つにまとまった向上ではなく、トレードオフである。 ↩