
レポート
AI は IKEA 家具の組み立てを考える力を大きく伸ばしている
原題:AI has improved significantly at reasoning about IKEA furniture assembly
AI は、組み立て途中の IKEA 家具の写真から誤りを見つけられるだろうか。車や家電の修理のように、同じような視覚的・空間的推論を必要とする経済的に重要な作業は多い。この課題はそうした作業のよい代理指標になると私たちは考えている。この分野でモデルが十分に速く正確に推論できるなら、複雑な物理的組み立てや修理の作業について、AI が近いうちに信頼できるリアルタイムの手引きを提供できるようになる可能性は十分にある。
この能力は重要なのに、これを試す既存の視覚推論ベンチマークはほとんどない。この空白を埋める一助として、私たちは Furniture Assembly Benchmark(FAB、家具組み立てベンチマーク)を作成した。このベンチマークは、3種類の IKEA 家具の組み立てにまたがる60枚の画像からなる。正しく組み立てられた家具を写したものもあれば、(意図的な)誤りを含む組み立てを写したものもある。AI モデルには、画像に加えて組み立て説明書と、画像を調べるためのツールが与えられる。FAB で高いスコアを得るには、誤りがあったすべての手順を特定し、それぞれの誤りを妥当に説明しなければならない。
要点
- モデルはこの1年で大きく向上した。2025年11月時点の最高スコアは、Anthropic の Claude Opus 4.5 が記録した28%だった。そのわずか10か月後、現在は OpenAI の GPT-6 Astra が80%で首位に立っている。
- GPT-6 Astra は速度も大きく向上しており、写真1枚あたりの所要時間の中央値は3分である。これは私たちが評価したモデルのなかで最も速く、それまで首位だったモデルの2〜10倍の速さである。
- 首位のモデルは常にクローズドウェイトであり、中国のオープンウェイトモデルは最先端(フロンティア)に少なくとも7か月遅れている。
Furniture Assembly Benchmark の実施方法
私たちは、組み立ての難しさが異なる IKEA 家具を3点購入した。難しさは IKEA Complexity Index(IKEA 複雑度指数)で測った。この指数は、手順の数と部品の数の積として複雑さを算出する。こうしておけば、大きく複雑な家具ほどモデルが苦戦したかどうかを調べられる。
| 製品名 | 種類 | IKEA 複雑度 指数 | 人間の推定 組み立て時間(時間) |
|---|---|---|---|
| STÄLL | 靴収納 | 4,032 | 1.5 |
| TONSTAD | ベッドフレーム | 10,878 | 3.5 |
| GULLABERG | チェスト | 21,320 | 5 |
次に、写真を撮りながら家具を組み立てた。組み立ての途中では、意図的に誤りを入れた。現実にありそうな間違え方になるよう最善の判断を尽くし、見つけにくくするため、誤りのあとも組み立てを続けることが多かった。誤りを含む写真では、どれもその問題がはっきり見える。誤りの一例を下に示す。このベンチマークで人間の成績はまだ測っていないが、組み立てに慣れていない人にとっては、こうした誤りの多くを見つけるのは難しいだろうと予想している。
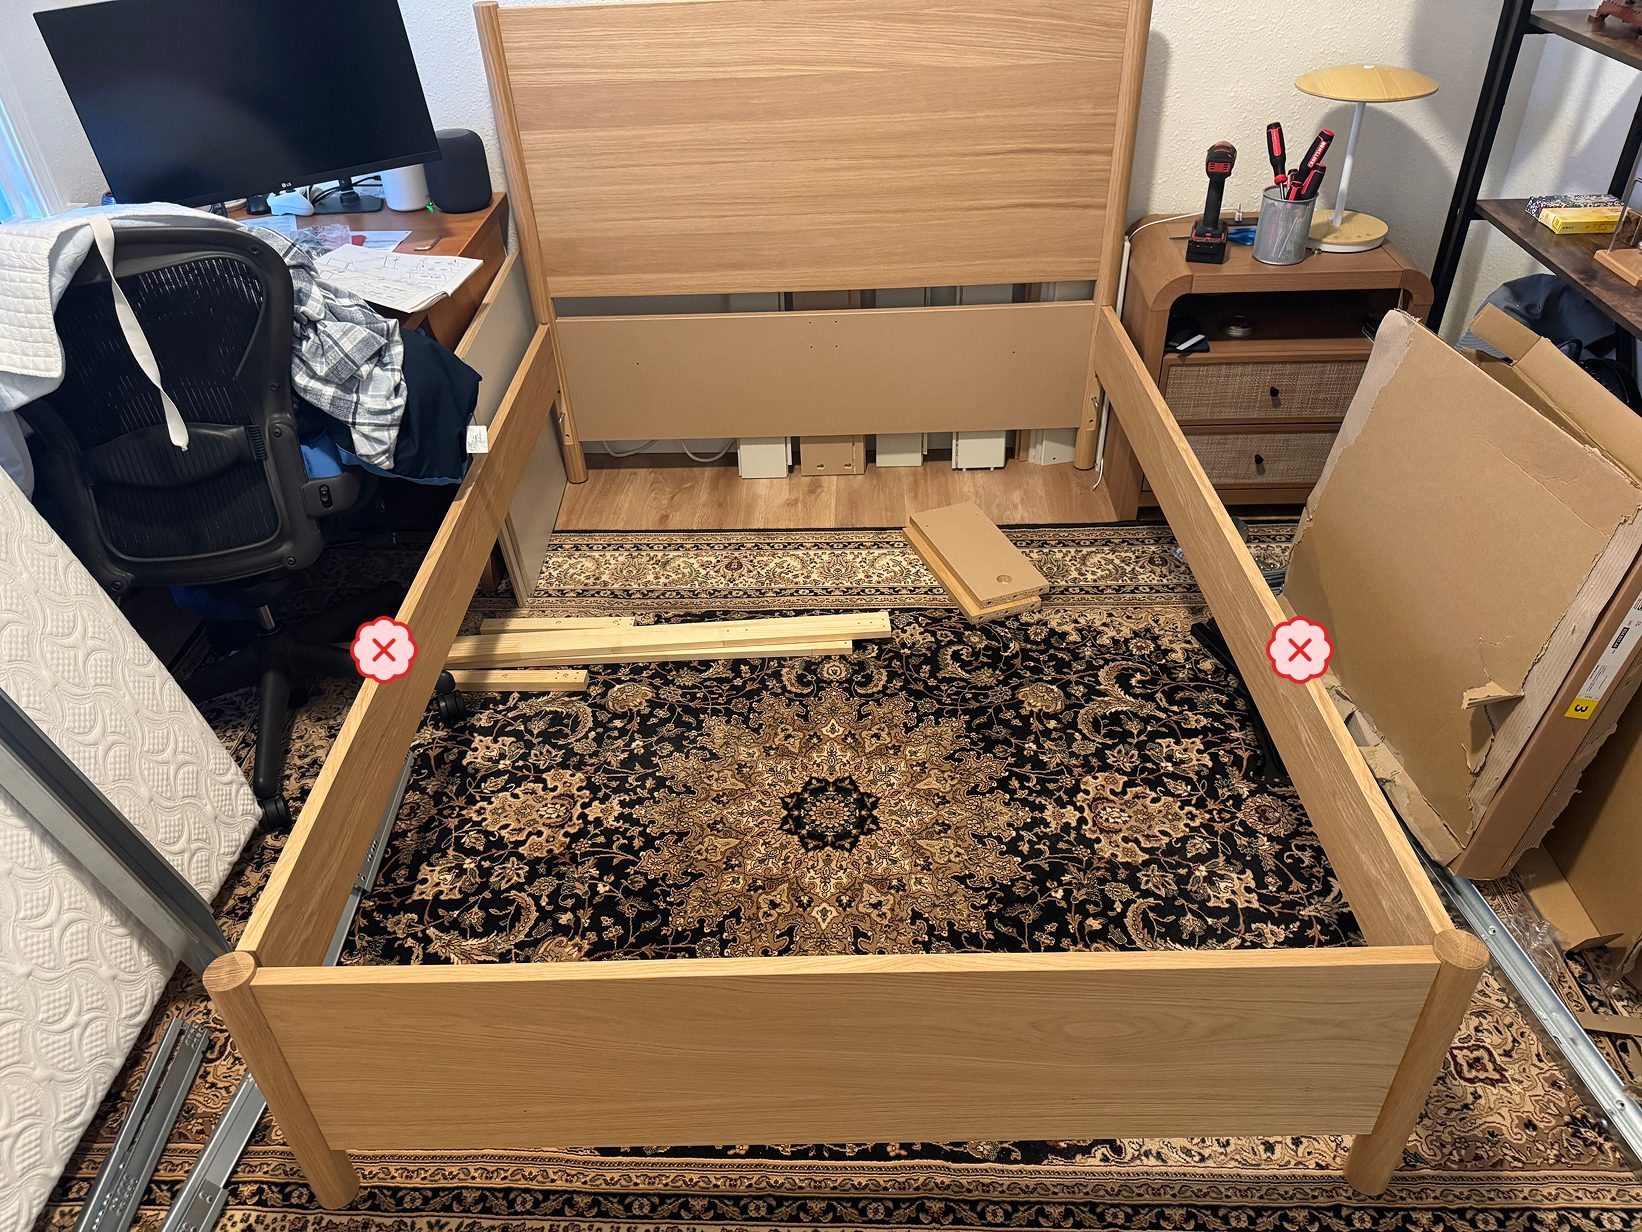
上の画像は誤りである。化粧板が外側ではなく内側を向いている。下の画像は正しい。
私たちは、OpenAI、Anthropic、Google、Moonshot、Alibaba が開発した複数のモデルを評価した。評価では、モデルに画像を見るよう指示する。誤りを見つけた場合は、誤りを含む手順をすべて挙げ、問題を説明しなければならない。誤りがない場合は、組み立ての次の手順へ利用者を案内しなければならない。モデルには、説明書の PDF、画像の一部をより高精細に見るためのズームツール、Python インタープリタが与えられる。モデルはサンプル画像1枚ごとに、エージェント用のサンドボックスで80ステップの上限を与えられる。上限に近づくと警告が出され、上限に達すると最終回答を求められる。実際には、この上限に達したのはサンプルの5%未満だった。
採点は複数の段階に分かれている。誤りがなく、モデルがそれを正しく見抜いた場合は正解とする。誤りがある場合は、誤りのあった手順を正しく特定したかどうかをモデルの回答で確かめる。これも通過したら、最後に、特定した誤りが正確であることを確かめるため、誤りの説明が LLM 採点者の判定を通過しなければならない。LLM 採点者のモデルは GPT-5.6 Sol で、非常に寛大に採点するよう指示している。誤りのある手順を正しく特定し、問題をおおまかに説明できていれば、得点が与えられる。
結果
最初のリーダーボードを作るため、主要な AI 企業がこの1年間にリリースした、画像を扱えるモデルをいくつか試した。最高スコアのモデルは80%の GPT-6 Astra で、次点の Claude Fable 5.1 と Claude Opus 5 はそれぞれ70%と61%だった。
モデル間・家具間の正答率の違い
どの家具で苦戦するかは AI モデルによって異なり、IKEA 複雑度指数とのはっきりした関係は見られなかった。このため私たちは、家具の大きさや使う部品の数よりも、誤りの分かりにくさ、撮影の角度、誤りのあとどこまで組み立てを続けたかといった他の要因のほうが、難しさに大きく寄与したのではないかと考えている。
能力の進歩の推移
この1年にリリースされたモデルを試せば、能力がどれほど速く進歩してきたかをさかのぼって確かめられる。試したモデルのなかでは、2025年11月に Opus 4.5 が28%で最高水準を記録した。1 その10か月後の2026年9月には、Astra が80%を記録した。
中国のオープンウェイトモデルの成績
現時点で最良の中国製モデルであるオープンウェイトの Kimi K3 は、リリースの時点で最先端に7か月遅れていた。Kimi K3 と最先端との差は、FAB では汎用的な能力よりも大きい。Epoch能力指数(ECI)で測ると、Kimi K3 の遅れは汎用的な能力ではわずか4.4か月だった。中国製モデルで画像を扱える能力はまだ珍しい。DeepSeek V4 の Pro と Flash は画像入力に対応しておらず、Z.ai の GLM 5.3 も同様である。こうした能力が広まるにつれて、この分野の進歩を引き続き追跡していく。
失敗のパターン
失敗のパターンは、同じ系統のモデルどうしで共通していることが多い。Google の Gemini と Alibaba の Qwen は、ほぼ常に誤りがあるものと決めてかかる。一方、初期の Anthropic と OpenAI のモデルは逆方向に間違え、誤りをまったく見つけられないことがあまりに多かった。
モデル間の効率の違い
効率の点では、Astra が際立っている。他のモデルが使う時間とトークンのごく一部で、最高の正答率を達成できる。2 1課題あたりの中央値は3分で、実用的なリアルタイムのフィードバックにはまだ少し遅いが、それほど遠くはない。
結論
今回の結果からは、フロンティアモデルが写真と技術的な説明書を使って物理的な組み立てについて推論し、組み立ての誤りを見抜けることがうかがえる。性能はこの1年間向上し続けており、GPT-6 Astra は性能と効率の両面で最新の飛躍となった。正答率と応答の遅さはリアルタイムでの利用にとってまだ制約だが、この分野は急速に進歩している。
私たちがモデルを試したのは、3種類の家具の組み立てから撮った60枚の写真だけなので、この結果が他の物理的な作業にどこまで当てはまるかはまだ分からない。それでも、説明書を実物と結びつけて誤りを見つけられるということは、保守や機械の故障診断に役立つ空間推論の能力をモデルが備えていることをうかがわせる。Furniture Assembly Benchmark が、モデルの物理的な推論能力を測り、それが現実の作業にどうつながるかを理解する研究をさらに後押しすることを願っている。