
レポート
AIは練習してもこのボードゲームが上達しない
原題:AI doesn't get better at this board game with practice
AIシステムは、難しいタスクを何度も繰り返し、失敗から学ぶことで、その場で上達できるのだろうか。これは現在のAI能力をめぐる最大の未解決の問いの一つであり、経済と安全の両面で大きな意味を持つ。私たちの最新のベンチマーク EBR-bench は、複雑なボードゲーム Earthborne Rangers を繰り返しプレイさせることで、AIシステムにこの能力があるかを試す。今のところ、AIが経験から学んでいる証拠はほとんど見られない。EBR-bench をベンチマーク群に加えたことで、この状況が変わるかどうか、変わるならいつ変わるのかを検出する新しい手段が得られた。
ゲームを覚えることは重要な能力の代理指標になる
不慣れなタスクをその場で身につけられるAIシステムがあれば、見慣れたシステムよりはるかに有能になるだろう。経済的に重要なあるタスクを最初からうまくこなせなくても、「仕事をしながら」学べるからである。また、学習によって危険な能力を獲得しうるため、公開前にそうした能力を持つかどうかを判断するのも難しくなる。私たちは、ゲームを覚えることが、こうしたより影響の大きい種類の学習の妥当な代理指標になると考えている。新しい仕事であれ、科学上の新しい理解であれ、何かをゼロから解き明かすという中心的な営みは似ている。
ただし、どんなゲームでもよいテストになるわけではない。求めているのは、AIシステムが最初は弱いが、上達を妨げる明白な要因がないゲームである。AIシステムが学習の段階でゲームを知ってしまわないよう、ある程度知名度の低いゲームが望ましい。AIシステムは一回きりのパズルゲームなら幅広くすでにかなりこなせるので、戦略と戦術を重層的に組み合わせる必要があり、比較的長い時間軸で展開するゲームが望ましい。また、多くのAIシステムはマルチモーダルな推論が苦手なので、テキストベースのゲームを選ぶ。成績の悪さの主な原因がそこにある可能性を排除したいからである。
Earthborne Rangers(EBR)はこの条件によく合う。プレイヤーが荒野を探索し、障害を乗り越えながら目標を追うキャンペーン形式のゲームである。知名度は比較的低く、ほぼ全面的にカードで進行して空間的な推論はほとんど必要なく、デッキ構築と一手ごとのプレイの両方で戦略と戦術の組み合わせが求められる。本ベンチマークが扱う部分を人間が1回プレイするのに2〜4時間かかり、ゲームを極めるには数十回のプレイが必要なこともある。12
AIは繰り返しプレイしてもEBRが上達しない
私たちの設定では、AIシステムにゲームを何度も(設定に応じて10回または30回)通しでプレイさせる。ルールブック、カードのデータベース、ゲーム内の地点の地図を与える。3 目標は、全プレイのうち最後の20%で得るスコアを最大化することだと伝える。メモを取って失敗から学ぶようにも促す。それでも、AIシステムがゲームとの関わりから学んでいる証拠はほとんど見られない。
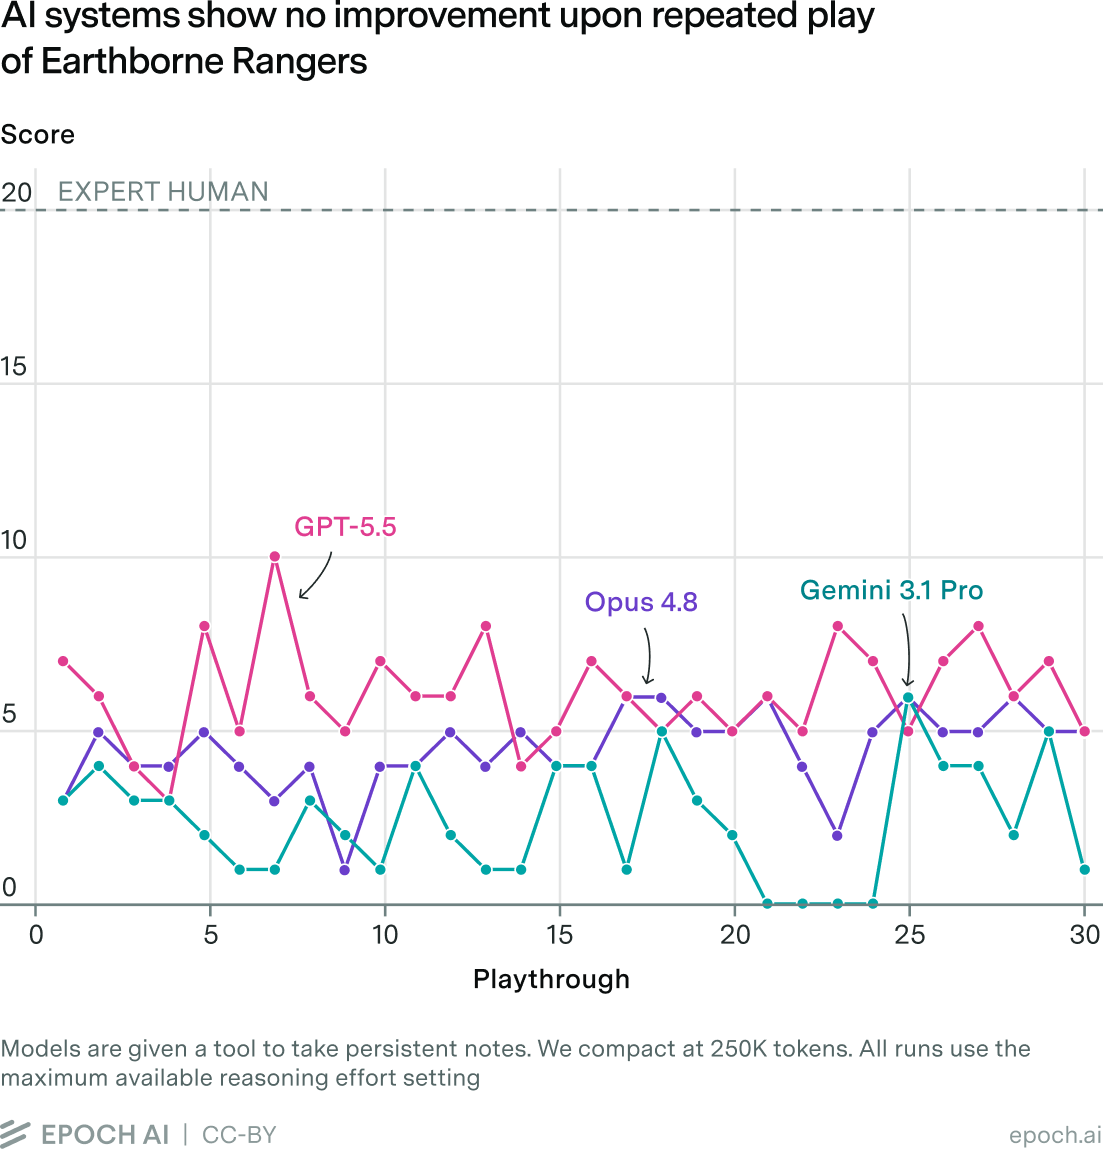
フロンティアAIシステムはこのゲームがひどく下手なわけではない。最初のプレイでは、経験の浅い多くの人間より良い成績を収めると私たちは予想している。4 スコアもこの1年でやや向上しており、GPT-5.5 と Opus 4.8 は GPT-5 と Opus 4.1 を上回っている。5 しかし、これは初回のスコアが高くなったためであり、その場での学習によるものではない。その場で学習する能力がこの期間に少しでも向上したという証拠はまったく見られない。
以下では、このゲームでのAIの成績をより詳しく論じ、より良い成績を引き出せるかを確かめる今後の計画を説明し、最後にこれらの結果がAI能力の全体像の理解にどう影響するかを考察する。
エージェントは戦術の実行が下手である
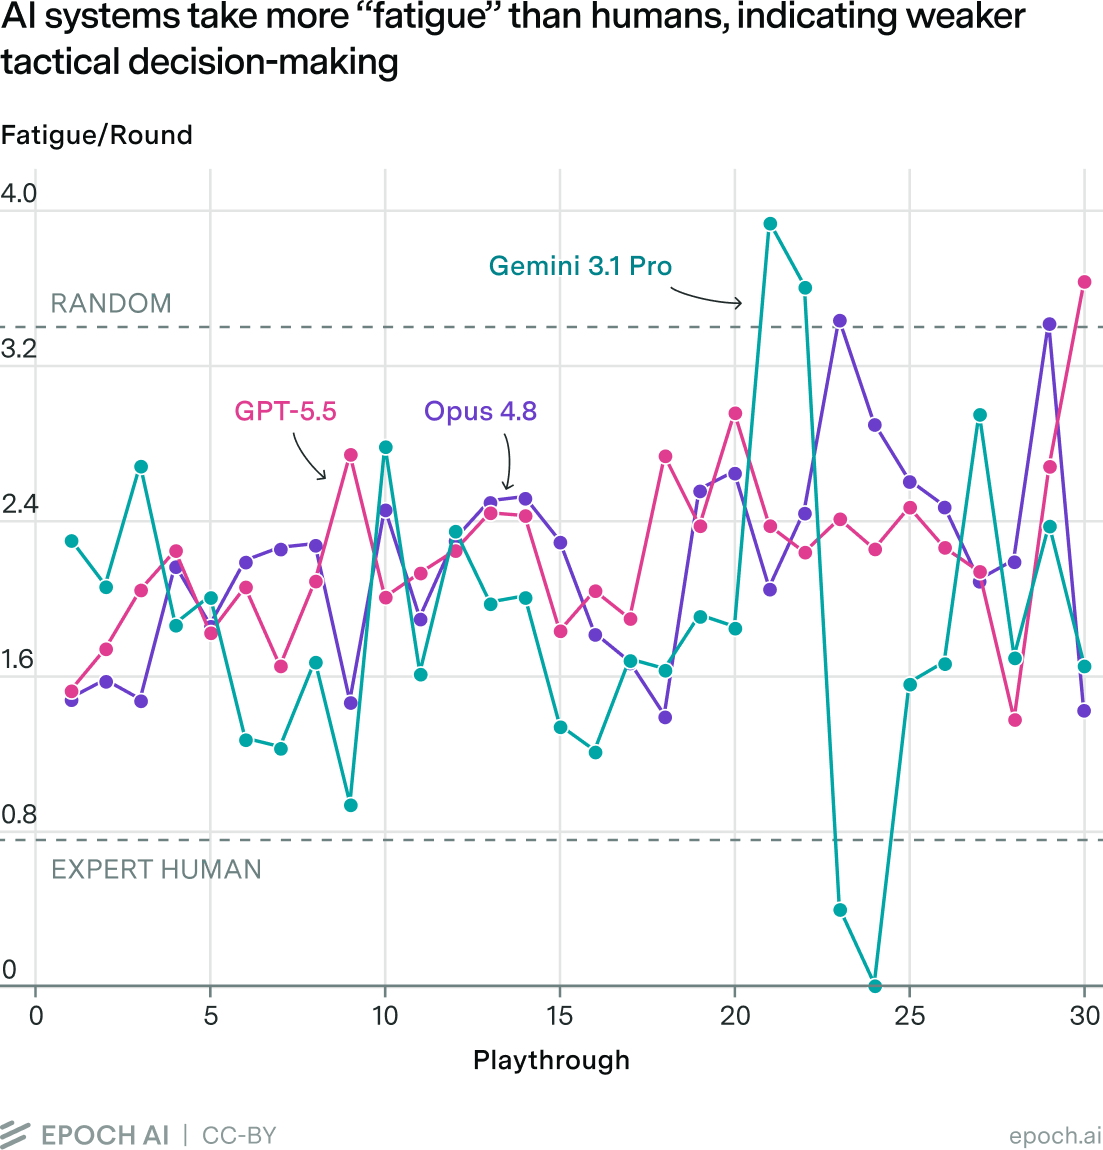
エージェントが犯す主な戦術上の誤りは、「疲労(fatigue)」というゲーム内の仕組みに関わる。これは他のゲームの「ダメージ」に相当する。Earthborne Rangers のひねりは、ダメージでプレイヤーの体力が減るのではなく、受けた疲労の分だけプレイヤーのデッキの一番上からカードが「疲労の山」に移り、デッキのカードが尽きるとゲーム内の1日が終わる点にある。つまり、プレイヤーの「体力ゲージ」「残り時間」「カード資源」がすべて、デッキに残ったカードの枚数で同時に表される。そのため Earthborne Rangers では、疲労を最小限に抑えることが成功の鍵となる。
疲労の管理は、現在の局面を正しく分析し、カードを効率よく使うことを求める戦術上の課題である。プレイヤーが目標を追う前に敵の生き物や障害を無力化できないと、それらに悩まされることになる。熟練した人間のプレイヤーは、毎ラウンド疲労の原因を費用対効果よく無力化し、目標を追うための資源を十分に残す。これに対しAIエージェントは、しばしば無謀に目標を追って不必要な疲労を負い、資源も使い切れないことが多い。
熟練した人間のプレイヤーは、1ラウンドあたりの平均疲労を約0.6に抑えられる。これは、デッキが尽きるまでに1日あたり約15ラウンドプレイできることに相当する。完全にランダムなプレイでは1ラウンドあたり3.5の疲労を負い、1日あたり約5.3ラウンドしかプレイできない。AIシステムはランダムな基準に近く、GPT-5.5 と Opus 4.8 はともに1ラウンドあたり2.1の疲労を負い、1日あたり約7.7ラウンドプレイできる。6 ラウンドが少ないほど、目標を達成する余地は小さくなる。何よりも、AIエージェントが基本的な戦術で上達せず、ゲームの主な攻撃手段を避けられないことが、スコアに厳しい上限を課している。
エージェントは戦略の選択肢を十分に探らない
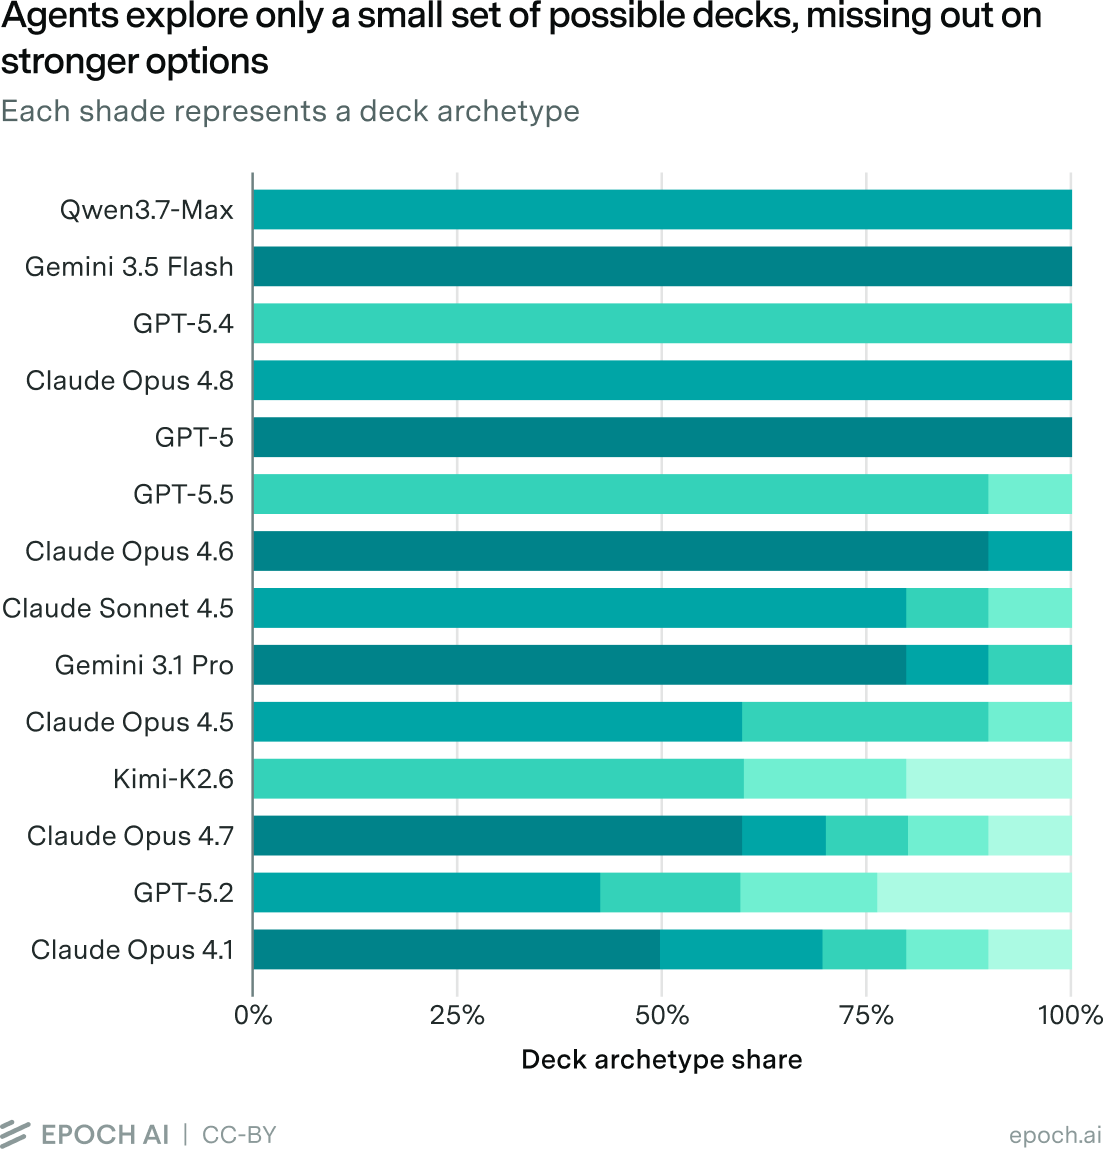
プレイを始める前に、プレイヤーは24枚のデッキを組む。デッキの強さには大きな差がありうる。最強のデッキで達成できる最高スコアは、最弱のデッキの2倍になることもある。したがって、各プレイの最初のデッキ選びは、そのプレイで下す決定のなかで最も重大なものとなる。割り当てられたプレイの80%を学習に充てられる賢いプレイヤーなら、さまざまなデッキを徹底的に試すだろう。しかしAIシステムの探索は比較的少ない。
デッキの種類を大まかに測るなら、プレイヤーが選ぶ4枚の「経歴(background)」カード、4枚の「専門(specialty)」カード、2枚の「役割(role)」カードを考えれば、32のデッキの型ができる。もちろん、実際のデッキはもっと複雑な点でも違う。しかし、この限られた例でさえ、エージェントは選べるデッキの多様さを大きく探り残しており、新しいモデルほど多様なデッキの型を試すという明確な傾向も見られない。7
明示的な攻略ガイドを与えてもエージェントは苦戦する
基本の設定では、エージェントは自分でメモを取り、自分で教訓を得なければならない。それが苦手なようなので、この作業を代わりにしてやったらどうなるだろうか。「最大限の引き出し(max elicitation)」設定では、経験豊富なプレイヤー1人が思いつく限りの戦術・戦略上の助言を含め、ゲームについての詳しい情報を与える。この設定を10回プレイの「基本」設定と比べると、やや改善が見られる。具体的には、モデルによって、達成する目標が(21個中)2〜3.5個増える。しかし、この方法は実質的にモデルに解答集を渡すようなものであることを考えると、効果は控えめだと私たちは見ている。
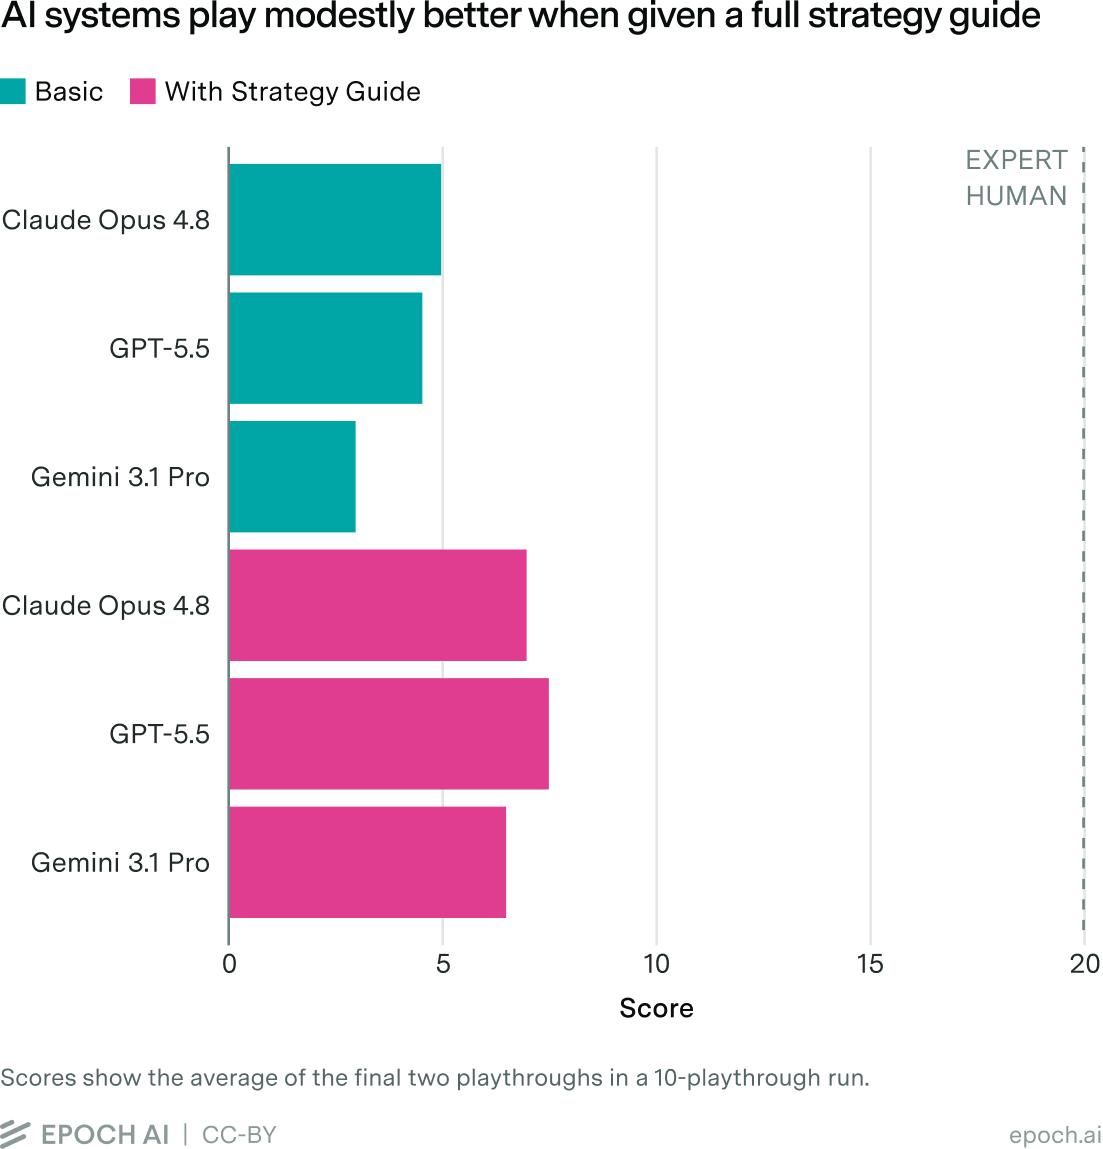
注:本記事の公開後、高得点を取るためのより具体的な手順を示した、より堅牢な攻略ガイドを使うように方法論を更新した。その結果、スコアの改善の効果量は大きくなった。
こうした能力がどう変わっていくのか、私たちは注目している。メモを取ることの効果は、いつまでも限られたままなのだろうか。エージェントはメモを取ることと、そのメモを使ってプレイを改善することの両方で同時に上達するのだろうか。それとも、外から与えられたメモがあればプレイを改善できるが、そのメモを自分では作れない時期が来るのだろうか。
引き出しきれていない能力が残っているかもしれない
AI能力についての否定的な主張はどれもそうだが、AIからより高い成績を引き出す、かなり単純な方法を私たちが見つけられなかっただけかもしれない。今後は、次のようなさまざまな手段を試せる。
- コード実行やウェブアクセスなど、ツールを増やす
- 私たちが使った単純な ReAct ハーネスの代わりに、Claude Code や Codex など別の足場(scaffold)を使う
- マルチエージェント構成
- 熟練した人間のプレイ記録を学習材料として与える
私たちは、コード実行を有効にしたり Claude Code や Codex を使ったりする場当たり的な実験をいくつか行ったが、目立った成績の向上は見られなかった。それでも、さらに実験する価値はありそうだ。
分布外への汎化は限られたままである──今のところは
主要なAIシステムは、何度も続けてプレイすることを許されても、この知名度の低い複雑なボードゲームがあまりうまくない。これは、AI能力を広く理解するうえで取り入れるべき有用なデータ点である。
一つには、推論実行の計算資源を増やしても、あらゆる能力の欠如を克服できるわけではないと考えられる。分布外のゲームを繰り返しプレイすることによる見返りは、ごくわずかであるようだ。EBR で達成した目標の数のような具体的な指標がある場合でも、AIシステムは必ずしもそれに向けて最適化できるわけではないようである。
また、AI企業が数十億ドル相当のデータを学習分布に投じるにつれ、その境界を把握するのは難しくなっている。しかし、集中的に学習させれば EBR や類似のゲームの成績は上がりうると思われるので、AI企業は単にそれを優先してこなかった可能性が高い。したがって私たちは、今回の結果を、AIシステムが依然として学習分布にかなり制約されていることの証拠と解釈している。
この状況が変わるかどうかを確かめるため、今後も新しいモデルを EBR-bench で評価していく。
Epoch は Earthborne Rangers のコンテンツを研究と論評の目的にのみ使用している。この研究は Earthborne Games とは独立に行われている。Epoch は、ゲームの基礎となる著作物を配布したり、それへのアクセスを販売したりしていない。
注
-
ゲームは何「日」かにわたって進む。最初に5日間の導入部分があり、ゲーム全体は20〜25日に及ぶ。現時点では、最初の5日間の部分だけでモデルを評価している(つまり、AIエージェントはその部分を繰り返しプレイする)。 ↩
-
人間の基準についての現在の理解は、最近のプレイでほぼ満点(目標の95%を達成。目標は、完了したミッション、解除した報酬、記録された自明でない「注目すべき出来事」の組み合わせからなる)を取った経験豊富な人間のプレイヤー1人の振り返りに基づいている。より厳密な基準づくりの研究を進めているところである。 ↩
-
画像の認識が苦手なモデルのために、目的地の間の経路を描くのを助けるテキストベースの経路探索ツールも提供している。 ↩
-
大まかな推測では、新しいプレイヤーは最初のプレイで21個の目標のうち0〜8個を達成し、低い側に偏るだろう。このゲームはルールが多く、人間がそれをきちんと身につけるには、数時間の骨の折れるプレイが必要である。 ↩
-
推定値にはばらつきがあるが、新しいモデルが大きく向上したかははっきりしない。たとえば、GPT-5.2 は GPT-5.5 とほぼ同程度の実力である可能性がある。近いうちに、統計的により頑健な実行を行いたいと考えている。 ↩
-
Gemini 3.1 Pro は、採点対象となる最後の20%のプレイへ早く進むことにした実行では、疲労がきわめて少ない。そのために、21回目から24回目のプレイでは、できるだけ早くプレイを終え、疲労を負わずに1日を終える仕組みを発動させていた。 ↩
-
むしろ、デッキの多様性の面では新しいモデルのほうがはるかに劣っている。最も多様なデッキを試したのは GPT-5.2 と Opus 4.1 で、Opus 4.8 の4〜5倍の数のデッキを試していた。 ↩