
レポート
時間の区切り方に依存しないラプラスの法則
原題:A time-invariant version of Laplace’s rule
明日、太陽が昇る確率はどれくらいか。来年パンデミックが起きる確率はどれくらいか。これまでに一度しか成功していない新しい手術を受けて、生き延びる見込みはどれくらいか。
こうした問いの多くには、ある一般的な法則を使って答えることができる。ラプラスの継起の法則である。この法則は、過去の成功についての情報が与えられたときに、好ましい結果が得られる確率を表す。用途が広く一般的であることから、この法則は予測者にとってかけがえのない道具になっており、ベースレート(基準率)の推定に使われている1。
ラプラスの法則は簡単に述べられる。ある実験を 回繰り返し、 回の成功を観測したなら、次の試行で成功する事後確率は と推定できる。
しかし、ある期間にわたる観測にこの法則を当てはめようとすると、致命的な問題が生じる。何をもって1回の試行とするかの定義がはっきりしないからである。たとえば、来年パンデミックが起きる確率を推定したいとしよう。 は、過去のパンデミックのデータセットがカバーする年数とすべきだろうか。それとも日数とすべきだろうか。本質的に恣意的なこの選択によって、問いへの答えが変わってしまう2。
この問題に取り組んだ末に、私たちが最終的に推奨するのは単純な公式である。要するに、 年の期間についてのデータがあり、その期間に 回の成功を観測したなら、次の 年間に1回も成功が起きない確率は である。私たちはこの公式を時間不変なラプラスの法則と呼ぶ。
観測期間 を、記録に残る最初の成功からの経過時間に等しくとった場合は、成功の数から1を引き、確率は代わりに とすべきである。この場合、サンプリング期間には必ず少なくとも1回の成功が含まれると最初から分かっているので、最初の成功は、事前分布を更新するための新しい情報を何ももたらさないからである。
期間 T に観測された成功の数 S | 期間 t に成功が1回も起きない確率 |
|
|
| サンプリング期間が可変の場合は サンプリング期間が固定の場合は |
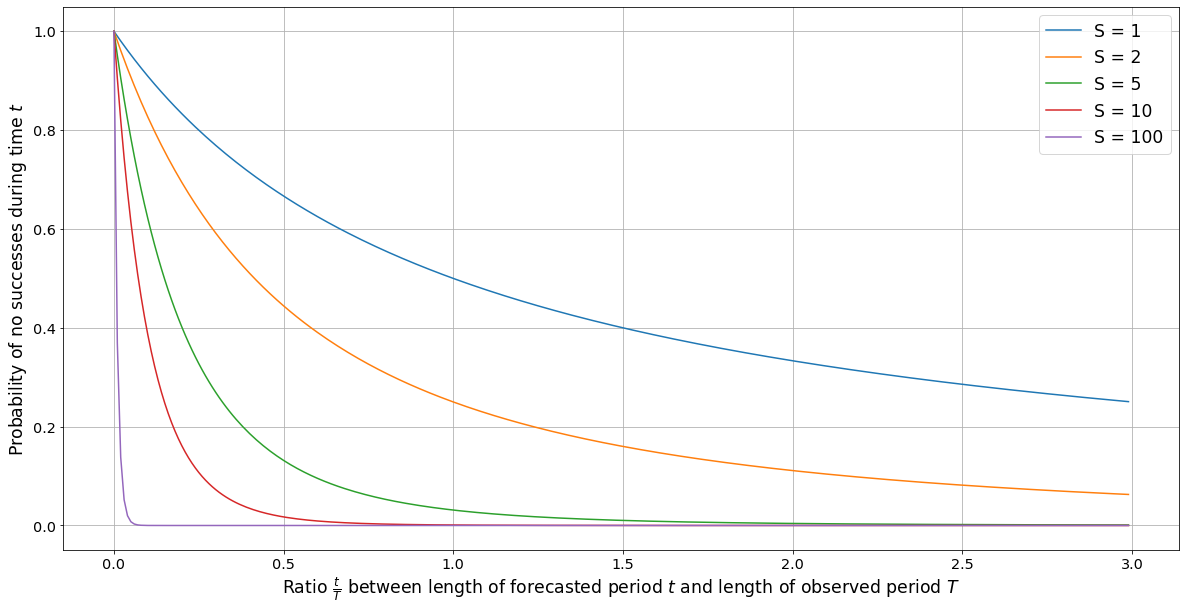
公式 \((1+\frac{t}{T})^{-S}\) の値を、\(S\) のさまざまな値について示したグラフ
重要な注意として、この法則はあくまでラプラスの法則の代わりとして推奨するものであり、ラプラスの法則と同じ問題のほとんどを抱えている。仮想的な成功を1回仮定するせいでラプラスの法則が強気すぎる場合には、同じ理由で、私たちの時間不変な法則も強気すぎることになる。この問題は、更新の根拠となる証拠が少ないほど顕著になる。したがって、事前の知識からは成功までの時間が長いはずだと考えられるのに、これまでの観測期間が短い場合には、この法則の成績が特に悪くなると予想すべきである。
そうした場合、より慎重な分析では、たとえばこちらの記事で概説されているように、その情報を事前分布に組み込もうとするだろう。実際には、そうした情報を考慮に入れる方法のほうが優れている。しかしそれは無情報事前分布の領域から半情報事前分布の領域へと踏み込むことになり、この話題は本稿の範囲を超える。
本稿の構成は次のとおりである。まず、ラプラスの継起の法則とその使い方をおさらいする。次に、例を通して時間についての一貫性の問題を明らかにする。続いて、それをどう解決するかを説明し、時間不変なラプラスの法則を導出する。さらに、時間不変なラプラスの法則の使い方を例で示す。最後に、予測者への推奨をまとめる。
本稿を読むには、ラプラスの継起の法則を知っていることが望ましい。ラプラスの法則に初めて触れる方には、詳しく知るために Ege Erdil による以前の記事を勧める。
おさらい:ラプラスの継起の法則
ラプラスの継起の法則によれば、T 回の試行で S 回の成功を観測したなら、次の試行で成功する確率は と推定すべきである。
これは、試行1回あたりの成功確率についての一様な事前分布 から出発し、ベイズ更新を行い、その結果の期待値をとることで導かれる。ここでは導出の詳細には立ち入らないが、関心のある読者にはこちらの記事を勧める。
ラプラスの継起の法則は、実際の成功と失敗の数に、仮想的な成功を1回と仮想的な失敗を1回加えるものと解釈されることが多い。これにより、これまでに起きたことのない出来事の確率を にしてしまうことが防がれる。
ラプラスの継起の法則を繰り返し当てはめれば、次の 回の試行で1回も成功が起きない確率を推定できる。
この連鎖を展開する際には、それまでの失敗にもとづく更新を考慮に入れている。成功が一度も見られないまま時間が経つほど、成功はますます起こりにくくなる。
時間の問題
ラプラスの法則の問題は、何をもって1回の試行とするかの明確な定義がない問題に当てはめようとすると明らかになる。そうした問題では、試行の代わりに、ある期間にわたって集めた成功の観測がある。
地震の起こりやすさを調べているとしよう。Exampletopia 地方の地震計を10年間観測してきたが、これまで地震は観測されていない。Exampletopia の建築家組合は、この幸運が次の10年も続くかどうかを知りたがっている。
地震学者長の Ada は即座に答える。10年間に地震は1回も見られなかった。したがってラプラスの法則により、次の10年に地震が起きない確率は である。
地震学者補の Byron は、答えるのにもう少し時間をかける。10年は 個の年からなる。したがって、上の推論によれば、次の10年間に地震が起きない確率は次のようになる。
地震学者たちの結果が食い違っている!
しかも、ありうる結果はこの二つだけではない。10年分の観測を 個の期間に分けていたら、地震が起きない確率は次のようになっていたはずである。
この結果はばかげている。確率は、観測をどれだけ細かく分けるかに左右されるべきではない。明らかに、この状況ではラプラスの法則を素朴に当てはめることはできない。では、代わりにどうすればよいのだろうか。
事前分布の問題
地震学者たちの結果が食い違うのは、地震の確率について異なる事前分布から出発しているからである。
思い出してほしいが、ラプラスの法則は、各試行で関心のある出来事が起きる事前確率に一様分布を仮定して導かれる。
Ada は各試行を10年と定義しているので、10年間(1回の試行)に地震が起きない確率についての彼女の事前確率(観測を考慮に入れる前のもの)は である。
これに対して Byron は、試行の単位を年としている。彼の視点から見ると、10年間に地震が起きない事前確率は である。
結果が違うのも無理はない。異なる仮定から出発すれば、異なる結果が得られるのは当然である。
ここから、問題を解決するために何をすればよいかも見えてくる。時間をどれだけ細かく分けても、どの時間単位に対しても地震が起きない確率が同じになるような(非正則な)事前分布を選ぶ手順がほしいのである。
ただしその前に、視点を離散から連続へと移す必要がある。
連続的な改善
ここまでは、ラプラスの法則を離散的な設定で考えてきた。 回の離散的な試行があり、そのうち 回が成功に終わる。
代わりに、この過程の極限をとりたい。関心のある過程を、長さ の連続的な時間区間にわたって観測する。そして、その間に 回の成功を観測する。
ある時間区間に起きる出来事の数をモデル化する自然な方法は、ポアソン分布である。ポアソン分布は率パラメータ によってパラメータ化される。これは、単位時間あたりに観測されると予想される出来事の平均の数を表す。
区間を 単位時間にわたって観測しているので、これまでに見た観測の数を としてモデル化する。
この連続的な設定は、離散的な設定でのあらゆるステップの長さを包含している。1日、1か月、1年のうちに成功が起きたかどうかを示す二値変数を定義すれば、離散的な設定を復元できる。したがって、連続的な設定に切り替えても柔軟性は何も失われない3。
そして予測する際には、変数 を変えることで、任意の長さの期間に所定の数の成功が観測される確率を推定できる。ただしその前に、 の事前分布を決め、手元の観測にもとづいてそれを更新する必要がある。
スケール不変な事前分布
ベイズ推論を行いたいのだから、 について何らかの事前分布を選ばなければならない。この選択はどのように行えばよいのだろうか。
さしあたり、到着率 について分かっている事実は、それが到着率であり、0に限りなく近いことはありうるが0より厳密に大きいということだけだとしよう。到着率なので、時間の逆数の単位、つまり周波数の単位で測られることが分かっている。そこで、 についてまったく何も分からない状態で求めるのにとりわけ自然な条件は、それに割り当てる事前分布 が、時間の単位を変えても変わらないことである。
形式的に言えば、先に単位を変えてから を使って事前分布を得た場合と、先に を使ってから単位を変えた場合とで、同じ答えが得られてほしい。つまり、二つの操作が可換であってほしい。
この条件が成り立てば、上でラプラスの法則に生じたような問題は起きない。元の区間を最終的にどう分けようと、 について常に同じ事前分布が得られ、それをベイズ更新すれば常に同じ事後分布にたどり着く。測る単位は異なるが、それは計算するどの確率にも影響しない。
どのような ならこの条件が成り立つかを見つけよう。考える二つの時間の単位が、スケーリング定数 で関係づけられているとする。すると単位の変更は置換 に相当する。添字は、右辺が「新しい周波数単位」で測られていることを表す。先に事前分布を得てから単位を変えると、確率測度として が得られる。一方、先に単位を変えてから事前分布を計算すると、単に が得られる。これらが等しくなるには、 がすべての について成り立たなければならず、これは を意味する。4
スケール不変な事前分布 には問題がある。正の実数全体での積分が無限大になるのである。そのため、正の実数上の正当な測度を定めてはいるものの、この測度は確率測度ではない。本物の確率分布なら全確率質量は1でなければならないが、この測度は、有限の定数で割ってそうなるよう正規化することができない。つまり、これは非正則事前分布である。
非正則事前分布は正規化できないが、それでもベイズの定理を使うことはできる。場合によっては、何度かベイズ更新を行った後の事後分布で、正規化できない原因となっている発散が消えることがある。今回の場合、それは の積分、つまり自然対数が でもつ厄介な発散である。直観的には、到着率をどの単位で測っているか分からないので、それは「非常に小さい」こともありうるし「非常に大きい」こともありうる、ということである。手元の証拠が両方の可能性を排除しないかぎり、スケール不変な事前分布からは何の答えも得られない。
スケール不変な事前分布による推論
幸い、スケール不変な事前分布は、ポアソン尤度の共役族に属する。具体的には、形状パラメータ 、逆スケールパラメータ のガンマ分布として表せる。
このため、 の分布を、観測された成功の数 と観測した時間の長さ にもとづいて更新するのは簡単である。事後分布は となる。
すると、次の 単位時間に起きる成功の数は、率 のポアソン分布に従う。したがって、この期間に成功が1回も観測されない確率は次のようになる。5
まとめると、 回の成功を期間 に観測したとき、さらに時間 t のあいだに成功が1回も起きない確率は と推定することを推奨する 6。
前例のない成功
観測された成功の数が0の場合、上で示した公式はもう機能しない。 というばかげた結果になってしまう。
これは、 の事後分布が となり、その確率密度関数が となるからである。この分布は依然として積分可能ではなく、そのためにばかげた結果になる。
この状況に対しては、妥当な代替案を二つ導いた。一つは、時間を 個の部分に分けたときの、ラプラスの法則による推定値の極限をとることである。もう一つは、ソロモノフ帰納法の弱いバージョンを当てはめることである。これらの方法は、それぞれ付録AとBで導いている。
どちらの代替案も同じ推奨にたどり着く。時間 のあいだ観測してきたなら、さらに時間 のあいだに成功が1回も見られない確率は である。
この結果は、先に導いた公式と驚くほどよく似た形をしている。前節で述べたように、事前分布を積分可能にするために仮想的な成功を1回加えたものと解釈できる。これは、標準的な形のラプラスの法則で仮想的な成功と仮想的な失敗が1回ずつ導入されるのと呼応している7。
この公式は二つの異なる方法で導けた。しかも、スケール不変な事前分布から出発する導出と構造的に似ている。そのため、成功の数がちょうど0の場合には、この公式を推奨することに迷いはない。
しかし、この解決策は不整合をもたらす。 の場合と の場合とで、公式が同じ結果を与えてしまうのである。両方の場合で方法の一貫性を保つため、すべての場合に仮想的な成功を加えることを推奨する。そうすると、この法則を使った予測は強気になるが、通常のラプラスの法則より強気になることはない。
重要な注意点として強調しておきたいのは、上で述べたように、何らかの形で「仮想的な成功」を仮定することで、低い到着率を人為的に起こりにくくしてこの結果を得ているということである。つまり、成功までに長い時間がかかりそうだと考える十分な事前の理由がある状況では、この法則はあまり役に立たない。観測期間が十分に長くなり、そこから得られる証拠の強さが事前分布を圧倒するほどになれば、これは問題にならず、この法則を安心して使える。
観測期間が可変の場合の調整
予測でよくあるのは、最初の成功についての情報はあるが、それ以前に成功がありえたかどうかについては情報がない、という状況である。たとえば、世界人口の3%超が死亡するパンデミックのベースレートを知りたいとしよう。Wikipedia の疫病の一覧には、そうしたパンデミックが三つ挙がっており、最も古いものは2世紀のアントニヌスの疫病である。そうしたパンデミックがあったかどうかを判断できるほど十分なデータがどの期間についてあるのかが分からなければ、最善の策は、最も古い観測から観測期間を始めることである。
この場合、最初の成功はサンプリング期間に数えるべきではない。最初の成功が必ず含まれると分かっている場合、それは尤度に何の項も寄与しないからである。データのサンプリングの仕方によって、サンプリング期間は必ず成功から始まることが保証されているので、成功が存在することは、成功がありうるということ以上の情報を何ももたらさない。確率1の出来事は情報をもたないので、それが起きたことにもとづいてベイズ更新を行うことはできない。サンプリング期間が構成上その始まりで成功に固定されている場合に最初の成功を無視するのは、このためである 8 9。
まとめると、期間 T をちょうど S 回の成功を含むように調整した場合は、時間 のあいだに成功が1回も起きない確率を と推定することを推奨する。ここでも、 のときに適切にふるまうよう、仮想的な成功を1回含めている。
まとめ
ここまでで、時間不変性の問題を解決するための実用的な提案と、それを当てはめる際に考慮すべき二つの落とし穴を示した。
推奨は表にまとめられる。
期間 T に観測された成功の数 S | 期間 t に成功が1回も起きない確率 |
|
|
| サンプリング期間が可変の場合は サンプリング期間が固定の場合は |
念のため繰り返すと、サンプリング期間が可変であるのは、データ中の最初の成功を含むように観測期間 を意図的に選んだ場合であり、その場合に限る。
推奨を実際に使ってみよう。
例:チリの地震
この10年のうちに、つまり2030年の初めまでに、チリでマグニチュード の地震が起きる確率を予測したいとしよう。
まず、そうした地震のうち最後のものの日付だけが分かっていて、それ以外は何も分からないとしよう。Wikipedia によれば、そうした地震の最後は2015年9月だった。簡単のため、これをちょうど7年前としよう。現在から2030年の初めまでの残り時間はおよそ7.5年なので、時間が可変で成功が1回の場合の公式を当てはめると、確率は次のようになる。
次に、基準を満たす直近3回の地震の日付が分かっていて、スケール不変な事前分布による方法を使いたいとしよう。日付は次のとおりである。
- 2015年9月
- 2014年4月
- 2010年2月
もちろん、上の法則をそのまま使って答えを出すこともできるが、ここでは法則が実際にどこから来るのかを示すため、第一原理からこの例を解いてみる。
地震がポアソン過程に従うなら、時間の間隔を見ることで、所定の到着率 に対する尤度を計算できる。10 ここでも簡単のため、時間の間隔はすべて最も近い整数年に丸める。すると次のようになる。
各因子は、それぞれ (2)〜(3) の間隔、(1)〜(2) の間隔、(1) から今日までの間隔に対応する。したがって、スケール不変な事前分布 をベイズ更新すると、事後分布は次のようになる。
ここで、次の7.5年間にそうした地震が起きない確率を計算したければ、次の式が得られる。
ここで分母は、 で定まる全体の確率密度を、積分が実際に1になるよう正規化している。分子は、確率密度を尤度 に対して積分している。これは、 の値を条件として、7.5年間にもう地震が観測されない尤度である。言い換えれば、この式は、 をその事後分布を使って周辺化している。
一般に、次の結果が成り立つ。
ただし である。これを上の式に代入すると、最終的な答えが得られる。
これはそうした地震が起きない確率であり、起きる確率は である。
月単位の時間スケールでラプラスの法則を使っていたら、月ごとの成功確率の事後分布は となり、
が、次の7.5年間、つまり2030年の初めまでに地震が1回も見られない確率になっていた。これは、スケール不変な事前分布によるより控えめな37.8%よりかなり小さい。違いが生じるのは、ラプラスの事前分布と異なり、スケール不変な事前分布が小さな到着率に多くの確率質量を置いており、ここではまだ証拠が十分に強くないため、尤度がそれを上回らないからである。
最後に、ずっと大きなデータセットをとり、証拠が多い場合に食い違いがどうなるかを見てみよう。チリで記録されたマグニチュード8以上の地震のうち、直近から数えて14回目のものは1906年に起きた。したがって、スケール不変な事前分布によれば、2030年の初めまでにそうした地震がもう起きない確率は
であり、起きる確率は55.6%である。一方、上と同じようにラプラスの法則を年単位の時間スケールで形式的に当てはめると、次のようになる。
この場合、ほとんどの予測の法則が似た答えを出すだろう11。それでも、その分野に固有の理由からふさわしい事前分布ではないと疑う理由がないかぎり、私たちはスケール不変な事前分布を使うことを推奨する。たいていの場合、ラプラスの法則を使うよりも優れており、計算の手間もわずかに増えるだけである。
結論
ラプラスの法則は、予測の際にベースレートを推定するための欠かせない道具である。
本稿では、 回の成功を連続的な期間 にわたって観測する場合へと、この法則をどう拡張できるかを説明した。
をいくつかの試行に分けるという素朴な方法は、望むようにはふるまわない。しかし、さらに時間 のあいだに成功が1回も起きない確率は と推定できる。
この公式は、観測を率 のポアソン過程の結果としてモデル化することで導かれる。この率は、スケール不変な事前分布 をもつと仮定する。
この方法の二つの落とし穴を回避する方法も説明した。成功の数が のときは、成功の数に仮想的な成功を1回加えることを推奨する。また、期間 をちょうど直近 回の成功を含むように選んだときは、成功の数から1を引くことを推奨する。
観測された成功の数 (期間 中) | 期間 に成功が1回も起きない確率 |
|
|
| サンプリング期間が可変の場合は サンプリング期間が固定の場合は |
三つの注意点を挙げておく。
- 成功の数が増えるにつれて、時間不変な法則とラプラスの法則の素朴な適用との差は小さくなる。目安として、 なら結果は同程度になるはずである。
- 観測期間が短い の場合、 となる。観測期間が予測する期間よりはるかに短い場合、すなわち の場合には、この法則は適切ではない。
- この法則は、追加の情報を何も考慮しない場合に当てはまる。より精密な分析のためには、背景情報を使って、更新の出発点となるより良い事前分布を選ぶことを推奨する。Tom Davidson がこの方法をこちらで論じている。
私たちが提案する法則を機械的に当てはめても、慎重な分析と予測の経験の代わりにはならない。それでも私たちは、これを有用で十分な根拠のある経験則として推す。
謝辞
議論に参加してくれた Eric Neyman、Jonas Moss、Tom Davidson、Misha Yagudin、Ryan Beck、Nuño Sempere、Tamay Besiroglu に感謝する。
Anson Ho は、ラプラスの法則が時間について一貫しないことに私(Jaime)の注意を向けてくれた。本稿は彼の研究に着想を得ている。
Eric Neyman は、時間をより細かく分けたときのラプラスの法則の極限をとるというアイデアを提案してくれた。このアイデアは付録Aで展開する。
付録A:極限をとる
このアイデアは Eric Neyman によるものである
ラプラスの法則を当てはめる時間スケールを選ぶことの恣意性は、代わりに極限をとることで克服できる。
次の設定で考える。世界には (失敗)と (成功)の二つの状態があり、これまで状態 に、 に等しい時間だけとどまってきた。一般性を失うことなく、 となるように時間の単位を選べる。理想的には、 についての確率分布を記述したい。ここで は、追加の時間( で表す)、つまり初めて状態 に移るまでにかかる時間の量である。 が 以上であることは分かっている点に注意してほしい。この分布を、その生存関数 によって特徴づける。生存関数 は と定義されることを思い出してほしい。
そのために、最初の時間区間を 個に分ける。同じことだが、時間を幅 のメッシュで分割する。ラプラスの法則を使うなら、事前分布 を、単位時間あたりの遷移 の確率に置いて出発し、事後分布 にたどり着く。すると、追加の時間 のあいだに成功が1回も観測されない確率は次のようになる。
成功が起きない確率 を事後分布について積分しているからである。ベータ関数をガンマ関数で表して整理すると、次が得られる。
ここで、 の極限、つまり最初の区間の分割を無限に細かくした極限をとる。すると最終的な結果が得られる。
ただし である。したがって、この正則化の方法は、恣意的な時間スケールを導入することなく、次の成功の到着時間について明確に定義された確率分布を与える。
付録B:ソロモノフ帰納法
この設定にソロモノフ帰納法を当てはめるのは、主に、観測が離散的なビットとして得られるわけではないために難しい。しかし、離散化の方法でこの問題を補い、そのうえで極限をとることができる。
ここでは、ソロモノフ帰納法のごく弱く制限されたバージョンを使う。 を ステップのあいだ出力し、その後はずっと を出力するプログラムだけに注目するのである。したがって、プログラムは の値そのものを2進数で表したものによって直接符号化される。最終的には が出力されることが分かっていると仮定する。この仮定は、すべての継起の法則も置いているものである。この仮定を置かないと、観測した0の数が無限大に近づくにつれて、ソロモノフ帰納法は常に を出力するプログラムにますます大きな重みを与えることになる。
これらのプログラムの標準的な接頭符号による符号化は、事前分布 に相当する。これは、 個の0を出力してから1を出力しはじめるプログラムに対する事前確率である。 個の0を観測したとすると、さらに少なくとも 個の0を観測する確率はおおよそ次のようになる。
とすると、離散的な和を積分で置き換えたことによる近似誤差は0に近づくので、これは厳密な答えになる。言い換えれば、成功がありうることが分かっているなら、ソロモノフ帰納法の素朴な近似は、付録Aで示したラプラスの法則の正則化と同じ答えを与える。
一方、それ以上の情報がなければ、成功が実際にありうる確率がどれくらいかをここから読み取ることはできない。失敗と成功を生み出しているものについてそれ以上の情報がなければ、0でない有限の時間区間はすべて、私たちの視点からは同等だからである。ソロモノフ帰納法は、ビット列を明示的に扱うことでこの対称性を破る。この場合、それまでに見たビットの数によって明らかなスケールが導入されるが、離散的な設定ではなく連続的な設定にいる場合には、そうしたスケールは伴わない。
付録C:先行研究
ラプラスの法則の設定で時間不変性の問題に取り組んだのは、私たちが初めてではない。ここでは二つの代替案を取り上げる。半情報事前分布と、自然な単位を使う方法である。
Tom Davidson は Semi-informative priors over AI timelines(AI のタイムラインについての半情報事前分布)のなかで、時間不変性をどう解決するかを考えている。彼は、成功確率の事前分布として、最初の1年間に所定の成功確率を与えるようなベータ分布を選び、仮想的な成功の数を1とすることを選んでいる。
彼の方法は、過去の参照クラスについての情報を使って、この最初の試行の確率がどうあるべきかを選ぶことに依拠している。
仮想的な成功の数の選び方は、根拠がそれほどしっかりしていない。Tom は、最初の試行の確率が小さいかぎり、仮想的な成功の数をいろいろに選んでも似た結果になると論じている。彼は記事のなかで、便宜上、おおむね仮想的な成功の数を1として扱っている。
Tom は、ラプラスの法則について自身の考えの要点をまとめた別の記事をこちらに書いている。
Jonas Moss は、事前分布を選ぶために時間の単位のあいだをどう移るかを説明している。
一般に彼は、自然な単位が M(たとえば日)だと考えるが、時間スケール M’(たとえば時間)で扱いたい場合、M’ の時間スケールに対する事前分布は π~B(1,1) について π’ = πM’/M とすべきだと提案している。その結果、π’ ~ B(M’/M,1) という事前分布が導かれる。
もちろん、この方法全体が、一様分布を課す単位を選ぶことに依拠している。
どちらの方法も妥当ではあるが、込み入った選択に依拠している。特に半情報事前分布による方法は、参照クラスからの背景情報が利用できる場合には手堅い選択だと私たちは考える(ただし、仮想的な成功の数の選び方については、より厳密な扱いを見たいところである)。
それでも、本稿で提案するようなより機械的な方法には、これらの方法に比べていくつかの利点があると私たちは考える。主な利点は、込み入った選択にかかりきりにならずに、すばやく推定値を出せることである。
using the memorylessness of a Poisson process. As the arrival time is always exponentially distributed conditional on the arrival time , we can substitute out all these conditional probabilities using the probability density and the cumulative distribution function of an exponential distribution with arrival rate .注
-
たとえば、Samotsvety によるこの予測を参照してほしい。そこでは、ロシアと NATO のあいだで核兵器の応酬が起きる確率の推定に、ラプラスの継起の法則が使われている。 ↩
-
一つの区間に2回以上の成功が含まれる場合の問題は除く。ただし、そうしたことが起きないほど時間を細かく分ければ、これらの問題は解決できる。 ↩
-
これは他の方法、たとえば次元解析を使っても容易に分かる。これらの方法になじみのない人でも議論を追えるよう、ここではこの計算を明示的に書いた。 ↩
-
この導出を詳しく述べると、次の積分から始める。
と置換すると、次が得られる。
そして、この積分はガンマ関数の定義により1に等しい。 を計算しているのと同じだからである。したがって、最終的な答えは次のようになる。
-
のとき となることに注意してほしい。これは、観測期間が予測の対象期間に比べて非常に短い場合には、この公式が適切でないことを示唆している。 ↩
-
さらに的を射た話として、標準的なラプラスの法則でも、非正則で、おそらく情報量のより少ない事前分布 から出発することを選べたはずである。
しかしその場合、 回の試行を観測して成功が 回なら、事後分布は となり、これは正則ではない。
これは、時間不変な場合に結果を適切に積分できるよう仮想的な成功を導入する必要があったことと、不気味なほどよく似ている。 ↩
-
これは通常のラプラスの法則にも当てはまることに注意してほしい。 ↩
-
ここで、直近の成功からの距離にもとづいて人間原理的な更新を行うべきかどうかについては、いくつか注意点がある。実際には、この形式化で成功を1回追加で仮定することは、観測者がどの時点でも等しい確率で観測を行うという仮定のもとで人間原理的な更新を行うのと同じ効果をもつ。したがって、そうした更新が必要だと考えるなら、それを行うのは難しくない。 ↩
-
これは、 回の出来事を時刻 に、固定した時間区間 のなかで見た場合、尤度 を次のように分解して計算できるからである。 ↩
-
ラプラスの法則から得られる答えは、年間の成功確率 の事後分布が期待値 に集中したディラックのデルタ分布だと仮定し、それを直接使って 年間に成功が起きない確率を と導くことでも近似できた。 の事後分布は確率質量のほとんどを最大値の周りの狭い領域に置いているので、上とほぼ同じ答えになる。 ↩