
お知らせ
より体系的で透明性の高いAIベンチマークハブ
原題:A more systematic and transparent AI benchmarking hub
はじめに
昨年11月、私たちはEpoch AIベンチマークハブ(Benchmarking Hub)を公開した。このプラットフォームでは、Epoch AIが注目すべきAIモデルについて行った評価の結果を、可視化や追加の分析とともに掲載している。その目的は、今日のAIシステムに何ができるのか、そしてこれからどこへ向かうのかを明らかにすることである。プラットフォームのデータは制約の少ないライセンスのもとで公開されており、研究コミュニティのほかのメンバーが自分たちの分析に使うことができる。
今日、ベンチマークハブの大幅な更新を公開する。可視化の見た目は以前とほとんど変わらないが、AIのベンチマークを実行して結果を共有する手順は全面的に刷新した。基盤に大きな技術的投資を行い、より透明で、体系的で、最新の状態を保てるようにした。
利用者にとって最も目につく変化は次のとおりである。
- 各評価と、評価対象のモデルについて、より豊富なデータを見られるようになった。
- データベースの更新頻度が大幅に上がる。
AIベンチマークハブの主な特徴
私たちのデータベースは、次の特徴によって、AIのベンチマーク性能について公開されているデータの空白を埋めている。
透明性。ベンチマークの平均スコアだけでなく、各問題のプロンプト、AIの回答、スコアの包括的な記録も保存している。この情報は、Inspectライブラリが提供する対話型のログビューアーで表示する。たとえば、GPQA DiamondでのDeepSeek R1の結果はこちらで見られる。
さらに、評価の実行と採点に使ったコードも共有している。現時点では、細かな違いがありうる静的なGitHub gistを共有するという近似的な方法をとっている。内部的には、各評価を実行時の正確なgitリビジョンに結びつけることで、完全な監査可能性を確保している。これも近く公開する予定である。
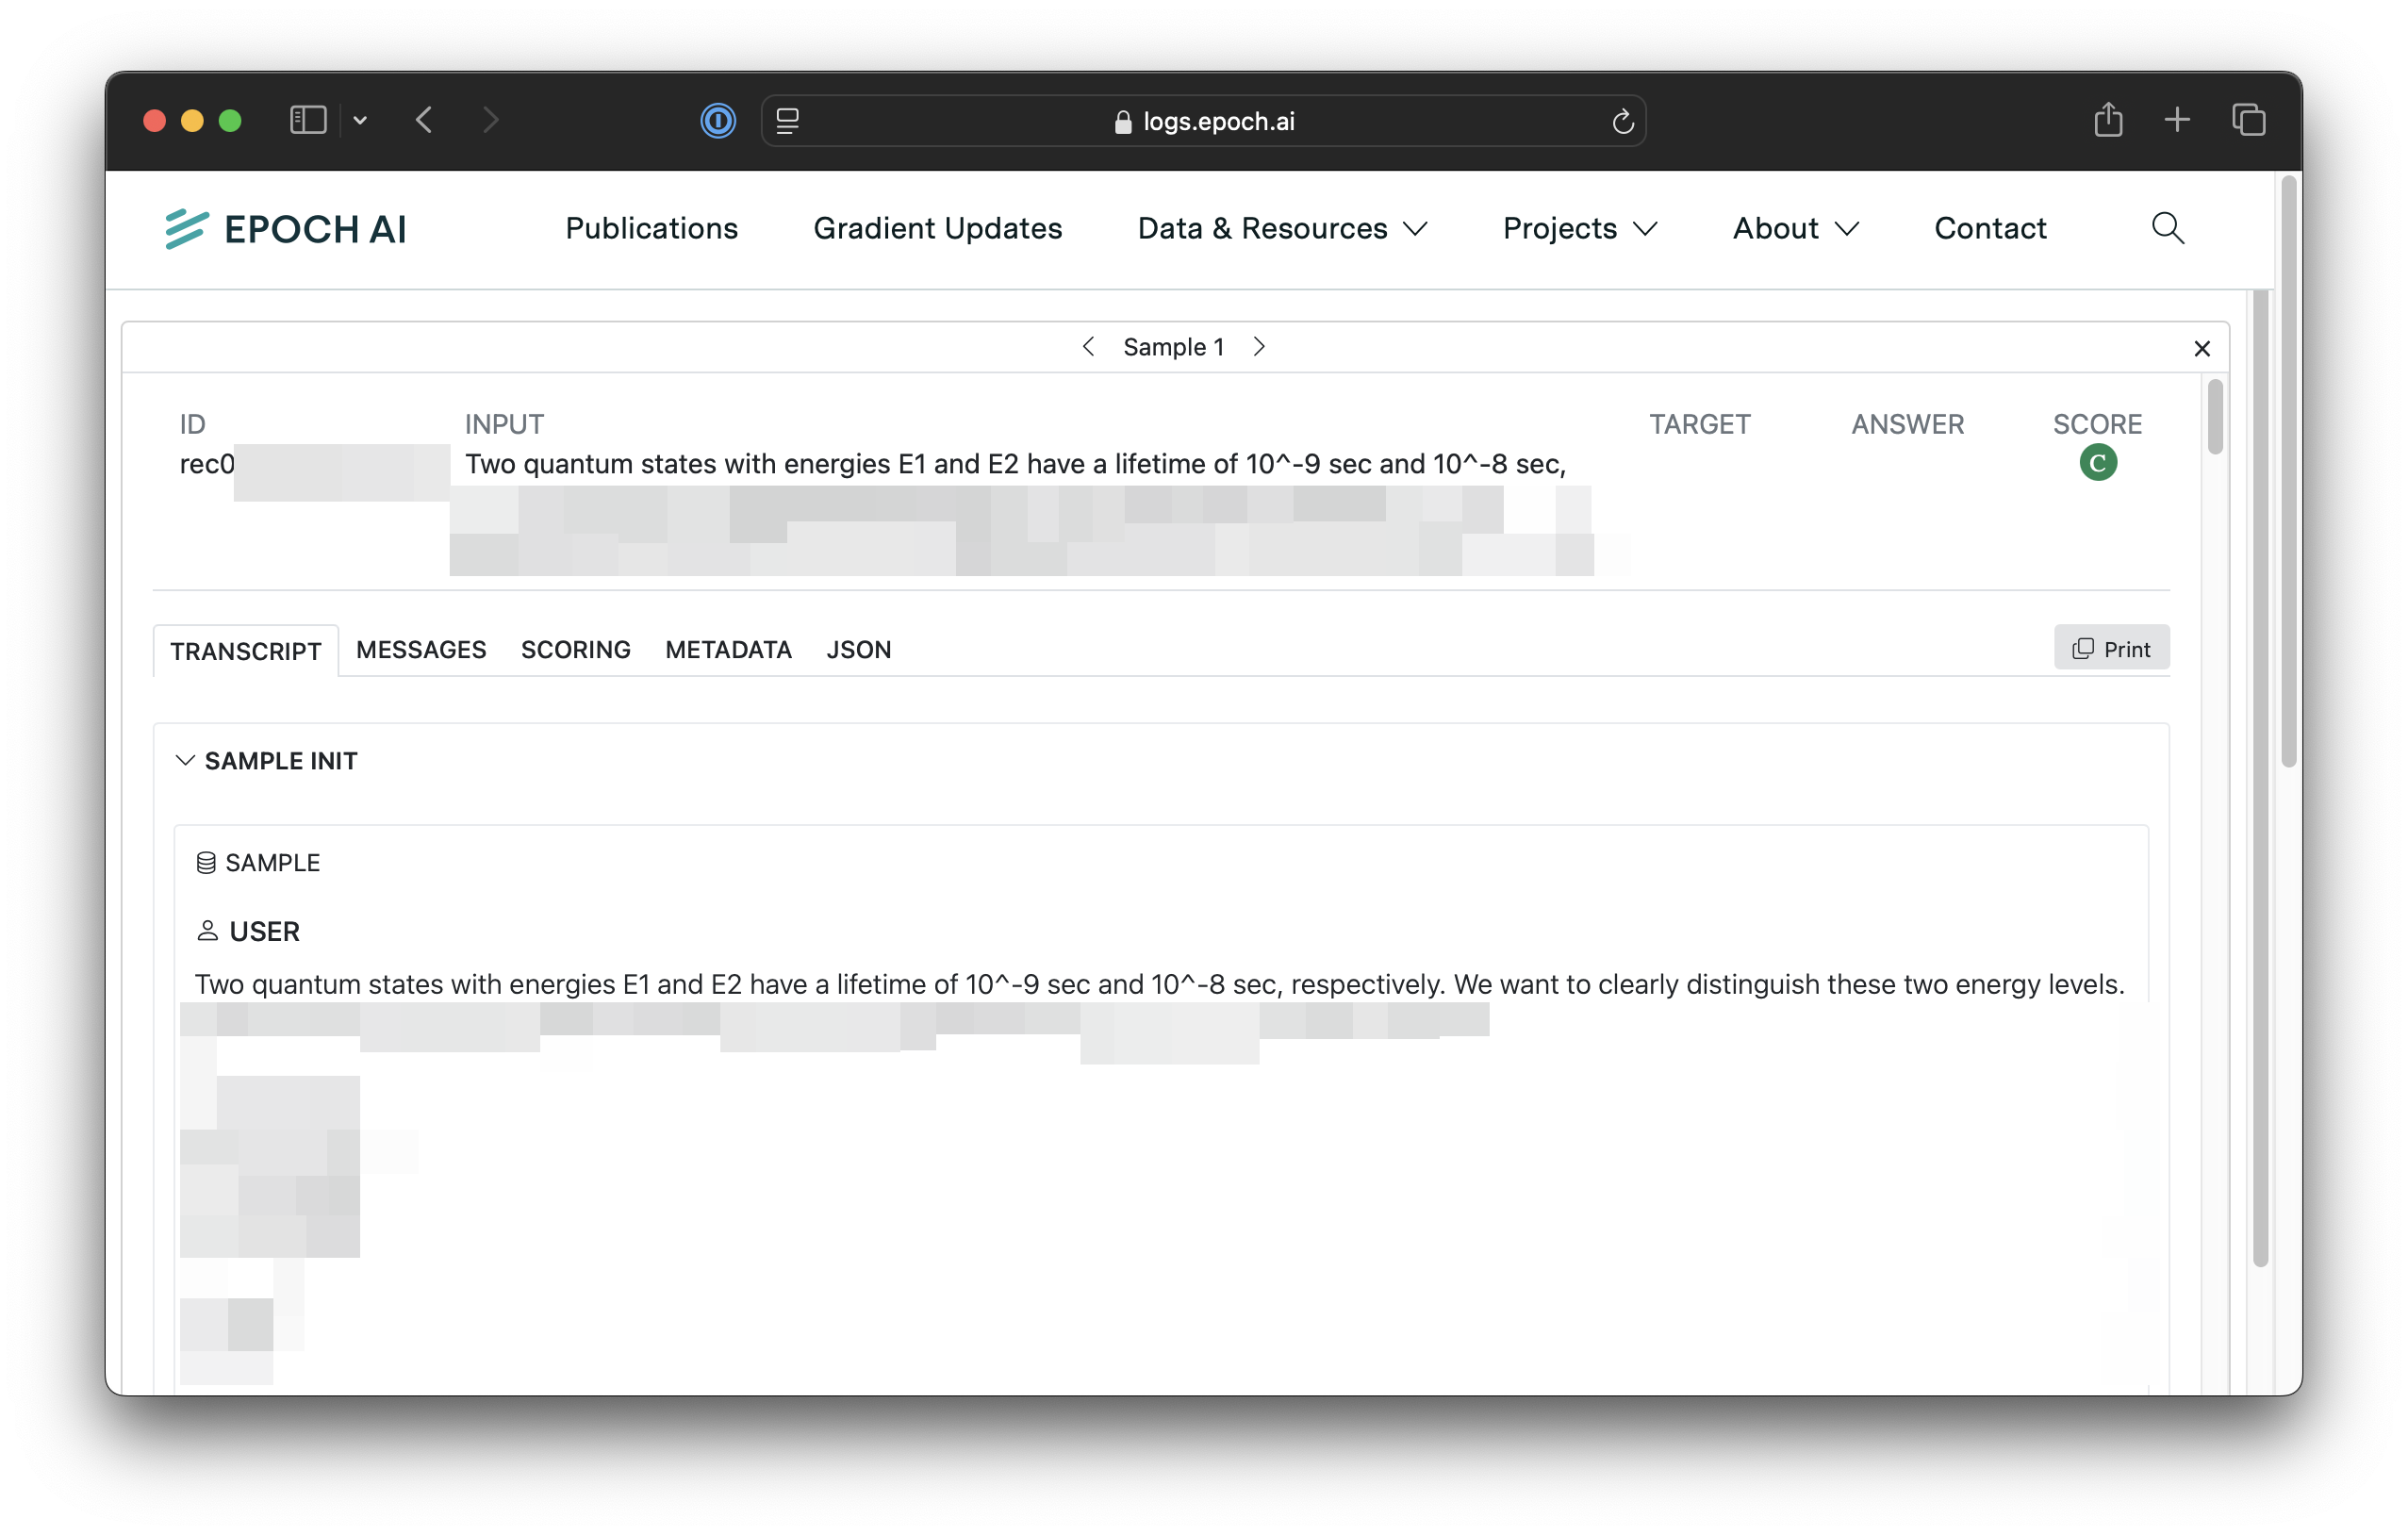
GPQA DiamondでのDeepSeek R1の評価から一つのサンプルを表示したInspectのログビューアー。LLMの学習用コーパスに誤って流出するリスクを抑えるため、ボットはログビューアーにアクセスできないようにしている。そのため、アクセスするにはCAPTCHAを解く必要がある。
体系性。少数の最新モデルだけでなく、幅広いモデルでベンチマークを実行している。これにより、AIの能力の大まかな傾向を調べることができる。最新のモデルも古いモデルも、小さなモデルも大きなモデルも対象としている。オープンなモデルと独占的なモデルの両方を追跡している。
最新性。ベンチマークのデータベースやリーダーボードの中には、更新がまれなものや、もう保守されていないものもある。私たちは、新しいモデルの結果を公開後すぐにデータベースに追加できる(多くの場合、モデルが公開された当日に結果を追加する)。今後もベンチマークの種類を増やし、このデータベースの保守と改善を続けていく。
AIモデルのデータとの統合。各評価は、私たちが集めているモデルの詳しい情報と結びついている。これには公開日、開発した組織、場合によってはモデルの学習に使われた計算量の私たちの推定値が含まれる。
Epoch AIクライアントライブラリ
今日はあわせて、オープンソースのEpoch AI Pythonクライアントライブラリ(pip install epochai)も公開する。このライブラリは、Airtable API経由で私たちのデータにアクセスする新たな手段となる。
このライブラリには、よくある作業のためのサンプルスクリプトが付属している。たとえば、あるベンチマークで最も性能の高いモデルの推移を追ったり、ベンチマークでの性能順位を表示したりするものである。
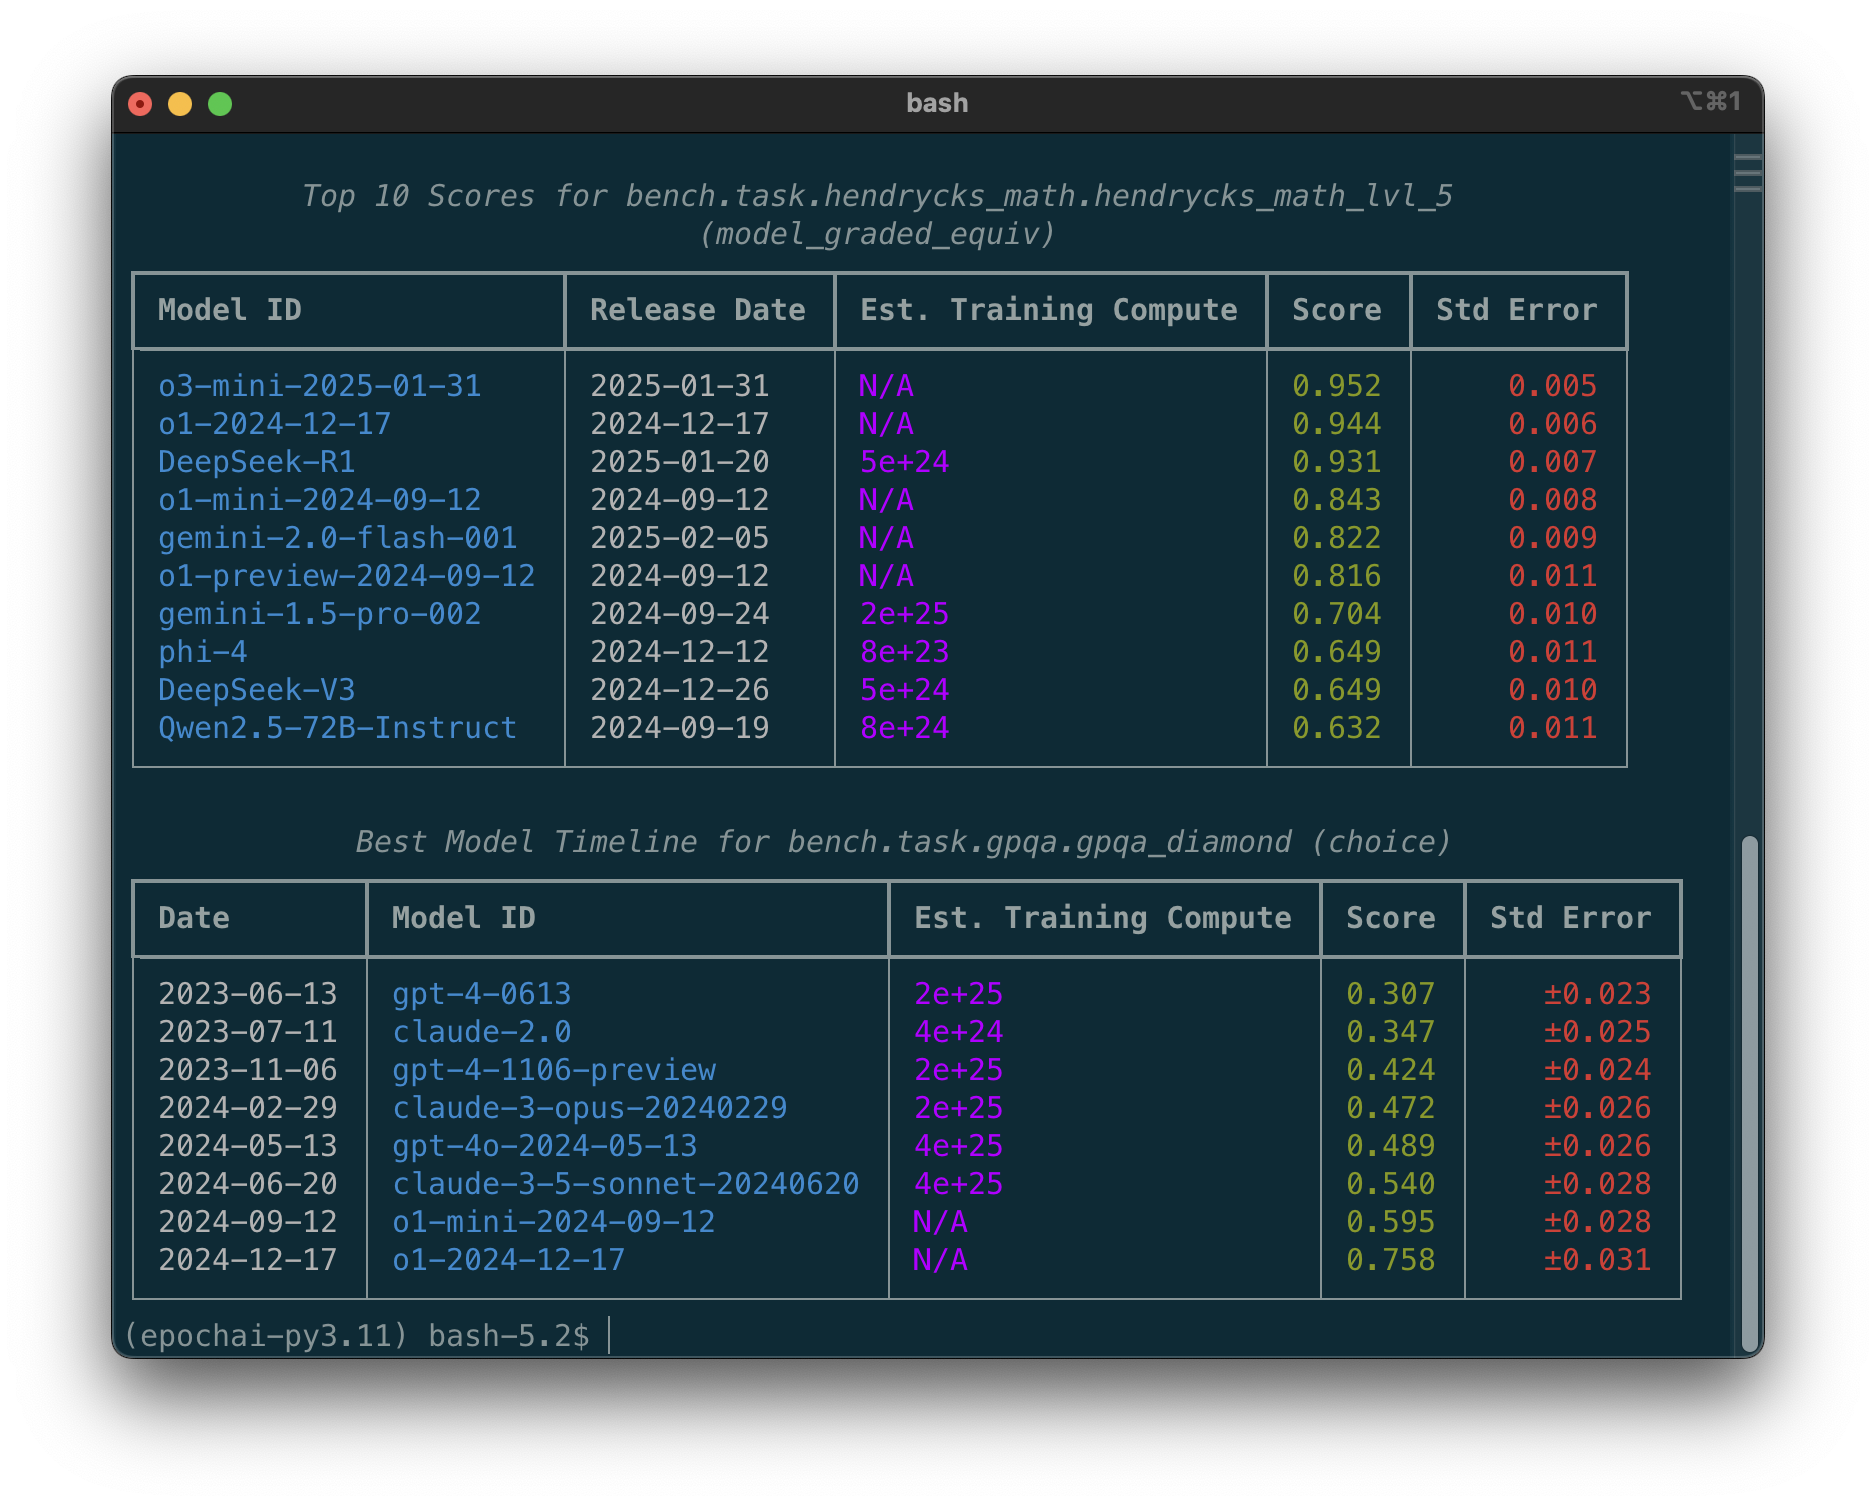
このライブラリを使えば、ベンチマーク結果と、データベース内のほかの項目(公開日、学習計算量の私たちの推定値、モデルを公開した組織など)との関係を簡単に問い合わせることができる。
評価プラットフォーム
私たちは、英国政府のオープンソースのInspectライブラリを使っている。Inspectは強力なプラットフォームで、評価をすばやく実装し、評価の設定について包括的な情報を集め、その情報をInspectのログビューアーで表示するのに役立つ。
私たちのベンチマークの実装は、Inspect向けにコミュニティが提供したLLM評価のリポジトリであるInspect Evalsを利用している。
今後の予定
最優先の課題は、ハブにベンチマークを追加して拡充することである。まずは、難しい数学の問題からなる私たちのベンチマークFrontierMathから始める。
ベンチマークの種類と対象モデルを今後も広げていくので、定期的な更新を楽しみにしていてほしい。