
ニュースレター
AIにいま何ができるかは本題ではない
原題:What AI can currently do is not the story
Gradient Updates は著者個人の見解を述べるニュースレターで、Epoch AI 全体の見解とは限りません。
AIシステムの将来の能力と、その能力がもたらす経済的・社会的影響を予測しようとするとき、よく使われる方法は2つある。
-
過去のAIの能力とその変化の速さを調べ、そこからわかることを将来に外挿する。
-
人間の脳の能力と資源の使い方、さまざまな領域での学習データの入手しやすさ、タスクごとの報酬信号を得るコストなどに基づいて第一原理から推論し、タスクを自動化する難しさを見積もる。
それぞれの方法を実際にどう使うかについてはさらに細かい違いがあるが、この2つはAIの能力を予測する根本的に異なる方法である。経済学者は第1の方法を好むことが多い。たとえば Robin Hanson は2012年にその変種を使い、過去20年間に人間並みの能力に向けてどれだけ進歩したかをAIの専門家に尋ね、その答えを外挿して、人間並みのAIの到来時期(タイムライン)を1世紀以上先と見積もった。
この方法をとる人々は、将来のAIにとって最も易しいタスクは、予測を行う時点でAIにできるタスクに(自分たちから見て)似ているものだ、と想定しがちである。さまざまな職業がコンピュータ化の影響をどれだけ受けやすいかを推定しようとした影響力のある経済学論文、Frey and Osborne (2013) の次の一節は、この考え方をよく表している。
……コンピュータが実行できるタスクは、結局のところ、起こりうるあらゆる事態に対して技術を適切に動かす一連の手順や規則を、プログラマーが書けるかどうかにかかっている。したがってコンピュータが人間の労働に比べて相対的に生産的になるのは、問題を明確に定式化できる場合、つまり成功の基準が定量化でき、容易に評価できる場合である。
この予測は当時は妥当に思えたかもしれないが、その後10年間の深層学習の進歩によって誤りであることが示された。今日の大規模言語モデルは、人間がモデルの内部の計算を理解しないままでも多くのタスクを実行できる。問題を明確に定式化することが今も重要だとしても、それは別の理由による。たとえば、強化学習でそのタスクでのモデルの性能を高めやすくなる、といった理由である。
深層学習の革命のあと、AIの経済学でもう一つ広まった捉え方は、AIシステムを「予測マシン」と考えるものだった。この新たな外挿は、当時のAIシステムの能力の特徴への反応だった。2012年から2019年にかけては、予測タスクに適した教師あり学習の手法が分野を席巻しており、外挿する人々は、将来のAIは2010年代半ばの教師あり学習器がより良くなったようなものだと想定すれば予測できる、という昔ながらの誤りを犯した。上でリンクした本からいくつか引用すると、これがよくわかる。
「……私たちが目にしてきた進歩は機械学習におけるものであり、それはより正確には、重要なものではあるにせよ、統計学の進歩、とくに予測を生み出すための統計学の進歩と特徴づけるべきものである」
「新しいAI技術は何をそれほど安くするのか。予測である。したがって経済学が教えるとおり、私たちはこれまでよりずっと多くの予測を使い始めるだけでなく、予測が思いがけない新しい場所に現れるのを目にすることになる」
コンピュータ化はプログラマーがあらゆる事態を明示的に想定できるかにかかっている、という Frey and Osborne (2013) の予測と同じく、この新たな外挿も、その後の分野の発展、とりわけ教師なし学習と、いま「生成AI」と呼ばれるものへの移行によって覆された。
これらの例とは対照的に、第一原理から推論する方法は、AI研究者や未来学者がよく使ってきた。おそらく最も有名な例は Ray Kurzweil で、彼は1999年に脳の計算能力を毎秒約10^16回の演算と見積もり、これをムーアの法則と組み合わせて、人間並みのAIシステムが2029年に生まれると予測した。私自身も Gradient Updates で以前、似た方法を使ったことがある。たとえばモラベックのパラドックスを扱った過去の号では、進化論的な議論をもとに、さまざまなタスクがAIによって自動化される今後の順序を推測した。
本号で私は次のように論じる。AIがすでに最低限の能力でこなせるタスクでの進歩の速さを予測するには、第1の方法のほうが信頼できることが多い。しかし、現在のAIがまったくできない、あるいはごく下手にしかできないタスクでの性能を予測するには、第2の方法のほうがはるかに優れている。さらに、AIによる将来の経済的利益の大部分は、AIがまだ実行できないタスクから生まれると予想できるので、第1の外挿の方法だけに狭く頼る予測者は、AIの進歩の今後の速さ、広がり、影響を大幅に過小評価すると予想すべきである。
Epoch AI の最新情報を受け取る 購読する
外挿の危うさ
単純なモデルを使って過去のデータを将来に外挿するのは、予測の方法として十分に検証されたやり方であり、ほかの多くの領域では私も支持する。しかしAIについては、それだけを使うと深刻な欠陥があると思う。
最も重要な欠陥は、こうした方法を使うと過去と現在の能力に引きずられ、現在のAIにはまったくできないタスクを将来のAIがどこまでこなせるようになるかを過小評価してしまうことである。この方法を使う予測者は、その可能性を明示的に考慮しようとする場合でも、将来のAIは現在のAIと似たようなもので、ただ得意な範囲が、いまAIにできることの隣接するタスクへと徐々に広がっていくだけだと考えがちである。
この誤りの現在の形は、AIの最近の発展を「生成AI」という狭い枠組みで見ることである。それ以前の「予測マシン」と同じく、この考え方をする人々は、今日の画像生成器やチャットボットのようなものが、より安く、より高品質になると想定すればAIの将来の能力を十分に予測できる、と考えるように偏ってしまう。
このようにAIの将来を予測することの問題は、どれほど強調してもしすぎることはない。例示として、また教訓として、2016年に人々がAIシステムの重要な能力と考えていたものの表を以下に示す。
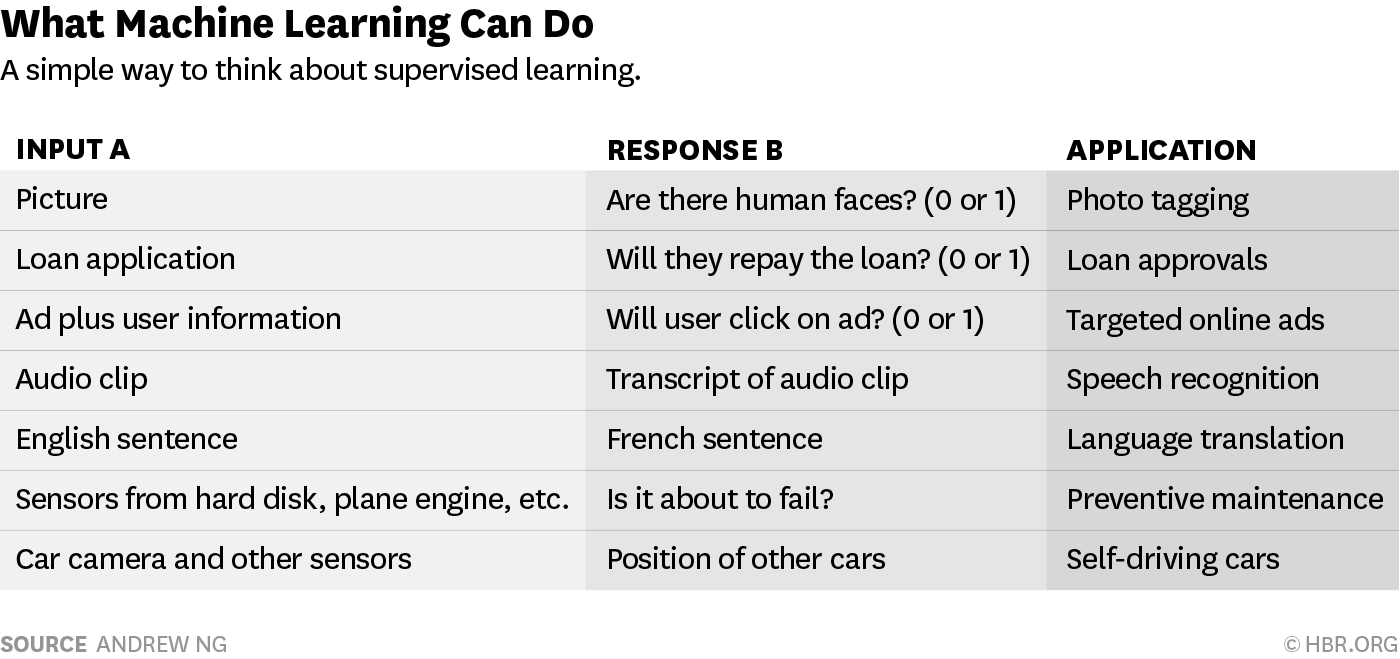
図1:当時のAIシステムにできること・できないことについて Andrew Ng が書いた2016年の Harvard Business Review の記事の表。
2025年の私たちにとって目立つ能力、つまり質問応答、読解、画像生成、プログラミング、数学のどれも、この表にはまったく登場しないことに注意してほしい。これらはすべて、スケーリングとアルゴリズムの進歩の結果として現れた新しい能力であり、2025年のAIシステムの性能を素朴な外挿で予測していた人には視野の外にあったはずのものだ。現在のAIの能力と10年後の能力の違いも同じくらい大きくなる、と最初から予想しておくべきだ。
この素朴な外挿の方法に頼りすぎるという誤りを犯していると私が考える、最近の影響力のある論文が Acemoglu (2024) である。Acemoglu は、さまざまな経済的タスクがLLMによる自動化にどれだけさらされているか、またそうしたタスクでどれだけのコスト削減が合理的に見込めるかを推定した他の著者たちの研究をもとにしている。そのうえで、AIによって今後10年間で経済の産出量が0.7%増えると見込めると推定している。この数字は、次の推定を組み合わせて得られる。
- Eloundou et al. (2023) の推定によれば、米国では賃金総額で見てタスクの約20%が大規模言語モデルによる自動化にさらされている。
- Svanberg et al. (2024) は、現在コンピュータビジョンのシステムによる自動化にさらされているタスクのうち、実際に自動化して費用対効果があるのは23%にすぎないと推定している。
- こうして自動化されたタスクについて、Acemoglu は、人間が行う場合と比べて平均約30%の人件費削減を仮定している。
- 最後に Acemoglu は、これらのタスクのコストのうち実際に人件費が占めるのは約50%と推定しており、これらのタスクの総コスト削減は約15%となる。
GDPへのおおよその影響は、コスト削減を受けるタスクの割合(約 0.2 * 0.23 = 4.6%)に、そこから導かれる生産性の向上(約 1/0.85 = 17.6%)を掛けて計算でき、全要素生産性への影響は約 4.6% * 17.6% = 0.8% となる。
これは、「LLMをより良くしたもの」と要約できるような仮想の技術が経済の産出量に与える影響の見積もりとしては妥当である。しかし、10年という時間軸で将来のAIシステムに実際に期待すべきものはそれではない。将来のAIシステムは、現在のAIシステムにはまったくできない多くのタスクを実行できるようになると予想すべきである。たとえば下の図は、テスト時の計算量というパラダイムの転換が言語モデルの数学の成績に与えた影響を示している。
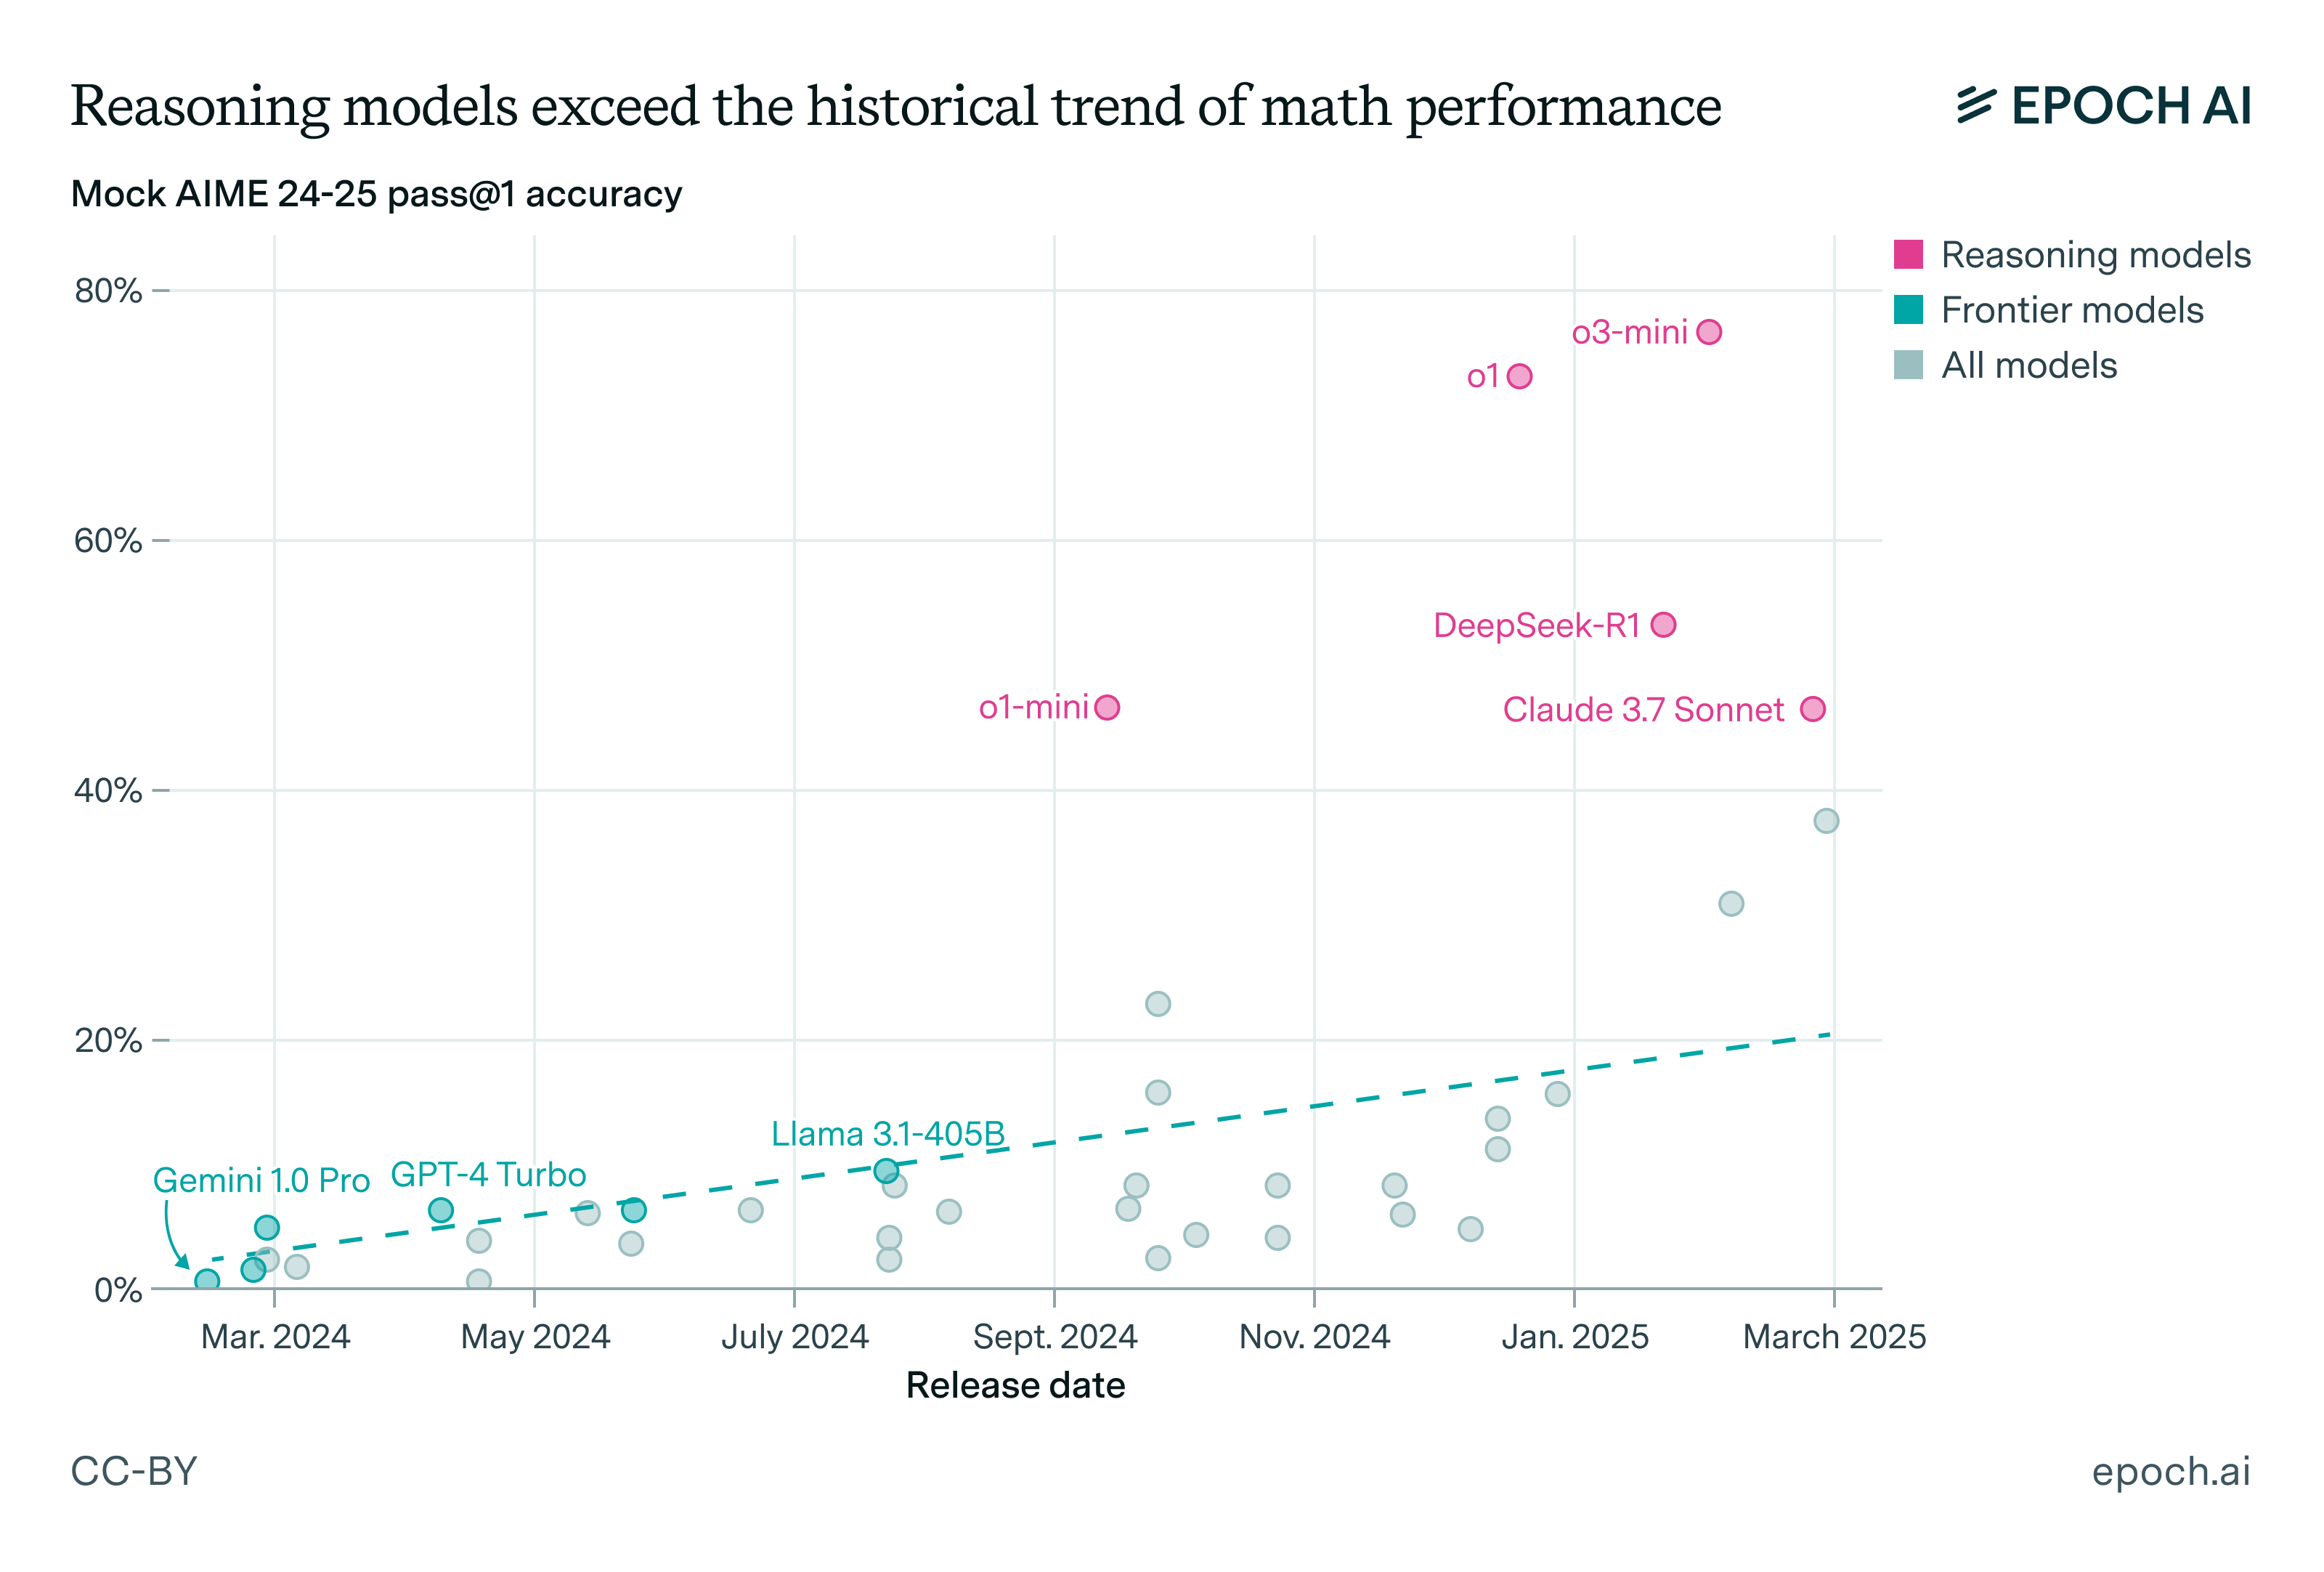
事前の見込みとしては、今後10年間にもこうした不連続な変化や、突然現れる能力が数多くあると予想しておくべきだ。したがって、いまAIに何ができるかを見るのは、予測を立てるうえで地に足のついた妥当な方法に思えるが、実際にはひどく不正確になる可能性が高い。進歩の急な加速や新しい能力の出現を考慮に入れる、より思弁的な方法のほうが、よりよい予測になる可能性が高い。
代わりにどうするか?
将来の予測が難しいという問題を回避する方法はない。将来に外挿できる明確なトレンドがなければ、なおさら難しい。たとえば現在、リモートワークのタスクやロボット工学について質の高いベンチマークはない。仮にそうしたベンチマークがあっても、現在のシステムはどれも非常に低い成績にとどまり、線形に外挿すれば、ベンチマークが飽和する時期は数世紀とまでは言わないまでも数十年先になるかもしれない。これは明らかに、AIがこれらのタスクをいつうまくこなせるようになるかを見通す妥当な方法ではない。ベンチマークのスコアが時間の線形関数ではないことを、私たちは何度も見てきたからだ。
人間にはできるが現在のAIにはまったくできない、こうした「出現前」のタスクについては、人間の脳という存在証明とその資源の必要量を予測の材料にすべきだと私は考える。人間の脳が実行できる認知タスクであれば、そのタスクを実行するニューラルネットワークを作るには、少なくとも次のものがあれば十分だと言える。
-
実行時の計算量として 1e15 FLOP/s。脳が行っている計算量はおおよそこの程度と推定されている。
-
学習計算量として 1e24 FLOP。人間は30歳までに約10億秒を生きるからである。
-
サイズが100 MBよりはるかに小さく、何らかの進化的探索で発見するのに必要な計算量が1e45 FLOPよりはるかに少ない学習アルゴリズム。
サイズの上限はゲノムの大きさから、探索の計算量の上限は、進化の全過程で行われえた有用な計算の量に対する熱力学的な限界からくる。 -
人間が生涯の学習で目にするのと同じ量の学習データ。
このうち (1)、(2)、(4) は、ほとんどのタスクで現在すでに達成できる。これは新しい状況で、フロンティアAIシステムの学習計算量が1e24 FLOPの閾値を超えたのは約2年前のことにすぎない。人間を超える能力を示すAIシステムがまだないことは、多くの領域で私たちのアルゴリズムがいまだ人間の脳に劣っている証拠である。つまり条件 (3) はまだ満たされていない。
(3) にかかわるアルゴリズム探索に実際に必要な計算量についての不確実性を、簡単に絞り込む方法はない。そこで控えめな解決策として、人間の脳を上回るアルゴリズム一式の発見に必要な計算量は、これまでに累計で費やしてきた量(おそらく1e26〜1e30 FLOP)から1e45 FLOPまでの間で、対数スケール上で一様に分布すると仮定する。この累計の計算量は2020年代の終わりまでに約1000倍に増えるという見積もりが妥当であり、現在の出発点からすると、これは正しいアルゴリズムに行き当たる確率が約20%であることを意味する。モデルの不確実性を考えてこれをたとえば半分に割り引いても、2030年までに人間並みのAIが実現する確率は10%になる。
しかもこれは、進化とは違って、私たちがアルゴリズム探索、モデルの学習、モデルの推論実行に費やす計算量を互いにトレードオフできる可能性や、学習計算量をモデルの展開されたすべてのインスタンスで償却できる可能性を考慮に入れていない。これにより、劣ったアルゴリズムを使い、それをより多くの学習計算量と推論実行の計算量で補うことができるかもしれない。実際、最初の人間並みのAIシステムはそうするだろうと私は予想している。これを考慮に入れれば、確率は10%よりかなり高くなるはずだ。ただ、どの程度高くなるかははっきりしない。
この見方をモラベックのパラドックスと組み合わせると、AIが最初に人間並みの性能に達するのはどのタスクかについても見当がつく。それはまさに、人間と比べてAIのデータ面での優位が大きく、アルゴリズム面での劣位が小さいタスクである。たとえば Eloundou et al. (2023) は、タスクに科学的な技能が必要であることを、そのタスクがLLMによる自動化に抵抗すると予想する理由だと結論づけている。しかし私は、このより広い見方からすると、それはむしろ、そのタスクがAIによる自動化全般にさらされる理由になると考える。科学的な推論は、感覚運動や知覚のタスクと比べて、人間がきわめて効率的なアルゴリズムを持っているような種類のタスクではないからである。
結論
基本的な教訓は、AIにいま何ができるかは本題ではないということだ。数年より先のAIの将来を予測したいなら、AIシステムの現在の能力に、さらには現在の能力の変化の速さにさえ、引きずられるのは得策ではない。代わりに、さまざまなタスク(その多くは現在のAIシステムにはまったくできない)の本来の難しさと、そこからAIでそうしたタスクを自動化するのにどれだけの資源が必要になるかを考えるべきである。
そうすると、AIの進歩についてはるかに強気な見通しが得られ、それは最近の歴史によりよく合っているように私には思える。「生成AI」システムの能力には本来的な限界があるとして今日の人々が持ち出す議論の多くは、たとえば2016年に当時のAIシステムの限界について持ち出されていたとしたら、かなりひどい結果に終わっていただろう。予測をもっと当たるものにしたいなら、過去にうまくいかなかった予測方法に頼るべきではない。