
❦
以前、XとYの相互情報量について話した。I(X;Y)と書き、同時確率分布のエントロピーH(X,Y)と、周辺分布のエントロピーH(X) + H(Y)との差である。
例として、変数XにはX1からX8までの8状態があり、まだ証拠がなければすべて等確率であるとした。変数Yにも、証拠がなければ等確率のY1からY4までの状態がある。周辺エントロピーH(X)とH(Y)を計算すると、Xは3ビット、Yは2ビットになる。
ただし、XとYは両方偶数か両方奇数だと分かっており、関係について知っているのはそれだけだ。同時分布(X,Y)には16の可能な状態しかなく、すべて等確率なので、同時エントロピーは4ビットだ。XとYが独立なら5ビットなので、1ビット少ない。このエントロピーの不足分が相互情報量である。XがYについて、あるいはその逆に教えてくれる情報で、一方を知れば、もう一方の不確かさが減る。
だが、第三の変数Zがあるとしよう。Zには「偶数」「奇数」の二状態があり、(X,Y)の偶奇と完全に相関する。実際、Zは単に「XとYは偶数か奇数か?」という問いだとしよう。
XとYについて証拠がなければ、与えた情報から、Z自体のエントロピーは必ず1ビットになる。ZとXの相互情報量は1ビット、ZとYも1ビット。そして先ほどのとおり、XとYも1ビットだ。では全体系(X,Y,Z)のエントロピーは? 素朴には、次のように考えるかもしれない。
H(X,Y,Z) = H(X) + H(Y) + H(Z) − I(X;Z) − I(Z;Y) − I(X;Y) ,
だが、そうはならない。
Zはただ「XとYは偶数か奇数か?」という問いなので、結合系(X,Y,Z)には16の可能な状態しかなく、H(X,Y,Z) = 4ビットだ。だが、今の式を計算すると、
(3 + 2 + 1 − 1 − 1 − 1) ビット = 3 ビット = 間違い!
なぜか。XとZの相互情報量、およびZとYの相互情報量には、XとYのあいだにあると計算される相互情報量の一部が、重複して含まれうるからだ。この例では、Xが偶数と知ればZも偶数だと分かり、Zが偶数と知ればYも偶数だと分かる。だが、それはXがYについて教えるのと同じ情報だ。知識の一部を二重に数えたため、エントロピーを少なく見積もりすぎた。
正しい式は、私の理解では、次のとおりだ。
H(X,Y,Z) = H(X) + H(Y) + H(Z) − I(X;Z) − I(Z;Y) − I(X;Y|Z).
最後の項I(X;Y|Z)は、「Zをすでに知っているとき、XがYについて教える情報」を意味する。この例では、Zが分かっていれば、XからYについて新たに分かることはない。だからこの項はゼロになり、式は正答を与える。ほら、うまくできているだろう?
「いいえ」とあなたは正しく答える。「I(X;Y|Z)の計算方法を教えず、ゼロになるはずだという言葉の説明をしただけだからです」。
I(X;Y|Z)は、予想どおりの方法で計算する。I(X;Y) = H(X) + H(Y) − H(X,Y)と分かっているので、
I(X;Y|Z) = H(X|Z) + H(Y|Z) − H(X,Y|Z).
今度は条件付きエントロピーの計算方法を知りたいのだろう。エントロピーのもとの式は、
H(S) = Σi −P(Si) × log 2(P(Si)).
そこで新しい事実Z0を知ったなら、Sについて残る不確かさは、
H(S|Z0) = Σi −P(Si|Z0)log2(P(Si|Z0)).
だから、新しい事実Zを知る予定だが、どのZかはまだ分からないなら、その後のSについての不確かさは、平均すると次のように予想される。
H(S|Z) = Σj  P(Zj)Σi −P(Si|Zj)log2(P(Si|Zj))
 .
こうして条件付きエントロピーを計算し、そこから条件付き相互情報量を求められる。
ここには、次のようなさまざまな付随する定理もある。
H(X|Y) = H(X,Y) − H(Y)
そして、
もし I(X;Z) = 0 かつ I(Y;X|Z) = 0 ならば I(X;Y) = 0,
だが、それには立ち入らない。
「でも」とあなたは尋ねる。「これが、言葉の本質や、そこに隠れたベイズ構造とどう関係するのですか?」
その質問をしてくれて、言葉にならないほどうれしい。あなたが望もうと望むまいと、話すつもりだったからだ。だが、先にもう少し準備がある。
覚えているだろう。いや、覚えているはずだ。相互情報量とベイズ的な証拠には双対関係がある。相互情報量が正なのは、少なくとも一部の同時事象の確率P(x,y)が、個々の事象の確率の積P(x)P(y)と等しくない場合、そしてその場合に限る。これは、xとyのあいだにベイズ的な証拠が存在するという条件と、厳密に等価だ。
| I(X;Y) | > | 0 ⇒ |
| P(x,y) | ≠ | P(x)P(y) |
| P(x,y) | ≠ | P(x) |
| P(y) | ||
| P(x|y) | ≠ | P(x) |
Zを条件にするなら、導出全体をそれに合わせて調整すればよい。
| I(X;Y|Z) | > | 0 ⇒ | |
| P(x,y|z) | ≠ | P(x|z)P(y|z) | |
| P(x,y|z) | ≠ | P(x|z) | |
| P(y|z) | |||
| (P(x,y,z)/P(z)) | ≠ | P(x|z) | |
| (P(y,z)/P(z)) | |||
| P(x,y,z) | ≠ | P(x|z) | |
| P(y,z) | |||
| P(x|y,z) | ≠ | P(x|z). | |
最後の行は、「Zを知っていても、Yを知ればXについての信念が変わる」と読む。
逆に、最初の例のようにZが「偶数」か「奇数」なら、ZはXをYから遮断する。つまりZが「偶数」と分かっているなら、YがY4だと知っても、XがX2、X4、X6、X8のどれかについて、それ以上何も分からない。あるいは、Zが「奇数」と分かっているなら、XがX5だと知っても、YがY1かY3かについて、さらに分かることはない。Zを知ることで、XとYは条件付き独立になったのだ。
条件付き独立は、確率論で非常に重要な概念だ。一例を挙げるだけでも、それがなければ、宇宙には構造がないことになる。
ただしここでは、特定の種類だけを扱う。中央の胴体から触手が伸びるように、中心の変数が、周りの変数同士を遮断する場合だ。
五つの変数U、V、W、X、Yがあり、どの二つを選んでも、一方が他方についての証拠になるとしよう。たとえばUとWを選ぶと、U = U1と知れば、W = W1の確率について、それまで知らなかったことが分かる。
手に負えない推論の混乱だろうか。証拠が暴走しているのか。必ずしもそうではない。
Uは「言語を話す」、Vは「腕が二本、指が十本」、Wは「服を着る」、Xは「ドクニンジンで中毒になる」、Yは「血が赤い」だとしよう。リンゴかもしれず、石かもしれない、世界の何かに出会い、それが中国語を話すと分かれば、服を着ている確率をずっと高く見積もるだろう。ドクニンジンでは中毒にならないと分かれば、血が赤い確率をいくらか下げるだろう。
これらの規則には、強いものと弱いものがある。火山事故で指を一本失ったフレッドや、まだ話せない赤ん坊のバーニーや、文を発するが血はないIRCボットのアーヴィングもいる。だから、あるものが服を着ていないと分かっても、話せるという情報が血の色について教えることが、すべて遮断されるわけではない。服を着ないが話せるなら、裸のネリーかもしれない。
この点で、たとえば、全部が奇数か全部が偶数で、それ以外には相関しない五つの整数変数よりも、面白い例になる。その場合は、一つを知れば、二つ目から三つ目について分かることは、すべて遮断される。
だがここには、裸のネリーの例のように、一変数を知るだけでは消えない依存関係がある。ならば、やはり推論上、手に負えないのだろうか。
恐れることはない! 六つ目の変数Zがあり、それを知れば、どの変数同士も本当に遮断できるかもしれない。そのような変数Zがあるかもしれないのだ。直接観測するのでなく、Zを構成しなければならないとしても、次が成り立つような変数が。
| P(U|V,W,X,Y,Z) | = | P(U|Z) |
| P(V|U,W,X,Y,Z) | = | P(V|Z) |
| P(W|U,V,X,Y,Z) | = | P(W|Z) |
| ⋮ |
あるものが「人間」だと分かっていれば、話す確率、服を着る確率、標準的な本数の指を持つ確率は、すべて独立なのかもしれない。フレッドは指を失っていても、ほかの人より裸で暮らすのを好む見込みが高いわけではない。裸のネリーは服を着ないが、それを知っても、話せる確率は下がらない。赤ん坊のバーニーはまだ話せないが、手足は欠けていない。
これは「ナイーブベイズ」と呼ばれる手法だ。普通は完全には真でないのだが、真だと見なせば、計算がとてつもなく簡単になるからである。指の本数が与えられたとき、服を着ていることが話す能力へ及ぼす影響を、別々に追跡しない。観測した情報をすべて使って、目の前のものが人間である確率、あるいはチンパンジーやロボットなど別物である確率を追い、中央の分類についての信念から、ドクニンジンへの弱さなど、まだ見ていないことを予測するだけだ。
U、V、W、X、Yのどの観測も、中央の分類変数Zについての証拠として働く。そしてZの事後分布を使い、U、V、W、X、Yのうち未観測の変数について、必要な予測を行う。
見覚えがあるだろう? そのはずだ。
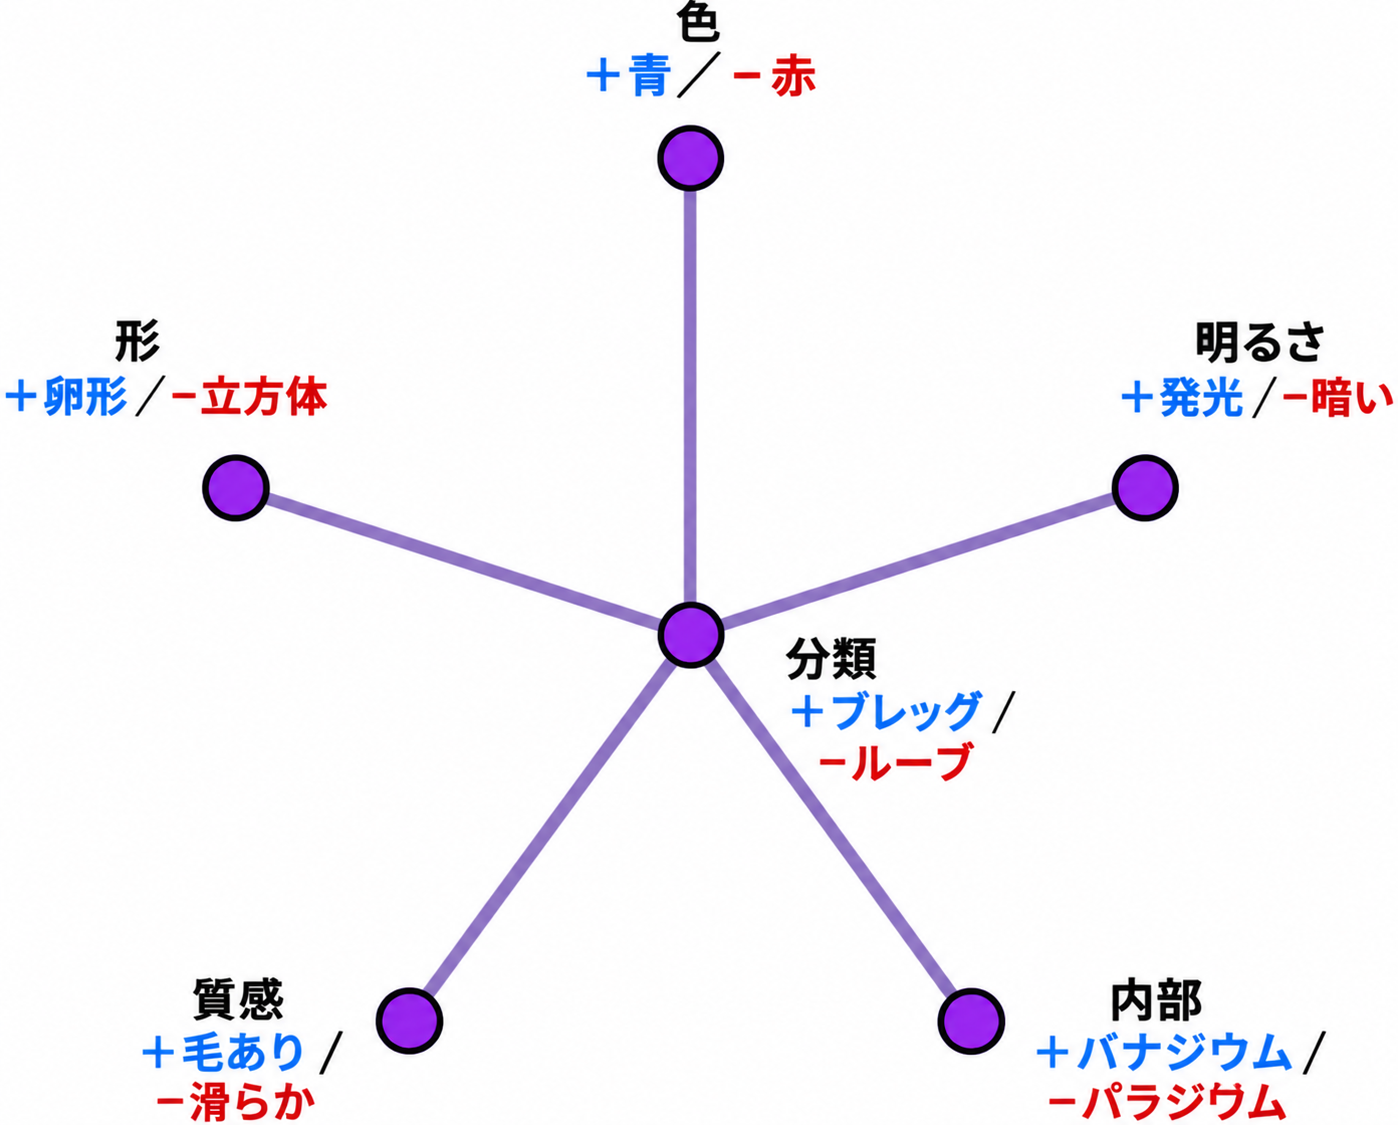
ネットワーク2
実際、適切な種類のユニットを使えば、この「ニューラルネットワーク」はナイーブベイズと数学的に厳密に等価になる。中央のユニットにはロジスティックな閾値、つまりS字曲線の応答が必要で、入力の重みは尤度比の対数に合わせればよい、といった具合だ。ロジスティック応答がニューラルネットワークでしばしばうまく働く理由の一つは、これではないかと考えられる。設計者が見ていないところで、アルゴリズムに少しだけベイズ的推論を忍び込ませるのだ。
誰かが「ニューラルネットワーク」と呼ぶアルゴリズムに、「泥臭い(スクラッフィ)」「創発的」といった流行語を貼りつけ、学習後の仕組みは分からないと誇らしげに断っても、その小さなAIが本当に論理の領域を超えていると思ってはいけない。この場当たり的な手法の典型も、機能するならベイズ構造を持つと分かるはずだ。「ベイズ的」と呼ばれる種類のアルゴリズムと、厳密に等価であることさえありうる。
表面上はベイズ的に見えなくても。
そしてベイズ主義者が、その仕組み、反映する前提、利用する環境の規則性、うまくいく場合と失敗する場合を正確に説明し、学習した重みに理解可能な意味まで与え始めることは、もう分かっているだろう。
がっかりだろう?