
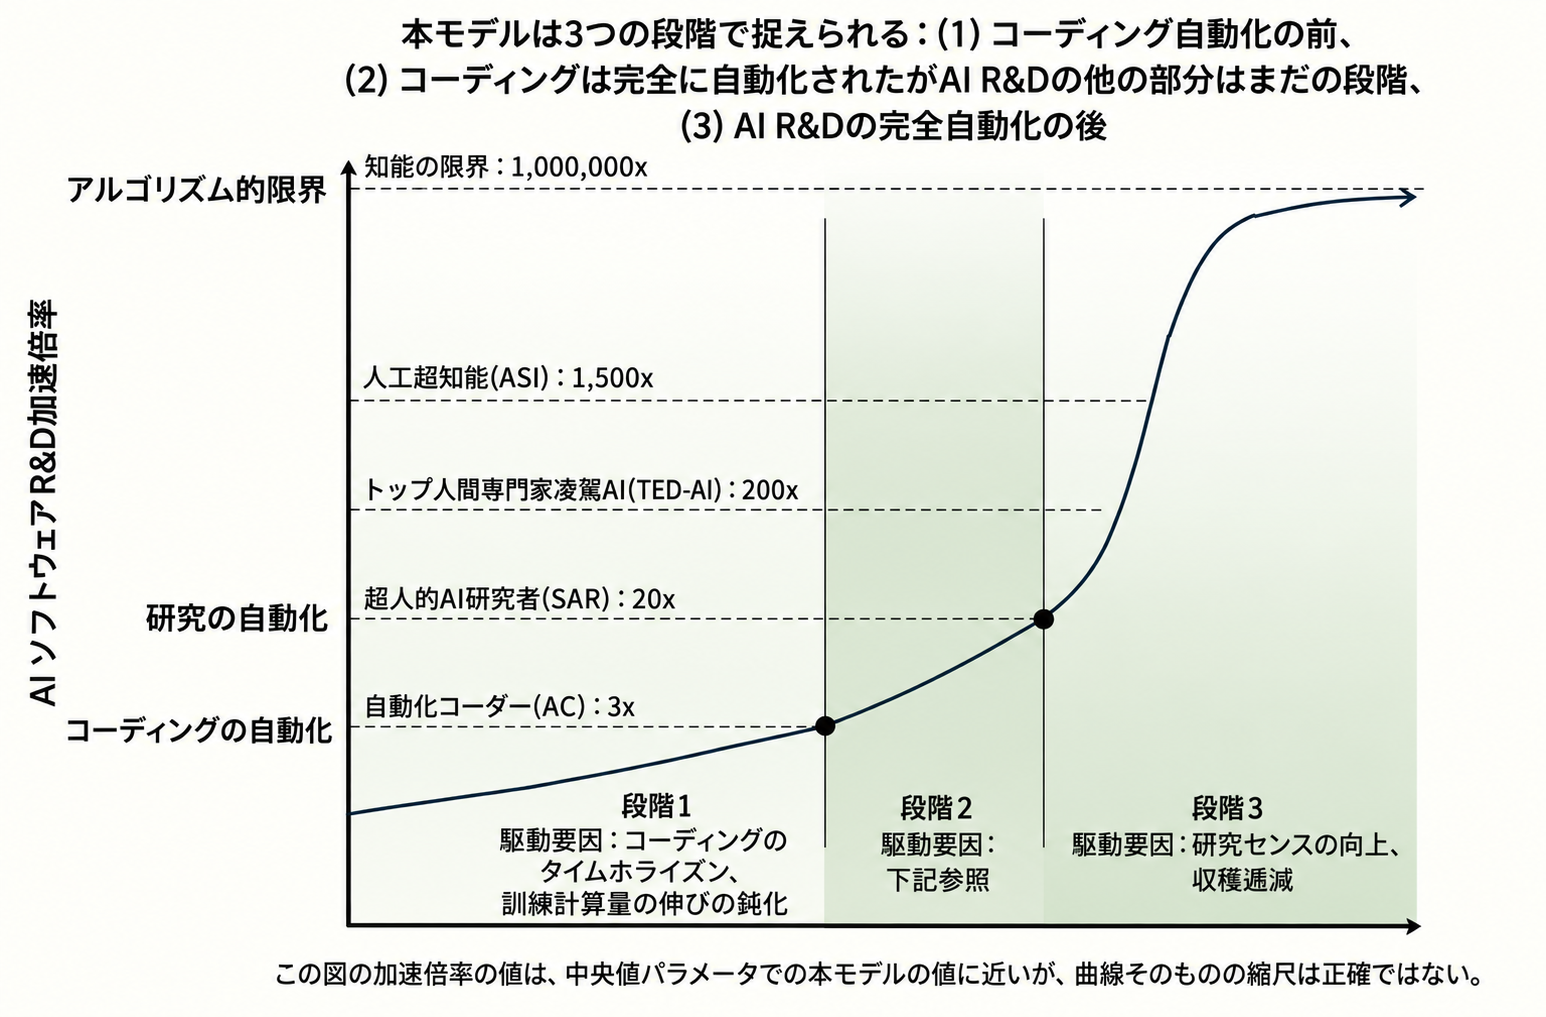
1 タイムホライズンと自動化コーダーのマイルストーン
本モデルの段階1は主に、AIのコーディングスキルの軌道を予測する。コーディングの自動化に注目するのは、コーディングが他のAI R&Dタスクと比べて現在のAIの得意分野だからである(そしてAI R&Dタスクに注目するのは、AI R&Dの自動化がAIの進歩にどう影響するかを予測するためにそれを使えるからである)。
コーディングの自動化を予測するために、METR-HRSのコーディングのタイムホライズン・ベンチマークにおける能力を外挿する。METR-HRSを選んだのは、非常に高度な能力まで外挿するのが比較的容易であること、そして過去データが何年分もあることによる。
コーディングのタイムホライズンとは、フロンティアモデルが80%の確率で成功裏に完了できるコーディングタスクの長さであり、人間がそのタスクを完了するのにかかる時間で測る。たとえば、あるAIの80%タイムホライズンが2時間なら、そのAIは人間のベースライン作業者が2時間かかるタスクを80%の成功率で完了できる(ベースライン作業者がそれ以上の時間を要するタスクでは成功率が下がる)。METRの調査によれば、タイムホライズンは過去5年間にわたって指数関数的に伸びており、倍加時間はおよそ7か月である。さらに2024年初頭以降のデータだけを見ると、タイムホライズンの伸びは実はそれ以上に速く、倍加時間は4〜5か月であるように見える。
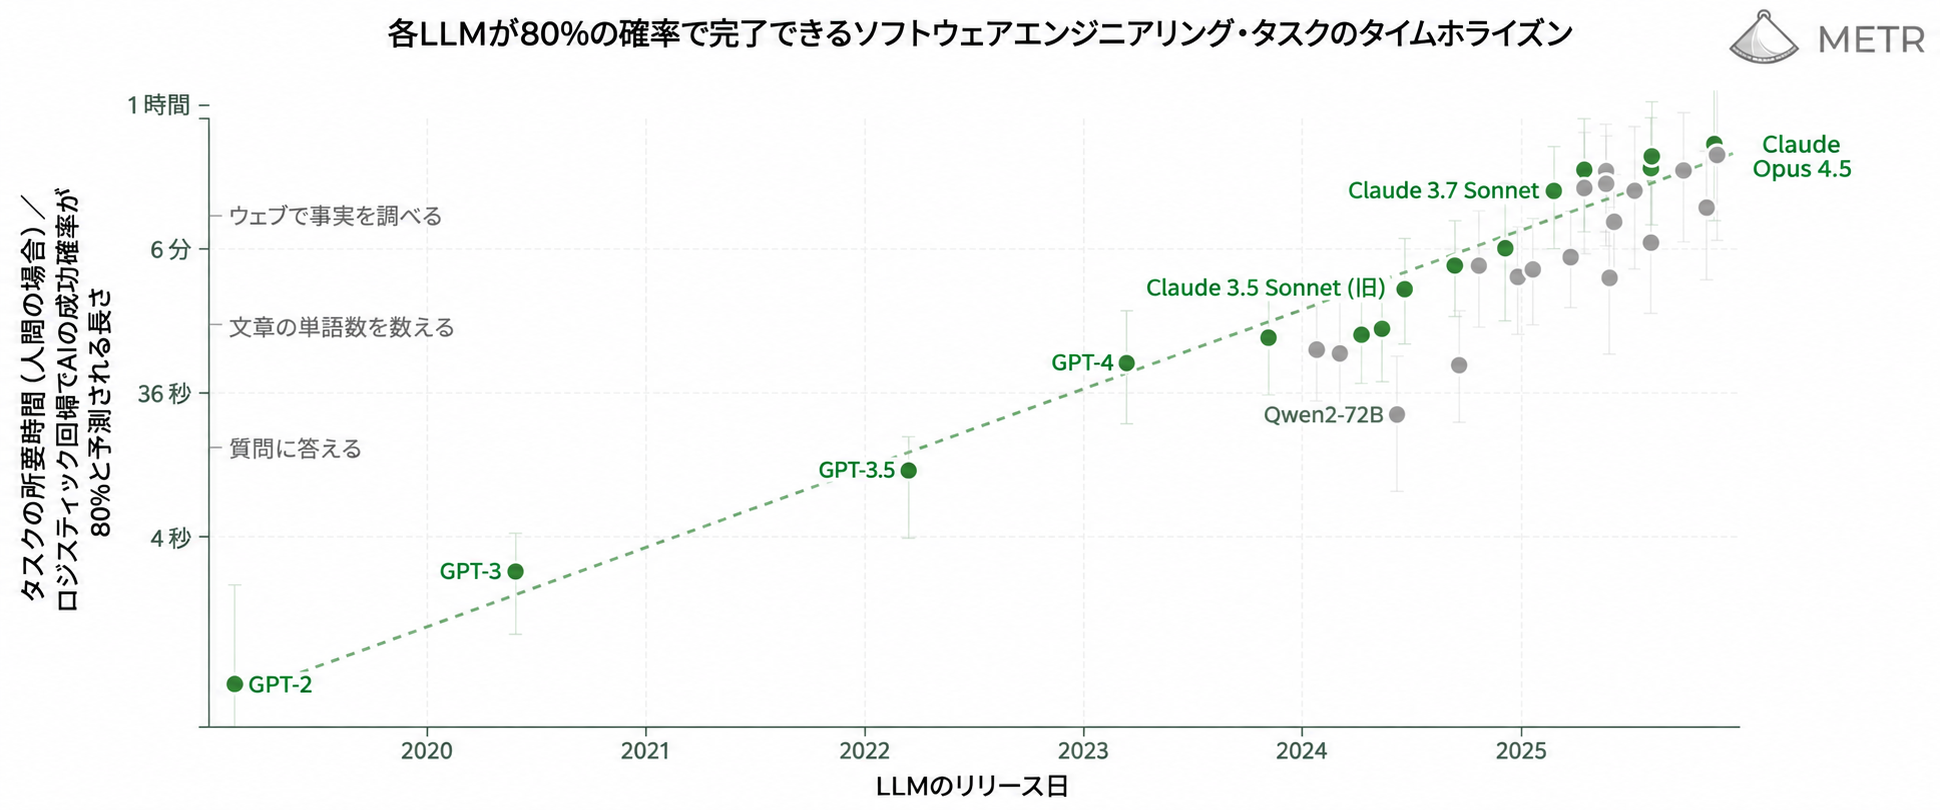
ここで予測したいのは、自動化コーダー(Automated Coder, AC)というマイルストーンに到達する時期、つまりAGIプロジェクトのコーディング作業を完全に自動化するAIの集団が得られる時期である。
本モデルにおけるACの操作的定義
ACとは、仮に現在に投入されたとすれば、それ単独で、AIを使わない人間のコーダーだけの場合と同等の生産性を発揮するものである。つまり、AGIプロジェクトから人間のコーダーを全員取り除いても、人間のコーダーだけで進めた場合と同じ速さで進む。プロジェクトはACを動かすために、自らの計算資源供給の5%を使うことができる。
自動化コーダーの到来時期を予測する単純な方法は、次のようなものだろう。
自動化コーダーを予測する単純な方法。 (METRのベンチマークを拡張した版において)どのタイムホライズンの閾値が自動化コーダーに相当するかを推定し、METRの過去のデータ点を時間について素直に指数関数で外挿して、そのタイムホライズンがいつ達成されるかを予測する。
なぜ成功率80%を要件とするのか?
80%は、METRが質の高いものとみなしている中で最も高い成功率のタイムホライズンである。では、80%タイムホライズンが、あらゆるカテゴリーのタスクで平均的なコーダーを凌駕することに対応するというのは、どうしてありうるのか。(a) AIが個々のタスクに成功するかどうかにはある程度のランダム性があるため、あらゆるカテゴリーで平均的な人間を凌駕するAIであっても、個々のタスクを人間並み以上の効率で100%確実にこなせるわけではない。(b) 信頼性への要求が高まることを考慮し、必要な80%タイムホライズンを上方修正している。
タイムホライズンにおける効率の要件
本モデルでは、AIがタスクを完了して成功とみなされるための条件として、速度の要件と計算効率の要件の両方を明示的に課す。具体的には、AIに (a) 同種のタスクを担当するAGIプロジェクトの人間の中央値と同じ速さでタスクを完了すること、(b) 現在の自動化用計算資源のうち、AGIプロジェクトでそのタスクに従事する人間のコーダーの割合と同じ割合だけを使うこと、を求める。METRの論文はこうした速度や計算効率の閾値を設けていないが、我々はこれが重要だと考えている。AIはすでに人間より非効率にタスクをこなすことがあり、AIがより多くのリソースをより高い性能に変換するのが上手くなるにつれて、この点は時間とともに重要性を増すと予想されるからだ。これらの要件は、これまでのMETRのデータ点とおおむね整合するはずである。
理論上のベンチマークMETR-HRS-Extendedの定義
METR-HRSには人間のベースライン作業者が完了までに30時間かかるタスクしか含まれておらず、我々はそれよりはるかに高い水準まで予測したい。そこで、実際に行うのは現実的ではないにせよ、原理的にはタスク群の拡張に使える手順を定義する。METR-HRSの拡張に使うタスクは、既存のタスクと同様のプロセスで作られると仮定する。すなわち、そのタスクの要件には、ある程度オープンエンドであるか、完了に探索を要するタスクを目指すこと、また幅広いスキルと領域をカバーすることが含まれる。テキストのモダリティと、おおむねモデルの得意分野を活かすタスクに重点を置きつつ、経済的な価値も持つものとする。また、バグがある、基準が曖昧であるなどの理由で確実に達成することが不可能なタスクは、すべて除外されると仮定する。
また、拡張の際にどのような人間のベースライン作業者を使うかを定義することも重要だ。有能な作業者ほど、あるタイムホライズンにおいて予想すべき影響は大きくなる。我々は、METRが、同種のタスクを担当する典型的なAGI企業のプログラマーと同じ時間でタスクを完了する人間のベースライン作業者を見つけると仮定する。これはMETRの過去のベースライン測定ともおおまかには整合するかもしれないと考えており、また現実世界への影響に比較的うまく結びつく単純な仮定でもある。
しかし、この単純な方法は、考慮に入れたい重要な要因をいくつか見落としている。すなわち、
- 1.
「タイムホライズン対暦時間」のトレンドは、AIの進歩への投入量の伸びの変化や、AIによる自動化の影響によって崩れる可能性がある。たとえば、投資の限界や新しいファブ(半導体工場)の建設速度のために、訓練計算量の伸びが鈍るかもしれない。一方で、人間の労働力の伸びは時間とともに鈍るかもしれない(「有効に雇える人数には限りがある」)が、AIがコーディングと研究に長けるにつれて、AI R&Dに投じられる総労働力は増えていく。
- 2.
投入量のトレンドが維持されたとしても、タイムホライズンは暦時間に対して超指数関数的にも劣指数関数的にも伸びうる。METRが観測してきたタイムホライズンの伸びはおおむね指数関数的で、各倍加にかかる時間はほぼ一定だったが、このトレンドが超指数関数的または劣指数関数的になる可能性はある(実のところ、最近の上振れのために現時点のトレンドはわずかに超指数関数的に見えるが、我々はこれを実質的な証拠とはみなしていない)。我々の最善の推測では、AI R&Dの自動化がなかったとしても、タイムホライズンは超指数関数的に伸びる。AIは(有限の時間で)無限のタイムホライズンに到達すると予想しており、そのためにはどこかの時点で超指数関数的な成長が必要になるうえ、急激な相転移が起こるとは考えていないからだ(詳しくは後述)。他方、少なくとも短期的に劣指数関数的な成長を予想する理由としては、データのボトルネックが考えられる。長期的な(ロングホライズンの)タスクについて質の高いデータを集めるのはコストがかかるかもしれない。
以下の各小節では、これらの欠点に対処するために単純な方法(すでに現在の倍加時間パラメータと、自動化コーダーに必要なタイムホライズンを含んでいる)に加える拡張を説明する。概要は次のとおり。
- 1.
タイムホライズンを、暦時間ではなく実効計算量(訓練計算量とソフトウェアの進歩を組み合わせたもの)の関数として追跡する。具体的には、ACの到来時期を求めるにあたり、本モデルはまずACに対応する実効計算量を決め(タイムホライズンと実効計算量の関係をモデル化し、ACのタイムホライズンを設定することで求める)、その後、実効計算量の伸びを別途モデル化することでACの到来時期を求める、という論理をとる。
- 2.
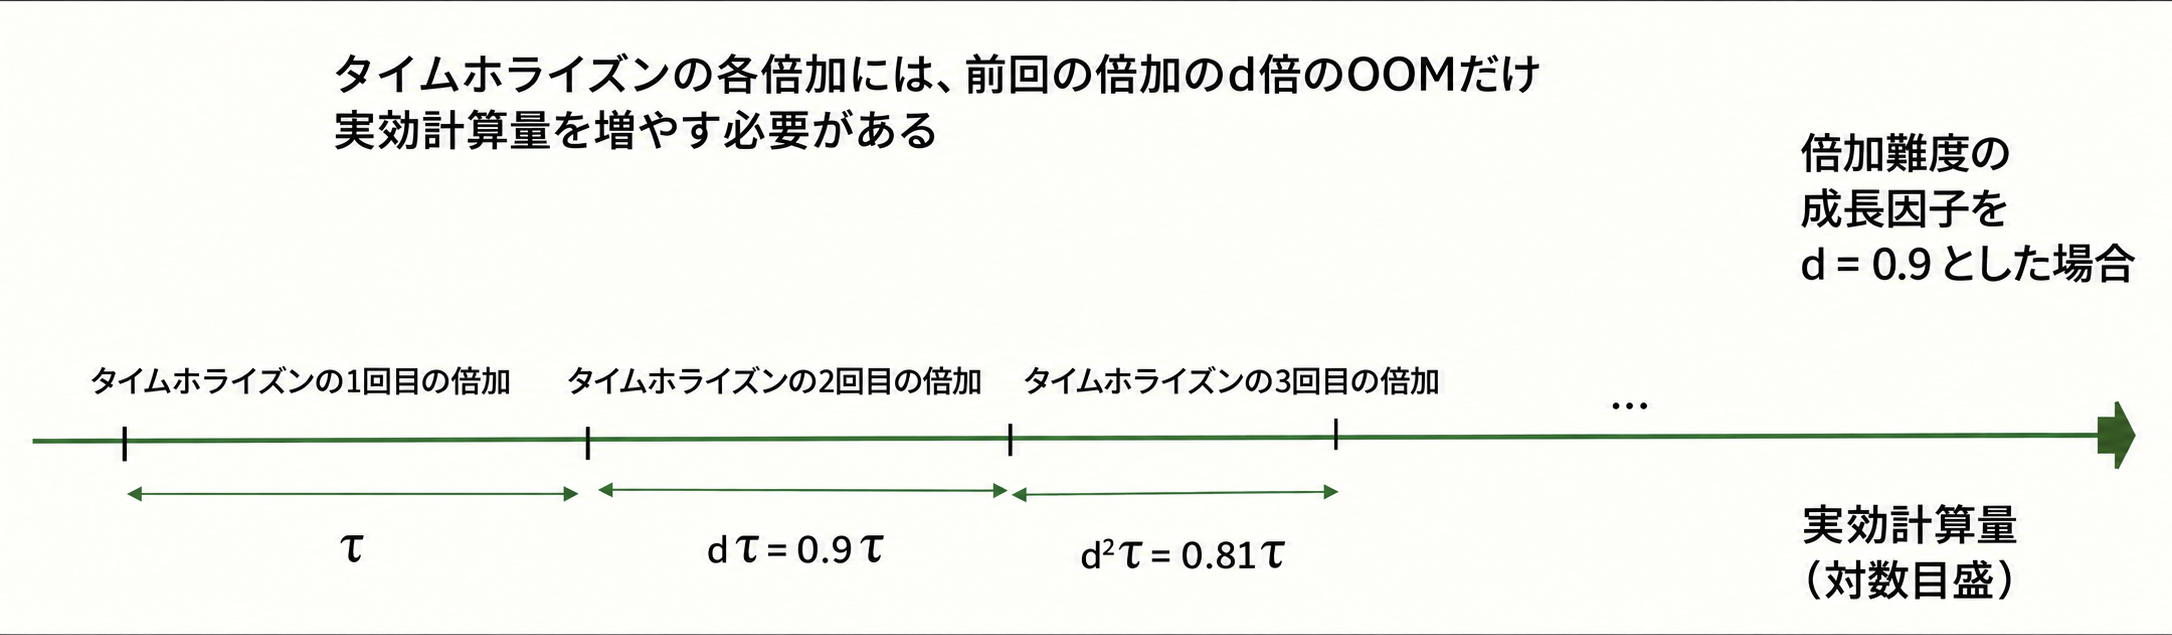
倍加難度の成長因子を加える。これは、タイムホライズンがに対して超指数関数的に伸びるか劣指数関数的に伸びるか(およびその程度)を決めるものである。タイムホライズンの各倍加には、前回の倍加の倍のlog(実効計算量)の増加が必要になる。(暦時間に対してタイムホライズンが(超/劣)指数関数的に伸びるかという問いを、log(実効計算量)に対してタイムホライズンが(超/劣)指数関数的に伸びるかという問いに置き換えている点に注意。)
- 3.
必要なタイムホライズンに達した後も、ACに到達するまでに必要となる実効計算量の「ギャップ」をオプションとして加える。これは、METR型の非常に長いベンチマークのコーディングタスクで成功することと、現実世界でコーディングを自動化することとの間の隔たりを表す。
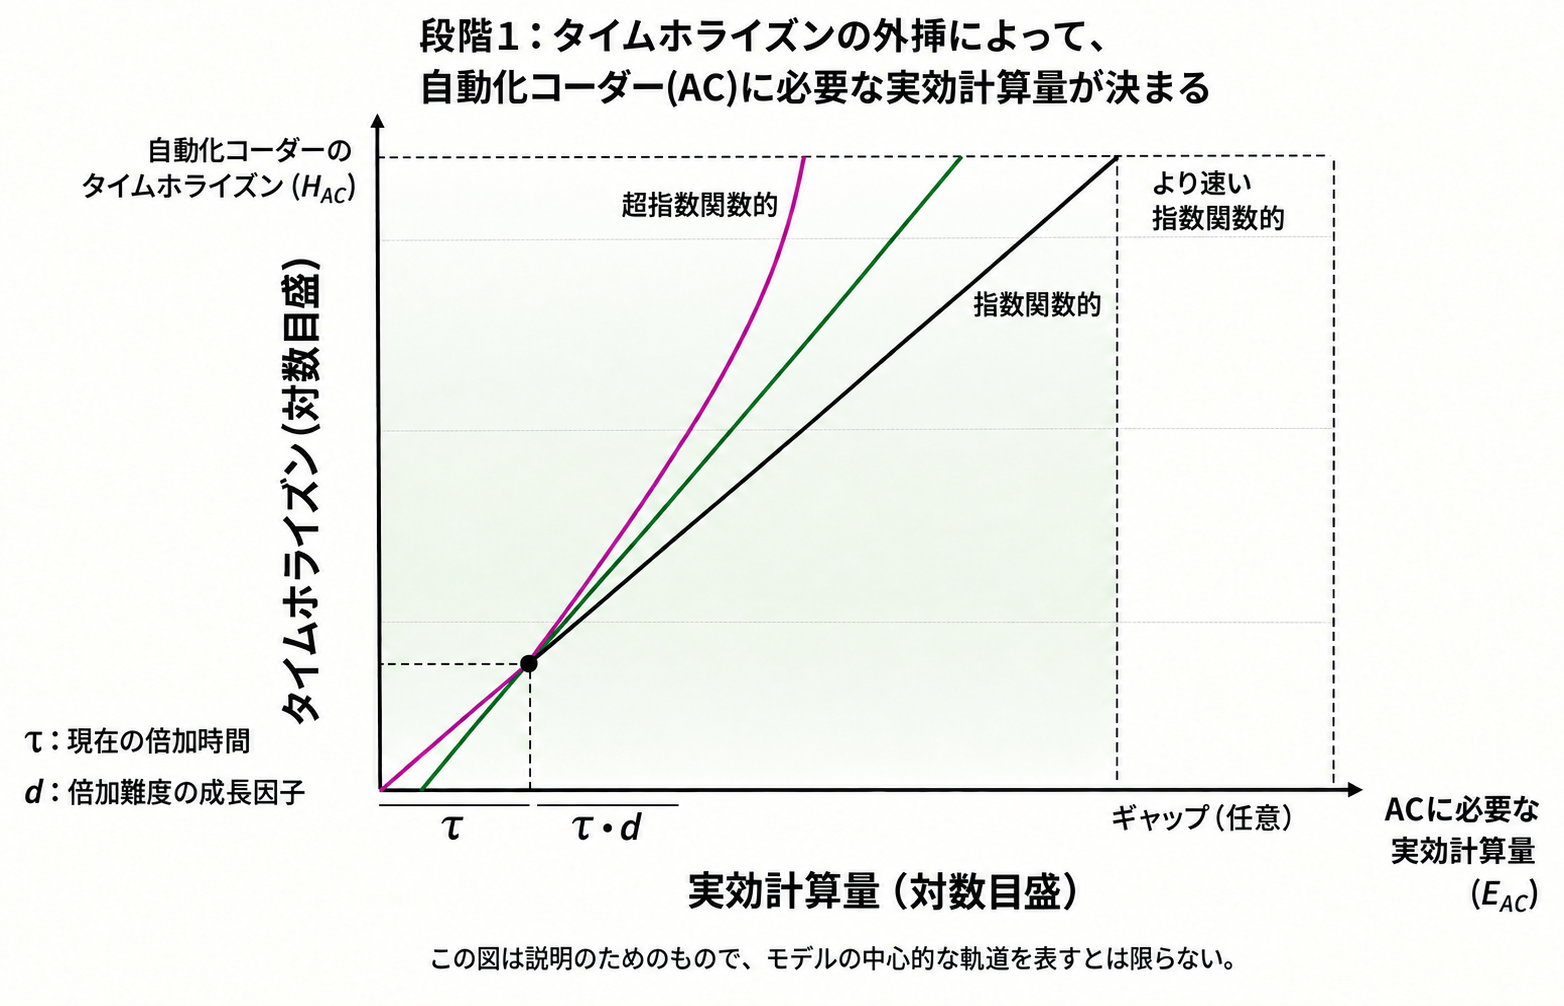
1.1 暦時間を実効計算量に置き換える
上で述べたように、タイムホライズンを暦時間の関数として直接考えることからは離れたい。暦時間のトレンドは我々の目的にとってメカニズムに即したものとは言えず、将来変化する可能性もあるからだ(たとえば、投資の限界によって訓練計算量の伸びが鈍る、AIがR&Dを手助けすることで新たな力学が生じる、など)。そこで代わりに、タイムホライズン(およびその他のAI能力)を、AIの進歩への投入量の変化を直接反映する実効計算量の関数として追跡することにした。定義上、実効計算量とは、時点のフロンティアモデルと同等の性能のモデルを、現在の訓練プロセスで訓練するのに必要となる訓練計算量である。これは、ソフトウェアの進歩(すなわち訓練計算量をより効率的に性能へ変換すること)を訓練計算量と同じ軸にまとめられる便利な指標だ。実効計算量を用いる動機とそのモデル化については、タイムホライズンと自動化コーダーのマイルストーンのモデル化を説明し終えた後で改めて取り上げる。
1.2 タイムホライズンの推移
METR-HRSのタイムホライズンと実効計算量は、いずれも過去5年間でおおむね指数関数的に増加した。したがって、log(実効計算量)とタイムホライズンの間には指数関数的な関係があると予想できるかもしれない。タイムホライズンを倍加させるのに必要な実効計算量の桁数(OOM)をと書く。(最初はタイムホライズンが時間の関数として指数関数的に伸びるという話をしたが、その議論は、タイムホライズンを実効計算量(の桁数)の関数として語る議論にそのまま置き換えられる。)直観的には次のようになる。
は主に、METR-HRSの過去のトレンドへのフィッティングによって設定し、長期的に観測されたトレンドと最近の上振れの可能性とのバランスをとる。
次に、先に挙げた単純な方法の2つ目の問題、すなわち単純な方法ではタイムホライズンがlog(実効計算量)の関数として指数関数的に伸び続けると仮定している点に取り組む。タイムホライズンが超指数関数的または劣指数関数的に伸びる可能性は、倍加難度の成長因子と呼ぶパラメータによってモデル化する。その考え方は、タイムホライズンの各倍加には、直前の倍加に要した量(実効計算量の桁数)の倍が必要になる、というものだ。したがって、は指数関数的な場合、は超指数関数的な場合、は劣指数関数的な場合に対応する。
我々の最善の推測では、タイムホライズンはlog(実効計算量)に対して超指数関数的に伸びるべきであり、したがってとなる。その主な理由は、AIが最終的にロングホライズンのエージェンシー(自律的に行動する能力)において人間を上回れば、そのタイムホライズンは無限大か極めて大きくなると予想しているからだ(次の展開ボックスを参照)。もしAIが有限の実効計算量の水準で無限のタイムホライズンを持つなら、(METRの著者ら自身が指摘しているように)少なくともlog(実効計算量)がその臨界水準に近づくにつれて、タイムホライズンは指数関数よりも速く伸びるはずである。log(実効計算量)がその臨界水準に近づくまでは成長がおおむね指数関数的であるということも考えられなくはないが、我々の最善の推測では、そこまで急激な相転移は起こらず、超指数関数性はもっと早い段階から目に見えてくる。
実際、我々の直観では、タイムホライズンをたとえば1000年から2000年に伸ばすほうが、1時間から2時間に伸ばすよりも容易なはずだ。AIが1000年のタイムホライズンを持つ頃には、おそらく2000年のタイムホライズンに到達するのに必要なロングホライズンのエージェンシーのスキル(長期的な計画、長いタスクの分解、誤りに気づいて修正することなど)の大半をすでに身につけているだろう。この直観的な議論は、本モデルで用いる「次の倍加は倍の容易さ」という超指数関数の関数形を選んだ動機にもなっている(超指数関数の選び方は先験的には多数ある)。今後のモデル化では、別の超指数関数の関数形を使う可能性もある。タイムホライズンの超指数関数的な成長についての詳しい議論は補足資料を参照。
AIが人間より優れたロングホライズンのエージェンシーのスキルを身につければ、そのタイムホライズンはおそらく無限大になる。
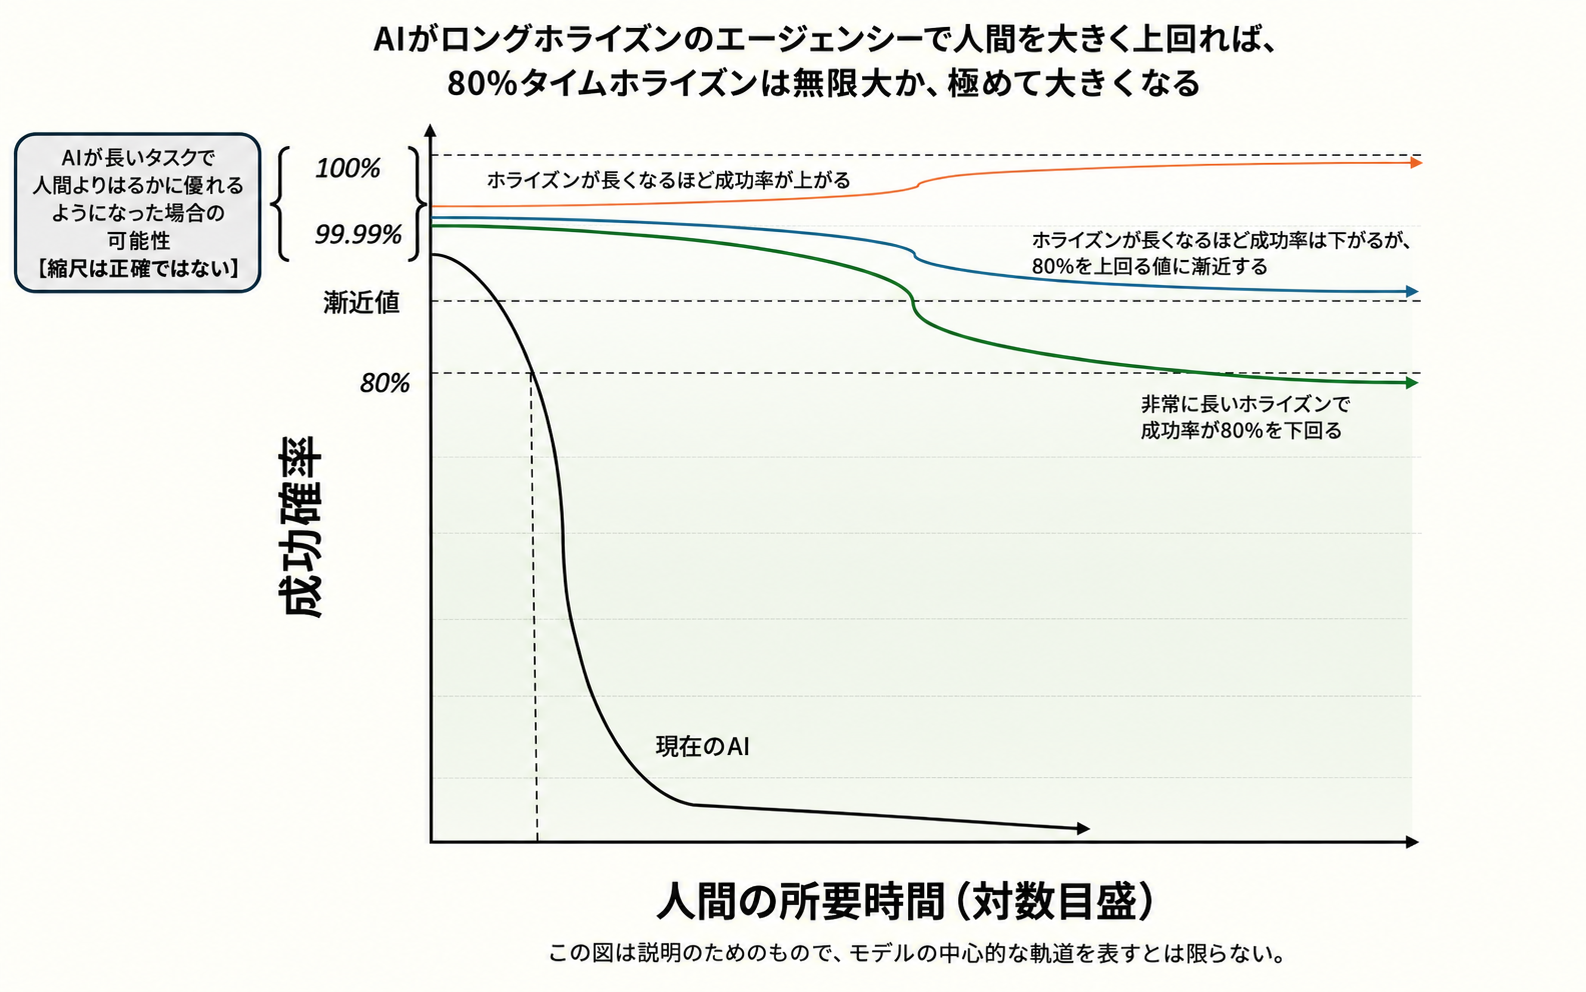
METR-HRS-Extendedの人間のベースライン作業者よりも優れたロングホライズンのエージェンシーのスキルを持つAIが得られたとしよう。タスクに対するAIの成功率を、人間のベースライン作業者がそのタスクを完了するのにかかる時間(「人間のタスク時間」)に対してプロットすると、どうなるだろうか。可能性は3つある。
- 1.
成功率が人間のタスク時間とともに上昇し、現在のAIに見られるトレンドとは逆になる。これは80%タイムホライズンが無限大であることに対応する。我々のタイムホライズンの定義では、AIは人間のベースライン作業者と同じ速さで、かつホライズンの長さに比例した量の自動化用計算資源でタスクを完了することが求められていた。この要件のため、AIにとっては、より長いホライズンのタスクのほうが「楽」になりうる。より多くの作業時間と実行用の計算資源が割り当てられるからだ。ある意味で、人間のスキルの分布と比べて、そのAIは短いホライズンのタスクよりも長いホライズンのタスクのほうが得意だということになる。
- 2.
成功率は人間のタスク時間とともに低下するが、80%を上回る値に漸近する。これは80%タイムホライズンが無限大であることに対応する。分析は項目1と同様だが、今度はAIが長いホライズンのタスクよりも短いホライズンのタスクで成功することが多い(長いタスクにより多くの作業時間と計算資源が割り当てられていたとしても)。とはいえ、どのタスクの長さにおいても、少なくとも80%の確率で人間を上回る。
- 3.
成功率が80%を下回るが、それは人間のタスク時間が極めて長い場合に限られる。これは有限の(ただし極めて大きい)80%タイムホライズンに対応する。
人間を基準としたタイムホライズンの概念のもとでは、(1)と(2)のほうが(3)よりもかなり可能性が高いと考えているが、(3)も無視できない可能性だと考えている。
タイムホライズンの成長が超指数関数的な場合の、無限のタイムホライズンへの到達
、すなわち本モデルでタイムホライズンの成長が超指数関数的である場合、次のときにタイムホライズンは無限大になる。
先に述べたように、無限のタイムホライズンとは、AIがロングホライズンのエージェンシーにおいて人間のベースライン作業者より有能であることを意味するのであって、知能の限界に達したことを意味するわけではない。
倍加難度の成長因子パラメータはどう設定するのか?
イーライによる倍加難度の成長因子の中央値は0.92である。これは主にエージェンシーのスキルの汎化についての直観に基づき、副次的に、この関数が過去のタイムホライズン、特にGPT-3.5以降のものを妥当に後ろ向きに再現する(バックキャストする)ことを条件として課して決めた。イーライののサンプリング分布は、80%信頼区間がである。詳しい議論はこちらを参照。
超指数関数的・劣指数関数的な場合を含む、タイムホライズンの明示的な式
から始めて、タイムホライズンの1回目の倍加にはがだけ、2回目の倍加にはだけ、3回目の倍加にはだけ増加する必要があり、以下同様に続く。がまだ無限大になっていない限り(これはの場合にいずれ起こる)、の明示的な式を計算できる。
1.3 自動化コーダーに対応する実効計算量の設定
タイムホライズンが実効計算量の関数としてどう推移するかを定義したので、次にこれを、自動化コーダーに到達するのに必要な実効計算量に換算する必要がある。
まず、ACの達成に必要なタイムホライズンを設定する。ACのタイムホライズン要件は、AI企業のプログラマーが行うタスクのタイムホライズンを推定し、我々のタイムホライズンがの成功率しか要求しないことを踏まえて上方修正し、さらにタイムホライズンのベンチマークと現実世界のコーディングタスクとの違いを踏まえて再び上方修正することで設定する。詳しい議論はこちらを参照。イーライの中央値(本サイトの既定値)は125人年、ダニエルの中央値は3人年であり、人によって直観はかなり異なる。このパラメータには、ぜひご自身の値を試してみてほしい。
最後に、本モデルには任意で「実効計算量ギャップ」を加えられるようにしている。これは、ACのタイムホライズン要件が達成された時点よりも、自動化コーダーのマイルストーンが遅れてやって来る可能性を表すものだ(たとえば、AIがMETR-HRS-extendedを飽和させても、現実世界のコーディングタスクでは人間を完全には置き換えられず、しかもそのずれが必要タイムホライズンの調整では補正できない、ということがありうる)。
(任意の)実効計算量ギャップを含む、自動化コーダーの実効計算量要件の明示的な式
2 実効計算量のモデル化
本モデルでは、人間の労働、自動化された労働、訓練計算量、実験用計算資源、自動化用計算資源といった投入を考慮する。これらの投入をすべて何らかの方法で集約し、具体的な能力へと対応づける必要がある。近年のAIの進歩は、モデルの訓練に使う計算量のスケールアップによってかなりの部分が牽引されてきたことから、我々はこれらの投入を実効計算量へと集約することにした。実効計算量とは、ソフトウェアの進歩、つまり訓練計算量をより効率よく性能へ変換できるようになることを、訓練計算量と同じ軸にまとめて表す指標である。そのうえで、自動化コーダーの実効計算量、コーディングの自動化、研究センスの自動化で説明するように、具体的な能力を実効計算量の関数としてモデル化する。
より正確には、実効計算量とは、時刻のフロンティアモデルと同等の性能のモデルを、現時点の訓練プロセスで訓練するのに必要となる訓練計算量のことである。実効計算量は、訓練計算量とソフトウェア効率の積として表す。
ソフトウェア効率は、時刻の訓練プロセスがどれだけ計算効率がよいかを測る。定義によりである。そしてであれば、次のことを意味する。2027年6月時点で最良のモデルと同等の性能のモデルを現時点の訓練プロセスで訓練しようとすると、2027年6月の場合より多くの計算量が必要になる。基準を2025年2月にしているのは、その時期にGrok 3がリリースされ、その訓練に使われた計算量が他のLLMよりも確度高くわかっているからである。
実効計算量を用いることの限界
実効計算量は、AIの進歩への投入を単一の性能指標に集約する方法として、現時点で我々が知る最善のものだ。これは、より多くの計算量がより高い性能へと変換されてきた過去10年のスケーリングのトレンドを捉えようとするものである。しかし、少なくとも文字どおりに受け取るなら、そこには重要な仮定が組み込まれている。とりわけ、現在のAIの訓練プロセスに近いものが非常に高い能力までスケールしうるという仮定だ。
この仮定が成り立たなくても、本モデルにはなお価値があると考えている。ある固定した日付の訓練プロセスをもっと柔軟に参照する形で実効計算量を定義することもでき(たとえば、大規模な計算量の拡大をうまく活用できるよう、訓練プロセスへのある程度の調整や計算資源の配分の変更を認めるなど)、それでも似たような振る舞いになるかもしれないからだ。とはいえ、この仮定がなければ実効計算量の値を解釈するのは確かに難しくなり、そのせいで本モデルの結果が的外れになっている可能性もある。今後のモデルの改訂では、中核となる能力指標をEpoch能力指数(ECI)のようなものに切り替えるかもしれない。そのほうがパラダイムシフトに対して頑健でありうる。
実効計算量の仮定(計算量をスケールアップすれば、いくらでも高い能力が得られるという仮定)をあまり心配しなくてよいかもしれない理由がもう一つある。本モデルにおけるAIの進歩は、主に計算量の増加ではなくソフトウェアの改善からもたらされるという点だ。そのため、訓練プロセスを固定したまま計算量だけを大幅にスケールさせるという状況は、実際にはほとんど生じない。本モデルの実際の振る舞いからすれば、むしろ、訓練計算量を増やさずにソフトウェアだけで大きな進歩が得られるという仮定のほうを心配すべきかもしれない。
ソフトウェア効率の推移に関する本モデルは、実験スループットと(ソフトウェア)研究努力という変数に依存する。説明をわかりやすくするため、まずこれらと、そのモデル化の方法を論じる。研究努力の増加がソフトウェア効率の向上へどう変換されるかは、ソフトウェア効率で説明する。その前に、本モデルが用いる計算量のデータについて少し補足しておく。
2.1 計算量の予測
本モデルでは3種類の計算量を追跡する。
- 1.
訓練計算量: 実効計算量への直接の投入。
- 2.
実験用計算資源: ソフトウェア効率への投入。
- 3.
自動化用計算資源: コーディングの自動化への投入。
これらの計算量のトレンドは外生的な時系列としてモデル化している。つまり、モデル内で起きている他の事柄の影響を受けない。これは、ハードウェアR&Dの自動化、ハードウェア生産の自動化、経済成長をモデル化していないということであり、本モデルの重大な限界である。特に遅いテイクオフのシナリオではそれが大きい。
計算量の成長は、まず首位のAI企業がどれだけの計算資源を持つかを推定し、次にそのうち何%を訓練・実験・自動化のそれぞれに使っているかを決めることで予測する。首位のAI企業の計算資源については、2030年までに成長率が2倍鈍化し、その後もさらに鈍化すると予測している。これは投資とファブ(半導体製造工場)の生産能力による制約のためである。計算量の予測の詳細については補足資料を参照されたい。
2.2 実験スループット
実験スループットは、AIプロジェクトが実験を実装・実行する能力を表す。おおまかには、プロジェクトが単位時間あたりに実装・実行できる実験の数と理解できる。ただし各実験は、使用する計算量と、コーディングにかかる労力の大きさによって重み付けされる。
実験スループットは、実験用計算資源(つまり研究用の実験の実行に使うH100換算の数)とコーディング労働(つまりフルタイムの人間に換算したコーダーの数)の関数としてモデル化する。実験スループットは実験用計算資源とコーディング労働のどちらが増えても上がるが、一方の投入だけを増やして他方を増やさない場合には収穫逓減が生じる。この関係をモデル化する一つの方法は、コブ・ダグラス関数(ただしかつ)を使うことだ。この関数には、との一方が他方よりずっと大きくなると、の増加は主に小さいほうの投入からもたらされる、という性質がある。大きいほうの投入には収穫逓減が働くからである。
コブ・ダグラス関数の問題の一つは、との一方が無限大に向かい、もう一方が有界のままでも、実験スループットが無限大に発散しうることで、これは現実的ではない。コーディング労働が無限にあっても実験用計算資源が一定量しかなければ、単位時間あたりに実装できる実験の数には限りがある。逆に、実験用計算資源が無限にあってもコーダーの数が一定なら、その計算資源をすべて有益に使う実験を実装するにはコーダーが足りない。(厳密には、実験用計算資源が無限にあれば、ありうるすべてのAI設計の空間を探索できるが、それには時間がかかるので無限の高速化にはならない。そもそも我々はそのような領域にいない。)経済学の用語で言えば、実験用計算資源とコーディング労働は、互いを完全には代替できない補完的な投入である。これはしばしば、代替パラメータを持つCES(「代替の弾力性一定」)生産関数でモデル化され、我々もこの方法をとる。数学的な詳細は、以下の展開ボックスを参照してほしい。
詳細
実験スループットは次のCES生産関数で与えられる。
ここで
とは何か? の代わりにそれより小さい量を使うのは、が並列的なコーディング労働の尺度であるのに対し、我々が必要とするのは逐次的なコーディング労働の尺度だからである(「互いの足を踏む」効果により、1人のプログラマーが2日で進められる量は、2人のプログラマーのチームが1日で進められる量より多い)。CES関数で並列ではなく逐次のコーディング労働を使う理由は、プロジェクトに実験用計算資源が無制限にある場合、実験スループットを倍にする方法は、コーディング人員の規模を倍にすることではなく、コーディング人員に2倍の時間働いてもらう(あるいはコーディング人員を高速化する)ことだからである。は、並列労働の増加が研究努力に与える影響についての我々の直観と、フロンティアAI研究者へのインタビューに基づいて推定した。既定値はで、これはコーディング人員を高速化すること(つまり逐次的なコーディング人員を倍にすること)が、コーダーの数をに増やすこと(つまり並列的なコーディング人員をに増やすこと)に相当することを意味する。
とは何か? がに近いほど、コーディング労働に比べて実験用計算資源が重要とみなされる。
とは何か? が小さいほど、との一方だけを増やしてを増やすことは難しくなる。CESの式には次の性質がある。を固定してを無限大にすると、はに漸近する。またを固定してを無限大にすると、はに漸近する。簡単に言えば、が小さいほど、実験用計算資源かコーディング労働の一方を無限大に増やして得られる押し上げの最大値は小さくなる。
とは何か? 現在の関数形で妥当な結果を得るには、実験用計算資源を指数で割り引く必要がある。これは少し奇妙に思える。コーディング労働が無制限にあるなら、実験用計算資源を倍にすれば、実行できる実験の数も倍になりそうだからだ。これを理解する方法を二つ挙げる。
- 1.
コーディング労働が無制限にある状況で実験スループットを倍にすることは、チップの(並列的な)数を倍にすることではなく、チップの逐次的な速度を倍にすることに相当するのかもしれない。
- 2.
モデルのサイズが大きくなるにつれ、フロンティアに近いサイズのモデルで実験を行うのに必要な計算量も増えていく。
デイヴィッドソンも、自身のFull Takeoff Model (FTM)で実験用計算資源を指数で割り引いている。彼のモデル解説の「production box」を参照。
の値の設定: 現時点を固定した出発点として三つの量を推定し、それらをあわせて、、の値を決めた。具体的には次の三つである。
- 1.
が小さかったら、はどれだけ小さくなるか。
- 2.
を無限大にしたとき、は何に漸近するか。
- 3.
を無限大にしたとき、は何に漸近するか。
これらの量を推定するために、フロンティアAI研究者へのインタビュー、他のAI専門家へのアンケート調査、そしてコーディング労働や計算資源が無限にある場合にがどう変わるかについての我々自身の推論を組み合わせた。既定値は、、である。詳しくはこちらを参照。
2.3 研究努力とAI R&D加速倍率
研究努力とは、プロジェクトが単位時間あたりに実行できる、質で調整した実験の数である。つまり実験スループットの一種だが、より腕のよい研究者が提案した実験ほど大きく重み付けされる(実験スループットでは、実験は必要な実験用計算資源の量と、実装に必要なコーディング労働の量によってのみ重み付けされていた)。
研究努力は、実験スループットと総合的な研究センスの積としてモデル化する。
直観的には、は実験1件あたりの平均的な価値を測るものだ。たとえば研究者Aの研究センスが研究者Bのであれば、Aが提案した実験1件は、Bが提案した実験2件と同じだけの価値があることを意味する(ただし、この3件の実験はいずれも計算量とコーディング労働が同等だとする)。研究センスの算出方法は総合的な研究センスを参照。
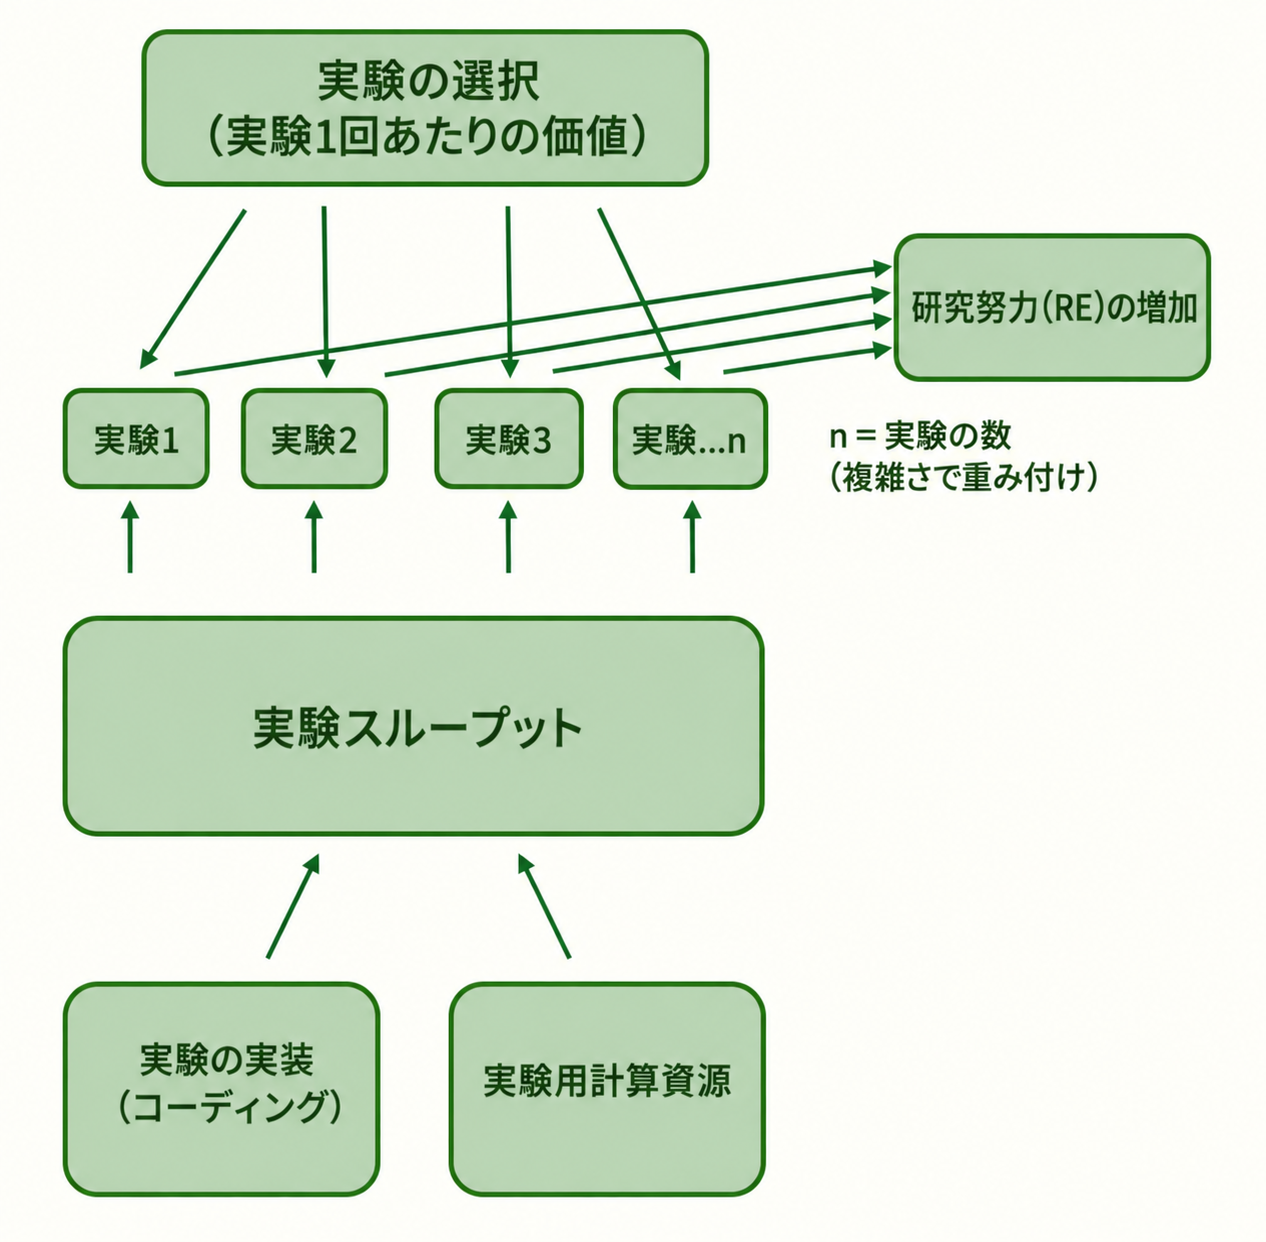
研究努力に関連して、各時刻についてAIソフトウェアR&D加速倍率(uplift)を追跡する(我々の以前の研究では「AIソフトウェアR&D進歩倍率」と呼んでいたもの)。この概念は名前のとおりのもので、「AIがない場合と比べて、AIがあるとR&Dがどれだけ速く進むか」を測る。時刻のAIを魔法のように現時点へ連れ戻した場合に、現時点で得られる研究努力をと書く。すると
AIソフトウェアR&D加速倍率の定義では、現時点へ連れ戻すのはAIだけであり、時刻に利用可能になる追加の実験用・自動化用計算資源や追加の人間の労働は連れ戻さないことに注意してほしい。
2.4 ソフトウェア効率
思い出してほしいが、ソフトウェア効率は、時刻の訓練プロセスが訓練計算量をどれだけ効率よく性能へ変換できるかを測るものだった。であり、であれば次のことを意味する。2027年6月時点で最良のモデルと同等の性能のモデルを2025年2月の訓練プロセスで訓練しようとすると、2027年6月の場合より多くの計算量が必要になる。
知りたいのは、研究努力が変化するにつれてがどう変化するかである。ただし厳密に言えば、は(「いまどれだけの研究が行われているか」の尺度)の関数ではなく、これまでに累積で行われた仕事の総量の関数である。そこで研究ストックを次のように定義する。
つまり研究ストックと研究努力の関係は、移動距離と速度の関係に等しい。(記号で書けば。)
研究ストックとソフトウェア効率はどちらも、AIプロジェクトが「どこまで来たか」を表すが、研究ストックは(研究努力と同様に)努力・投資についての量であるのに対し、ソフトウェア効率は成果・リターンについての量である。知りたいのは両者の関係だ。
過去の実証データを見ると、は時間とともに指数関数的に成長してきた。一方、研究努力と研究ストックも指数関数的に成長しているはずである。過去10年間、実験用計算資源とAIソフトウェアR&D労働はいずれも指数関数的に成長してきたからだ。したがって、とはどちらも時間とともに(異なる底で)指数関数的に成長するので、両者の関係はべき乗則でモデル化するのが最も適切である。
| (1) |
直観的には:
パラメータはどう設定するのか?
は直接推定するのではなく、他のパラメータに基づいて設定する。要するに、2024年のソフトウェア進歩の速度がユーザー指定のパラメータに一致するようにを設定する。
は次のように設定する:
- 1.
2024年のソフトウェア効率の成長率を仮定する(2024年のソフトウェア効率の成長率の設定方法について詳しくはこちらを参照)。
- 2.
開始年(2012年)から2024年までの間、AIエージェントはエンジニアリング労働にも研究センスにも加速をもたらしていなかったと仮定する(現在ではなく2024年を用いたのはこのためである)。
こうすると研究努力は時間だけの関数になる。外生的な計算資源と労働の投入量の値を調べ、それを生産関数に代入すればよい。ここから、2024年における研究ストック(累積研究努力)の成長率を計算できる。
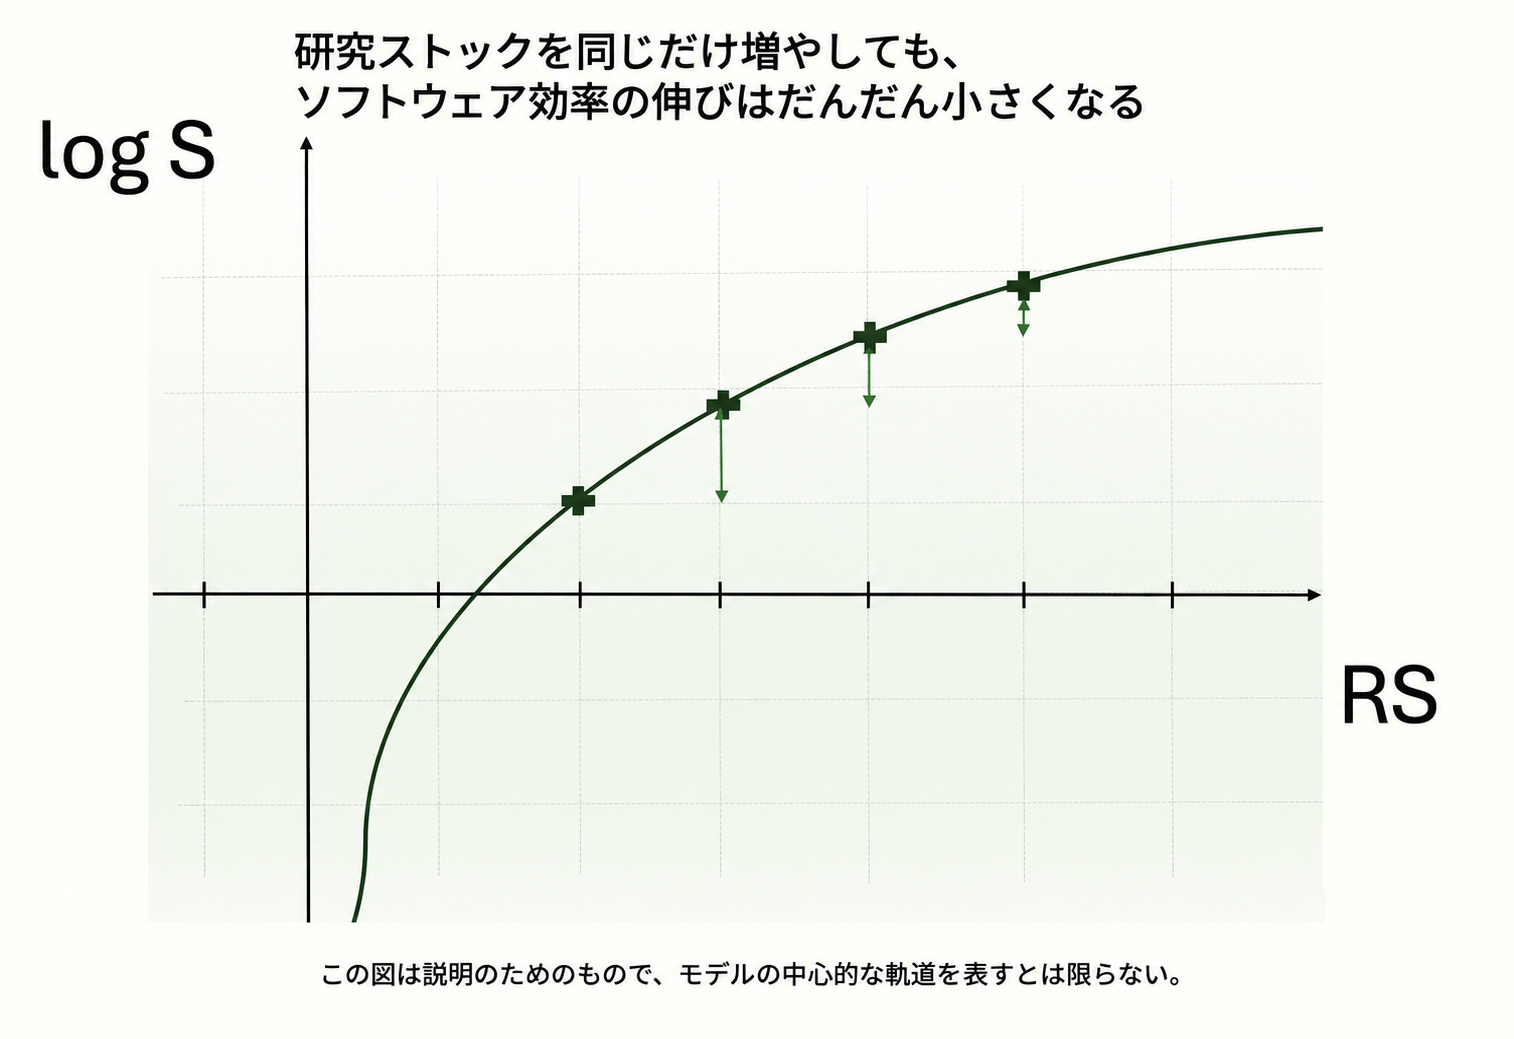
本モデルは収穫逓減を捉えている。
AIの能力は、ソフトウェア効率と訓練計算量の組み合わせから生まれる。訓練計算量は指数関数的に伸びてきたので、がそれに「ついていき」、意味を失わないためには、こちらも指数関数的に伸びる必要がある。したがって、研究努力に対する収穫は(つまりの桁数)の観点から語るのが自然である。次の式より
を同じ大きさずつ増やしていっても、それによるの増分は時間とともにどんどん小さくなる。これが「収穫逓減」という現象である。すでに進歩が進んでいるほど、低いところにある果実は摘み取られてしまっているため、インパクトのある新発見をするのが難しくなる。
Jonesの半内生的成長モデルとの関係
Jones 1995は、アイデアの生産をモデル化するために次の成長則を用いている:
ここではアイデアのストック、はアイデアの生産に従事する研究者の数である。パラメータは研究者を追加することによる「互いの足を踏む」効果を制御し、は「釣り尽くし」効果の強さを表す。この効果によって、ストックが増えるにつれてアイデアはだんだん見つけにくくなる。
過去のAGIテイクオフモデル(例: デイヴィッドソンのFTMモデルやEpochのGATEモデル)では、アイデアのストックをソフトウェア効率で置き換えていた。これまで提案されたモデルはすべて、次の形をとっていた
(研究努力の定義はさまざまである)。
この成長則が、上で示した我々の式に帰着することを示す。まず:
| 右辺の積分は、置換、によって計算できる: | ||||
| について解くと、 | ||||
3 コーディングの自動化
次に、本モデルがAIの研究開発能力をどう設定し、それがソフトウェア研究努力への投入にどう影響するかを説明する。
3.1 コーディング自動化率
コーディングは、タスクの種類からなる安定した集合としてかなりうまく記述でき、一部のタスクは他のタスクよりはるかに早く自動化可能になる(あるいはすでになっている)と我々は考えている。コーディング自動化率を、(フロンティアAI研究に関わる)コーディング作業のうち効率的に自動化できる割合と定義する。たとえばは、2029年3月のAIを使えば、現在行われているコーディング作業のを生産性を落とさずに自動化できることを意味する(このは、その作業に従事するクローン同等コーダーの割合で測ったもの。下の展開ボックスを参照)。
タスクが効率的に自動化可能とみなされるのはどんなときか?
「クローン同等コーダー」を、すべての人間のコーダーをクローン同等コーダーに置き換えても生産性が変わらない、という条件で定義する。各種類のコーディングタスクについて、AIの支援がない場合にそのタスクに従事するクローン同等コーダーの数で、その重要度を重み付けする。AIが人間のコーダーより速く、かつ現在の自動化用計算資源の以下を使ってタスクを完了できるとき、そのタスクは効率的に自動化可能とみなす。ここでは現在そのタスクに従事している人間のクローン同等コーダー換算の人数、は現在の人間のコーダーの総数である。
我々の自動化コーダーのマイルストーンの定義は、厳密には、マイルストーン到達時点でとなることを意味しない。それでも、そうなるという単純化の仮定を置く。
ACの定義が文字どおりにはすべてのタスクが効率的に自動化可能であることを意味しないのはなぜか?
自動化コーダー(AC)のマイルストーンは、ACを現在に持ち込んだとき、AIの支援を受けない現在の人間のコーダー全員と全体として同じだけの生産性を発揮する、という条件で定義されていた。これは、一部の割合のタスクについてはACがまだ人間より効率が低い場合でも成り立ちうる。
コーディング自動化率を、実効計算量のOOM(桁数)のS字型ロジスティック関数としてモデル化する。すなわち、現時点の自動化率を推定し、をの関数としてロジスティックに変化させ、が自動化コーダーのアンカーの実効計算量に等しくなったときにが1に達するようにする。(ロジスティック関数が実際に1に到達するように、ロジスティックの右側の漸近線を1より大きく取り、コーディング自動化率が1に達した時点で打ち切る。)
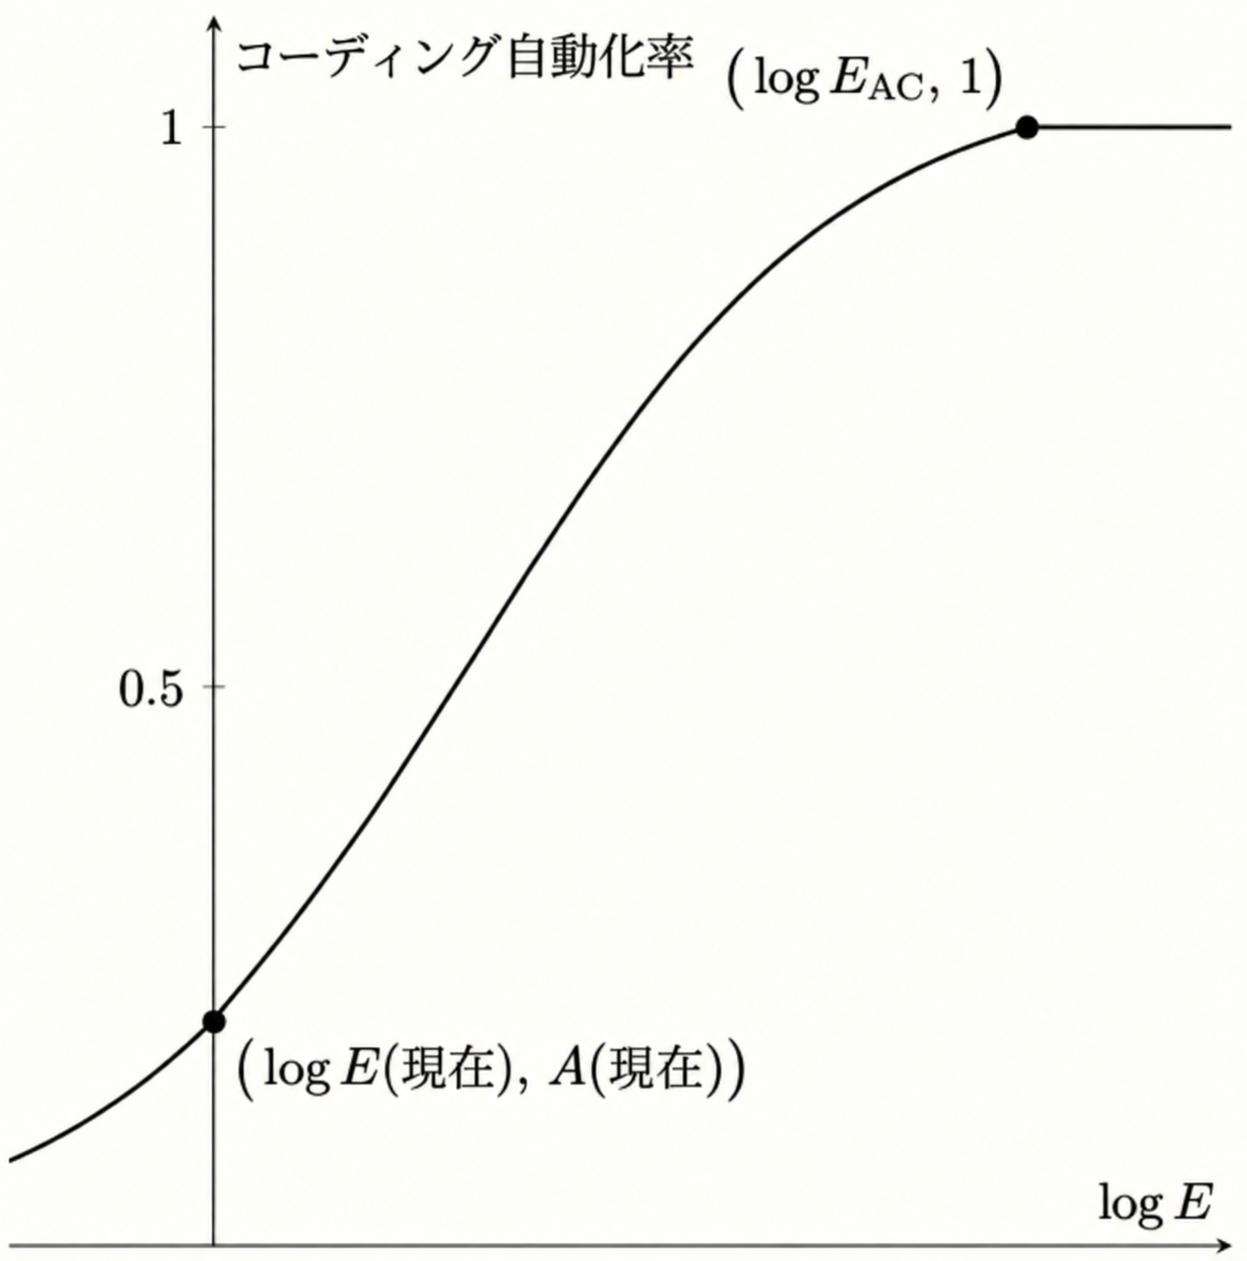
現在のコーディング自動化率は、現在のコーディング加速倍率についてのモデルの予測が、AGI企業の人々を対象とした調査結果と一致するように設定する。AGI企業における現在のAIのコーディング加速倍率について、我々の中央値は、AIがあることはソフトウェアエンジニアが1.8倍いること(およびその人たちを効果的に取りまとめるのに必要なスタッフ全員がいること)に相当する、というものである。これらのコーディング加速倍率の調査について詳しくはこちらを参照。
3.2 コーディング自動化効率
研究実験の実装に関わるさまざまなコーディングタスクを、区間内の添字で表す。任意の時点において、を満たすタスクは効率的に自動化可能とみなし、を満たすタスクはそうでないとみなす。
各タスクについて、コーディング自動化効率は、自動化用計算資源の単位(つまりH100換算)と、それに相当する人間のコーダーとの換算率である。言い換えると、がタスクに割り当てられた計算量だとすれば、それは人の人間のコーダーを追加でタスクに従事させることに相当する。したがっては、タスクにおけるAIの実行時の効率の尺度である。効率の向上は、AIの高速化、より多くのAIを走らせられるようになること、そしてより少ない行動でタスクを完了できるより有能なAIの獲得、の組み合わせから生じる。
タスクが初めて効率的に自動化可能になる時点に対応する実効計算量をと書くと、についての我々のモデルは次のとおりである:
ここではタスクが初めて自動化可能になった時点の初期効率を表すパラメータ、はその後、自動化されたコーダーの効率がどれだけ速く向上し続けるかを制御するパラメータである。これは直観的には次のように理解できる:
コーディングタスクが効率的に自動化可能になる時点についての我々の定義により、初期の換算率は、現在における人間のコーダーの総数と自動化用計算資源の量との比である。
この自動化効率のモデルは、実効計算量と効率の関係が効率の水準によらず一定であるという単純化の仮定を置いているが、これは厳密には正しくない。しかし、これを変えても結果に大きな影響はないと考えている。(本モデルは、固定された自動化用計算資源の予算で達成できるコーディング自動化効率に上限も課している。とはいえ、これはモデルの出力にはほとんど影響しない。こうした上限に達するずっと前に、AGIプロジェクトの実験実行能力はコーディング労働ではなく実験用計算資源によって律速されるようになるからである。)
コーディング自動化効率の傾きパラメータは、AIの推論コストと速度がどれだけ速く改善してきたかについてのデータを調べて推定した。詳しくはこちらを参照。
3.3 総コーディング労働
次に、向上していくAIのコーディング能力が総コーディング労働にどうフィードバックし、それが実験スループットにどう影響するかを論じる。思い出してほしいが、実験スループット(つまり、プロジェクトが実験を実装・実行する能力)はコーディング労働と実験用計算資源の関数であり、コーディング労働は「フルタイムの人間換算の人数」と説明していた。には人間のコーディング労働とAIのコーディング労働の両方を反映させたいので、これを「総コーディング労働」と呼ぶことにする。人間のコーダーの数をと書く(は、AGI企業の研究者・エンジニアの人員増加に関する過去のデータを外挿して設定する外生的な時系列である。詳しくはこちら)。
AI実験の実装に関わるさまざまなコーディングタスクを、区間内の添字で表すのだった。タスクに割り当てられる人間のコーディング労働とAIのコーディング労働の量を、それぞれとと書く。タスクの総コーディング労働は次のとおりである
はタスクにおける自動化用計算資源の単位と人間のコーダーとの換算率だからである。
AIが一部のコーディングタスクを安価に自動化し、他のタスクは自動化しない場合、コーディング労働にはどんな影響があるだろうか? それは、自動化可能なタスクで自動化不可能なタスクをどれだけ代替できるかによる。しかし、たとえばタスクの90%でが無限大になったとしても、が無限大になるべきではない。その場合、コーディングは残りの10%のタスクによって律速されるからである。我々はこれを、代替可能性の度合いを制御するパラメータを持つ、タスクベースのCES(「代替の弾力性一定」)生産関数でモデル化することにした。タスクベースのCES関数が現実をどれだけうまくモデル化するかについて確信はなく、既知の問題もある(たとえばこの論文を参照)が、この目的のために我々が知る限り最良の道具である。コーディングのワークフローをより細かくモデル化する研究があれば関心がある。
の明示的な式
とは何か? 代替パラメータが小さいほど、コーディングはコーディング労働の少ないタスクによって律速される。言い換えると、が0よりはるかに小さいことは、AI実験のコーディングが、常にこなさなければならないかなり硬直的なタスクの集合であることを意味し、が0に近いことは、自動化の難しいタスクを自動化しやすいタスクでより容易に代替できることを意味する。の設定方法について詳しくはこちらを参照。
本モデルのシミュレーションを実行する際には、各時間ステップで、総コーディング労働を最大化するように割り当てとを設定する(割り当ての合計が人間のコーディング労働の総量に等しく、割り当ての合計が自動化用計算資源の総量に等しいという制約のもとで)。これは、AIプロジェクトが人間とAIのコーディング人員を最も役立つところに割り当てることに相当する。より具体的には、人間のコーダーはまだ自動化を免れているタスクに再配置され、AIのコーダーは自分たちが効率的に自動化できるタスク(特に非常に速く自動化できるタスク)に割り当てられる。
4 研究センスの自動化
人間やAIの研究センスは、たとえば高レベルの研究方向の設定、低レベルの選択、実験の着想と解釈など、さまざまなものを包含することを意図している。本モデルでは、研究センスは基本的に、実験1回あたりに得られる価値として操作的に定義される。研究センスを2倍にすることは、実験スループットを2倍にすること(つまり、プロジェクトが単位時間あたりに実装できる実験の数を2倍にすること)と同じ効果を進歩にもたらす。
この節では、AIの研究センスが実効計算量とともにどう向上するか、また人間とAIの研究センスがどう組み合わさって総合的な研究センスになるかについての、本モデルの考え方を説明する。
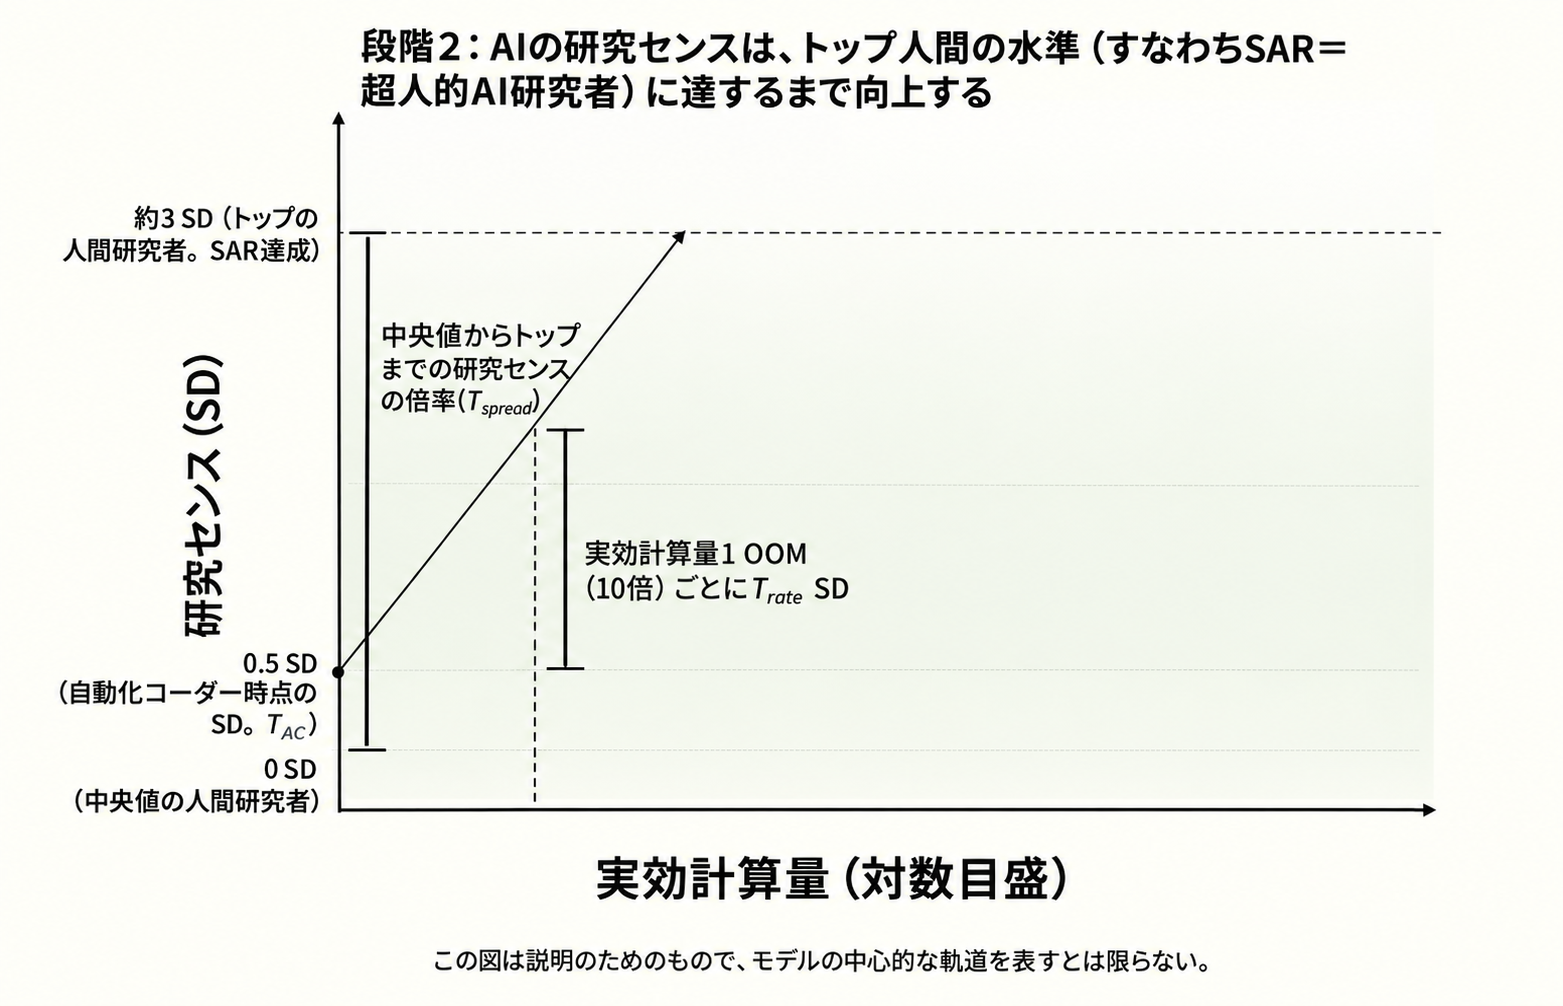
すでに述べたように、本モデルのうち現在から自動化コーダーのマイルストーンまでの第1段階は、主にMETRのタイムホライズンのトレンドの外挿(そして、指数関数・超指数関数・劣指数関数のどれで外挿するかの判断)によって決まる。自動化コーダーのマイルストーン到達後のモデルの挙動の第2段階は、主に、AIの研究センスが実効計算量とともにどれだけ速く向上するか、そして自動化コーダーのマイルストーン時点でのAIの初期の研究センスによって決まる。コーディングの完全な自動化(および高速化)も顕著な役割を果たすが、我々のモデルのシミュレーションに基づけば、AIの研究センスが向上する速度のほうが大きな要因である。直観的には、追加のコーディング労働が役立つ程度には限りがある。実験を実行する能力は、いずれ実験用計算資源によって律速されるからである。一方、自動化された実験選択がより巧みになることは、常に役に立つ。
4.1 人間の研究センス
自動化された研究センス(つまりAIの研究センス)の向上に話を進める前に、人間の研究センスについての本モデルの考え方を論じておく。(トップのAGI企業における)人間の研究者の研究センスの分布を、中央値1の対数正規分布でモデル化する(「対数正規」とは、が正規分布であることを意味する)。対数正規分布の分散を決めるため、まず、フロンティアAI研究者を対象とした調査を通じて、トップのAGI企業における現在トップの研究者の研究センスと、現在の中央値の研究者の研究センスとの比を推定した(これにより中央値が得られる。このトップ対中央値のセンスのパラメータの設定方法について詳しくはこちらを参照)。今日のAGI企業に人間の研究者が1000人いると仮定すると、ここから、対数正規分布を、のパーセンタイル値との中央値との比がになるように選ぶことになる。(のちに、のパーセンタイル値が、元になる正規分布の中央値から3標準偏差上に対応することを用いる。)
なぜ人間の研究センスに対数正規分布を用いるのか?
対数正規分布を選ぶのは、フロンティアAI研究者への調査や議論に基づくと、上位数パーセントの研究者が研究センスを通じて典型的な研究者よりはるかに大きな価値をもたらしている可能性が高いと思われるからである。さらに、科学論文の被引用数やスタートアップの成功など、類似する量はしばしば経験的に対数正規分布に従う。
4.2 自動化された研究センス
コーディング自動化率とコーディング自動化効率と同様に、自動化された研究センスは実効計算量の関数としてモデル化する。人間の研究センスは対数正規分布で表すのに対し、は各時点ごとに1つの数値である(人間の場合とは異なり、AIは単一の集合的な存在とみなしている)。
AIの研究センスは、それが人間の中央値より何標準偏差(人間の分布の元になる正規分布における標準偏差)上または下にあるかで表し、この量をと書く。が負ならAIの研究センスは人間の中央値を下回り、が正ならAIの研究センスは人間の中央値を上回ることを意味する。
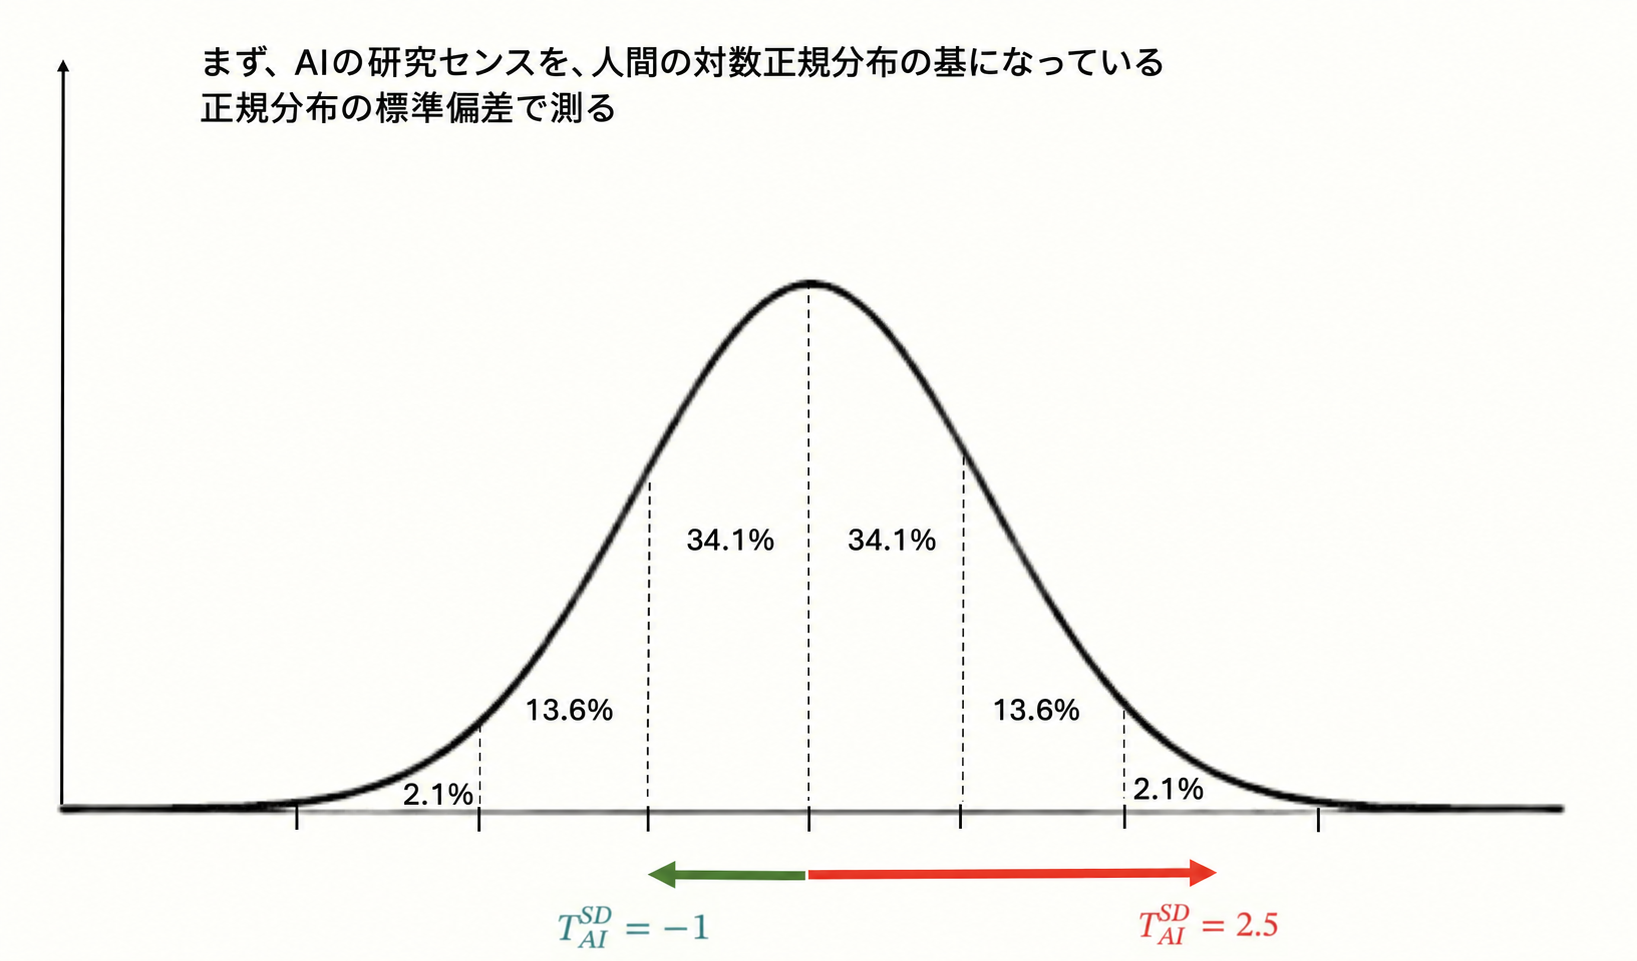
実効計算量が1 OOM(1桁)増えるごとに、AIの研究センスは標準偏差ずつ上昇すると仮定する:
| (2) |
ここでは自動化コーダーの研究センス(標準偏差単位)を表すパラメータ、は自動化コーダーに対応する実効計算量である(は、タイムホライズンと自動化コーダーのマイルストーンで説明したモデル部分によって決まる)。パラメータは、フロンティアAI研究者やAI専門家への調査に、直観に基づく小さな調整を加えて設定した。イーライの中央値は(ACが中央値の人間研究者よりわずかに優れていることを意味する)、ダニエルの中央値は(ACが中央値の人間研究者と同水準であることを意味する)である。詳しくはこちらを参照。
研究センスの傾きを設定するため、さまざまなタスクにおいてAIが人間の範囲をどれほどの速さで通過してきたかに関するデータを調べた。は、現在の実効計算量の成長率の関数として推定している。データ中のモデルについては、実効計算量よりもリリース日のほうが確信をもって評価できるからである。イーライとダニエルの中央値はそれぞれとである。の設定について詳しくはこちらを参照。
4.2.1 人間の範囲の近傍
AIの研究センスが人間の範囲の近くにある間は、AIの研究センス(ここでは標準偏差単位ではなく絶対単位)は、正規分布から対数正規分布へ変換し直すことで近似的に得られる。つまり、AIが人間の範囲の近くにあるときはであり、したがっての式(2)により、実効計算量が1 OOM増えるごとにAIの研究センスはおよそ倍になる。
4.2.2 アルゴリズム的限界を扱う、のより一般的なモデル
の実際のモデルはもう少し複雑である。研究センスがどこまで高くなりうるかの上限を組み込みたいからだ。そのため、当初はが1増えるごとにおよそ倍になるが、が非常に大きくなると最終的には頭打ちになる。また、上限に近づくにつれて研究センスの進歩の速度は急にではなく徐々に鈍化すべきだと考えている。
そこで、の代わりに、の関数としてののモデルとして一種の一般化ロジスティック関数を用いる。これを次のグラフに示す(橙色の点線については後で説明する):
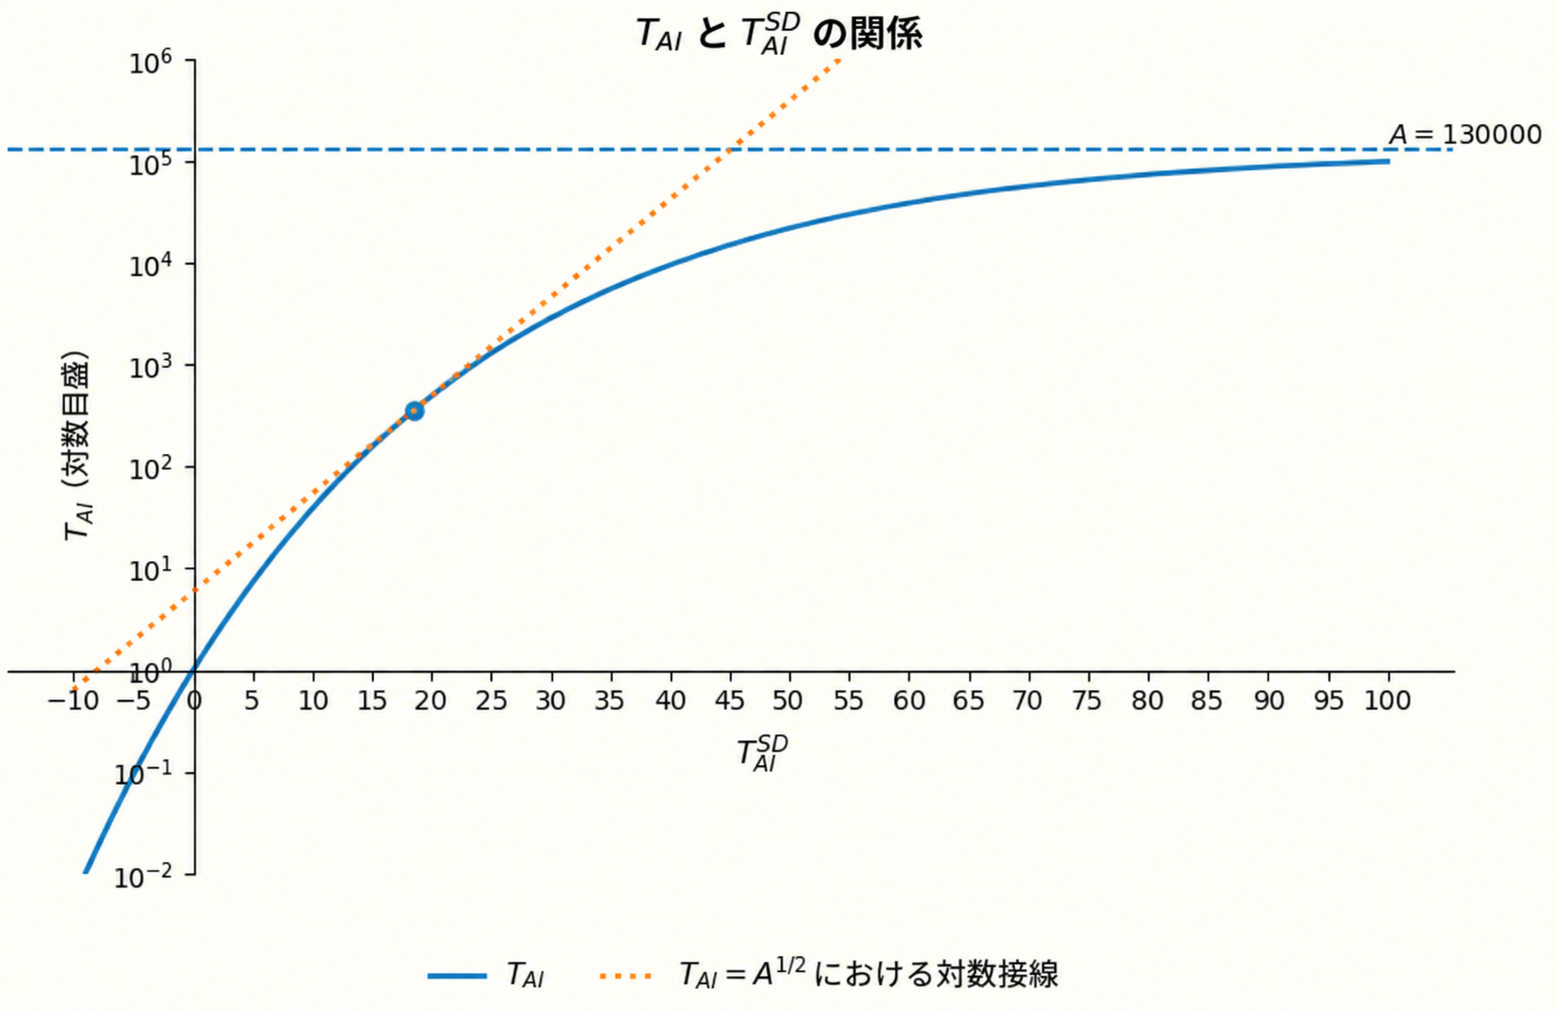
人間の範囲の近傍(すなわちが0に近いとき)では、はおよそに等しい。また、パラメータ(「アルゴリズム的限界までの中間点における研究センスの減速係数」と呼ぶ)があり、の関数としてが上限にどれだけ速く近づくかを制御する。は次のように解釈される:が対数空間で1との中間にある時点(すなわちのとき)において、を増やすとは倍になる(つまり、中間点における(対数スケールでの)成長率は人間の範囲にあったときの倍である)。が大きいほど橙色の点線は急になり、は限界により速く近づく。グラフではイーライの既定値とを用いている。
パラメータとの値の設定。
を設定するため、チェスや囲碁のAIが人間をどれほど超えているかについてのデータを調べ、これらの活動と機械学習研究との違いを踏まえて小さな調整を加えた。については、研究センスの限界が最良の人間を「トップ対中央値の人間の差」何個分上回る点に相当するか、という観点で考えた。イーライの中央値はトップ対中央値の差8個分で、となる。一方、ダニエルの中央値は16個分である。言うまでもなく、研究センスの限界については非常に大きな不確実性がある。さらなる議論はこちらを参照。
イーライは中央値を選んだ理由を次のように説明している:「を選んだのは、直観的におおよそ妥当と思えるうえ、AIの研究センスの最大値についての私の中央値と組み合わせると、私にとって妥当に思える挙動になるからだ。具体的には、SARASIのソフトウェアのみのテイクオフを約1.5〜3倍減速させ、テイクオフが速いほど減速幅が大きくなる。とはいえ、このパラメータの推定には確かな手がかりを得にくいと思われるので、不確実性は大きい。そこで、5パーセンタイルが、95パーセンタイルがのベータ分布を指定している。」
をの関数として表すことに関する数学的詳細。
のモデルは次のとおりである。
前述のとおり、は研究センスの上限である。パラメータ(正にも負にもなりうる)は先に述べたパラメータと関係しており、の上限にどれだけ速く到達するかを制御する。具体的には(下の導出を参照)、次が成り立つ。
| (3) |
最後に、
| (4) |
は、の近くでとなるように選ぶ(より正確には、においてとなるようにを選ぶ。下の導出を参照)。
、すなわちのとき、をより解釈しやすいロジスティック・シグモイドの形に変形できる:
| (5) |
ここで、、である。特に、この式から、が大きくなるとはに漸近することがわかる。、すなわちのときも式は正しいが、かつとなるため、やや奇妙になる。特にのとき、ではが定義されない。グラフ作成ツールで(すなわち)を変化させてみたところ、少なくとも本モデルにとって重要なの範囲では、対の曲線の形に重要な変化はなかった。どの曲線も、先に示した図の曲線とおおむね同じ形をしている。
以下の2つの導出は読み飛ばしてかまわない。
の式の導出:前述のとおり、においてとなるようにを選ぶ。次が成り立つ。
| (6) | ||||
をで評価すると次を得る:
したがって、この量をに等しくしたいなら、とすればよい。
の式の導出:を定義する性質は次のとおりである。
| (7) |
(6)とを用いると、次を得る。
ここで、この式のはとなる点を表す。分子は次のように書き換えられる。
以上をまとめると、条件は次のようになる。
言い換えれば
をとで表すように解くと、次を得る:
の解釈についての補足、およびSIAR、TED-AI、ASIの定義。
研究センスに上限を課しているため、人間の研究センスの分布は文字どおりの対数正規分布にはならない(対数正規分布は有界ではないため)。たとえば、人間の研究者人口を何桁も増やしたとしても、最良の人間研究者の研究センスは対数正規分布が予測するほど高くはならない。代わりに、人間の研究センスの分布を概念的にモデル化するにはを用いるほうがよいかもしれないと考えている。そうするととなる(を標準正規分布の累積分布関数として)。言い換えれば、対の図を見るとき、は、そのの値に対応するの値を求め、が標準正規分布がそのの値以下となる確率に等しいことに注目すれば得られる。
人間の研究センスの分布をこのようにモデル化したうえで、AIが(SD単位の)研究センスを持つことを、そのAIがパーセンタイル(すなわちパーセンタイル)の人間研究者と同等であることと解釈する。99.999999パーセンタイルの人間研究者を論じるのはやや奇妙である。現在の最良の人間研究者(研究者人口を1000人と仮定する本モデルにおいて)がすでに99.99パーセンタイルだからだ。したがって、99.999999パーセンタイルの人間研究者とは、人間の研究者人口を数桁増やした仮想的な状況を基準にしたものとなる。
のこの解釈は、SIAR(超知能AI研究者)を定義する際に用いる。SIARは、SIARとAGIプロジェクトのトップの人間研究者との差が、AGIプロジェクトのトップの人間研究者と中央値の研究者との差の2倍である、と定義した。トップ対中央値の人間の差は3標準偏差に相当するので、SIARの正確な定義は、単位の研究センスがであるAIとなる。したがって本モデルでは、これは絶対的な研究センスに対応し、パーセンタイルの人間研究者の研究センスに相当する(しかもである!)。繰り返すと、我々にとってSIARの水準は、何らかのより本質的な尺度ではなく、人間を基準として(具体的には、仮想的にはるかに大きな人間研究者集団においてSIARが研究センスの何パーセンタイルに相当するかによって)定義される。ASIの定義についても同様のことが言えるが、ASIはAI R&Dの研究センス以外の認知能力に関して定義される。詳しくはこちらを参照。
本モデルはAI R&D以外の認知能力を直接モデル化していないため、TED-AIとASIは、これらのマイルストーンに到達するのに最良の人間研究者を「トップ対中央値の人間の研究センスのSD差」何個分上回る必要があるかについての推測によって操作的に定義する。既定のパラメータでは次のとおり:
- •
SARはに対応する(すなわち、SARは最良の人間研究者、つまり中央値の研究者より3 SD上の研究者の研究センスを持つ)。
- •
SIARはに対応する(すなわち、SIARに到達するにはSARからトップ対中央値の人間の差2個分上回る必要がある)。
- •
TED-AIはに対応する(すなわち、TED-AIに到達するにはSARからトップ対中央値の人間の差1.5個分上回る必要がある)。
- •
ASIはに対応する(すなわち、ASIに到達するにはTED-AIからトップ対中央値の人間の差2個分上回る必要がある)。
4.3 総合的な研究センス
総合的な研究センスは、人間とAIの両方の研究センスを考慮したときの、実験1回あたりの平均的な価値を測る。AIの研究センスが最良の人間研究者のそれを上回ると、は単にとなる。それ以前については、AIより能力の低い人間研究者はそれぞれAIの水準まで引き上げられると本モデルでは仮定する。
そのうえで、各時点について、総合的な研究センスを、AIによって引き上げられた人間研究者の研究センスの平均として定義する(はある対数正規分布だったことを思い出してほしい):
| (8) |
たとえばなら、2030年7月の総合的な研究センスはとなる(研究センスが2未満の人間は研究センスが2に等しいとみなされ、2を超える人間は影響を受けない)。そして、後のにおいてが最良の人間研究者の研究センスより大きければ、(8)はに帰着する。
現時点では研究に従事する労働の量はモデル化しておらず、そうしても結果が定性的に変わることはおそらくないと考えている。研究センスについては量より質のほうがはるかに重要だからである。代わりに、研究センスの定義に効率を組み込み、AIの研究センスを評価する際の計算資源予算を固定している。とはいえ、これは本モデルの重要な限界であり、研究労働の量を明示的にモデル化した場合にどれほどの影響があるかについて確信はない。
5 AI R&Dの完全自動化後、本モデルはどう振る舞うか?
序論では、本モデルの進行を3つの自然な段階に区切れることを論じた(AIソフトウェアR&D加速倍率は研究努力の定数倍にすぎないことを思い出してほしい。研究努力とAI R&D加速倍率を参照)。
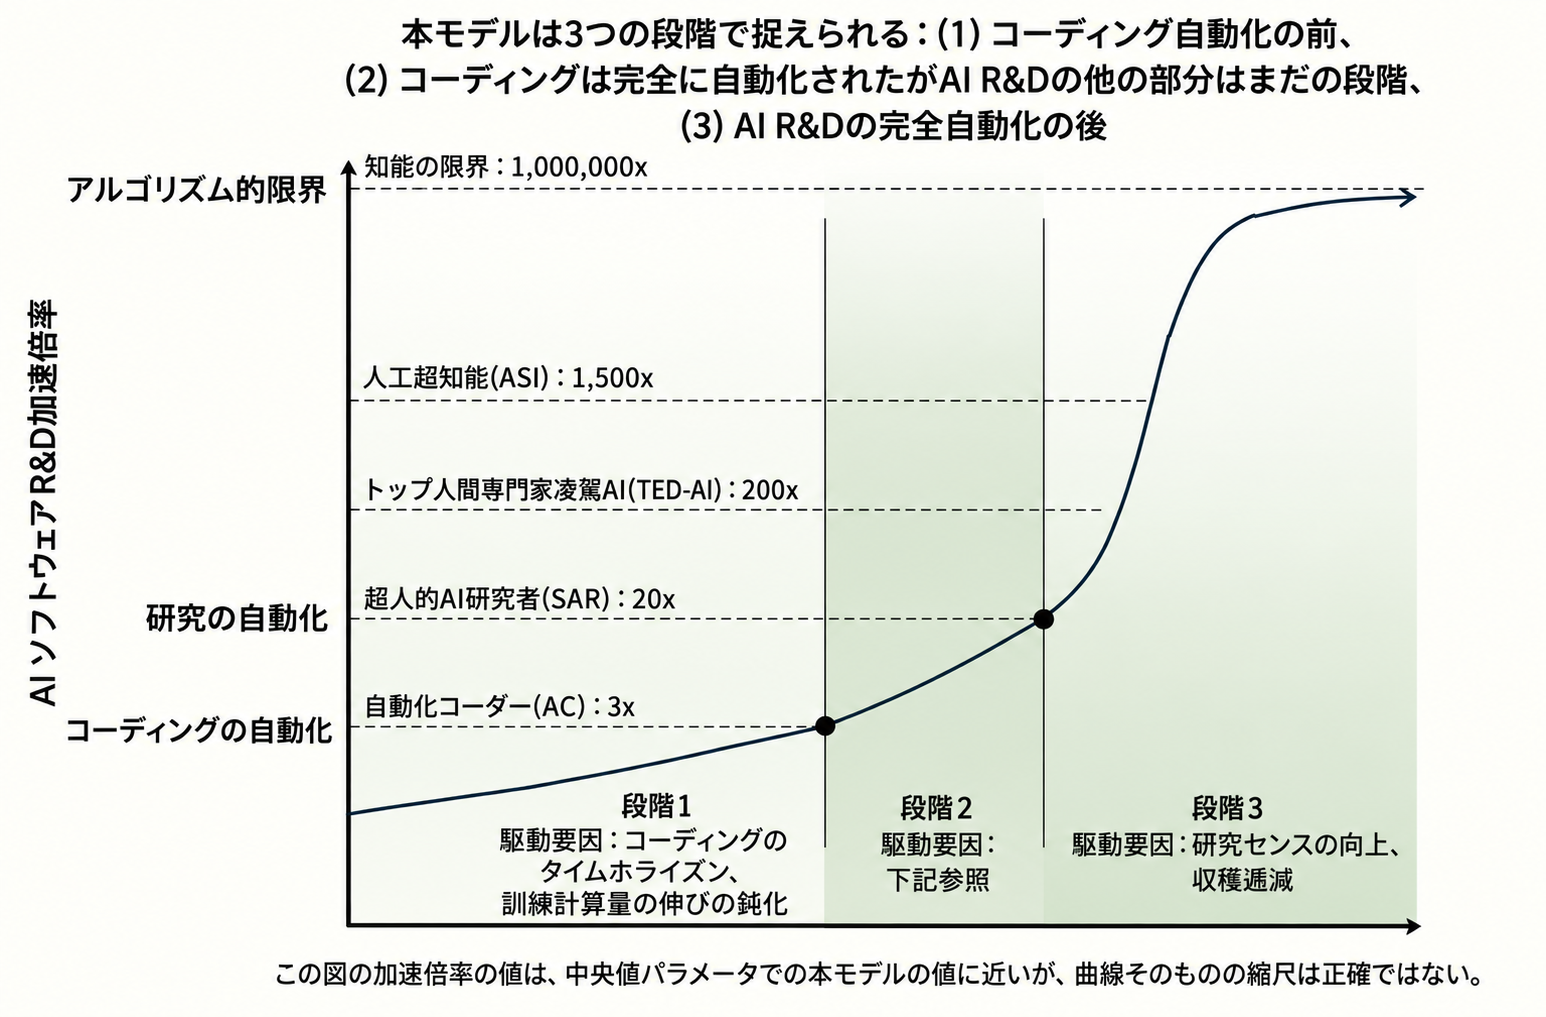
段階3は、超人的AI研究者(SAR)のマイルストーンに到達した時点で始まる。このときAIソフトウェアR&Dは完全に自動化される。
本モデルにおけるSARの操作的定義。
SARは、現在のAGIプロジェクトに投入された場合、研究センスの点で、人間の研究者だけがいて、その一人ひとりがトップの研究者と同等の研究センスを持つようにされた場合と同じくらい優れている。SARはまた、自動化コーダー(AC)の条件も満たさなければならない。すなわち、AGIプロジェクトのコーディングを完全に自動化できなければならない。
SARが研究センスに使える計算資源予算はプロジェクトの計算資源の1%である。ACと同様に、コーディングにはプロジェクトの計算資源の5%の予算を持つ(コーディングの計算資源予算のほうが大きいのは、現在、実験のアイデア出し・選定よりもコーディングに多くの人的労働が費やされているためである)。
この操作的定義は、我々の以前の研究で超人的AI研究者(SAR)として定義したものと似ているが、プロジェクトの最良の研究者を30倍に高速化し30倍の人数にしたものではなく、プロジェクトの最良の研究者の生産性に並べばよいという点が異なる。また、研究センスをコーディングから切り離している。
この時点で、定性的に異なる2つの可能性がある:
- 1.
センスのみのシンギュラリティ(TOS)が起こる。つまり、計算資源が変わらず、コーディングの改善を無視したとしても、AIソフトウェアR&D加速倍率の倍加がどんどん速くなる。言い換えれば、研究センスが駆動するAI R&Dのフィードバックループ(研究センスの向上がAIソフトウェアR&Dの向上をもたらし、それがソフトウェア効率の向上をもたらし、それがさらに研究センスの向上をもたらす)が、計算資源のストックと(総)コーディング労働を固定したまま、時間とともに加速する。本モデルでは、この加速するフィードバックループは、AIが研究センスのアルゴリズム的限界に近づくまで続く(ソフトウェア効率から研究センスへの変換率は、研究センスの限界で急に止まるのではなく、時間とともに滑らかに減衰する。前節を参照)。
- 2.
センスのみのシンギュラリティは起こらない。価値ある研究アイデアが見つけにくくなっていくペースが、研究センスの向上を上回るからである。研究センスのフィードバックループは、それ単独では尻すぼみに終わる。この場合、テイクオフ速度はAIのコーディング能力の向上と、計算資源(訓練用・実験用・自動化用)の成長率によって決まる。
「センスのみのシンギュラリティ」は「ソフトウェアのみのシンギュラリティ」とどう関係するのか?
ソフトウェアのみのシンギュラリティ(SOS)やソフトウェア知能爆発(SIE)の可能性については、ほかでも論じられている(特にForethoughtの最近の研究、こちらとこちら)。Forethoughtの定義では、AI R&Dが完全に自動化された後、計算資源の増加に依存することなく、ソフトウェア効率の倍加が時間とともに速くなっていくなら、SIEが起きている。
彼らのモデルは、認知労働を単一の集計量として扱い、それが実験用計算資源と組み合わさってソフトウェア研究を生み出すとする。彼らが用いる関数形では、認知労働が十分にあれば、ソフトウェア研究努力はいくらでも大きくなりうる。また本モデルと同様に、彼らのモデルもソフトウェア効率を累積認知労働(すなわち研究ストック)のべき関数として表す。アルゴリズムが効率化すればより多くの自動化研究者を稼働させられるため、爆発的になりうるフィードバックループが生じる。最終的な挙動は単一のパラメータによって決まる。これは、累積認知労働が1回倍加するごとに、自動化研究者の数が何回倍加するかを表す。
本モデルは、コーディング労働と研究センスを別々に扱う。実験用計算資源と研究センスを一定に保ったままコーディング労働だけを無限大にしたときの研究努力の倍率は、比較的低い値に漸近する。中央値のケースでの増加である。一方、研究センスを最大限に高めたときに得られる利得は(ほとんどのシミュレーションで)はるかに大きい。イーライのパラメータ推定の中央値では、おおよその増加になる。したがってコーディング労働と研究センスはどちらも知能爆発に大きく寄与しうるが、研究センスのほうが上限が高く、そのぶん失速しにくい。
本モデルがきれいな数学的特徴づけを与えられる条件のうち、これに最も近いのがセンスのみのシンギュラリティ(taste-only singularity, TOS)である。TOSとは、訓練計算量と実験スループットが一定(つまり計算資源とコーディング労働が一定で、変化するのは研究センスだけ)と仮定したときに、AI R&D加速倍率の倍加が時間とともに速くなっていくことをいう。この定義では研究センスの価値に上限がないとも仮定するが、実際には上限のために倍加時間はいずれ長くなっていく(ただし前述のとおり、我々のパラメータ推定ではこの上限は通常高い)。
センスのみのシンギュラリティは、SIEより厳しい条件である。向上を認めるのがセンスの次元だけで、コーディングその他のスキルの向上は認めないからだ。それでもこれを取り上げるのは、実際にはセンスがテイクオフ速度の最も重要な決定要因になると考えているからであり、実際、本モデルではTOSがどの程度成り立つかがテイクオフ速度と強く相関している。センスのみのシンギュラリティが起きないからといって、テイクオフが遅いとは限らない。コーディング労働や計算資源の増加による寄与も依然として大きい(コーディング労働は特にテイクオフの初期段階で効いてくる)。また、もし本モデルにハードウェアR&Dの自動化や産業爆発が含まれていれば、計算資源の増加とコーディング労働はさらに大きな意味を持つだろう。
本節では、本モデルがどのような場合にTOSを予測するかを説明する。つまり、TOS(計算資源と総コーディング労働を固定しても、AI R&D加速倍率の倍加が時間とともにどんどん速くなること)に対応する、モデルパラメータについての単純な条件を特定する。あらゆる種類の計算資源(訓練計算量、実験用計算資源、自動化用計算資源)は一定と仮定する。とりわけ、実効計算量の増加はソフトウェア効率の向上だけからもたらされる(訓練計算量からではない)。さらに総コーディング労働も一定と仮定しているので、実験スループット(すなわちAGIプロジェクトが実行できる実験の数)も一定になる。(いずれ実験スループットは実験用計算資源がボトルネックとなり、コーディングがそれ以上向上してもほとんど意味をなさなくなる。しかしそれは超人的AI研究者のマイルストーンが達成された後になりうるので、実際にはコーディングの向上は通常、テイクオフの速度に意味のある影響を与える。TOSが起こるかどうかについての以下の単純な分析では、コーディングの向上の効果は脇に置く。)
結論として、本モデルは次の場合にTOSを予測する。
ここではソフトウェア効率が1回倍加するごとに研究センスが何回倍加するかを表し、はインパクトのある新しいソフトウェア研究アイデアを見つける難しさを測るパラメータである(次の図の後の説明を参照)。直観的には、とは、研究センスによってAIソフトウェアR&D加速倍率が向上するペースが、アイデアが見つけにくくなるペースを上回ることを意味する。
実のところ(下の展開ボックスを参照)、AIソフトウェアR&D加速倍率の連続する倍加時間の比はになる。たとえばイーライのパラメータの中央値とを使うと、TOSは起こらず、AI R&D加速倍率の各倍加には、その前の倍加の倍の時間がかかる。本モデルの仕組みの興味深い特徴として、R&D加速倍率の各倍加は、直前の倍加と比べて最大でも2倍までしか速くならない(は常に以上であるため)。これでもすでに極めて速いが、おそらく本モデルの癖であり、原理的には現実世界ではさらに速いテイクオフもありうると我々は考えている。
イーライのパラメータの中央値ではTOSが起こらないとしても、イーライのパラメータ分布からサンプリングしてモンテカルロ・シミュレーションを行うと、シミュレーションのでTOSが起こる。
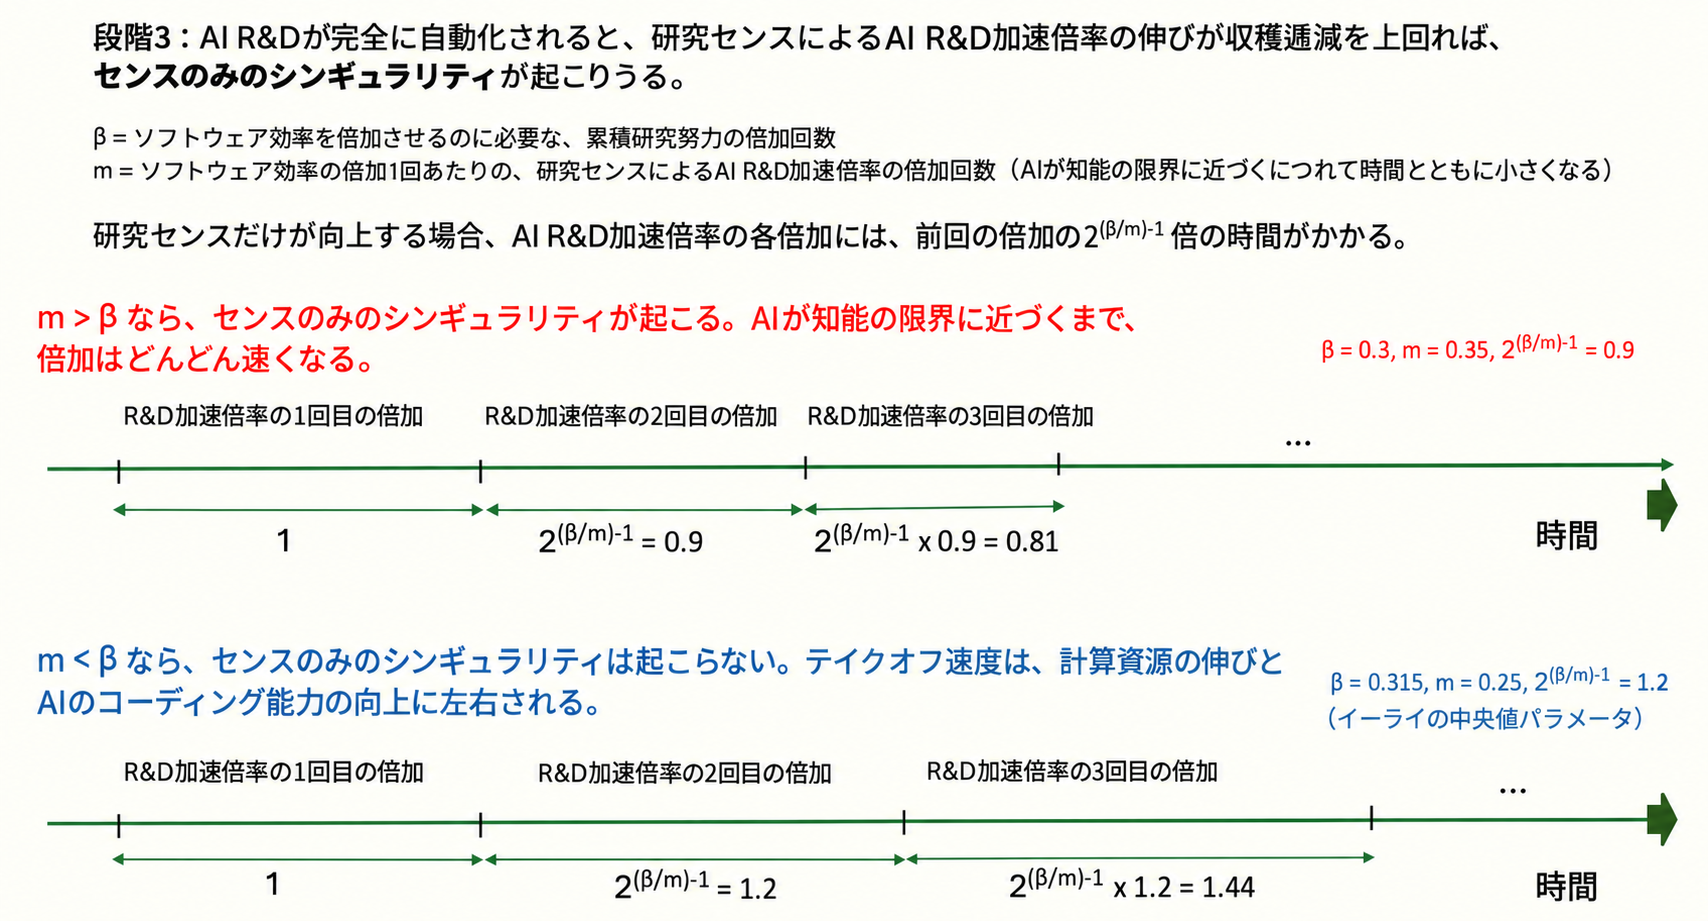
とは何だったか? 自動化された研究センスのモデルでは、実効計算量が1 OOM増えるごとに、AIの研究センスが標準偏差(人間の研究センスの(近似的な)対数正規分布の基になっている正規分布の標準偏差)だけ上がると仮定した。は、最も優れた人間の研究者と中央値の人間の研究者の研究センスの比であり、3標準偏差に対応していた(指数の3はを丸めたもの)。まとめると、AIの研究センスのモデルから、少なくともAIがアルゴリズム上の限界から遠いうちは、実効計算量が1 OOM増えるごとにがおよそ次の倍数だけ掛け算されることがわかる。
つまり、実効計算量が1 OOM増えるごとに、は(近似的に) OOM増える。同じことだが、実効計算量が1回倍加するごとに、は(近似的に)回倍加する(対数は引き続き常用対数)。計算資源がほぼ一定だと仮定するなら、実効計算量の増加はソフトウェア効率の向上だけからもたらされる。また、実験スループットは一定(実験用計算資源のボトルネックのため、プロジェクトはそれ以上多くの実験を実行できない)と仮定し、さらに総合的な研究センスは自動化された研究センスそのもの(人間の研究者はもはや価値を付け加えない)と仮定しているので、AIの研究センスの向上はそのまま研究努力の向上に対応する。以上をまとめると、は次を満たす。
| (9) |
とは何だったか? ソフトウェア効率の節で、研究ストックを、時刻までに行われた研究努力の総量として導入した。モデルは次のとおりだった。
| (10) |
が大きいほど、(ソフトウェア効率を高める)インパクトのあるソフトウェア研究アイデアを見つけるのが難しくなる。本モデルでは、2024年のソフトウェア効率の成長率がユーザー指定のパラメータに等しくなるように、が自動的に設定される(詳細はソフトウェア効率を参照)。
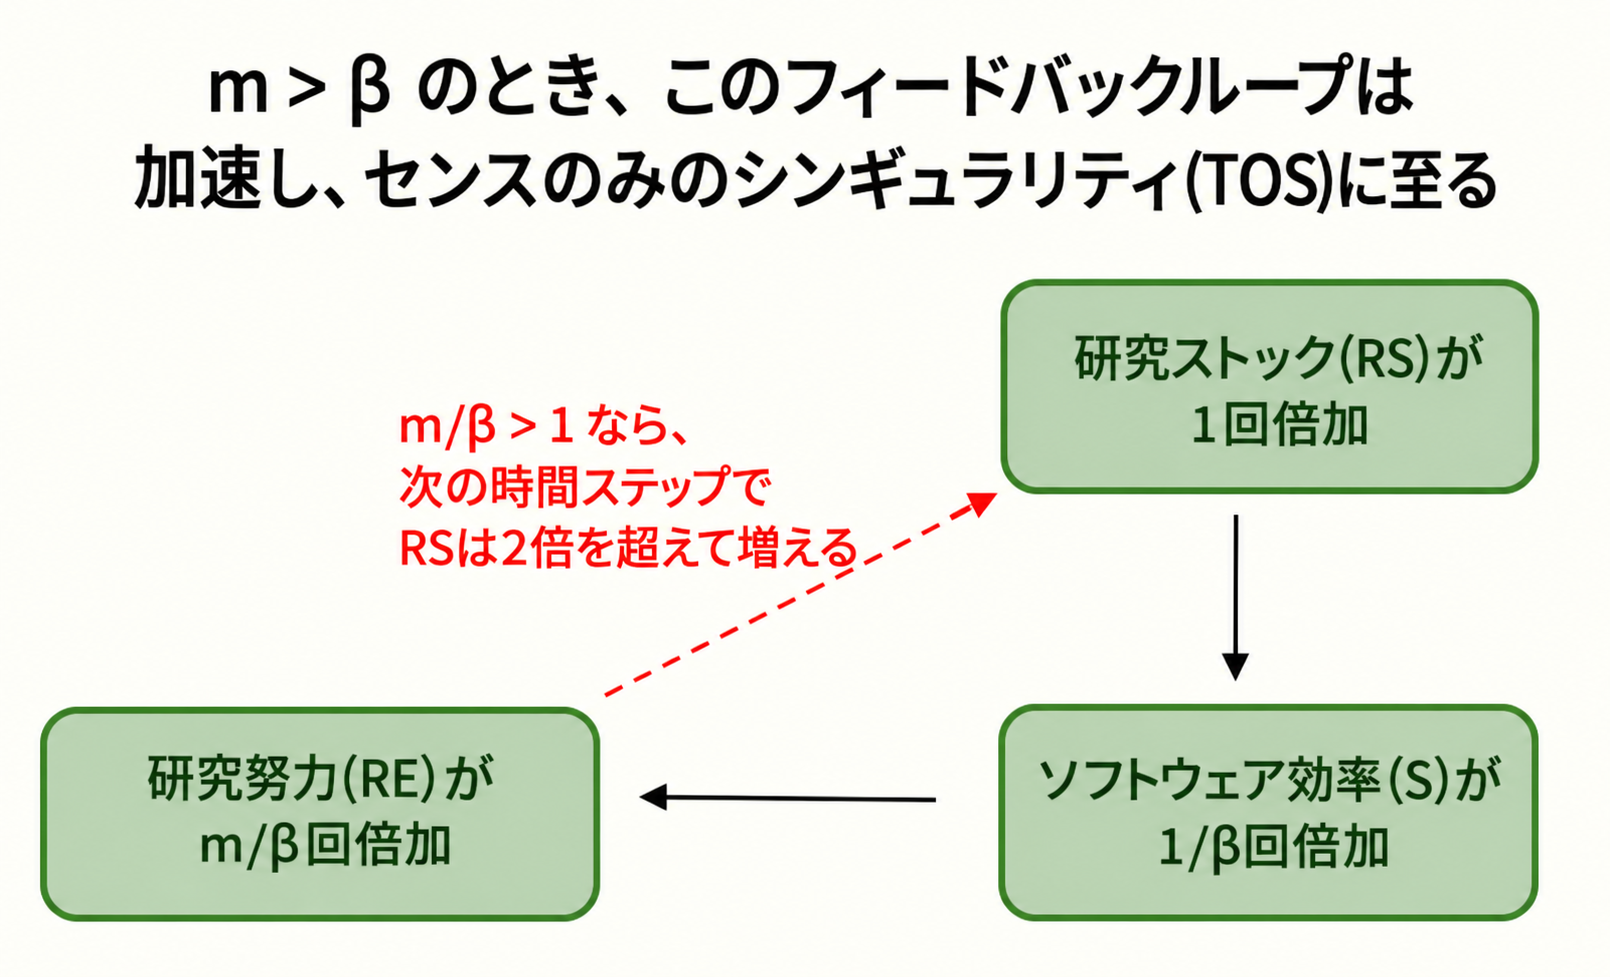
TOSの条件を正当化する数学的な詳細。
TOSが起こる場合、つまりソフトウェア効率の倍加時間がどんどん短くなっていく場合(アルゴリズム上の限界によって進歩が鈍化する前であり、かつ計算資源と総コーディング労働が一定と仮定したとき)を特定したい。これには、研究努力とソフトウェア効率の関係を半内生的成長モデルとして定式化したもの(こちらの展開ボックスを参照)を使うのが簡明である。
| (11) |
の変化の速さをOOM単位で測るには、の対数の導関数を見るのが便利である(式が簡単になるので、自然対数を使う)。これをの成長率と呼び、次のように書く。
(11)の両辺をで割ると、次が得られる。
| (12) |
が時間とともに大きくなるなら(少なくともアルゴリズム上の限界によって進歩が鈍化する前に)、シンギュラリティが起きている。
をで表したい。計算資源と総コーディング労働が固定されているという仮定から、が1 OOM増えるたびには OOM増える。これは、とがべき乗則の関係を満たすと言うのと同じである。
| (13) |
これを(12)に代入すると、次が得られる。
| (14) |
この式から、がとともに大きくなる(すなわち、は時間とともに増加するので、が時間とともに大きくなる)のは、のときであり、かつそのときに限ることがわかる。言い換えれば、本モデルがTOSを予測するのは、のときであり、かつそのときに限る。
式(14)を使えば、連続する倍加時間がどう変化するかも調べられる。の連続する倍加時間の比は次で与えられる。
ここでとは、それぞれの1回目と2回目の倍加期間の始めにおけるの成長率である。したがって、少なくともAIがアルゴリズム上の限界から遠い初期のうちは、の各倍加時間は、その前の倍加時間の倍の長さになる。
研究努力、あるいは同じことだがAI R&D加速倍率についても、連続する倍加時間の比を求められる(AI R&D加速倍率は研究努力の定数倍にすぎないことを思い出してほしい。研究努力とAI R&D加速倍率の末尾を参照)。(13)より、の倍加はが倍になることに対応する。の連続する倍加時間の比をと計算したのと同じ方法で、が連続して倍になるのにかかる時間の比も計算できる(倍加やOOM、あるいは対数目盛の特定の底を使うことに特別な意味はない)。その結果は次のとおりである。
AI R&D加速倍率の倍加はの倍加と同じであり、それはが倍になることと同じなので、次のように結論できる。
したがって、少なくともAIがアルゴリズム上の限界から遠い初期のうちは、AI R&D加速倍率の各倍加時間は、その前の倍加時間の倍の長さになる。
6 モデルのまとめ
記載している既定値は、イーライのパラメータの中央値である。
6.1 入力時系列
- •
人間のコーディング労働。
- •
計算資源。これは固定の割合で、訓練計算量()、実験用計算資源()、自動化用計算資源()に配分される。(残りの計算資源は外部向けの推論に配分される。)
- •
これらの入力時系列をどう設定したかについて詳しくは、補足資料を参照。
6.2 タイムホライズンのモデル化
- •
タイムホライズンは、log(実効計算量)の関数である。から出発して、タイムホライズンの1回目の倍加にはがだけ増える必要があり、2回目の倍加には、3回目の倍加には、以下同様である。がまだ無限大になっていなければ(無限大になるのはの場合で、いずれそうなる)、次が成り立つ。
の既定値はである。とくにこのとき、はの超指数関数になる。
- •
自動化コーダーのマイルストーンは、がパラメータに等しくなったときに達成される。の既定値は130人年である。
6.3 実効計算量のモデル化
- •
実効計算量
とは、現時点の訓練アルゴリズムを使って、時刻のフロンティアAIを訓練するのに必要な訓練計算量のことである。ほかのすべての能力指標(タイムホライズン、コーディング自動化率/効率、研究センス)は、実効計算量によって表される。
- •
実験スループットは、実験用計算資源と逐次コーディング労働のCES関数である。
- –
。ここで並列化ペナルティの既定値はである。
- –
.
- –
パラメータは、次の3つについてのパラメータを指定することで決まる。(a) が10分の1だったらがどれだけ小さくなるか、(b) が無限大だったらはいくらになるか、(c) が無限大だったらはいくらになるか。既定値は、、である。詳細はこちらを参照。
- –
- •
研究努力は次のとおりである。
ここでは総合的な研究センスである。
- •
AIソフトウェアR&D加速倍率は次のとおりである。
ここでは、時刻のAIを現時点へ連れ戻した場合(ただし時刻に利用可能な追加の実験用・自動化用計算資源や追加の人間の労働は連れ戻さない)に、現時点での研究努力がどうなるかを表す。
- •
ソフトウェア効率は、Jonesの半内生的成長モデルに従う。
パラメータは、が大きくなったときにソフトウェアの進歩がどれだけ難しくなるかを決める。が1回倍加するには、累積研究努力(「研究ストック」)が回倍加する必要がある。
6.4 コーディング自動化のモデル化
- •
自動化可能なコーディングタスクの割合は、のロジスティック関数である。本モデルでは、この割合はACに対応する実効計算量で1に等しくなる(これは単純化である。定義上、ACが達成されるのはそのコーディング生産性が現時点の全人間コーダーのそれに並んだときであり、それはすべてのタスクが自動化される前に起こりうるからだ)。現時点での自動化可能なコーディングタスクの割合(既定パラメータで2025年12月に)は、モデルが現時点のコーディング加速倍率(AI企業の人々への調査に基づくパラメータ)を正しく予測するように選ぶ。
- •
コーディングタスクにはで番号を振る。
- •
タスクがいったん自動化されると、そのタスクは倍率の分だけ時間とともに効率が上がっていく。
- –
タスクが自動化される前は、は0である。
- –
実効計算量がタスクの自動化に必要な水準に達すると、は実効計算量のべき乗則に従って増加する:
- –
初期効率は、現時点における人間のコーダー数と自動化用計算資源の量の比に等しい。は、推論のコストと速度がどれだけ速く改善してきたかに関するデータから推定する。
- –
- •
タスクの全体のコーディング労働は次のとおりである。
ここではタスクに従事する人間のコーダー数、はタスクに取り組むAIの実行に使われる計算資源である。
- •
総コーディング労働は、すべてのタスクに投入される労働のCES関数であり、既定では代替性が低い():
- •
人間のコーディング労働と自動化用計算資源は、各時間ステップでが最大になるようにタスク間に配分される。
6.5 研究センスの自動化
- •
人間の研究センスは対数正規分布に従う。中央値の人間研究者のセンスを1とし、99.9パーセンタイル(+3.1 SD)の人間研究者を最良の研究者とみなす。現在の最良の人間研究者の研究センスの既定値は3.7倍である(AI研究者や専門家への調査を参考にした)。
- •
既定では、ACの研究センスは中央値の人間研究者より SD上である(このパラメータはAI研究者や専門家への調査に基づく)。
- •
SD単位で表すと、自動化された研究センスは次のとおりである。
- •
実際の自動化された研究センスは、の一般化ロジスティック関数である:
- –
は研究センスの究極的な上限である。
- –
は上限にどれだけ速く近づくかを制御する。
- –
は、からへの写像が、人間の範囲の近傍で人間の研究センスの対数正規分布と一致するように設定する。
- –
数学的な詳細はこちらの展開ボックスを参照。
- –
- •
AIの研究センスがある人間研究者より優れていれば、その研究者の研究センスはAIの水準まで引き上げられる。AIより優れた人間研究者は影響を受けない。総合的な研究センスは、(場合によっては)引き上げられた後の人間研究者たちの研究センスの平均である: